ELK(Elasticsearch+Logstash+Kibana)

ELK基础配置和使用 阅读详情

以下为ELK技术栈完整使用指南,涵盖核心组件部署、配置及优化方案:

一、ELK核心组件功能

组件 作用 关键特性
Elasticsearch 分布式搜索与分析引擎 实时索引、横向扩展、RESTful API
Logstash 日志收集、解析与传输管道 200+插件、Grok模式解析、数据过滤
Kibana 数据可视化与分析平台 仪表盘定制、机器学习分析、警报系统

二、部署流程(以CentOS 7为例)

1. 环境准备
# 安装Java环境
sudo yum install java-11-openjdk-devel
2. Elasticsearch安装
# 导入ES密钥
rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearch

# 安装ES
cat > /etc/yum.repos.d/elasticsearch.repo <<EOF
[elasticsearch]
name=Elasticsearch repository
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md
EOF

sudo yum install elasticsearch
3. 关键配置(/etc/elasticsearch/elasticsearch.yml)
cluster.name: prod-logs         # 集群名称
node.name: node-1               # 节点标识
network.host: 192.168.1.100     # 监听IP
discovery.seed_hosts: ["node-1"] # 单节点发现
4. 启动服务
sudo systemctl enable elasticsearch
sudo systemctl start elasticsearch
5. Logstash部署
sudo yum install logstash
6. Logstash管道配置(/etc/logstash/conf.d/apache.conf)
input {
   
   
  file {
   
   
    path => "/var/log/apache2/access.log"
    start_position => "beginning"
  }
}

filter {
   
   
  grok {
   
   
    match => {
   
    "message" => "%{COMBINEDAPACHELOG}" }
  }
  date {
   
   
    match => [ "timestamp", "dd/MMM/yyyy:HH:mm:ss Z" ]
  }
}

output {
   
   
  elasticsearch {
   
   
    hosts => ["http://192.168.1.100:9200"]
    index => "apache-logs-%{+YYYY.MM.dd}"
  }
}
7. Kibana安装与启动
sudo yum install kibana
sudo systemctl enable kibana && sudo systemctl start kibana

三、Kibana操作指南

  1. 数据接入

    • 访问 http://<server_ip>:5601
    • 进入 Management > Stack Management > Index Patterns 创建索引模式(如 apache-logs-*)
  2. 日志分析

    • 使用 Discover 界面进行实时日志搜索
    response:200 AND bytes:>1000   # 筛选成功响应且传输量>1KB的请求
    
  3. 仪表盘构建

    • 在 Dashboard 创建可视化图表:
      • 柱状图:HTTP状态码分布
      • 饼图:客户端操作系统占比
      • 地图:访问者地理位置分布

四、性能优化方案

  1. Elasticsearch调参

    # /etc/elasticsearch/jvm.options
    -Xms4g   # JVM最小内存
    -Xmx4g   # JVM最大内存(不超过物理内存50%)
    
  2. Logstash管道优化

    input {
         
         
      beats {
         
            # 改用轻量级Filebeat
        port => 5044
      }
    }
    
  3. 索引生命周期管理(ILM)

    PUT _ilm/policy/logs_policy
    {
         
         
      "policy": {
         
         
        "phases": {
         
         
          "hot": {
         
          "actions": {
         
          "rollover": {
         
          "max_size": "50GB" } } },
          "delete": {
         
          "min_age": "30d", "actions": {
         
          "delete": {
         
         } } }
        }
      }
    }
    

五、安全加固措施

  1. 启用X-Pack基础安全

    # elasticsearch.yml
    xpack.security.enabled: true
    
    # 生成密码
    sudo /usr/share/elasticsearch/bin/elasticsearch-setup-passwords auto
    
  2. Kibana用户角色配置

    • 通过 Stack Management > Security 创建只读用户

六、常见问题排查

  1. 日志未入库
    # 检查Logstash管道状态
    tail -f /var/log/logstash/logstash-plain.log
    
  2. 集群健康异常
    curl -XGET 'http://localhost:9200/_cluster/health?pretty'
    
    • 关注 status 字段(green/yellow/red)

七、典型应用场景

  1. Web服务器监控
    • 实时分析Nginx/Apache访问日志,检测异常请求
  2. 安全审计
    • 通过自定义规则识别SSH暴力破解行为
    event.type: "authentication_failure" | stats count by source.ip
    
  3. 业务指标分析
    • 统计电商平台订单处理延迟(ELK + Kafka流处理)

注:生产环境建议部署3节点ES集群,搭配Redis做日志缓冲队列

思维导图
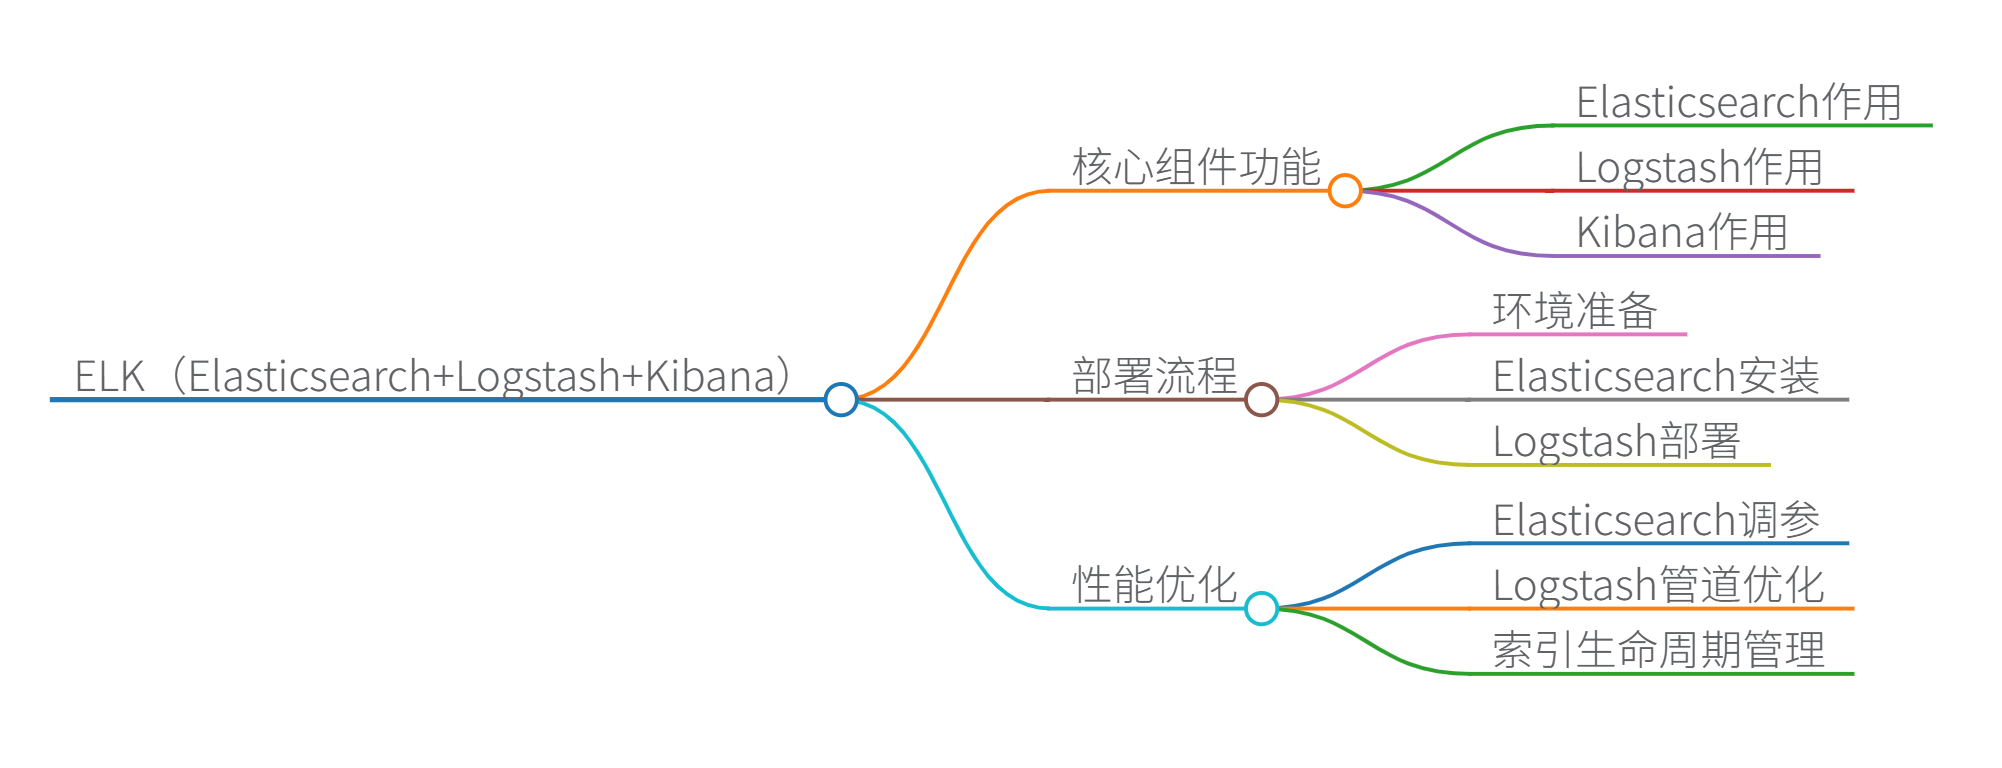
在这里插入图片描述


以下是对ELK技术栈的全面解析,涵盖技术原理、设计架构、核心组件及代码实现:

一、技术原理与设计架构

1. 整体架构图
+----------------+       +----------------+       +----------------+       +----------------+
|   数据源        | ----> |   Logstash     | ----> |  Elasticsearch  | ----> |    Kibana      |
| (日志文件/DB等)  | 采集  | (数据处理管道)   | 传输  | (分布式搜索引擎)   | 可视化 | (数据展示平台)  |
+----------------+       +----------------+       +----------------+       +----------------+
2. 设计原理
  • 分布式扩展:Elasticsearch采用分片(shard)机制实现水平扩展
  • 近实时处理:数据从采集到可搜索延迟约1秒(refresh_interval)
  • Schema-on-Read:无需预先定义数据结构,动态映射字段类型
  • CAP原则:优先保证AP(可用性和分区容错性)

二、核心组件技术解析

1. Elasticsearch

数据结构与算法:

  • 倒排索引:核心数据结构,实现O(1)O(1)O(1
ELK之简介+Elasticsearch集群部署+索引管理 Logstash 作为日志搜集器,从数据源采集数据,并对数据进行过滤,格式化处理,然后交由 Elasticsearch 存储,Kibana 对日志进行可视化处理。 阅读详情

相关推荐

ELK(ElasticSearch、Logstash、Kibana)

目录: ELK概念和工作原理 ELK分布式日志平台搭建 ELK概念和工作原理 ElasticSearch ElasticSearch是基于JAVA语言编写的,开源、免费的,用于数据存储,可以作为分布式搜索引擎来使用,可以实现数据内容存储、检索、排序、查询、报表统计、生成等功能 Logstash Logstash是基于JAVA语言开发的,开源、免费的,用于客户端服务器采集本地日...

番茄炒蛋君的博客 718

ELK EFK日志搜索平台 filebeat kafka logstash elasticsearch(es) kibana

ELK是当前比较主流的分布式日志收集处理工具。常用日志采集方式Filebeat→Kafka集群→Logstash→ES→KibanaGrafana(可视化监控工具)上配置连接ES数据库进行实时监控实施步骤Filebeat部署在应用服务器上(只负责Logstash的读取和转发,降低CPU负载消耗,确保不会抢占应用资源),Logstash、ES、Kibana在一台服务器上(此处的Logstash负责日志的过滤,会消耗一定的CPU负载,可以考虑如何优化过滤的语法步骤来达到降低负载)。...............

zhaoyang10的专栏 2772

ELK日志平台(elasticsearch+logstash+kibana)搭建

为了实现分布式日志数据统一收集,实现集中式查询和管理 故障排查 安全信息和事件管理本文仅仅简单介绍了ELK的安装,而ELK其他强大的功能需要继续学习。

用来当笔记本 2702

ELK(Logstash+Elasticsearch+Kibana)

一、ELK日志分析系统简介 ELK日志分析系统是Logstash、Elasticsearch、Kibana开源软件的集合,对外是作为一个日志管理系统的开源方案,它可以从任何来源、任何格式进行日志搜索、分析与可视化展示 1.1、ELK日志分析系统组成 elasticsearch(es):通过搭建群集;存储日志数据,索引日志数据 logstash :收集日志,收集到了后给es存储 kibana :视图形式展现日志信息,更加人性化 1.2、日志处理步骤 1.将日志进行集中化管理 2.将日志格式化(Logstash

m0_50650953的博客 405

基于ELK搭建网站实时日志监控平台

基于ELK搭建网站实时日志监控平台 1 为什么要用到ELK 早在传统的单体应用时代,查看日志大都通过SSH客户端登服务器去看,使用较多的命令就是 less 或者 tail。如果服务部署了好几台,就要分别登录到这几台机器上看,等到了分布式和微服务架构流行时代,一个从APP或H5发起的请求除了需要登陆服务器去排查日志,往往还会经过MQ和RPC调用远程到了别的主机继续处理,开发人员定位问题可能还需要根据TraceID或者业务唯一主键去跟踪服务的链路日志,基于传统SSH方式登陆主机查看日志的方式就像图中排查线路的工

weixin_40055163的博客 4304

Elasticsearch 与 Logstash、Kibana 的完美结合:ELK 实战教程

收集:用 Logstash(或更轻量的 Filebeat)收集分散在各个服务器的日志;存储:用 Elasticsearch 存储日志,提供快速查询和分析;可视化:用 Kibana 生成 dashboard,实时展示日志趋势、错误统计、用户行为等。简单来说,ELK 能把“混乱的日志”变成“可利用的信息”,帮你快速定位问题、优化系统、支撑决策。部署ELK:用 Docker Compose 快速部署 Elasticsearch、Logstash、Kibana;配置Logstash。

AI智能探索者的博客 905

ARM的CI-700和Arteris的NoC对比

设计理念:CI-700注重于为移动和客户端SoC提供定制化的互连解决方案,而Arteris的NoC更侧重于提供灵活、可配置的网络互连技术,适用于多种应用场景。性能与功耗:CI-700通过系统级缓存和网状拓扑结构优化性能和功耗,而Arteris的NoC通过物理感知和多协议支持来提升性能和降低功耗。功能安全:Arteris的NoC提供了功能安全支持,这对于汽车和工业应用尤为重要,而CI-700虽然也关注安全性,但未明确提及功能安全支持。互操作性。

ygyglg的专栏 2619

基于Simulink的直流电机双闭环调速系统抗扰动仿真与参数优化

本文详细介绍了基于Simulink的直流电机双闭环调速系统仿真与参数优化方法。通过构建转速外环与电流内环的仿真模型,阐述了利用工程设计法整定PI参数的核心步骤,并重点探讨了如何优化系统参数以增强其抗负载突变等扰动的能力,实现快速、平稳的调速性能。

weixin_29061997的博客 192

从零到一:用CubeMX和485模块快速上手多摩川绝对式编码器(附清零操作详解)

本文详细介绍了如何使用STM32CubeMX和485模块快速上手多摩川绝对式编码器,包括硬件连接、STM32配置、协议解析及清零操作。通过具体的代码示例和调试技巧,帮助开发者高效实现编码器数据读取和清零功能,特别适合STM32单片机开发者参考。

weixin_30599769的博客 190

高级用法:LangChain 安全防护(Guardrails)

在调用开始时校验请求,可做关键词过滤、身份校验、限流等。= "human":return {}],# 使用],= "human":return {}],

Long_像风一样自由 316

openGauss学习笔记-280 openGauss性能调优-实际调优案例09-修改启动参数解决TPCC大幅度波动

openGauss学习笔记-280 openGauss性能调优-实际调优案例09-修改启动参数解决TPCC大幅度波动280.1 现象描述280.2 优化分析 openGauss学习笔记-280 ope

超哥的博客 308

Codex 100个真实案例 - 用AI生成Blender 3D建模脚本(建模师要失业了?)

本案例将展示如何用 Codex 生成 Blender Python API(bpy)脚本,自动创建完整的 3D 模型。我们将从基础几何体开始,逐步实现布尔运算、材质设置、光照配置,最终完成一张精美桌子的 3D 建模——包括桌面、桌腿、倒角、木纹材质。还会实现参数化批量生成不同风格的桌子、渲染输出 PNG 图片、以及 360 度旋转动画。全程用自然语言驱动 Codex,让建模从"点鼠标"变成"说人话"!

yueyeguzhuo的专栏 629

计算机组成原理(第三版)唐朔飞-第七章指令系统-课后习题

机器字长是指CPU一次能处理数据的位数通常与CPU的寄存器位数有关。指令字长是指机器指令中二进制代码的总位数。存储字长是指存储单元中存放二进制代码的总位数。三者可以相等也可以不等视不同机器而定。答:OP(4位)A1(6位)A_1(6位)A1​(6位)A2(6位)A_2(6位)A2​(6位)设二地址指令格式为该指令系统的基本格式,4位操作码共有16种编码,其中13种用来定义二地址指令,还剩3种可用作扩展标志。一地址指令条数=3∗26=192。

weixin_45735391的博客 7万+

【yolo】如何在 YOLOv8 中添加负样本以减少误检

在YOLOv8目标检测中,误检(False Positive)是一个常见问题,即模型将非目标区域错误识别为目标。通过引入负样本(Negative Samples),即不包含任何目标框的图像,可以有效减少误检。在YOLOv8中添加负样本的方法是为这些图像提供空的标注文件(.txt),确保每张图像都有对应的标注文件,即使内容为空。可以使用Python脚本自动生成这些空标注文件。使用负样本时需注意数量比例、标注一致性、验证集同步和图像质量。适当加入负样本能显著提升模型鲁棒性,降低误判风险。

songhuangong123的博客 2877

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

上一篇: Zuul(Netflix 开源)
下一篇: Elastic-Job
HuiSoul200
博客等级 码龄8年 274粉丝 82原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
