彻底搞懂深度学习-强化学习和智能体(动图讲解)

强化学习(1): 概述 一、DRL问题描述 算法定义: 强化学习算法是在不确定环境中,通过与环境的不断交互,来不断优化自身 策略的算法。 算法特点: 数据非独立同分布:agent的行为会影响后续的数据分布 没有绝对正确的标签,无法立即获得反馈 具有超越人类先验知识的表现 强化学习问题定义在马尔可夫决策过程之上。一个MDP是<S,A,R,P,ρ0><S,A,R,P,\rho_0><S,A,R,P,ρ0​>的五元组。 关于马尔可夫决策模型,我们详细参见博客:link 二、算法分类 1. 大分类 阅读详情

当我们谈论人工智能时,经常会遇到"强化学习"和"智能体"这两个术语。很多人会问:它们是一回事吗?有什么区别?为什么AlphaGo和AlphaStar既被称为强化学习的成功,又被称为智能体的典型?
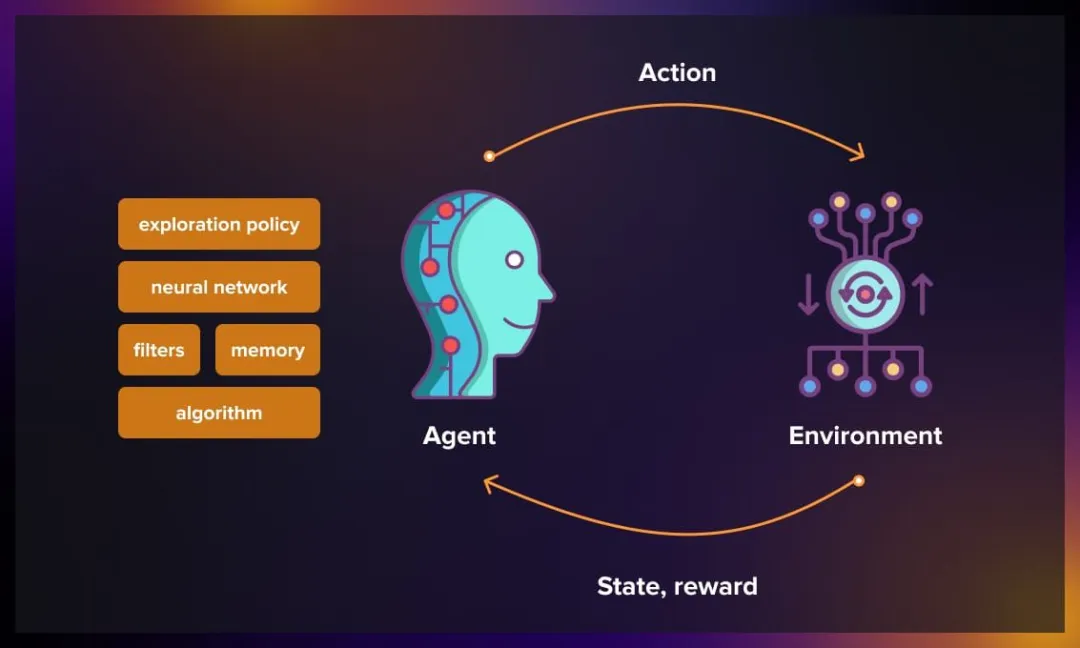
要回答这些问题,我们需要从根本上理解这两个概念的本质。

一、强化学习和智能体

什么是强化学习(Reinforcement Learning)?解决"如何学会做决策"的问题

想象你是一个刚学会走路的孩子,站在一个陌生的房间里,想要到达门口。你不知道哪条路最好,也没有人告诉你标准答案。你只能:

  • 尝试向前走 → 撞到桌子 → 感到疼痛(负反馈)

  • 尝试绕过桌子 → 顺利前进 → 感到高兴(正反馈)

  • 重复这个过程,逐渐学会避开障碍物,找到最短路径

这就是强化学习的核心思想:在没有标准答案的情况下,通过试错和反馈来学习最优的行为策略。
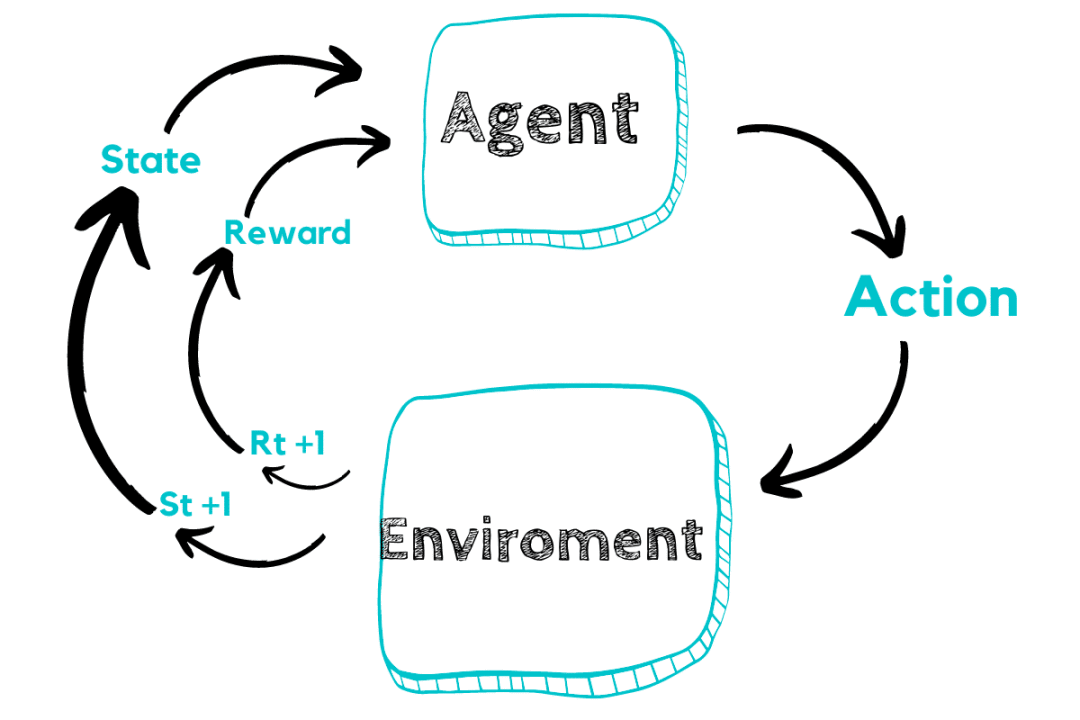
强化学习是一套学习方法论,它回答的是:

  • 如何从错误中学习?

  • 如何处理延迟的反馈?

  • 如何平衡尝试新方法和使用已知好方法?

  • 如何优化长期收益而不是短期收益?

什么是智能体(Agent)?解决"如何构建自主系统"的问题

现在换个角度。假设你要设计一个扫地机器人,它需要:

  • 感知环境:用传感器检测房间布局、障碍物位置
  • 做出决策:选择清扫路径,决定是否需要充电
  • 执行动作:控制马达移动,启动吸尘装置
  • 适应变化:当家具移动时调整策略

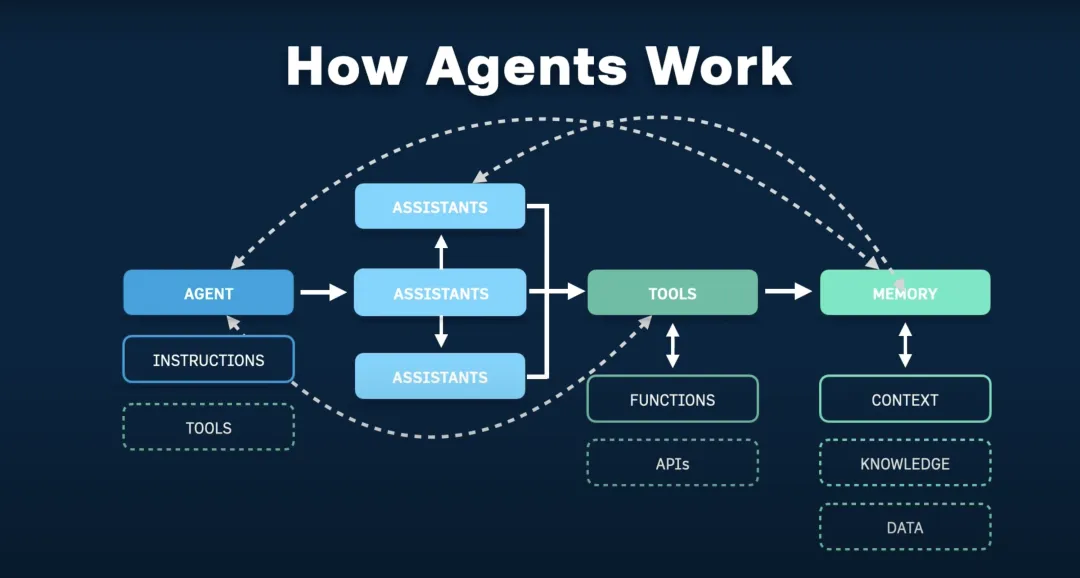
这个扫地机器人就是一个智能体。它是一个完整的系统架构,强调的是如何组织各个组件来实现自主运行。
智能体回答的是:

  • 如何设计一个能自主运行的系统?

  • 如何组织感知、决策、执行这些功能模块?

  • 如何让系统有目标导向的行为?

  • 如何让系统适应环境变化?

通过这两个例子,我们可以看出强化学习是一套学习方法论,智能体是一个完整的系统架构。

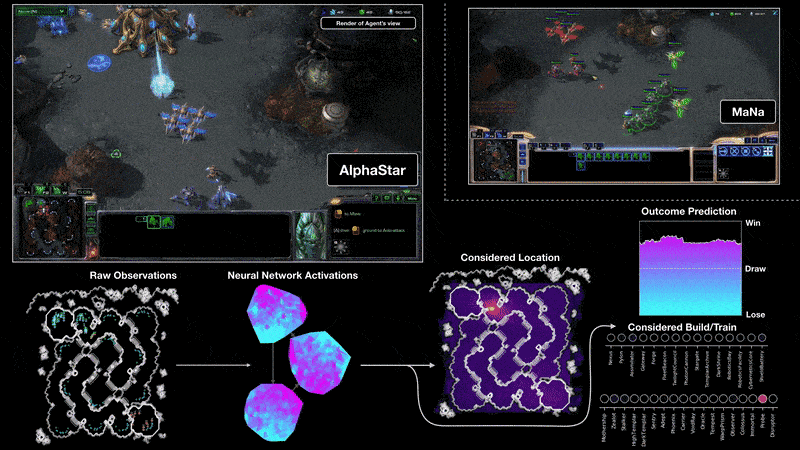
它们可以独立存在,也可以结合。当我们把强化学习嵌入到智能体架构中,就得到了强化学习智能体。例如:AlphaGo,AlphaStar
二、大语言模型智能体

随着ChatGPT、GPT-4等大语言模型的突破,AI领域出现了一种新的智能体构建方式:基于大语言模型的智能体(LLM-based Agents)。这种新范式正在重新定义我们对智能体的理解。

大语言模型智能体与传统智能体的差异是什么?

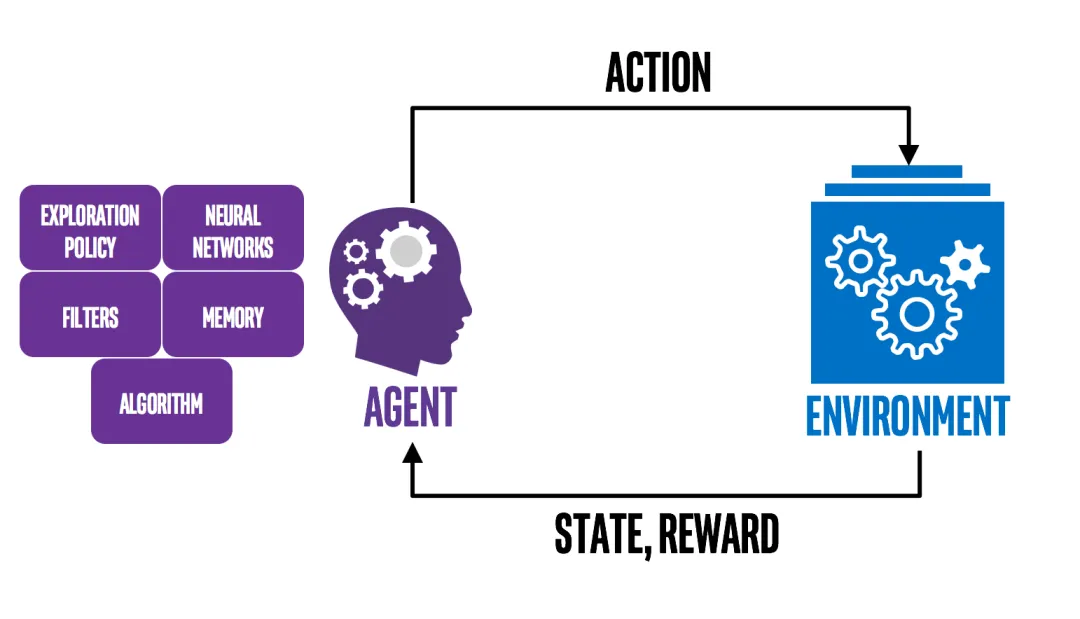
(1)传统智能体的构建方式

智能体系统
├── 感知模块(专门的传感器处理)
├── 决策模块(规则引擎或特定算法)
├── 执行模块(专门的执行器)
└── 学习模块(强化学习、监督学习等)
(2)大语言模型智能体的构建方式

LLM智能体系统
├── 核心:大语言模型(统一的认知引擎)
├── 输入处理:多模态信息转换为文本
├── 推理决策:基于语言的思维链推理
├── 工具调用:通过API连接外部世界
└── 输出转换:文本指令转换为具体行动
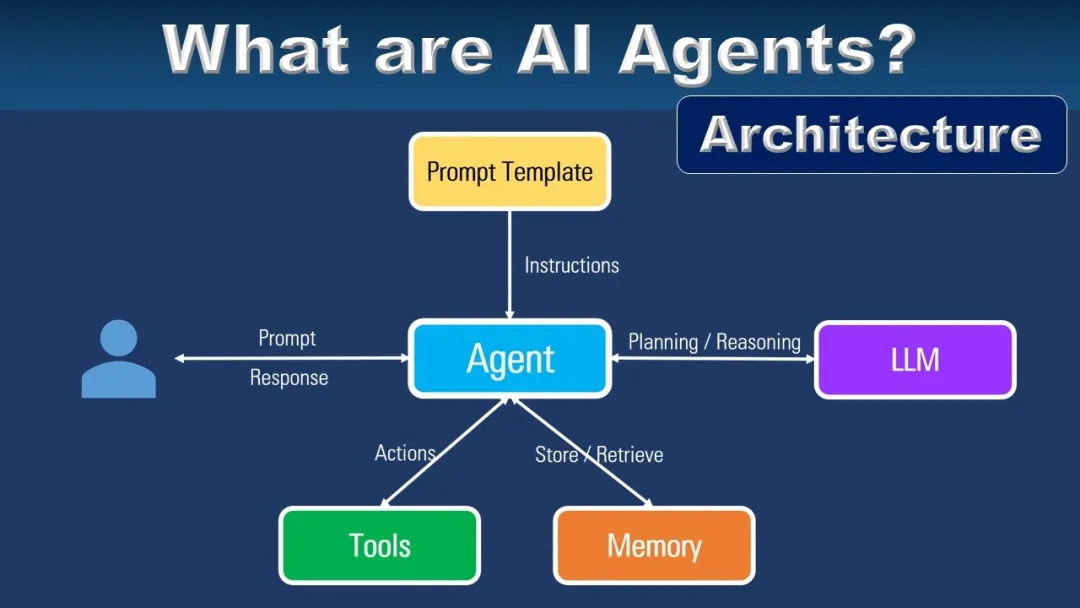
这两种智能体的根本差异在于,大语言模型智能体将语言作为通用接口。

LLM智能体是一个能够理解和生成人类语言的万能助手,主要有三种应用模式。

1. 对话式智能体(Conversational Agents)

以自然语言对话为主要交互方式应用:客服机器人、个人助理、教育辅导。

案例:智能学习助手

学生:"我不理解什么是Transformer架构,和RNN有什么区别?"
智能体:"简单来说:
- RNN像逐字读书,必须按顺序处理,效率低
- Transformer像同时看整页,通过注意力机制并行处理所有信息
核心优势:并行计算、更好捕捉长距离依赖关系。"
学生:"GPT是怎么训练的?"
智能体:"三个阶段:
1. 预训练:用大量文本学习语言规律
2. 指令微调:学习按人类指令行事  
3. 强化学习:通过人类反馈优化输出
想动手实践吗?我可以安排从注意力可视化到mini-GPT实现的练习项目。"

2. 任务执行智能体(Task-Oriented Agents)

专注于完成特定任务应用:自动化办公、数据处理、内容生成

案例:营销文案生成器

输入:产品信息 + 目标受众 + 营销目标
处理:分析竞品 → 提取卖点 → 选择文案风格 → 生成多版本文案
输出:A/B测试用的不同风格文案 + 效果预期分析

3. 多智能体系统(Multi-Agent Systems)

多个LLM智能体协作完成复杂任务应用:软件开发、科研协作、决策支持

案例:AI软件开发团队

产品经理智能体:分析需求,制定产品规划
架构师智能体:设计系统架构,制定技术方案  
开发者智能体:编写代码,实现功能模块
测试工程师智能体:设计测试用例,执行质量检查
项目经理智能体:协调进度,管理资源分配
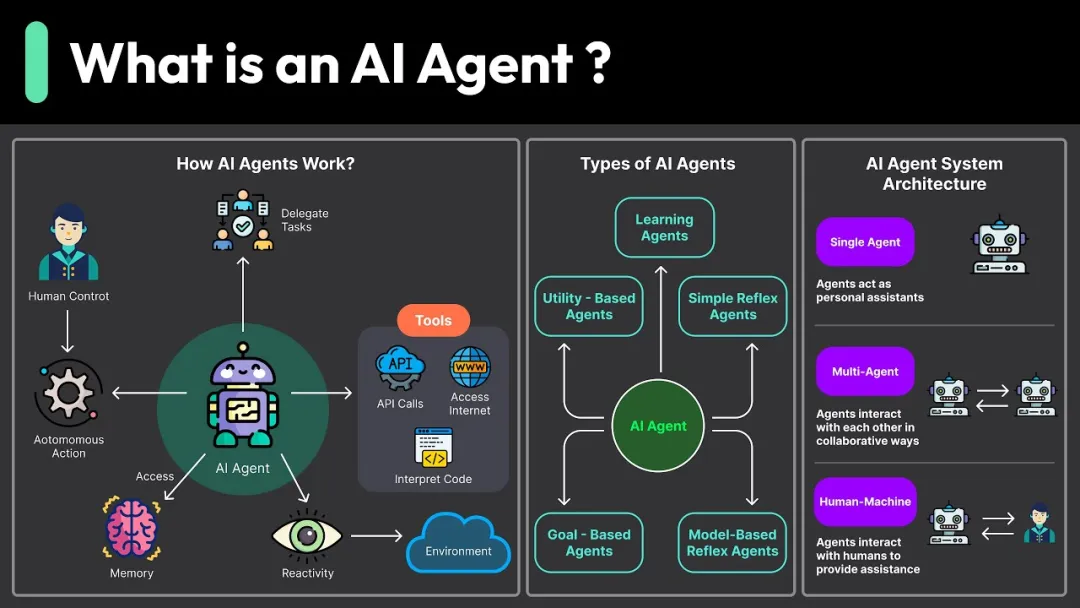
在理解了传统强化学习智能体和基于大语言模型智能体的特点后,我们可以根据具体需求选择最适合的技术路径。

  • 需要精确控制和实时反应 → 传统智能体架构
  • 需要自然语言交互和快速开发 → LLM智能体
  • 需要强大学习能力和长期优化 → 强化学习智能体
  • 需要复杂推理和知识整合 → 混合架构智能体

需要注意的是,LLM智能体的出现并不意味着传统方法的淘汰,而是为我们提供了更丰富的工具箱,让我们能够根据不同的问题选择最合适的解决方案。

深度强化学习实战:从Atari游戏到机械臂控制,一文搞懂核心原理 本文深入解析深度强化学习的核心原理与实践路径,通过对比传统强化学习,重点剖析了DQN和PPO两大核心算法。文章以Atari游戏和机械臂控制为实战案例,阐述了神经网络如何作为函数近似器解决高维状态表征问题,并详细介绍了经验回放、目标网络、策略梯度等关键技术,为开发者提供了从理论到应用的清晰指南。 阅读详情

相关推荐

RNN与强化学习:打造智能体

1. 背景介绍 1.1 人工智能的演进与智能体 人工智能 (AI) 的目标是创造能够像人类一样思考和行动的机器。从早期的符号主义 AI 到如今的深度学习,AI 经历了漫长的发展历程。近年来,强化学习 (Reinforcement Learning, RL) 作为一种新的机器学习范式,在解决复杂

AI天才研究院 835

人工智能基础部分19-强化学习的原理和简单应用,一看就懂

大家好,我是微学AI,今天给大家介绍一下人工智能基础部分19-强化学习的原理和简单应用,随着人工智能的不断发展,各种新兴技术不断涌现。作为人工智能的一个重要分支,强化学习近年来受到了广泛关注。本文将介绍强化学习的原理,并通过一个简单的实例来分析强化学习的运用。

微学AI的博客 4069

AI架构师必知必会系列:强化学习与多智能体系统

作者:禅与计算机程序设计艺术 1.背景介绍 随着人工智能技术的快速发展,越来越多的应用场景需要用到复杂的智能行为,如自动驾驶、机器人控制等。在这些场景中,强化学习作为一种基于试错的学习方法,能够有效提高智能体的自适应能力。同时,由于多智能体系统可以大大降低开发成本,因此在许多领域都有广泛的应用前景。

AI天才研究院 480

什么是强化学习

强化学习是一种独特且强大的机器学习范式,它适用于一系列需要顺序决策和自适应控制的复杂问题。通过不断的探索和实验,强化学习模型学习如何在给定环境中作出最优决策。尽管存在一些挑战,但随着研究的深入和技术的发展,强化学习将在许多领域发挥更大的作用。

十年以上架构设计经验,专注于软件架构和人工智能领域,对机器视觉、NLP、音视频等领域都有涉猎 5099

单细胞分析(五)——使用Harmony进行数据整合和去批次

为了保证单细胞RNA测序数据的准确性和可靠性,需要对数据进行样本去批次处理。去批次的方法包括Harmony,SeuratV3等,这些方法可以有效地消除批次效应和技术噪声,并提高单细胞RNA测序数据的质量,为后续的数据分析提供更加可靠的基础。

阅读文献,记录学习笔记 3万+

创新实训项目博客:基于LoRA的医疗大模型高效微调实战

预训练大语言模型(LLMs)虽然具备了广泛的知识和一定的通用能力,但在特定领域(如医疗)或特定任务(如遵循特定指令格式进行思考链推理)上,其表现往往不尽如人意。微调(Fine-tuning)能够使模型学习到特定领域的数据分布和任务模式,从而在目标任务上获得更好的性能,使其更贴合实际应用需求。使用Unsloth框架加载并以4-bit量化模型。基于数据集,构建了包含明确思考链引导的训练Prompt。配置了LoRA参数,并使用SFTTrainer在单张T4 GPU上对模型进行了高效微调。

m0_73556916的博客 1290

彻底搞懂深度学习:强化学习和智能体(动图讲解)

强化学习与智能体:概念解析与应用对比 强化学习是一种通过试错和反馈来学习最优决策的方法论,核心在于解决"如何学会做决策"的问题。而智能体则是一个完整的自主系统架构,关注如何构建具备感知、决策和执行能力的系统。两者可以独立存在,也可结合形成强化学习智能体(如AlphaGo)。随着大语言模型的发展,出现了新型LLM智能体,通过语言接口实现对话、任务执行和多智能体协作。传统智能体适用于精确控制场景,LLM智能体擅长自然语言交互,强化学习智能体则适合需要长期优化的场景。技术选择应根据具体需求决定

2401_85725028的博客 1178

30天入门Python(办公篇)——第34天:pandas - 数据处理与分析利器

摘要 本文介绍了Python数据分析库pandas的核心功能,包括数据结构和基本操作。主要内容涵盖:1) Series和DataFrame两种核心数据结构的创建与使用;2) 多种文件格式的读写方法;3) 数据查看、筛选和清洗技巧;4) 基础统计分析功能;5) 数据透视表和交叉表制作;6) 数据排序与合并等变换操作。文章通过大量代码示例演示了pandas在数据处理各环节的应用,适合作为pandas入门的实践指南,帮助读者快速掌握这一强大工具的基本使用方法。

weixin_42636075的博客 300

一文彻底搞懂强化学习

最近科技圈的大事件里,有一条消息直接把强化学习的热度拉到了新高度——Meta核心技术团队成员联手创立专注强化学习与世界模型的新机构,主攻通用智能方向,估值与资源投入都堪称行业顶格。不少人刷到新闻时都一头雾水:强化学习到底是什么?为什么能让深耕AI多年的团队专门下场创业?它和日常接触的大模型、生成式AI又有什么关系?这篇文章就用最接地气的方式,从零拆解强化学习的全部核心逻辑,搭配可直接运行的代码案例,把复杂概念拆成生活场景,看完既能懂原理,也能上手实操,彻底吃透这个2026年AI领域的核心赛道。

人工智能AI技术 2453

WPF数据绑定Binding对数据的转换与效验(四)

Binding的作用就是架在Source与Target之间的桥梁,数据可以在这座桥梁的帮助下来流通。就像现实世界中的桥梁会设置一些关卡进行安检一样,Binding这座桥上也可以设置关卡对数据的有效性进行检验,不仅如此,当Binding的两端要求使用不同的数据类型时,我们还可以为数据设置转换器。Binding用于数据有效性检验的关卡是它的ValidationRules属性,用于数据类型转换的关卡是它的Converter属性。

qq_30725967的博客 1626

九天揽月带你玩转Ardupilot 的EKF2纸老虎(1)

目录 目录 摘要 1.kalman基础知识储备 摘要 本文主要记录自己学习ardupilot的ekf2代码的过程,相信很多人想移植或者学习ekf2,看到眼花缭乱的代码无从下手。九天揽月将带你玩转Ardupilot 的EKF2纸老虎 1.kalman基础知识储备 (1)先来看下最基础也是最重要的线性kalman 总结:不要害怕kalman,只要你可以懂得线性kal...

陌城烟雨 1万+

智能体AI Agent入门必读:一文带你彻底搞懂Al Agent!

文章详细解析AI智能体(Agent)技术,介绍其自主性与目标导向特性,从基础到高级的六个发展阶段,以及感知、决策、执行、记忆和学习五大核心模块。通过差旅规划案例展示智能体"感知-思考-行动"的工作流程,探讨不同类型智能体及人机协同的未来,帮助读者全面理解这一从科幻走向现实的技术革命及其应用价值。

m0_74942241的博客 943

【教程4>第6章>第26节】基于FPGA的MMSE信道估计与均衡系统实现与整体测试,并对比LS信道估计

通过前面几个章节的学习,我们完成了MMSE信道估计和均衡系统。为了进一步验证MMSE信道估计的性能,我们在系统的最后,增加一个信道估计误差计算程序。由于MMSE信道估计,其主要优势在SNR较小时提现,因此测试对比时,我们在testbench中,将SNR设置为2db。然后m值,我们不考虑一个固定值,而是一直累加,直到所设置的仿真时间结束。通过对比可以看到,MMSE信道估计性能优于LS信道估计。这样方便FPGA中的误差计算。

FPGA/MATLAB学习教程/源码/项目合作开发 1596

收藏!一文搞懂强化学习如何让LLM更智能:RLHF到GRPO全解析

文章以通俗易懂的方式介绍了强化学习(RL)在大语言模型中的应用,解释了RL的核心概念及其试错学习过程。重点阐述了RLHF技术如何利用人类反馈作为奖励信号来微调预训练模型,使其生成更符合人类偏好的内容。文章还详细介绍了GRPO技术,这种基于组的RLHF方法提供了更稳定的训练过程,已被用于训练GPT-4等先进模型。

Android_XG的博客 827

基于BP神经网络PID控制的电机转速控制器设计复现

摘要:本文提出了一种基于BP神经网络PID控制的永磁同步电机转速控制方法,通过MATLAB/Simulink平台实现了算法复现。系统采用三层BP神经网络在线调整PID参数,包含输入层(误差、误差变化率、误差积分)、5节点隐含层和输出层(Kp、Ki、Kd)。仿真结果表明,相比传统PID控制,该方案具有更快的响应速度(上升时间减少约40%)、更小的超调量(降低约60%)和更强的抗干扰能力,在电动汽车电机驱动等复杂工况下表现优异。文中详细给出了PMSM数学模型建立、BP网络设计、权值更新算法及Simulink仿真

max500600的博客 306

SwinTransformer 改进:SSPCAB模块(2024最新改进方法)

SSPCAB(Spatial Pyramid Pooling with Channel Attention Block)是2024年提出的一种新型神经网络架构改进方法,专注于在保持高精度的同时显著降低计算复杂度和参数量。该方法通过创新的空间金字塔池化与通道注意力机制的结合,实现了网络结构的紧凑化和运算效率的大幅提升。核心创新点1. 混合空间金字塔池化(Hybrid Spatial Pyramid Pooling, HSPP)多尺度动态核池化:根据输入特征图尺寸动态调整池化核大小和步长交叉级联结构。

Henry的博客 1305

一文搞懂AI、机器学习、深度学习与ChatGPT:大模型学习的必经之路!

文章详解了人工智能(AI)、机器学习(ML)、深度学习(DL)和ChatGPT的层级关系:AI是广泛领域,目标是创造智能体;ML是实现AI的主要方法,从数据中学习规律;DL是ML的子集,使用深度神经网络处理非结构化数据;ChatGPT是DL的具体应用,基于Transformer架构的大型语言模型。通过自动驾驶类比帮助理解这种从目标到方法再到应用的层级关系,为学习大模型提供清晰路径。

m0_65555479的博客 1181

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

【机器学习】强化学习入门:从零掌握 Agent 到 DQN 核心概念与 Gym 实战

大家好!欢迎来到我们机器学习探索之旅的第 16 天!在前面的学习中,我们已经接触了监督学习和无监督学习。今天,我们将踏入一个同样令人兴奋且应用广泛的领域——强化学习 (Reinforcement Learning, RL)。想象一下,我们如何学习骑自行车?不是通过阅读说明书,而是通过不断的尝试、摔倒、调整,最终掌握平衡。强化学习正是模拟了这种“试错学习”的过程,让机器(智能体 Agent)在与环境 (Environment) 的交互中学习如何做出最优决策,以获得最大的累积奖励 (Reward)。

吴师兄大模型的博客 1583

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

30行代码搞懂强化学习价值函数:trl库ValueHead实现解析

你是否在训练语言模型时遇到过这些问题?Reward Model(奖励模型)输出不稳定、PPO训练时价值估计偏差大、模型难以判断生成内容质量?本文将带你通过trl库中的[ValueHead](https://link.gitcode.com/i/2529aca0f28c73d9d06a341d488661cf)组件,用30行核心代码理解强化学习中价值函数的实现原理,解决这些实际工程难题。读完本文你将...

gitblog_00676的博客 1014

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

强化学习极简入门:通俗理解MDP、DP MC TD和Q学习、策略梯度、PPO

强化学习里面的概念、公式,相比ML/DL特别多,初学者刚学RL时,很容易被接连不断的概念、公式给绕晕,而且经常忘记概念与公式符号表达的一一对应(包括我自己在1.10日之前对好多满是概念/公式的RL书完全看不下去,如今都看得懂了,故如果读文本之前,你正在被RL各种公式困扰,相信看完这篇RL极简入门后就完全不一样了)。

结构之法 算法之道 14万+

大模型面试题76:强化学习中on-policy和off-policy的区别是什么?

强化学习里的策略,就是智能体(比如机器人、LLM)的“行动指南”——在什么状态下,该做什么动作。游戏AI:血量低于30%(状态)→ 立刻加血(动作);前备箱防夹算法:检测到障碍物(状态)→ 停止关闭并反向(动作);LLM的GRPO训练:收到数学题(状态)→ 生成解题步骤(动作)。策略的本质,就是一个“状态→动作”的映射函数,咱们后面说的“学”和“用”,都是围绕这个函数展开的。on-policy是“自己动手,边做边改”,off-policy是“借鉴经验,择优升级。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 1084

AI、机器学习与深度学习:概念辨析与实战选型指南

人工智能(AI)作为一门让机器模拟人类智能的交叉学科,其核心目标是通过技术实现推理、学习与感知等能力。为实现这一目标,机器学习(ML)作为关键方法论应运而生,它让计算机能够从数据中自动学习规律,而无需依赖显式编程。机器学习的价值在于能够处理规则难以描述的复杂任务,如图像识别和自然语言处理,从而成为推动当前AI发展的主要引擎。在机器学习众多分支中,深度学习(DL)凭借其深层神经网络架构,在特征自动提取方面表现卓越,尤其擅长处理图像、语音等非结构化数据,已成为计算机视觉和自然语言处理等领域的主流技术。本文将从概

chutisun0039的博客 360

强化学习入门:从智能体与环境闭环到Q-learning实战

强化学习是人工智能中一种独特的学习范式,它不同于监督学习依赖标准答案,而是让智能体在与环境的持续交互中,通过试错和延迟奖励来优化决策策略。其核心原理可拆解为状态、动作、奖励、策略与价值五个要素,并通过贝尔曼方程将未来累积回报转化为可迭代求解的动态规划问题。这种基于闭环反馈的机制,让智能体在游戏对战、机器人控制、自动驾驶等序列决策场景中展现出强大的自适应能力。理解折扣因子对长期回报的影响,掌握探索与利用的平衡,是构建高效学习策略的关键。本文从一个6×6网格世界环境出发,带读者亲手实现Q-learning算法,

weixin_34348805的博客 280

HelloAgents实战:从零搭建DQN强化学习训练流程

强化学习是让智能体通过与环境交互学习决策策略的核心技术,但在实战入门时,很多人卡在环境配置、奖励设计和训练调试等环节。本文以CartPole平衡任务为例,介绍一个名为HelloAgents的最小实战项目,手把手拆解从环境搭建、DQN网络设计、经验回放到目标网络更新的完整训练闭环。通过理解epsilon-greedy探索、经验回放缓冲区和目标网络同步等关键机制,即使只有CPU也能快速训练出一个能稳定决策的智能体。这种“先跑通、再深挖”的路径,适合想快速落地强化学习Demo的开发者,也为后续迁移到更复杂任务打下

weixin_29053067的博客 288

极简入门:用Python从零实现Q-learning强化学习智能体

强化学习是机器学习中一种从交互中学习的范式,其核心在于智能体通过试错与环境互动,根据延迟奖励调整策略,最终实现决策优化。与监督学习依赖标签不同,强化学习强调“后果”驱动的学习机制,在游戏AI、机器人控制、路径规划等场景中广泛应用。Q-learning是其中最基础且经典的算法,通过Q表存储状态-动作价值,并使用贝尔曼方程迭代更新,无需神经网络即可处理有限状态空间的决策问题。本文采用纯Python实现一个微型网格世界,从环境搭建到训练循环逐步编码,演示智能体如何从随机碰撞到稳定走向目标。同时剖析奖励设计、超参数

weixin_29040367的博客 139

《动手学大模型智能体》:理论+代码双管齐下,学完就能用的Agent教程!

《动手学大模型智能体》是由上海交大"动手学"团队编写的Agent实战教程,配套资源完善,内容体系化分为四大部分,从基础到前沿全覆盖。每章配有可运行的Jupyter Notebook,实战导向,学完就能用,是2025年AI Agent爆发年的必备学习资源,适合开发者、师生及产品经理等人群。

2401_85327249的博客 1839
上一篇: 吃透AI新一波高薪红利,你只差这一块拼图(大模型LLM)
下一篇: 一区收割机,SAM+医学图像分割为啥刷爆顶会顶刊?新突破!
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值