使用ppo算法解决两足机器人的步行问题,该从什么开始学呢?

腿足机器人之十三-强化学习PPO算法 PPO(Proximal Policy Optimization)算法稳定性强,适合大多数的仿真环境,如MuJoco/Isaac Gym,是初上手的首选,SAC(Soft Actor-Critic )算法在需要高效探索或真实机器人部署(样本成本高)时更优,际工程中,PPO+SAC 组合(如 PPO 微调 + SAC 迁移)已成为提升鲁棒性的常见方案。的,OpenAI一直想做的是AGI,chatGPT是AGI决策中枢,而机器人是AGI在现实世界交互的核心,而机器人运动、姿态控制室交互中的核心。 阅读详情

 为了学习如何使用PPO算法解决两足机器人的步行问题,可以从以下几个方面逐步深入:

强化学习基础

强化学习基本概念

状态(State) : 表征环境的一个向量,可以是关节角度、角速度等。

动作(Action) : 机器人可采取的行为,例如施加在关节上的力矩。

奖励(Reward) : 根据动作的效果给予的反馈,用于指导策略的优化。

环境(Environment) : 机器人与之互动的外部世界,在此环境中,机器人根据当前状态采取行动,并接收新的状态和奖励。

强化学习算法

Q-Learning : 使用Q表存储状态-动作对的价值,适合离散状态和动作空间。

策略梯度(Policy Gradient) : 直接优化策略参数的方法,适合连续动作空间。

深度强化学习基础 

深度Q网络(DQN)

  • 将深度神经网络与Q-Learning结合,用于处理高维状态空间,如图像输入。

深度确定性策略梯度(DDPG)

  • 结合Actor-Critic框架,适用于连续动作空间,通过确定性策略输出连续动作。

PPO算法详解 

PPO基本原理 
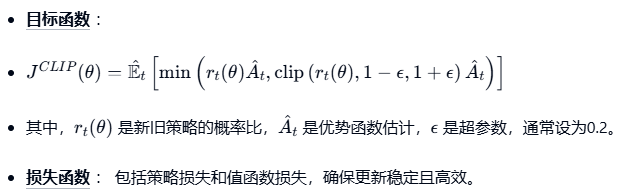
实现细节

  • 重要性采样 : 用于估计新旧策略间的差异,决定是否接受更新。
  • 策略裁剪 : 限制概率比的变化范围,防止策略更新幅度过大。 

两足机器人步行控制 

动态模型

  • 线性倒立摆(LIP)模型 : 用于简化两足机器人步行控制,假设质心高度不变,将复杂的非线性动力学简化为线性方程。
  • 五连杆模型 : 更准确地模拟两足机器人,可用于直接求解关节力矩。 

控制方法

  • 混合零动力(HZD) : 基于虚拟约束的反馈控制方法,常用于全模型和五连杆模型。
  • 模型预测控制(MPC) : 结合DRL预测干扰,提高鲁棒性。 

实践案例 

Mujoco仿真平台

  • 环境搭建 : 使用Mujoco物理引擎创建两足机器人模型,定义状态、动作和奖励函数。
  • PPO算法实现 : 利用OpenAI Baselines或其他RL库实现PPO算法,训练机器人学习步行策略。 

Matlab算例

  • DDPG和TD3算法 : 通过Matlab内置的强化学习工具箱,使用DDPG和TD3算法训练两足机器人沿直线行走。
  • 环境和智能体交互 : 通过Simulink模型实现环境与智能体的交互,进行训练和测试。 

分层控制策略

高级控制策略

  • PPO算法 : 用于优化策略,结合课程学习(Curriculum Learning)提升泛化能力。
  • 优势型演员-评论家框架 : 使用Advantage函数评估动作价值,提高训练稳定性。

低级控制器

  • PD控制器 : 将期望的关节位置转化为实际的关节力矩,频率高达1000Hz。 

总结

通过以上步骤,从基础理论到实践案例,逐步掌握使用PPO算法解决两足机器人步行问题的关键技术和实现方法。结合仿真平台和现有工具,进行实践操作,进一步深化理解和应用能力。 
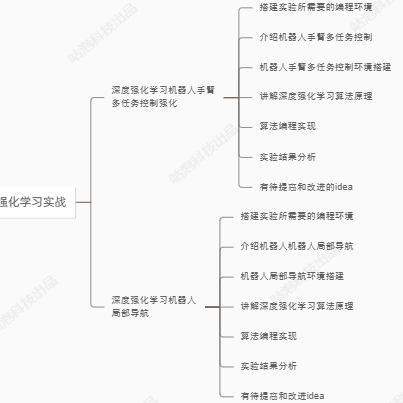

2024年零基础AI学习路线部分新增内容


深入理解PPO算法:从原理到实现 PPO是一种简单且有效的策略优化算法,通过限制策略更新的范围,实现了稳定和高效的策略优化。它不仅在计算上更简单,还在多个复杂任务中取得了优异的表现。随着强化学习的不断发展,PPO已成为解决复杂决策问题的一项强大工具,未来可能会被应用到更多实际场景中。 阅读详情

相关推荐

PPO算法实现:从零开始搭建PPO模型

1.背景介绍 在深度学习领域,强化学习是一个非常重要的研究方向。它的目标是让机器通过与环境的交互,学习到一个策略,使得某个奖励函数的期望值最大。在强化学习的算法中,PPO(Proximal Policy Optimization,近端策略优化)算法是一个非常重要的算法,它在许多任务中都取得了非常好的效果。 PPO算法是由OpenAI在20

AI天才研究院 1592

强化学习------PPO算法

PPO算法之所以被提出,根本原因在于在处理连续动作空间时取值抉择困难。取值过小,就会导致深度强化学习收敛性较差,陷入完不成训练的局面,取值过大则导致新旧策略迭代时数据不一致,造成学习波动较大或局部震荡。除此之外,因为在线学习的性质,进行迭代策略时原先的采样数据无法被重复利用,每次迭代都需要重新采样;同样地置信域策略梯度算法虽然利用重要性采样、共轭梯度法求解提升了样本效率、训练速率等,但在处理函数的二阶近似时会面临计算量过大,以及实现过程复杂、兼容性差等缺陷。而PPO算法具备。

niulinbiao的博客 4万+

PPO算法的挑战与机遇

1. 背景介绍 1.1 深度强化学习的崛起 近年来,深度强化学习(Deep Reinforcement Learning, DRL)在许多领域取得了显著的成功,如游戏、机器人控制、自动驾驶等。DRL结合了深度学习的强大表示能力和强化学习的决策能力,使得计算机能够在复杂的环境中进行自主学习和决策。

AI天才研究院 1188

零基础也能懂的PPO算法指南:从原理公式到机器人控制实战

首先定义AI的“大脑”——策略网络。Pythonnn.ReLU(),nn.ReLU(),nn.Softmax(dim=-1) # 离散空间输出概率PPO凭借其实现简单、稳定性高、对超参数不敏感的特点,还是已经成为目前工业界最实用的RL算法。无论是LLM后的直线(RLHF),自动化生产线上的路径规划,PPO都是首选。一提到“大模型微调”,很多人会默认它是一件高门槛的事。但实际上,真正拉开差距的并不是“会不会写代码”,而是有没有稳定、高性能的训练环境,以及足够灵活的模型与数据支持。像。

kanna1209的博客 687

DPO算法原理及与PPO算法的区别

是一种强化学习中策略梯度算法,旨在在提高模型参数更新效率的同时,保持模型训练的稳定性。PPO通过引入一个 区间限制(clip)的目标函数,防止策略参数更新过大,导致策略崩溃。DPO算法通过直接利用人类的偏好数据,构建了一个简单而有效的策略优化方法,避免了训练奖励模型的复杂性。其核心是最大化偏好输出与不偏好输出的概率差,使策略更倾向于生成被人类偏好的结果。相比之下,PPO算法是一种通用的强化学习策略优化算法,通过限制策略更新的幅度,确保训练的稳定性。PPO通常需要明确的奖励信号,并需要与环境进行大量交互。

u012374012的专栏 3781

强化学习在机器人控制中的应用:使用PPO算法训练类人机器人

本文探讨了强化学习(RL)在机器人控制中的应用,重点介绍了使用Stable-Baselines3库中的PPO算法训练Humanoid-v4环境中的行走机器人。与需要精确模型的传统方法不同,强化学习通过环境交互自主学习最优策略。文章详细解析了PPO算法的原理,包括其改进策略梯度方法的创新点,如裁剪目标函数等技术,在保证训练稳定性的同时简化计算。研究表明,PPO算法能有效解决机器人控制中的复杂决策问题。

古月居 731

3.深度强化学习------PPO(Proximal Policy Optimization)算法资料+原理整理

文章地址: PPO: Proximal Policy Optimization Algorithms 一. PPO资料 PPO原理讲解BLOG①:这篇blog详细讲了PPO算法的产生过程及原理,包含部分理论推导,看完这篇blog基本就理解PPO了。 PPO原理讲解BLOG②:可参考,其中包含部分tensorflow实现代码。 二. PPO原理简述 2.1 背景 PPO是基于基本的Policy Gradient进行改进的算法,关于PG的更新过程这里不详细描述了,可以根据上述BLOG①或其他资料或下面的图片推导

木易进 1万+

(11-1)Proximal Policy Optimization (PPO)算法:PPO算法的背景与概述

Proximal Policy Optimization (PPO) 是一种强化学习算法,用于训练能够执行连续动作的智能体,以最大化累积奖励。PPO是一种改进的策略梯度方法,旨在解决一些传统策略梯度方法的稳定性和样本效率问题。在本章的内容中,将详细讲解Proximal Policy Optimization (PPO)算法的知识,为读者步入后面知识的学习打下基础。

码农三叔 1653

Proximal Policy Optimization(近端策略优化)(PPO)原理详解

PPO主要是针对Important-Sampling产生的不稳定性进行了CLIP操作和罚函数法,相比TRPO方法更简单容易实现,有了策略梯度的定义,可以结合其他Actor-Critic进行联合使用更新,并且PPO将策略梯度缺陷的on-policy变为了off-policy,更大可能的利用了采样样本,效率和速度都有了一定的提升。

lvoutongyi的博客 6392

光电振荡器(OEO):从原理到应用,解锁高频微波信号新纪元

本文深入解析了光电振荡器(OEO)的核心原理与前沿应用。OEO通过巧妙的光-电-光转换机制,利用光学谐振腔产生高频、高纯度、低相位噪声的微波信号,有效突破了传统电子电路的频率瓶颈。文章详细拆解了其工作流程,并探讨了在雷达系统、高速光通信及精密测量等领域的硬核应用价值。

weixin_29231027的博客 367

FC游戏金手指代码大全:亲测可用指南与内存修改原理

在计算机和游戏开发领域,内存修改是一项基础而强大的技术,它通过直接读写程序运行时内存中的数据,改变软件的行为和状态。其核心原理在于理解进程的内存地址空间布局,定位存储关键游戏变量(如生命值、金币数)的特定地址,并注入或锁定目标数值。这项技术的工程价值在于,它不仅能用于游戏辅助,更是软件逆向工程、漏洞分析和调试的重要实践手段。在怀旧游戏和模拟器场景中,内存修改以“金手指”或“作弊码”的形式广泛应用,帮助玩家自定义游戏体验。本文将聚焦FC(红白机)游戏,深入解析Game Genie码和Raw码两种主流金手指格式

weixin_30780649的博客 803

【机器人】基于深度强化学习的两足机器人行走Matlab实现

两足机器人行走,作为一项极具挑战性的课题,长期以来吸引着机器人学界和人工智能领域的广泛关注。传统的基于模型的控制方法,例如零力矩点(ZMP)控制和线性二次高斯(LQG)控制等,虽然在特定环境下能够实现稳定的行走,但其依赖于精确的动力学模型和环境建模,难以应对复杂和非结构化的环境。近年来,深度强化学习(Deep Reinforcement Learning,DRL)凭借其强大的学习能力和适应性,为解决两足机器人行走问题提供了一种全新的思路,并取得了显著的进展。

m0_57702748的博客 1319

RPG MV游戏数据修改指南:从JSON解析到脚本进阶

游戏数据修改是游戏开发与逆向工程中的常见实践,其核心原理在于解析和操作游戏资源文件。许多现代游戏引擎采用结构化数据格式(如JSON)存储游戏配置,这为外部修改提供了可能。通过理解文件结构、数据格式与游戏逻辑的关联,开发者或爱好者可以调整游戏平衡、修复问题或实现个性化定制,这不仅能深化对游戏设计机制的理解,也具备实际的技术学习价值。本文以基于Web技术栈的RPG Maker MV(RPG MV)引擎为例,其游戏数据多以明文JSON存储,结构清晰。文章将具体阐述如何安全地修改角色属性、物品效果、敌人数据及技能公

weixin_29001419的博客 407

【PPO】浅谈ChatGPT等大模型中的PPO算法

PPO(Proximal Policy Optimization)是一种用于策略优化的强化学习算法,由John Schulman等人在2017年提出。旨在提高训练的稳定性和效率。它的目标是找到一个策略,使得根据这个策略采取行动可以获得最大的累积奖励。

程序星空实验室 2525

python实现ECMS算法

ECMS(Equivalent Consumption Minimization Strategy)算法是一种用于混合动力汽车能量管理系统的优化策略。它通过计算等效油耗来平衡电池电量消耗和燃油消耗,从而优化整体能耗。以下是一个简单的Python实现,用于演示ECMS算法的基本思想。这个实现假设了一个简单的混合动力汽车模型,其中电池电量和燃油消耗是主要的优化目标。

weixin_45570158的博客 923

OpenModelica入门指南:从下载安装到第一个仿真模型(附常见问题解答)

本文提供OpenModelica开源项目的完整入门指南,涵盖从下载安装、界面熟悉到构建首个仿真模型的全过程。通过创建经典的阻尼震荡系统实例,详细讲解组件拖放、参数设置、仿真运行及结果分析,并附有常见问题解决方案,帮助工程师和研究人员快速上手这一强大的多领域物理系统建模与仿真工具。

weixin_29239279的博客 730

PPO算法介绍之机器人学走路の奇幻漂流——PPO导演剪辑版

PPO算法介绍之机器人学走路の奇幻漂流——PPO导演剪辑版

尽吾所能 分享永久免费知识 1222

从Xilinx FPGA到MIPI DSI LCD屏:手撸代码的实战经验分享

本文分享了使用Xilinx FPGA驱动MIPI DSI LCD屏的实战经验。作者从依赖官方IP核失败,到与底层D-PHY IP缠斗,最终通过手撸代码,直接配置GTY收发器原语并实现完整的D-PHY与DSI协议栈,成功点亮屏幕。文章详细剖析了协议细节、Vivado工具链的调试技巧与避坑指南,为FPGA工程师提供了从理论到实践的宝贵参考。

weixin_29188997的博客 400

DPO PPO算法

PPO和DPO是两种不同的强化学习算法,分别适用于在线学习和离线偏好学习的场景。PPO通过限制策略更新的幅度来确保训练的稳定性,而DPO通过直接优化策略来匹配人类偏好。两者在优化目标和数据来源上存在显著差异,但都属于策略优化的范畴。

yaohaishen的专栏 3880

2 中望CAD二次开发-绘制图形(ZRX C++)

本文讲解中望CAD二次开发,关于块的概念及基本图形的绘制

cilvsuanna的博客 411

携程机票数据爬取实战:使用 Python 获取携程网机票信息

通过本篇博客,我们详细介绍了如何使用 Python 爬取携程网的机票信息,涉及了静态网页爬取(使用 Requests 和 BeautifulSoup)和动态网页爬取(使用 Selenium)两种方法。通过获取的数据,我们不仅能够进行票价分析,还可以构建更为复杂的预测模型或趋势分析工具。爬虫技术不仅能够帮助我们收集有价值的数据,还能够为商业决策提供数据支持。在实际应用中,我们可以结合更多的分析方法,如自然语言处理、图像处理等,进一步提升数据的价值。

2201_76125261的博客 1658

【强化学习】PPO算法原理及其Python实现

PPO(近端策略优化)算法是强化学习领域的重要突破,通过引入裁剪代理目标函数和重要性采样机制,有效解决了传统策略梯度方法训练不稳定和样本利用率低的问题。本文系统介绍了PPO算法的核心原理、数学基础、实现流程及Python代码示例,并分析了其在游戏AI、机器人控制和自然语言处理等领域的典型应用。文章还探讨了PPO算法的局限性及改进方向,如动态调整裁剪范围、解耦策略更新等前沿优化方法,展望了其在离线学习、多智能体系统等领域的应用前景。PPO算法凭借其高效稳定、易于实现的特点,已成为强化学习研究和应用的重要工具。

大雨淅淅的博客 1856

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

上一篇: 机器学习中有哪些形式简单却很巧妙的idea?
下一篇: DeepSeek15天指导手册一从入门到精通
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值