机器学习中有哪些形式简单却很巧妙的idea?

为什么我的 Spark Executor / Yarn Container 只有一个vCore? 在很多集群里,在关闭了Spark的DynamicAllocation的前提下(避免自动申请空闲资源,干扰测试结果),都会观察到:提交Spark作业时,申请 1 个 driver + n 个 executor 会在Yarn上会对应创建 n+1 个 container,但是每个container只有一个vCore,通过--driver-cores和--executor-cores设定的vCore数都未奏效。有人会因此错误的认为Yarn上的一个vCore对应一个Spark的executor,这是非常错误的,正确的 阅读详情

在机器学习领域,有许多形式简单却非常巧妙的想法(idea)。这些想法往往能够在保证算法简洁性的同时,解决复杂的问题。下面列出了一些典型的例子:

1、异常检测算法:Isolation Forest(孤立森林)

原理:Isolation Forest通过递归地将数据空间分割成子空间,来识别异常点。异常点通常更容易被孤立,因为在空间中与其他点的距离更远。通过构建多棵随机分割的二叉树(隔离树),那些在少数几步分割中就被孤立的点更可能被标记为异常点。  
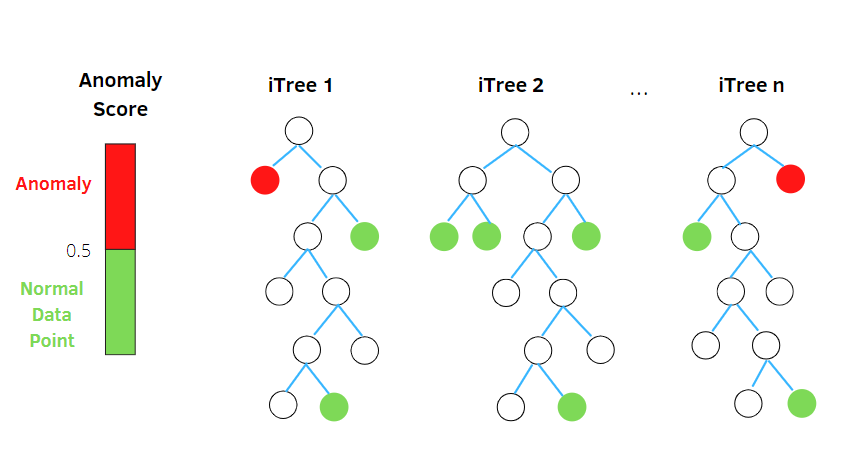
应用场景:异常检测在金融欺诈识别、网络安全等领域有着广泛应用。 

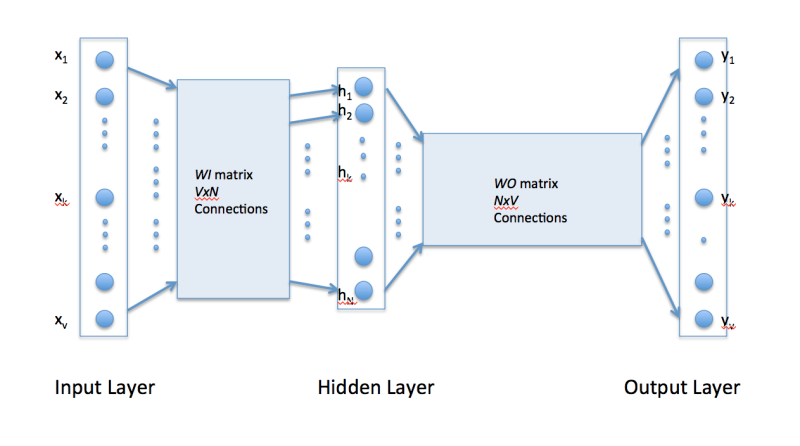
2、Word2Vec 

原理:Word2Vec通过训练神经网络来预测词语在句子中的出现概率,从而将词语转化为稠密向量(词嵌入)。Skip-Gram和CBOW是两种常用的模型架构,前者根据给定词语预测其上下文词语,后者则是根据上下文词语预测给定词语。  

应用场景:词嵌入技术在自然语言处理(NLP)任务中几乎成为了标准做法,如情感分析、命名实体识别等。 
3、成分分析(Principal Component Analysis, PCA)

原理:PCA通过线性变换将原始数据转换到一个新的坐标系,使得数据在第一个坐标轴(主成分)上有最大的方差,依次类推。通过这种方式,可以在减少数据维度的同时保留大部分的信息。  

应用场景:广泛应用于数据降维、可视化以及特征提取等领域。 

4、Residual Learning(残差学习)

原理:在深层神经网络中,随着网络深度增加,会出现梯度消失或爆炸问题,导致训练效果变差。Residual Learning提出了一种残差块(Residual Block)结构,通过在网络中添加捷径连接(Shortcut Connection),使网络可以直接学习残差映射,从而解决了这个问题。  
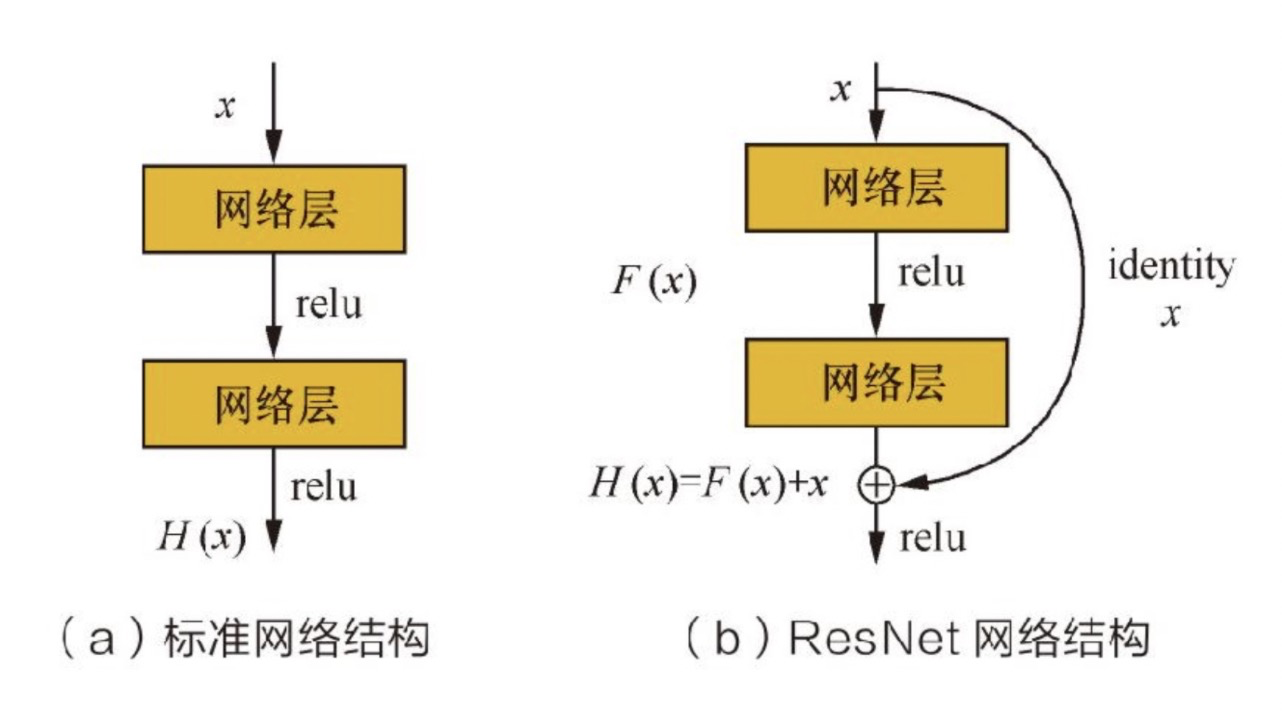
应用场景:残差网络(ResNet)在图像识别、目标检测等多个计算机视觉任务中取得了巨大的成功。 

5、Support Vector Machine(支持向量机,SVM)

原理:SVM通过找到一个最佳的超平面来分割不同类别的数据点,使得各类别之间的间隔最大化。通过使用核技巧(Kernel Trick),SVM还可以有效地处理非线性可分的数据。  

应用场景:SVM在生物信息学、手写数字识别等领域有广泛的应用。 

6、Dropout

原理:Dropout是一种防止神经网络过拟合的技术,通过在每次训练迭代中随机丢弃一部分神经元,强制网络学习更多的独立表示,增加了模型的泛化能力。  

应用场景:广泛应用于各种类型的神经网络中,特别是在大规模深度学习模型中。 

7、Mixup

原理:Mixup通过对输入样本及其标签进行线性插值,生成虚拟的训练样本,从而增强了模型的泛化能力和鲁棒性。  
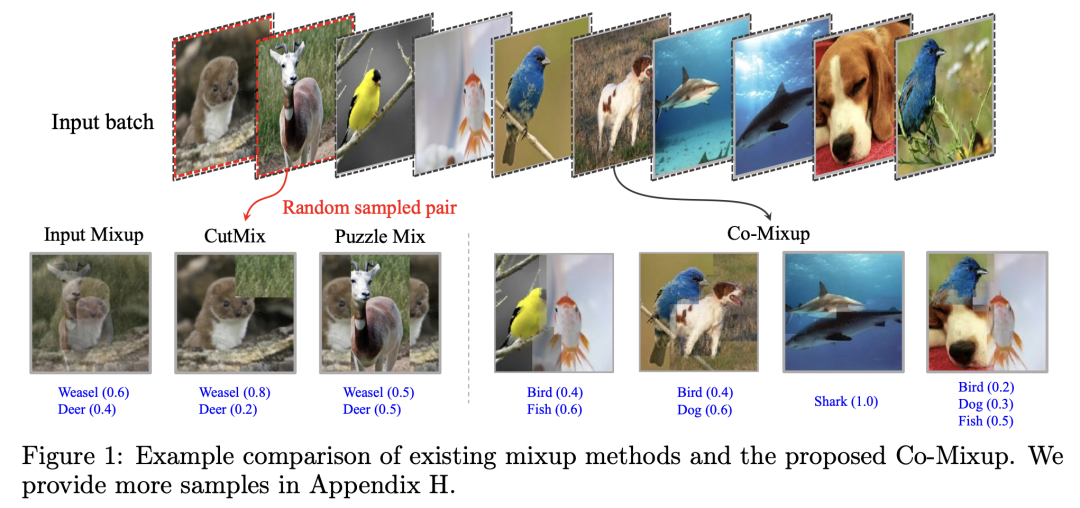
应用场景:图像分类、语音识别等任务中均有应用。 

8、Contrastive Learning(对比学习)

原理:对比学习通过拉近相同类别的样本表示,推开不同类别的样本表示,从而学习到更好的数据表示。  

应用场景:在自监督学习和无监督学习中表现优异,如SimCLR、MoCo等模型。  

这些想法不仅在理论上具有创新性,而且在实践中也得到了广泛验证和应用,推动了机器学习领域的发展。 
甲基化生物信息学分析及批次效应校正全流程 本文系统阐述了DNA甲基化数据分析中的批次效应问题及解决方案。甲基化数据(β值和M值)对实验批次差异高度敏感,可能导致假阳性结果。文章详细介绍了批次效应检测方法(PCA可视化、BEclear定量评分)和校正流程,包括数据预处理、参数化(ComBat-met)与非参数化(BEclear)校正方法,并提供了完整的R代码实现。重点解决了β值有界分布与统计模型假设冲突的问题,为甲基化研究的可靠性提供技术保障。 阅读详情

相关推荐

全志 T527_Android13 编译 [ 避坑必看 ]

Swap 概念: Linux中Swap(即:交换分区),类似于Windows的虚拟内存,就是当内存不足的时候,把一部分硬盘空间虚拟成内存使用,从而解决内存容量不足的情况。它的功能就是在内存不够的情况下,操作系统先把内存中暂时不用的数据,存到硬盘的交换空间,腾出内存来让别的程序运行。当输入编译命令make -j16 的时候,会有如下提示,这是官方建议通过减少编译线程来解决编译时消耗内存过大的问题。Android 13 系统的编译流程,编译一共分为两部分:内核编译与 Android 编译。

公众号:嵌入式分享 2111

机器学习中形式简单却巧妙的idea,看完让人拍案叫绝!!你一定能用得上!!

个即插即用模块的手册,对于只想水篇论文毕业的同学来说,简直轻松又实用,包含注意力机制、卷积变体等等,彻底把你从想创新点、改模型改代码的噩梦中解救出去!通常是独热编码形式的,这样在进行线性插值时才能保持标签空间的连续性。提高泛化能力:通过合成新样本,模型可以学习到更加泛化的特征表示。减少过拟合:平滑的决策边界有助于减少模型对训练数据的过度拟合。之间的标量,它决定了合成样本中每个原始样本的相对贡献。加入到训练集中,然后使用这个扩展的训练集来训练模型。注意,这两个样本可以是不同类别的。

Gupao123的博客 369

debian mirrors 镜像源 riscv 64 赛昉 星光 starfive vf2 InRelease‘ doesn‘t support architecture ‘riscv64‘

debian mirrors 镜像 riscv 64 赛昉 星光2 starfive vf2 InRelease' doesn't support architecture 'riscv64'

qq_29758759的博客 1259

机器学习中有哪些形式简单却很巧妙的 idea?

来源:机器学习与大数据挖掘 本文约1600字,建议阅读5分钟本文介绍了几种企业中简单而适用的算法。 1. 异常检查算法Isolation Forest(孤立森林)作者:桔了个仔htt...

数据派THU 270

【线粒体基因组数据提交实战】从注释校验到GenBank批量入库的避坑指南

本文详细介绍了线粒体基因组数据从注释校验到GenBank批量上传的全流程避坑指南。重点解析了GB2sequin工具的正确使用方法、TBL注释文件的精修技巧,以及BankIt平台提交的隐藏要点,帮助科研人员高效完成NCBI数据提交,特别适合需要批量上传线粒体基因组数据的研究者。

weixin_28726671的博客 444

【OpenCV】图像的像素直方图 图像特征点 cv::FAST cv::ORB ORB_SLAM2::ORB

文章目录图像直方图代码实现cv::FAST和cv::ORB 检测图像特征点cv::FAST和cv::ORB 检测图像特征点代码实现ORB_SLAM2::ORB和自己实现ORB图像特征点检测效果对比ORB_SLAM2::ORB和自己实现ORB图像特征点检测效果对比代码实现 图像直方图代码实现 图像是由不同数值(颜色)的像素构成的,像素值在图像中的分布情况是图像的重要属性,可以用直方图修改图像的外观,标识图像的内容,检测图像中特定的物体或纹理。 单通道灰度图像中每个像素都有一个 0(黑色)-255(白色)的整

小秋 AI SLAM 入门实战教程 2510

idea 无法引入外部依赖_NLP任务中有哪些巧妙的idea?

来源 |https://www.zhihu.com/question/356132676编辑 |磐创AI说明 |仅做学术分享,侵删在自然语言处理领域中,有哪些如Attention机制这种形式简单却功能强大的idea?或是有哪些任务专用的巧妙idea?大家对于一个idea是否巧妙的判定标准是什么?NLP任务包括但不限于:人机对话、问答系统、机器翻译、文本摘要等。作者:邱锡鹏链接:ht...

weixin_39962153的博客 177

【定位模块项目实战】正态分布变换(NDT)定位及建图(依赖高精度点云地图和三维激光雷达的定位方案)

系列文章目录 提示:这里可以添加系列文章的所有文章的目录,目录需要自己手动添加 TODO:写完再整理 文章目录系列文章目录前言一、正态分布变换(NDT)定位解决的主要问题二、正态分布变换(NDT)定位的核心思想三、NDT算法流程1.多元正态分布概念2.网格化并计算正态分布参数3.变换参数和最大似然四、使用C++实现NDT配准参考资料 前言 认知有限,望大家多多包涵,有什么问题也希望能够与大家多交流,共同成长! 本文先对依赖高精度地图和激光雷达的定位技术–正态分布变换(NDT)定位做个简单的介绍,具体

qq_35635374的博客 4412

图机器学习基础知识——CS224W(02-tradition-ml)

图机器学习基础知识——CS224W(02-tradition-ml)

WindGrin_的博客 1107

SerDes学习笔记:接收机CTLE均衡架构示例(USB3.1、PCIe3.0\4.0\5.0)

本文分析了USB3.1和PCIe标准中连续时间线性均衡器(CTLE)的设计演进。USB3.1Gen1采用一阶CTLE,其传递函数在长信道下具有有源滤波器特性;Gen2版本延续类似架构,通过Adc参数调节零点频率。PCIeGen3/4保持一阶结构但调整极点位置,Gen5升级为二阶传递函数,扩展Adc调节范围至-5dB~-15dB。研究表明,CTLE能有效改善信号完整性,通过参数优化可平衡信号衰减与码间干扰抑制。

一只豌豆象的博客 626

广联达Linkworks ArchiveWebService XML实体注入漏洞复现

广联达 LinkWorks /GB/LK/Document/ArchiveService/ArchiveWebService.asmx接口处存在XML实体注入漏洞,未经身份认证的攻击者可以利用此漏洞读取系统内部敏感文件,获取敏感信息,使系统处于极不安全的状态。

0xSec 2722

利用Idea创建Spark工程以及简单读取文件

文章目录Spark创建工程安装scala插件scala sdk配置spark代码 Spark创建工程 安装scala插件 Idea默认是不能创建Scala工程的。需要安装idea的scala插件 方法一:利用系统在线下载 方法二:方法一失效的情况下,可以在官网下载好后选择手动上传 注意:加载后需要重启Idea才能生效 scala sdk配置 利用maven下载对应的jar包 <dependency> <groupId>org.scala-lang</groupI

giantleech的博客 1166

边缘AI工业落地:YOLO26-Seg + RK3588 NPU 极致部署(低功耗+实时实例分割,工业场景全覆盖)

本次实战汇总了「YOLO26-Seg+RK3588 NPU」工业边缘部署中最常见、最致命的8个坑点,所有坑点均来自真实工业项目,解决方案均为零代码/一键操作,无需复杂配置,能让你少走90%的弯路,节省大量时间,必看必记!❌ RKNN转换报错「算子不支持/模型加载失败」→ ✅ 导出ONNX时必须指定opset=12,重新导出即可,RK3588唯一兼容版本;❌ 分割mask错位/轮廓模糊 → ✅ 导出ONNX时加,并保证RKNN的归一化参数与YOLO26一致,零代码修复;

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1719

Java机器学习库(Java ML)(二、聚类)

本文章翻译至Java ML技术文档clustering.pdf,代码部分是参考该文档使用IDEA编写,同时加入了运行结果。 聚类 本章将提供有关聚类算法,聚类评估措施以及与聚类数据相关的其他文档。 我们假设您已熟悉Java ML的基础知识,如入门教程中所述(http://java-ml.sourceforge.net)。数据集下载地址:https://download.youkuaiyun.com/do...

dbzzcz的博客 2369

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

无贡献、无创新、无思路,ML领域准博士求助:论文到底要怎么创新? | Reddit热议...

来源丨量子位编辑丨极市平台导读如何在机器学习领域写论文时保证创新性?机器学习领域水写论文日常:△图源推特:AI Memes for Artificially Intelligent Te...

3D视觉工坊 715

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

不要再水论文了,机器学习论文写作指南放送!

看到这个标题,本科研狗沉默了……诗里是,想起一生中后悔的事,梅花便落满了南山。而科研狗是,想起自己水过的论文,尴尬的用脚抠出了三室一厅……谁不想成为手握几篇科研巨作的大佬呢!然而现实却往往很打脸。呕心沥血写出来的“大作”在导师眼里不如一堆垃圾……从诞生以来,机器学习的流行势头始终不减。相关的研究论文数量也每年剧增。根据之前的数据显示,机器学习与概率推理这一研究方向的论文数...

datayx的文章 998

IDEA 2020 路线图,中文版要来了!

推荐阅读:2020 年最新 Spring 框架维护路线图上个月 JetBrains 发布了 IntelliJ 平台 2020 年路线图,现在作为 2020 年规划中的另一部分,JetBr...

Java技术栈,分享最主流的Java技术 5751

idea构建post请求_IDEA-HTTP工具

IDEA-HTTP工具在intellij idea2017.3版本中,增加了一个类VS Code的Rest-client的工具,通过这个工具我们可以完成绝大部分http请求,是一个不错的post-man替代工具,接下来详细讲讲它如何简化你的操作。请求示例所有HTTP请求需要在后缀为.http的文件中进行,新建一个test.http文件。基本格式为:请求类型(如:GET, POST,PUT) + ...

weixin_39801714的博客 3139

牛逼! IDEA 2020 要本土化,真的是全中文了!

点击上方“朱小厮的博客”,选择“设为星标”后台回复”加群“获取公众号专属群聊入口来源:rrd.me/grt2c前不久 JetBrains 发布了 IntelliJ 平台 2020 年路线...

朱小厮的博客 1万+

属性子集选择的基本启发方法_Java机器学习库(Java ML)(三、特征选择)

本文章翻译至Java ML技术文档featureselection.pdf,代码部分是参考该文档使用IDEA编写,同时加入了运行结果。特征选择本文简要介绍了功能选择的概念。在本章的其他小节中,我们讨论与特征选择有关的几个主题。特征选择主要有三种类型:(i)特征评分,(ii)特征等级和(iii)特征子集选择。特征评分是最通用的方法,可以在后两种方法中进行转换,而特征排名只能转换为特征子集选择方法,这...

weixin_35698738的博客 265

IDEA插件--Lombok

IDEA插件–Lombok 在Java编程时,写完字段后,需要一个一个去写getter和setter方法。在使用Idea编程时,可以按住ALT+INSERT键,让IDE自动生成getter, setter, toString等方法。 然而,当一个类的字段特别多时,整个文件看起来将非常不简洁。所幸IDEA提供了一款lombok插件,可以在代码阶段,通过添加注解的形式,省去手写getter, setter的麻烦。 文章目录IDEA插件--Lombok前言一、Lombok是什么?二、安装和使用步骤1.插件安装2

qq_43054104的博客 2259

IDEA 的Http工具小结

IDEA 的Http工具小结 通过这个工具我们可以完成绝大部分http请求,是一个不错的post-man替代工具,接下来详细讲讲它如何简化你的操作 1.请求示例 描述: 所有HTTP请求需要在后缀为.http的文件中进行,新建一个test.http文件。基本格式为: 请求类型(如:GET, POST,PUT) + 请求地址(http://www.baidu.com) 请求头 ... 请...

转身那一瞬 2647

基于Spark的机器学习实践 (一) - 初识机器学习

1 导学 1.1 开源大数据技术 1.2 提高竞争力必备 1.3 教程规划 1.7 预备知识 了解大数据相关基础知识 熟悉Linux基本命令 熟悉Scala语言的编程方法 有一定的数学基础 1.8 环境参数 Spark : 2.3.0 JDK : 1.8 IDE : IDEA 2 机器学习概述 2.1 机器学习概念 2.2 机器学习发展史 2.3 机器学...

weixin_34087503的博客 618
上一篇: 硕士论文写YOLO可以毕业吗?
下一篇: 使用ppo算法解决两足机器人的步行问题,该从什么开始学呢?
大模型星球
博客等级 码龄5年 1132粉丝 239原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值