大模型有什么发展瓶颈?

大模型发展瓶颈:算力、数据、对齐与系统工程的深度解析与破局思路 人工智能领域,尤其是大规模语言模型的发展,正从追求参数规模的狂热阶段,转向对核心瓶颈的冷静审视。其技术原理建立在海量数据训练与巨大算力消耗之上,旨在实现通用任务处理能力。然而,当前的技术价值实现正面临多重挑战:算力扩张的边际效益递减,高质量训练数据日趋稀缺,模型行为与人类价值观的对齐困难,以及超大规模分布式系统的工程复杂度。这些挑战共同构成了大模型深入应用的关键制约。具体到应用场景,无论是垂直领域的专业模型构建,还是高并发、低延迟的推理服务部署,都亟需在计算效率、数据质量、安全可控和系统稳定性上取得突破。本 阅读详情

如果我们相信未来比今天更好,坚信自己生活在一个好地方,所要做的便是认识到未来时代的特征和规律。把握住一些不变的道理,使用正确的方法,做那些能够不断让自己获得可叠加式进步的事情,这样便能立于不败之地。—吴军

最近关注两个方向,也是公司重点发展和投资的两个方向,一是数据资产入表,二是大模型及应用。前段时间写数据资产入表相关内容更多一些,利用假期,把最近一些大模型相关的信息做一个整理,给大家做一个分享。

一、为什么开源LLama?*背后的商业逻辑与赚钱之道*

近日,Meta公司发布了迄今为止功能最强大的公开可用的语言大模型(LLM)——LLaMA3。

这一版本在庞大的15万亿个Token数据上进行预训练,提供了8B和70B两种参数规模,以满足不同用户场景的广泛需求。LLaMA3在各种行业基准测试中均取得了最先进的性能。

值得一提的是,除了现有的8B和70B参数规模的模型外,LLaMA3还有一个更为庞大的400B参数模型正在训练中。这预示着LLaMA3在未来将拥有更加强大的能力和更广泛的应用前景。

首先,我们来看看Meta为什么要花如此巨大的资源来开发并开源LLaMA3。

据悉,Meta为了这个项目动用了16000颗GPU,加上长期的测试准备、电力耗费及人员储备,整体投入高达每月上亿。但为何扎克伯格愿意投入如此之多?这背后与Meta的战略布局密不可分。

Meta的核心商业模式是广告,无论是Facebook、Instagram还是WhatsApp,都依赖于用户的粘性。

然而,随着技术的不断进步,新型创新公司有可能通过技术的爆发,改变用户的粘性。如果这种粘性转移到了另一家公司,那对Meta来说无疑是巨大的威胁。OpenAI的ChatGPT就是一个潜在的竞争者,它的出现已经引发了业界的广泛关注。

为了应对这种潜在的威胁,Meta选择了开源LLaMA3这一策略。通过开源,Meta不仅能够在市场推广中获得极大助力,还能吸引更多的开发者、初创企业加入到他们的技术路线中来,共同构建一个庞大的AI生态。
图片

开源Llama3后,Meta如何赚钱呢?

首先,让我们回顾一下开源的历史。以安卓为例,谷歌通过开源这一策略,吸引了全球无数开发者和手机厂商加入其生态系统。

在这个过程中,谷歌通过广告收入(AdSense和AdWords)、应用商店收入(Google Play)、服务和应用销售(Gmail、Google Maps)、硬件销售以及生态合作伙伴等方式,实现了巨大的商业收益。可以说,掌握着整个生态系统的底座,就是躺赚的开始。

那么,Meta又是如何打算的呢?他们表示,“我们的策略是构建并开放源代码通用基础设施,同时保留我们的具体产品实现为专有技术。”

这句话透露出两层含义:一是Meta愿意开放其大模型的源代码,吸引更多开发者和企业加入其生态系统;二是Meta将保留其核心技术和产品实现,确保自己的竞争优势不被削弱。

这里,我们不妨回顾一下OpenAI的历程。OpenAI之所以名为“OpenAI”,是因为其早期模型GPT-1、GPT-2都是开源的。然而,随着GPT-3的发布,OpenAI却选择了闭源。

这一举动引起了业界的广泛讨论,**甚至有人戏称OpenAI应当改名*为“CloseAI”。*但无论如何,OpenAI的开源闭源策略都证明了开源和闭源并非水火不容,而是可以根据商业布局策略进行灵活调整。

那么,开源会不会削弱Meta的核心竞争力呢?答案是否定的。Meta在开源的同时,对开源的环节、流程和各种限制条件进行了精心设计。这些限制条件确保了Meta的核心技术和产品实现不会被轻易复制或模仿,从而保障了其竞争优势。

当然,这也引发了一些专业人士的质疑和嘲讽,认为Meta的做法“违返开源精神”。但商业世界从来都不是纯粹的道德世界,竞争和利益才是永恒的主题。

那么,Meta通过开源大模型能赚到哪些钱呢?

首先,通过吸引更多开发者和企业加入其生态系统,Meta可以进一步扩大其用户基数和市场份额。这将为其带来更多的广告收入和商业合作机会。

其次,Meta可以通过提供高级版或定制版的大模型服务,向企业收取一定的费用。这些服务将基于Meta的核心技术和产品实现,确保其竞争优势的持续性。

最后,Meta还可以利用其在AI领域的技术积累和生态优势,开展更多与AI相关的业务和合作,实现多元化收益。

总之,Meta开源大模型的背后隐藏着深刻的商业逻辑和赚钱之道。通过开源策略吸引更多开发者和企业加入其生态系统,同时保留核心技术和产品实现为专有技术,Meta在保障自己竞争优势的同时也为未来的发展奠定了坚实的基础。

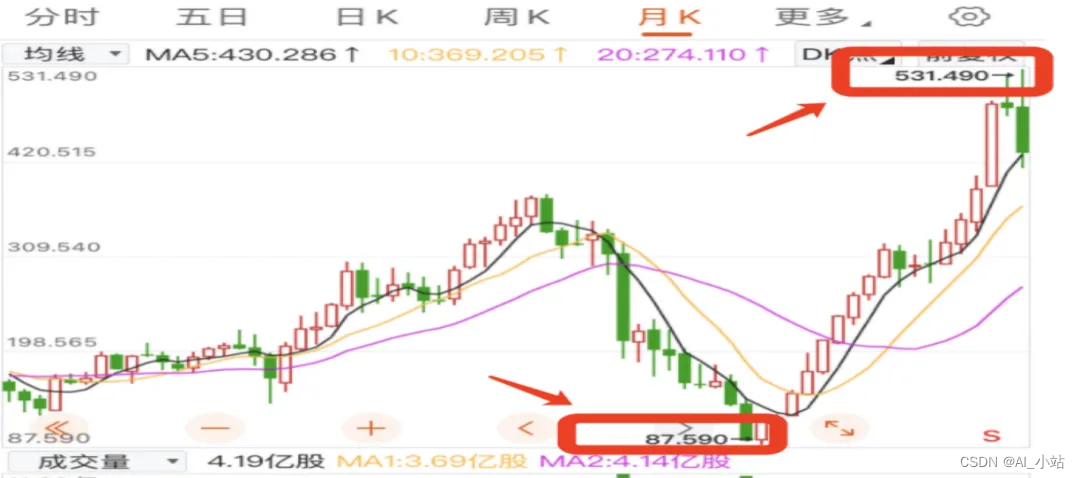
自从Meta全力投入元宇宙领域以来,小扎终于通过开源Llama3走出了困境,这个大坑爬的确实刺激。
在这里插入图片描述

二、大模型的发展瓶颈

大模型技术的飞速发展正不断刷新着我们的认知。然而,随着技术的深入,大模型未来的发展瓶颈也逐渐显现。
图片

关于这一点,个人还是很赞同张俊林的观点。

目前AIGC高速发展本质上还是吃的数据红利,如果GPT5达不到AGI,同时合成数据也没有技术突破,那么大模型能否通向AGI就存在很大疑问。

到了明年(2025年)下半年,可能用来训练大语言模型的高质量新数据就没有了,靠线性新增数据支持指数速度发展的模型能力是不够的。如果“合成数据”在未来两年不能取得突破性进展,大模型发展速度会骤然下降,无法维持目前这种高速发展的局面。

总体而言,“合成数据”是个新兴研究方向,还很不成熟,目前尚未能看到能主导未来技术方向的主流方法,探索性和不确定性比较强。

目前能看到的“合成数据”应用的最好的产品应该是DALLE-3,以及Sora,就是里面的图像和视频Re-caption模型,本质上这就是机器产生的“合成数据”。

“合成数据”目前应该投入大量资源来做,这是未雨绸缪,也能形成核心竞争力。

寄希望于多模态数据来大幅增强大模型的关键能力,比如逻辑推理能力,目前看只是很多人的愿望,目前并无明确的数据或实验能支持这一点。我个人认为这条路走不通。所以不应该把进一步提升AGI能力的希望寄托在多模态数据上。

未来如何,取决于我们在“合成数据”上的进展,有两种不同的未来图景。

一种是,长时间内合成数据无法大规模实用化。如果这样,未来会出现如下现象:大模型能力基本到顶,各种质疑目前AGI技术路线的声音会逐步放大,而开源和闭源模型能力会持平。

这对于很多闭源模型公司来说是灭顶之灾(尽管我们可以继续通过放大模型规模来进一步提升模型能力,但是模型能力增长曲线会比现在平缓很多,即模型能力“加速度差”减小,开源模型较为容易赶上闭源模型)。

另外一种,是在未来两年内要么我们在“合成数据”方面取得大进展,要么即使没有新数据,但是我们有突破性的技术,可以在数据量不变情况下,极大提升大模型的数据利用效率(相同数据量,相同模型大小,如果模型效果更好,则说明模型的数据利用率更高。当然这块目前也未看到可以主导未来发展的主流技术)。

那么,我们会继续按照Scaling law往后发展,就是继续增加新数据,推大模型规模,来持续增强模型能力。

如果这样,AGI是可能通过大模型技术路线达到的,而在这种情况下,意味着需要相比目前数以十倍、百倍的资源投入,基本是个天文数字了,而在如此巨量投入的情况下,Meta等公司是否还会这样大力度支持开源就是有疑问的,此时开源模型是有可能越来越落后于闭源模型的。

三、一键部署LLaMA3

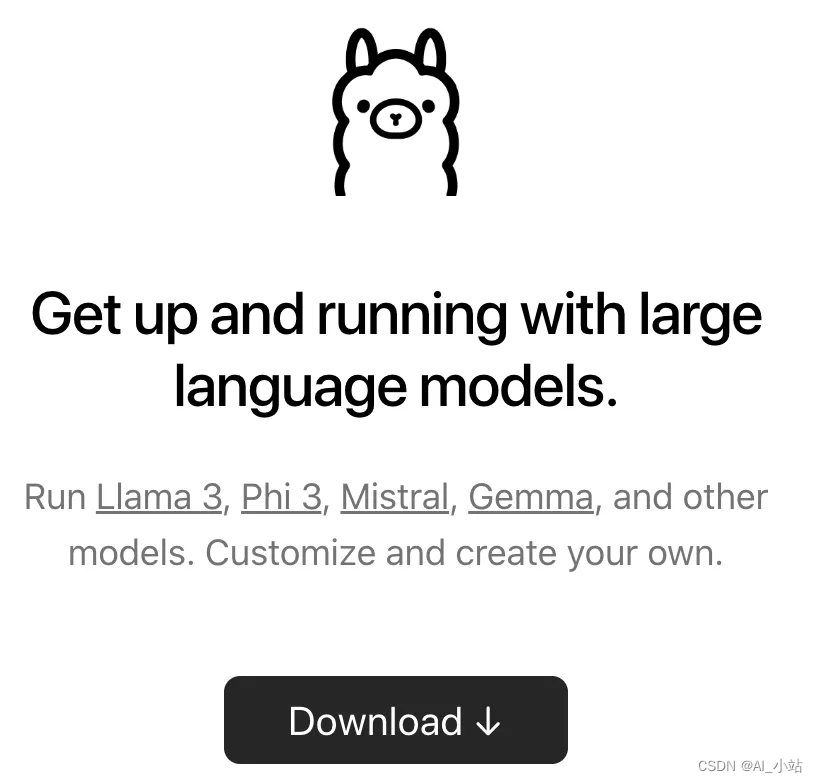
Ollama是一款由Meta公司开源的本地化管理大模型工具包,它支持多个大模型的本地化部署、管理以及运行,使得我们能够方便地将大模型下载至本地,并进行快速的调试操作。

跑8B版本,个人电脑配置基本够用,本人笔记本是6核CPU,16G内存。

  1. 安装Ollama

安装地址:ollama.com

进入网站后,点击“DownLoad”,选择电脑对应的系统。
在这里插入图片描述

下载之后,点击Next以及Install安装ollama到命令行。安装完成后界面上会提示ollama run llama2,不需要执行这条命令,因为我们要安装llama3。

2.下载Llama3

打开新的终端/命令行窗口,执行以下命令:

ollama run llama3

程序会自动下载LLaMA3的模型文件,默认是8B,也就80亿参数版本,个人电脑完全可以运行。

成功下载模型后,我们可以直接在终端和Llama3进行对话,比如提问Who are you?,基本可以实现即时回复。

vbnet
➜  Projects ollama run llama3
>>> who are you?
I'm LLaMA, a large language model trained by a team of researcher at Meta 
AI. I'm here to chat with you and answer any questions you may have.

I've been trained on a massive dataset of text from the internet and can 
generate human-like responses to a wide range of topics and questions. My 
training data includes but is not limited to:

* Web pages
* Books
* Articles
* Research papers
* Conversations

* I'm constantly learning and improving my responses based on the 
* conversations I have with users like you.

* So, what's on your mind? Do you have a question or topic you'd like to 
* discuss?

至此,我们已经成功运行LLaMA3。当然可以继续安装WebUI,可以通过Web页面交互,后续会进行相关分享。


优快云独家福利

最后,感谢每一个认真阅读我文章的人,礼尚往来总是要有的,下面资料虽然不是什么很值钱的东西,如果你用得到的话可以直接拿走:

飞书云文档API操作详细介绍 开通云文档API、python程序调用飞书api、飞书获取app_id和app_secret、 阅读详情

相关推荐

ERA5气象数据下载与解压全攻略:Python脚本一键搞定(附错误处理技巧)

本文提供了一套完整的ERA5气象数据自动化处理方案,涵盖从CDS API配置、智能批量下载到高效解压与数据验证的全流程。重点介绍了如何通过Python脚本实现一键式数据下载与批量解压,并分享了实用的错误处理技巧与性能优化策略,帮助科研人员高效获取和处理大规模气象数据。

k8l9m0n的博客 340

大模型训练触达「瓶颈」,基座模型厂商还有必要坚持预训练吗?

进入2024年来,中国大模型行业从狂奔进入到了“长跑阶段”。无论是在技术侧,还是在产业侧,行业内都产生了更多新的思考。从技术发展上看,在算力受限的情况下,中国基座模型的研发能力在全球范围内处在什么身位、如何追赶国外顶尖大模型等问题引发外界关注,甚至一度传出“中国大模型公司可以不用再做模型预训练”的说法。o1 模型的发布更是进一步加剧了这一讨论。外界可以看到的是,通过强化学习磨练思维链, o1 显著提高了逻辑推理能力,特别是在复杂数学和编程任务上都有着十分惊艳的成果。

2401_84204207的博客 1320

VS2022+Qt6保姆级配置指南:从插件安装到项目互通全流程(附常见错误解决)

本文提供了一份详细的Visual Studio 2022与Qt6集成开发环境配置指南。从插件安装、环境搭建到项目创建与互通,涵盖了全流程操作步骤,并针对常见的配置错误和调试问题提供了实用的解决方案,帮助开发者高效构建企业级桌面应用。

nginx7reverse的博客 1208

大模型发展的五大核心技术瓶颈

大模型当前面临的核心技术瓶颈与挑战主要包括算力瓶颈、高质量数据局限、能耗与成本、模型泛化与可信赖性、以及长上下文处理与多模态对齐等几个方面,这些挑战相互交织,共同制约着大模型的进一步发展和应用落地。

qq_35090060的博客 463

避坑指南:CoppeliaSim逆运动学仿真常见报错解决方案(附UR5+RG2爪完整Lua脚本)

本文针对CoppeliaSim机器人仿真中常见的逆运动学报错问题,提供了详细的避坑指南和解决方案。文章以UR5机械臂与RG2夹爪组合为例,深入剖析了模型装配、Dummy节点配置、Lua脚本编写等关键步骤中的常见错误,并附带了完整的、带错误处理的脚本代码,帮助用户快速定位并解决IK仿真失败问题,提升仿真效率。

weixin_29054399的博客 268

qupath再度更新:使用WSInfer进行深度学习

我们在下面提供了一个示例,说明如何使用 WSInfer 创建 WSI 中肿瘤和肿瘤浸润淋巴细胞 (TIL) 的空间图谱,这些图谱被认为在几种癌症中既有预后又有预测意义6,10,11,12.由于 WSI 非常大,因此它们通常被分解为补丁,以使分析变得可行。补丁分类的输出通常是空间分类地图,通常可以跨 WSI 集成,以创建表示该幻灯片的诊断、预测或“分数”的单个输出。在当前的实施中,我们专注于斑块分类的通用任务,该任务广泛用于广泛的病理学应用,具有促进诊断、预后或预测功能的深度学习模型。

hx2024的博客 2203

AI大模型学习的未来发展趋势、挑战及技术瓶颈分析

在当前技术环境下,AI大模型学习正处于快速发展的阶段。研究者们需要具备深厚的数学基础和编程能力,同时对特定领域的业务场景有深入的了解。通过不断优化模型结构和算法,AI大模型学习能够不断提升模型的准确性和效率,为人类生活和工作带来更多便利。然而,未来发展中也面临着一些挑战和难题。

Shy_Cloud的博客 1857

Unity 2022打包Android APK:手把手教你创建和配置第一个签名Keystore(避坑指南)

本文详细介绍了Unity 2022打包Android APK时创建和配置签名Keystore的全流程,包括环境准备、Keystore创建、高级配置避坑指南以及签名验证与故障排查。特别强调了Android应用签名的重要性及安全维护策略,帮助开发者避免常见错误,确保应用顺利发布。

weixin_27379781的博客 243

大模型发展瓶颈与效率优化实践

Transformer架构作为当前大模型的核心基础,其注意力机制的计算复杂度问题随着模型规模扩大日益凸显。从技术原理看,标准注意力计算的O(n²)复杂度导致计算资源消耗呈指数级增长,而模型性能提升却呈现边际递减效应。在工程实践中,混合专家系统(MoE)和模型蒸馏等创新方法能有效提升计算效率,其中MoE通过动态激活专家模块可实现3倍推理加速。这些技术在多模态融合、长文本处理等场景具有重要应用价值,特别是在应对数据质量精炼和架构优化等大模型发展瓶颈时尤为关键。当前研究趋势表明,结合数据质量评估框架DQE-7和模

weixin_34094282的博客 45

人工智能训练师三级补贴3120元申领全攻略|条件+流程+五省市对比

补贴是真的,但不是"白给"的。你需要满足社保、户籍、时间等条件,严格按照流程操作。记住四件事先确认自己是否满足条件,再报名——别考完了才发现领不到紧缺工种补贴更高——确认你所在城市是否在紧缺目录中证书下发后12个月内申请——设个日历提醒材料准备齐全再提交——避免来回折腾如果你正在考虑考人工智能训练师三级证书,想要从报名到备考到拿证到申领补贴的完整一站式指南,欢迎查看我的付费专栏:📖《人工智能训练师三级·从零到拿证完全指南》80篇系统化内容,覆盖报名、备考、冲刺、拿证全流程。

白话机器学习 1543

【IPC】ONVIF Device Manager 测试工具

介绍onvif 协议测试工具

以实战经验介绍行业知识 1963

聊聊大模型:开源LLaMA背后的底层逻辑与赚钱之道?大模型的发展瓶颈?如何一键部署LLaMA3?

如果我们相信未来比今天更好,坚信自己生活在一个好地方,所要做的便是认识到未来时代的特征和规律。把握住一些不变的道理,使用正确的方法,做那些能够不断让自己获得可叠加式进步的事情,这样便能立于不败之地。—吴军最近关注两个方向,也是公司重点发展和投资的两个方向,一是数据资产入表,二是大模型及应用。前段时间写数据资产入表相关内容更多一些,利用假期,把最近一些大模型相关的信息做一个整理,给大家做一个分享。背后的商业逻辑与赚钱之道*

2401_85328934的博客 1532

两组相机(或三维点)对齐方法介绍及实现代码(求解相似变换,包含旋转R、平移t、尺度s)

  这个变换用于将生成的稀疏重建场景对齐到真值上。由于SfM(Structure from Motion,运动恢复结构)求解的结果是尺度未定的,所以重建场景与真值之间不仅会相差一个旋转与平移,还会存在尺度缩放。待求解的问题可以描述为:已知一组相机(个数为m)的位姿真值Rgt、tgt和预测位姿Rpred、tpred,现要将预测值对齐到真值上。它们之间会相差一个相似变换Msimilarity,包括尺度s、旋转量R、平移量t,可以根据如下步骤进行求解:    1 求解旋转R   首先计算所有m个相机的位姿差异总和

zeeq的博客 3928

大模型发展瓶颈深度解析:算力、数据、对齐与系统工程

在人工智能领域,大模型已成为推动技术进步的核心引擎。其工作原理基于海量数据和强大算力,通过深度学习算法进行训练,旨在模拟人类的认知与生成能力。这项技术的核心价值在于能够处理复杂的自然语言任务,实现智能对话、内容创作和决策支持。随着技术进入深水区,其应用场景也从早期的探索性研究,扩展到企业服务、内容生成和垂直行业解决方案。然而,要实现模型的稳定、高效与可控,必须直面算力瓶颈、数据瓶颈、对齐瓶颈和系统工程瓶颈等关键挑战。其中,**系统工程**能力是确保模型从实验室原型转化为可靠服务的基石,而**合成数据**技术

weixin_30562507的博客 344

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

AI发展遇瓶颈?大模型落地工程破局实战指南

大模型的能力增长正从“拼参数规模”转向“拼工程效率”,数据枯竭、算力成本高企、评测饱和等现象,让AI落地进入深水区。面对幻觉、推理不稳定、Agent失控等真实挑战,工程优化成为比模型选型更关键的变量。模型压缩手段如量化与知识蒸馏可大幅降低推理成本,vLLM等高效推理引擎则能提升部署吞吐;RAG通过混合检索与重排提升知识库问答准确率,Agent编排需要白名单与步骤上限保障可控性,评测闭环则为迭代提供客观依据。数据飞轮与领域微调进一步构建竞争壁垒。本文从工程实践视角拆解瓶颈成因,给出可落地的优化路线,帮助开发者

weixin_29051149的博客 347

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

大模型发展瓶颈:算力、数据、对齐与系统工程的挑战与破局

大语言模型(LLM)作为人工智能领域的前沿技术,其核心原理是基于海量数据与Transformer架构进行预训练,通过自注意力机制捕捉长距离依赖关系,从而获得强大的语言理解和生成能力。这一技术的核心价值在于能够作为通用基础模型,赋能搜索、对话、代码生成等广泛场景。然而,要将潜力转化为实际生产力,必须克服从训练到部署的全链路工程挑战。当前,行业正面临算力成本与效率、高质量数据稀缺、模型安全对齐以及生产级系统工程四大核心瓶颈。例如,算力瓶颈催生了MoE架构、量化、编译优化等关键技术,以提升硬件利用率;数据瓶颈则推

weixin_33901641的博客 482

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

破解 Token 经济时代推理瓶颈|泛联亮相 2026 算力网发展大会,UbiPower 18000 构筑大模型推理硬核底座

业务形态从传统单轮对话转向多轮累积交互,批处理并行规模成倍扩张,上下文长度从 4K-32K Tokens 暴涨至 64K-256K Tokens,叠加 RAG 外部数据动态注入,KV Cache 的数据规模出现数倍至十余倍的激增,GPU HBM 显存容量瓶颈愈发凸显。大会立足产业全局,紧扣 “十五五” 算力基础设施建设任务,锚定技术创新、生态共建、场景落地三大方向,汇聚产业力量、凝聚行业共识,支撑全国一体化算力网络建设,释放算力赋能实体经济的价值。,一举拿下 8 个测试场景第一,15 项指标第一。

UBIX2022的博客 63

【AI大模型发展】人工智能正在突破最大瓶颈——从静态AI到自我进化智能体!

对首个关于自我进化智能体的系统调查的全面分析。我们探究了能够学习和适应的人工智能的“是什么、何时以及如何”,规划了从静态大语言模型(LLMs)到人工超级智能(ASI)潜力的发展路径。 我们正处在人工智能领域一个引人入胜的转折点。驱动ChatGPT等工具的大语言模型(LLMs)已成为知识巨头,能够生成流畅的文本、编写代码并回答复杂问题。然而,尽管它们功能强大,却存在一个基本的、近乎矛盾的弱点:它们是静态的。

2401_85325557的博客 942

AI发展太慢?从大模型推理到端侧部署的工程化落地瓶颈与加速思路

大模型推理效率与端侧部署是当前AI工程化的核心挑战。模型能力虽在基准测试上快速提升,但推理成本、延迟约束与数据闭环断裂导致实际落地周期长达12至18个月。量化、蒸馏与编译优化可降低首token延迟,而分级降级与动态批处理则保障服务稳定性。在智能客服、实时翻译与移动端AI助手等场景中,任务完成率比模型准确率更能反映真实体验。本文围绕AI落地慢的体感,拆解从训练到推理全链路的工程化瓶颈,并给出可操作的加速思路。

weixin_29038303的博客 262

AI发展遇瓶颈?从Scaling Law到大模型评估选型实战指南

在人工智能领域,关于大模型能力增长放缓的讨论日益增多,Scaling Law是否失效成为核心争议。实际上,基础模型正从规模扩张进入精细化工程阶段,架构创新趋缓但系统优化、后训练策略与评测方法论仍在加速演进。面对模型能力曲线变平,技术团队更需要建立科学的模型评估与选型机制,而非单纯追逐新版本。从回归测试集设计、批量评测脚本到资源监控与延迟分位分析,一套可复用的评估流程能有效区分模型能力问题与环境工程问题,帮助开发者在多模型共存的时代做出可靠决策。本文从AI发展瓶颈的争议出发,深入解析技术信号,并给出动手落地的

weixin_29057237的博客 309

传统预训练正走向终结,推理优化与后训练提升有限,大模型今后如何突破发展瓶颈?

主动构建多任务样本,实现数据生成与学习闭环。无需大规模人工标注,即可高效扩展预训练数据,根本性缓解当前高质量多模态数据稀缺的问题。

qingkahui24689的博客 1196

万字综述解读|大模型落地实体机器人:发展、瓶颈与未来路线

由中国电信TeleAI白辰甲、清华学者许华哲、李学龙发表的《大模型驱动的具身智能:发展与挑战》,梳理近300篇前沿文献,搭建起完整技术体系,清晰划分五大赋能范式,系统剖析行业六大核心瓶颈,为服务机器人、人形智能、工业操控等领域提供权威参考。本文首次以大模型赋能路径为核心分类标准,把海量碎片化研究规整为环境感知、任务规划、基础策略、奖励函数、数据生成五大统一范式,形成“感知-认知-决策-训练-数据”全链路闭环体系,读者可快速定位细分赛道、代表算法与技术优劣。更换机器人外形、地形、物体材质后策略直接失效;

张杰的博客 439

大模型≠通用人工智能:当前AI发展的关键瓶颈解析

大语言模型(LLM)作为当前人工智能的核心技术,其规模扩张已逼近算力与数据边际效益拐点。从技术原理看,LLM本质是统计模式匹配系统,缺乏因果推理、具身认知与持续自主学习能力——这正是通向通用人工智能(AGI)所缺失的底层机制。其技术价值集中于垂直场景的高效文本生成与信息检索,但在需要真实世界交互、多模态协同与目标驱动演化的任务中表现受限。典型应用场景包括智能客服、代码辅助、文档摘要等确定性高、反馈闭环强的工程化落地环节。本文聚焦LLM能力边界与AGI本质要求之间的结构性鸿沟,结合可验证的实验现象与主流评估框

weixin_30905133的博客 299

GPT-5.1深夜发布却无惊喜?从GPT-5.1看大模型发展瓶颈

当AI的进化带来的惊喜越来越少,我们不禁要问:大模型时代是否已经触及天花板?

SJJS_1的博客 1029

(什么是AI大模型)大模型入门到精通,收藏这篇就够了!一文搞懂什么是大模型?

典型模型参数对比(2023)models = {保持学习:每周跟踪arXiv最新论文实战优先:从微调开源模型(如LLaMA)开始关注伦理:建立AI安全防护意识技术交流:你在实际项目中遇到过大模型应用的哪些挑战?欢迎评论区讨论!

2401_84204413的博客 1740

2024中国AI大模型产业发展报告

来源 | 数据观、人民网日前,人民网财经研究院、至顶科技联合发布《开启智能新时代:2024年中国AI大模型产业发展报告》(以下简称《报告》),对于AI大模型产业发展背景、产业发展现状、典型案例、挑战及未来趋势等方面进行了系统全面的梳理,为政府部门、行业从业者以及社会公众更好地了解AI大模型产业提供参考。政策、技术、市场驱动AI大模型产业发展近年来,我国始终高度重视人工智能发展机遇和顶层设计,发布多...

weixin_49393016的博客 696
上一篇: 开源模型是什么意思?什么是开源大模型
下一篇: 向量数据库是什么
大模型应用场景
博客等级 码龄5年 7683粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值