为什么开源LLama?背后的逻辑是什么?

Vicuna-13B本地部署实战:llama.cpp量化推理与GGUF优化指南 大语言模型本地部署是AI工程化落地的关键环节,其核心在于平衡显存占用、推理精度与运行效率。Vicuna-13B作为主流开源对话模型,具备较强中文理解能力,但原生PyTorch加载易触发CUDA内存溢出;而llama.cpp通过GGUF格式封装、细粒度量化(如Q4_K_M)及C++底层优化,显著提升稳定性与可控性。GGUF不仅存储权重,更固化RoPE参数、词表映射等运行时元数据,保障跨平台行为一致;量化则需在精度与资源间权衡,非越低越好。本文聚焦显存受限环境(如单卡RTX 3090),详解从编译、模型验证、P 阅读详情

如果我们相信未来比今天更好,坚信自己生活在一个好地方,所要做的便是认识到未来时代的特征和规律。把握住一些不变的道理,使用正确的方法,做那些能够不断让自己获得可叠加式进步的事情,这样便能立于不败之地。—吴军

最近关注两个方向,也是公司重点发展和投资的两个方向,一是数据资产入表,二是大模型及应用。前段时间写数据资产入表相关内容更多一些,利用假期,把最近一些大模型相关的信息做一个整理,给大家做一个分享。

一、为什么开源LLama?*背后的商业逻辑与赚钱之道*

近日,Meta公司发布了迄今为止功能最强大的公开可用的语言大模型(LLM)——LLaMA3。

这一版本在庞大的15万亿个Token数据上进行预训练,提供了8B和70B两种参数规模,以满足不同用户场景的广泛需求。LLaMA3在各种行业基准测试中均取得了最先进的性能。

值得一提的是,除了现有的8B和70B参数规模的模型外,LLaMA3还有一个更为庞大的400B参数模型正在训练中。这预示着LLaMA3在未来将拥有更加强大的能力和更广泛的应用前景。

首先,我们来看看Meta为什么要花如此巨大的资源来开发并开源LLaMA3。

据悉,Meta为了这个项目动用了16000颗GPU,加上长期的测试准备、电力耗费及人员储备,整体投入高达每月上亿。但为何扎克伯格愿意投入如此之多?这背后与Meta的战略布局密不可分。

Meta的核心商业模式是广告,无论是Facebook、Instagram还是WhatsApp,都依赖于用户的粘性。

然而,随着技术的不断进步,新型创新公司有可能通过技术的爆发,改变用户的粘性。如果这种粘性转移到了另一家公司,那对Meta来说无疑是巨大的威胁。OpenAI的ChatGPT就是一个潜在的竞争者,它的出现已经引发了业界的广泛关注。

为了应对这种潜在的威胁,Meta选择了开源LLaMA3这一策略。通过开源,Meta不仅能够在市场推广中获得极大助力,还能吸引更多的开发者、初创企业加入到他们的技术路线中来,共同构建一个庞大的AI生态。
图片

开源Llama3后,Meta如何赚钱呢?

首先,让我们回顾一下开源的历史。以安卓为例,谷歌通过开源这一策略,吸引了全球无数开发者和手机厂商加入其生态系统。

在这个过程中,谷歌通过广告收入(AdSense和AdWords)、应用商店收入(Google Play)、服务和应用销售(Gmail、Google Maps)、硬件销售以及生态合作伙伴等方式,实现了巨大的商业收益。可以说,掌握着整个生态系统的底座,就是躺赚的开始。

那么,Meta又是如何打算的呢?他们表示,“我们的策略是构建并开放源代码通用基础设施,同时保留我们的具体产品实现为专有技术。”

这句话透露出两层含义:一是Meta愿意开放其大模型的源代码,吸引更多开发者和企业加入其生态系统;二是Meta将保留其核心技术和产品实现,确保自己的竞争优势不被削弱。

这里,我们不妨回顾一下OpenAI的历程。OpenAI之所以名为“OpenAI”,是因为其早期模型GPT-1、GPT-2都是开源的。然而,随着GPT-3的发布,OpenAI却选择了闭源。

这一举动引起了业界的广泛讨论,**甚至有人戏称OpenAI应当改名*为“CloseAI”。*但无论如何,OpenAI的开源闭源策略都证明了开源和闭源并非水火不容,而是可以根据商业布局策略进行灵活调整。

那么,开源会不会削弱Meta的核心竞争力呢?答案是否定的。Meta在开源的同时,对开源的环节、流程和各种限制条件进行了精心设计。这些限制条件确保了Meta的核心技术和产品实现不会被轻易复制或模仿,从而保障了其竞争优势。

当然,这也引发了一些专业人士的质疑和嘲讽,认为Meta的做法“违返开源精神”。但商业世界从来都不是纯粹的道德世界,竞争和利益才是永恒的主题。

那么,Meta通过开源大模型能赚到哪些钱呢?

首先,通过吸引更多开发者和企业加入其生态系统,Meta可以进一步扩大其用户基数和市场份额。这将为其带来更多的广告收入和商业合作机会。

其次,Meta可以通过提供高级版或定制版的大模型服务,向企业收取一定的费用。这些服务将基于Meta的核心技术和产品实现,确保其竞争优势的持续性。

最后,Meta还可以利用其在AI领域的技术积累和生态优势,开展更多与AI相关的业务和合作,实现多元化收益。

总之,Meta开源大模型的背后隐藏着深刻的商业逻辑和赚钱之道。通过开源策略吸引更多开发者和企业加入其生态系统,同时保留核心技术和产品实现为专有技术,Meta在保障自己竞争优势的同时也为未来的发展奠定了坚实的基础。

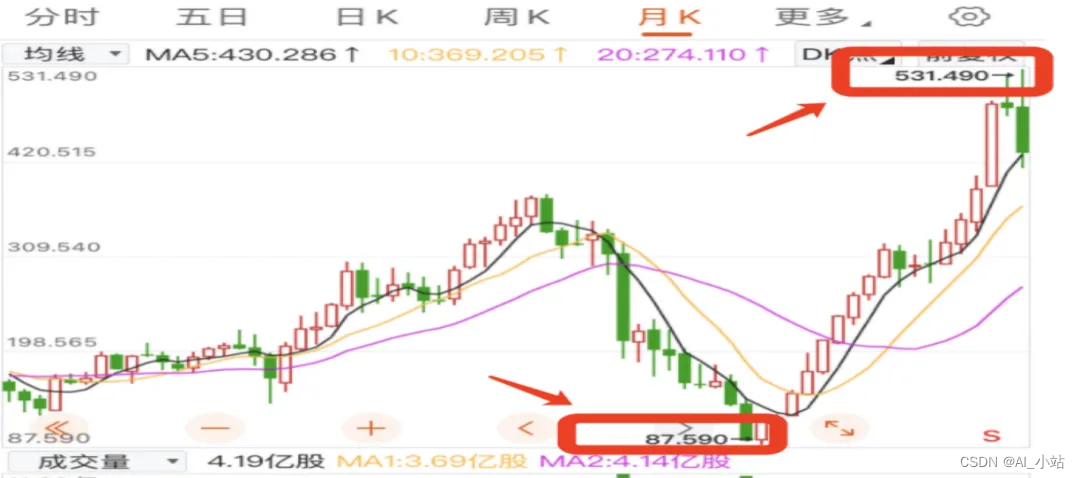
自从Meta全力投入元宇宙领域以来,小扎终于通过开源Llama3走出了困境,这个大坑爬的确实刺激。
在这里插入图片描述

二、大模型的发展瓶颈

大模型技术的飞速发展正不断刷新着我们的认知。然而,随着技术的深入,大模型未来的发展瓶颈也逐渐显现。
图片

关于这一点,个人还是很赞同张俊林的观点。

目前AIGC高速发展本质上还是吃的数据红利,如果GPT5达不到AGI,同时合成数据也没有技术突破,那么大模型能否通向AGI就存在很大疑问。

到了明年(2025年)下半年,可能用来训练大语言模型的高质量新数据就没有了,靠线性新增数据支持指数速度发展的模型能力是不够的。如果“合成数据”在未来两年不能取得突破性进展,大模型发展速度会骤然下降,无法维持目前这种高速发展的局面。

总体而言,“合成数据”是个新兴研究方向,还很不成熟,目前尚未能看到能主导未来技术方向的主流方法,探索性和不确定性比较强。

目前能看到的“合成数据”应用的最好的产品应该是DALLE-3,以及Sora,就是里面的图像和视频Re-caption模型,本质上这就是机器产生的“合成数据”。

“合成数据”目前应该投入大量资源来做,这是未雨绸缪,也能形成核心竞争力。

寄希望于多模态数据来大幅增强大模型的关键能力,比如逻辑推理能力,目前看只是很多人的愿望,目前并无明确的数据或实验能支持这一点。我个人认为这条路走不通。所以不应该把进一步提升AGI能力的希望寄托在多模态数据上。

未来如何,取决于我们在“合成数据”上的进展,有两种不同的未来图景。

一种是,长时间内合成数据无法大规模实用化。如果这样,未来会出现如下现象:大模型能力基本到顶,各种质疑目前AGI技术路线的声音会逐步放大,而开源和闭源模型能力会持平。

这对于很多闭源模型公司来说是灭顶之灾(尽管我们可以继续通过放大模型规模来进一步提升模型能力,但是模型能力增长曲线会比现在平缓很多,即模型能力“加速度差”减小,开源模型较为容易赶上闭源模型)。

另外一种,是在未来两年内要么我们在“合成数据”方面取得大进展,要么即使没有新数据,但是我们有突破性的技术,可以在数据量不变情况下,极大提升大模型的数据利用效率(相同数据量,相同模型大小,如果模型效果更好,则说明模型的数据利用率更高。当然这块目前也未看到可以主导未来发展的主流技术)。

那么,我们会继续按照Scaling law往后发展,就是继续增加新数据,推大模型规模,来持续增强模型能力。

如果这样,AGI是可能通过大模型技术路线达到的,而在这种情况下,意味着需要相比目前数以十倍、百倍的资源投入,基本是个天文数字了,而在如此巨量投入的情况下,Meta等公司是否还会这样大力度支持开源就是有疑问的,此时开源模型是有可能越来越落后于闭源模型的。

三、一键部署LLaMA3

Ollama是一款由Meta公司开源的本地化管理大模型工具包,它支持多个大模型的本地化部署、管理以及运行,使得我们能够方便地将大模型下载至本地,并进行快速的调试操作。

跑8B版本,个人电脑配置基本够用,本人笔记本是6核CPU,16G内存。

  1. 安装Ollama

安装地址:ollama.com

进入网站后,点击“DownLoad”,选择电脑对应的系统。
在这里插入图片描述

下载之后,点击Next以及Install安装ollama到命令行。安装完成后界面上会提示ollama run llama2,不需要执行这条命令,因为我们要安装llama3。

2.下载Llama3

打开新的终端/命令行窗口,执行以下命令:

ollama run llama3

程序会自动下载LLaMA3的模型文件,默认是8B,也就80亿参数版本,个人电脑完全可以运行。

成功下载模型后,我们可以直接在终端和Llama3进行对话,比如提问Who are you?,基本可以实现即时回复。

vbnet
➜  Projects ollama run llama3
>>> who are you?
I'm LLaMA, a large language model trained by a team of researcher at Meta 
AI. I'm here to chat with you and answer any questions you may have.

I've been trained on a massive dataset of text from the internet and can 
generate human-like responses to a wide range of topics and questions. My 
training data includes but is not limited to:

* Web pages
* Books
* Articles
* Research papers
* Conversations

* I'm constantly learning and improving my responses based on the 
* conversations I have with users like you.

* So, what's on your mind? Do you have a question or topic you'd like to 
* discuss?

至此,我们已经成功运行LLaMA3。当然可以继续安装WebUI,可以通过Web页面交互,后续会进行相关分享。


优快云独家福利

最后,感谢每一个认真阅读我文章的人,礼尚往来总是要有的,下面资料虽然不是什么很值钱的东西,如果你用得到的话可以直接拿走:

Vicuna-13B本地部署实战:llama.cpp+FastAPI轻量级生产方案 大语言模型(LLM)本地化部署正成为企业AI落地的关键路径,其核心在于平衡推理性能、硬件兼容性与工程可控性。基于llama.cpp的GGUF量化技术可将13B级模型压缩至5GB以内,实现CPU端稳定推理;FastAPI与Uvicorn组合则提供高并发、自文档化的RESTful接口能力。该方案规避了PyTorch显存瓶颈、Ollama黑盒封装及Flask GIL限制,特别适合知识库问答、智能客服、技术文档摘要等中低延迟业务场景。本文聚焦Vicuna-13B在消费级设备(如M1 Mac)上的端到端部署,涵盖4- 阅读详情

相关推荐

Vicuna微调实战:LoRA+ShareGPT如何让Llama-13B成为落地首选

大语言模型对话能力并非天然具备,而是依赖指令微调与高质量对话数据的协同优化。Vicuna作为Llama生态中最具工程落地价值的开源对话模型,其核心在于将ShareGPT真实用户对话轨迹转化为结构化训练信号,并通过LoRA低秩适配实现高效、稳定、可复现的轻量微调。它不追求参数规模,而聚焦于意图理解、上下文连贯与响应可控性三大实用指标,在AlpacaEval等权威榜单持续领先。尤其适合客服系统、知识库问答与低代码集成等对延迟敏感、需快速迭代的生产场景。本文深入解析Vicuna的数据构造逻辑、LoRA关键超参设定

weixin_34079177的博客 253

什么是开源?为什么要坚持开源?

高度自主、安全可控、开放自由,开源让这个世界产生更多的交互、分享,拥抱更多未知和可能性

weixin_46880696的博客 2万+

从LLaMA到Alpaca:开源大语言模型微调实战与生态解析

大语言模型(LLM)作为当前人工智能领域的核心技术,其核心原理是基于Transformer架构的海量参数模型,通过在大规模文本数据上进行预训练,学习语言的统计规律与知识表示。这项技术的核心价值在于,它能够理解和生成人类语言,实现智能对话、内容创作、代码生成等多种任务,极大地推动了人机交互和自动化生产力的发展。在实际应用中,为了将通用的基础模型适配到特定领域或任务,微调技术变得至关重要。其中,参数高效微调方法,特别是LoRA及其量化版本QLoRA,因其能大幅降低计算和显存需求,已成为工程实践中的主流选择。通过

weixin_42524100的博客 223

怎样查看一个网站是用什么开源程序做的?

判断一个网站是由哪种语言开发的方法,那么当需要知道一个网站是用的什么开源程序搭建时,我们该怎么查看和识别呢?在这之前,我们首先应该确保自己了解有哪些常见网站程序可直接拿来用?,有了一定知识储备才能谈得上识别。每一种开源程序只要没有被深度二次开发,它的固有特征就总能被找出来。   一、WordPress博客系统网站特征:   1、查看网页源代码,搜索看是否有wp-content、wp-i

互联网传奇爱好者 1万+

华为CNA VRM搭建(使用vmware worfstartion搭建)

华为CNA和VRM在 vmware workstation安装使用

weixin_70595351的博客 1813

OpenMMLab实战指南:从环境搭建到首个检测模型运行

本文是一份详细的OpenMMLab实战指南,重点介绍了如何从零开始搭建环境并运行首个目标检测模型。内容涵盖Miniconda环境配置、PyTorch与CUDA版本匹配、使用MIM工具安装MMCV和MMDetection的核心步骤,并通过RTMDet-tiny模型演示了完整的推理流程,帮助开发者高效入门这一计算机视觉开源算法体系。

weixin_28678151的博客 159

扎克伯格:为什么AI大模型应该开源?

我们希望能拥有自己的定制芯片,然后先用它来训练一些简单的东西,最终也会实现用它来训练大型AI模型的目标。这个计划进展顺利,我们有一个长期路线图,会有条不紊地推出它。3。

xxue345678的博客 1354

人工势场法在自动驾驶避障中的实践与优化

本文深入探讨了人工势场法在自动驾驶避障中的核心原理与实践优化。通过解析引力与斥力模型,揭示了经典算法在局部最优和目标不可达等问题上的局限性,并重点介绍了改进斥力场函数、引入道路边界斥力及动态参数调整等关键优化策略,有效提升了该局部路径规划算法在复杂动态场景下的实用性与鲁棒性。

weixin_29208327的博客 929

什么是开源?开源等于免费吗?

来源:C语言中文网编辑整理:strongerHuang有不少人认为开源就是免费,其实这个观点是错误的,今天就来谈谈关于开源的内容。一、关于开源开源软件在追求“自由”的同时,不能牺牲程序员...

张巧龙的博客 2万+

计算机国际会议中的proceedings、conference、paper、workshop、demo:如何区分与选择?

本文详细解析了计算机国际会议中的核心概念:Conference(会议)是学术交流的主舞台,Paper(论文)是研究成果的书面呈现,被接收后收录于Proceedings(会议论文集)。Workshop(研讨会)聚焦前沿细分领域,Demo(演示)则侧重系统与工具的可交互展示。文章为研究者根据自身阶段与工作类型,如何区分与选择投稿目标提供了实用指南。

weixin_29269441的博客 563

在Qt中集成VTK和PCL:实现数据可视化的完整指南

在现代软件开发中,数据可视化至关重要。将VTK(Visualization Toolkit)和PCL(Point Cloud Library)集成到Qt环境里,能为开发者提供强大的可视化解决方案。本文将深入讲解如何在Qt中读取PCL文件,展示VTK模型和PCL数据,适合想要在Qt项目中实现数据可视化的开发者。

轩宇的博客 918

聊聊大模型:开源LLaMA背后的底层逻辑与赚钱之道?大模型的发展瓶颈?如何一键部署LLaMA3?

如果我们相信未来比今天更好,坚信自己生活在一个好地方,所要做的便是认识到未来时代的特征和规律。把握住一些不变的道理,使用正确的方法,做那些能够不断让自己获得可叠加式进步的事情,这样便能立于不败之地。—吴军最近关注两个方向,也是公司重点发展和投资的两个方向,一是数据资产入表,二是大模型及应用。前段时间写数据资产入表相关内容更多一些,利用假期,把最近一些大模型相关的信息做一个整理,给大家做一个分享。背后的商业逻辑与赚钱之道*

python1234567_的博客 2576

【AI测试干货】软件测试 - 全流程提示词完整体系

本篇教程是一套专为软件测试工程师打造的 AI 协作提示词体系。从测试计划制定、用例设计、自动化脚本开发、缺陷管理,到测试报告生成,每个环节都提供了结构化的提示词模板,帮助测试人员高效利用 AI 提升工作质量。

blues_C的博客 356

深度好文:为什么说LLaMA比ChatGPT更“可怕”?从开源爆款到AI基石,它正在悄悄改变一切!

如果你经常关注 AI 领域,大概率听过 “LLaMA” 这个大模型 —— 它可能藏在你用的智能客服背后,支撑着小众工具的对话功能,甚至是开发者手里最常摆弄的开源模型。但它到底是什么?为什么能成为 AI 圈的 “现象级选手”?从初版到最新的 LLaMA 4,它又经历了哪些关键进化?

m0_59163425的博客 1682

金融领域必备:Python爬虫+AI量化分析,爬取股票数据并实现智能交易策略

本文通过Python爬虫+AI量化分析的组合,实现了从股票数据爬取到智能交易策略的全流程。免费获取全维度金融数据(行情、财务、舆情),替代付费终端;用LSTM模型捕捉股价的时间序列规律,提升预测精度;基于Backtrader实现策略回测与优化,保证策略的有效性。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1373

芒果YOLOv5改进107:ARConv自适应旋转卷积,全网首发 | 即插即用:以增强其表征能力,从而准确检测方向物体,ICCV顶会论文idea

ARConv自适应旋转卷积,全网首发 | 即插即用:以增强其表征能力,从而准确检测方向物体,ICCV顶会论文idea

包括YOLOv5、YOLOv7、YOLOv8等模型改进 960

DAMODEL平台|Llama 3.1 开源模型快速部署:从零到上线

传统的模型往往在面对长篇大论时会出现信息丢失或生成不连贯的情况,但Llama 3.1 405B不仅能够理解复杂的长文本,还能生成条理清晰、逻辑性强的回应。例如,如何优化这些庞大的模型以适应特定的应用场景,如何提高模型的可解释性,确保其决策过程透明且可信,如何保证模型在实际使用中不会出现安全隐患,都是我们在未来需要面对的重要问题。总的来说,Llama 3.1 405B的发布不仅推动了自然语言处理技术的发展,也为我们带来了更多创新的机会。Llama 3.1作为强大的语言模型,在客户服务领域展现出巨大潜力。

专注于 C/C++ 后端开发,涵盖基础语法、Linux系统与网络、MySQL数据库、常见算法及项目经验。 6881

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

AI那些趣事系列108:一文轻松读懂 LLaMA 系列模型:从 Meta 开源爆款到 AI 生态基石

让它分析一篇学术论文,它能提炼核心观点,甚至指出潜在漏洞。简单说,它是 Meta(原来的 Facebook)开发的一款 “通用语言 AI大模型”—— 就像一个天生会 “读” 会 “写” 的智能大脑,能理解文字意思,还能生成连贯的内容。2025 年 4 月,Meta 发布的 LLaMA 4 堪称 “革命性升级”—— 它不再局限于 “文本处理”,而是变成了能看、能听、能记千万字的 “全能助手”,还一口气推出三个版本(Scout、Maverick、Behemoth),覆盖从边缘设备到企业级的所有场景。

abc50319的专栏 1368

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

Vicuna开源对话银行客服智能问答训练流程

本文探讨Vicuna开源模型在银行客服场景的应用,涵盖模型原理、数据预处理、微调优化及系统部署,强调其在提升服务效率与合规性方面的优势。

weixin_42601608的博客 667

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

llama.cpp、Ollama、LM Studio:背后是谁在做?为什么会出现?要什么机器才能跑?

底层引擎 + 极客能力”👉 Ollama =“本地模型服务器(开发用)”“本地 ChatGPT 应用”

Anthony1453的博客 895

Pock 实战指南:把 macOS Dock 和媒体控制搬上 Touch Bar

Pock 是一个免费开源的 Touch Bar 小部件管理器(Widgets manager),为 MacBook 的 Touch Bar 提供 Dock 直达、媒体控制和系统状态速览等功能。它的定位很直接:把原本要伸手去点 Dock、开菜单才能完成的操作,压缩到手边的键盘条上,同时让屏幕主区域不被占用。 [![Pock 首次运行时的 Touch Bar 小部件安装引导界面](https://r

gitblog_00242的博客 428

coze-loop开源模型:基于Llama3微调,专注代码逻辑理解与重构

本文介绍了如何在星图GPU平台上自动化部署coze-loop - AI代码循环优化器镜像,快速搭建一个专注于代码逻辑理解与重构的AI助手。该工具基于Llama3微调,能够对现有Python代码进行自动化分析和优化,典型应用场景包括提升代码可读性、优化算法效率以及辅助代码审查,帮助开发者快速改进代码质量。

weixin_42514540的博客 809
上一篇: 开源大模型和闭源大模型有什么区别?
下一篇: 全球首款通用AI Agent——Manus发布!3大场景实测!
大模型应用场景
博客等级 码龄5年 7670粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值