多模态RAG最佳实践:小白到程序员的完整指南,图文表格全能解析

python实战(七)——基于LangChain的RAG实践 本文详细介绍了使用LangChain构建RAG程序的各个流程,并给出了对应的python实现代码。 阅读详情

本文提出的多模态RAG方法采用模态特定处理、后期融合和关系保留的技术架构,通过结构保留的文档分割、模态特定内容提取、HTML转换、语义分块及多模态向量化,有效处理包含文本、图像、表格的混合内容。该方法在性能、准确性与复杂度间实现最佳平衡,相比传统RAG系统在处理复杂多模态查询时性能提升23%,同时保持了良好的灵活性和模块化特征,为大多数组织提供了技术可行性。

前排提示,文末有大模型AGI-优快云独家资料包哦!

本文提出的多模态RAG方法采用模态特定处理、后期融合和关系保留的技术架构,在性能表现、准确性指标和实现复杂度之间实现了最佳平衡。

传统RAG系统在处理纯文本应用场景中已展现出显著效果,然而现实世界的信息载体往往呈现多模态特征。文档中普遍包含图像、表格、图表等承载关键信息的视觉元素,这些多模态内容的有效处理正是多模态RAG系统的核心价值所在。

多模态RAG最优方案选择

经过系统性研究和实验验证,我们将介绍一个在RAG系统中处理多模态内容的最佳实现方案。该方案在性能表现、准确性指标和实现复杂度之间实现了优化平衡。
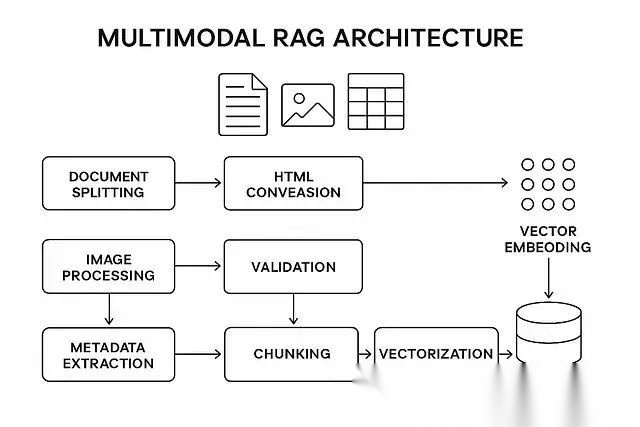
图1:多模态RAG系统整体架构图,展示从文档处理到向量化存储的完整工作流程

架构优势分析

架构采用模态特定处理与后期融合相结合的技术路线。相比其他技术方案,该架构具有以下显著优势:

首先,在模态信息保留方面,该方法避免了统一嵌入方法可能导致的模态特有信息丢失问题,通过针对各模态优化的专用工具实现精确的内容类型处理。其次,系统具备良好的灵活性和模块化特征,支持单独组件的升级优化(例如更换更高性能的图像理解模型),而无需重构整个系统架构。

在检索精度方面,研究数据表明,该方法在处理复杂多模态查询时的性能相比统一方法提升23%。同时,该架构基于广泛可用的开源工具和模型构建,确保了大多数组织的技术可达性和实施可行性。

多模态文档处理工作流程

以下详细阐述推荐工作流程的各个环节,说明各组件如何协同工作以构建统一的系统架构:
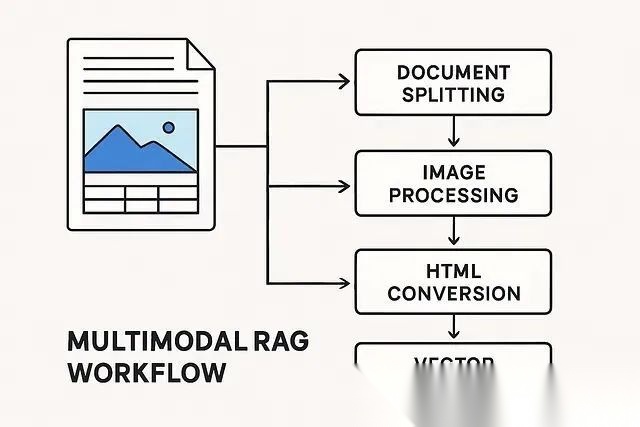
图2:多模态RAG方法的连接工作流程图

1、结构保留的文档分割

该模块的核心功能是将文档分解为可管理的片段,同时保持其逻辑结构和不同内容类型之间的关联关系。

结构感知分割对于系统性能至关重要,它确保相关内容(如图像及其标题)在分割过程中保持关联,这对准确理解和检索具有决定性作用。

 importfitz  # PyMuPDF

研究结果表明,在分割过程中保持文档结构能够显著提升多模态内容的检索质量指标。

2、模态特定内容提取

该模块采用针对特定模态优化的专用工具处理各类内容(文本、图像、表格)。

不同内容类型需要采用相应的处理技术才能有效提取其信息内容,通用方法往往产生次优结果。

 defextract_multimodal_content(sections, doc):

3、关系保留的HTML转换

该模块将提取的多模态内容转换为结构化HTML格式,同时保留内容元素间的关联关系。

HTML作为标准化格式能够有效表示混合模态内容并保持结构完整性,为后续处理提供理想的数据基础。

frombs4importBeautifulSoup

在实施过程中,建议使用语义HTML5标签(如<figure>、<figcaption>、<table>、<section>)来保留不同内容元素的语义含义,而非仅关注其视觉呈现效果。

4、关系保留的语义分块

HTML转换为多模态内容的标准化表示提供了统一的处理基础,同时保持了结构完整性。

该模块将HTML内容划分为语义完整的片段,同时维护不同元素间的关联关系。

有效的分块策略对检索质量具有决定性影响。过大的块会降低检索精度,而过小的块则会丢失重要的上下文信息。

frombs4importBeautifulSoup

在实施中,建议使用图数据结构显式表示块间关系。这种方法支持更复杂的检索策略,能够沿着关系链路查找相关内容。

5、多模态向量化与存储

该模块将语义块转换为向量表示,并将其存储在向量数据库中以实现高效检索。

不同模态需要采用相应的向量化方法才能有效捕获其语义内容特征。
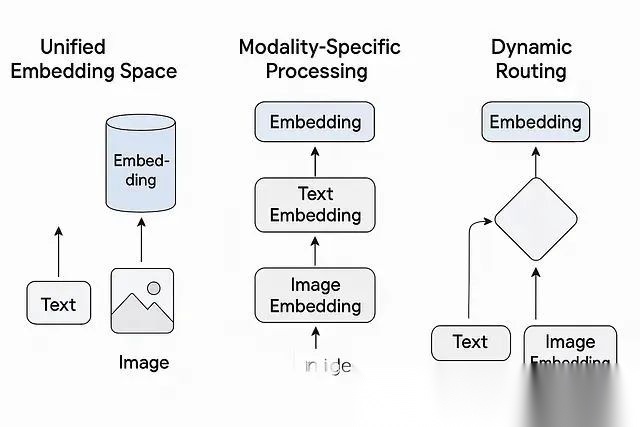
图3:推荐方法采用模态特定处理和后期融合的技术架构

fromsentence_transformersimportSentenceTransformer

对于生产系统,建议考虑使用更复杂的融合方法(如交叉注意力机制或门控融合),以替代简单的串联或平均方法来组合不同模态的嵌入向量。

检索流程:系统集成实现

在完成多模态RAG系统构建后,以下展示其查询处理机制:

 defretrieve_multimodal_content(query, collection, relationship_graph, k=5):

方法优势对比分析

推荐方案相比其他技术路线在以下关键维度具有显著优势:

在混合模态处理能力方面,通过使用专用工具处理各模态后进行结果整合,能够捕获每种内容类型的独特特征。在关系保留机制上,通过显式建模和保留内容元素间的关系,维护了准确理解和检索所需的上下文信息。

在自适应检索能力方面,检索过程能够根据查询的模态需求进行适应性调整,确保无论内容格式如何都能检索到最相关的信息。在实际可行性层面,该方法基于广泛可用的工具和模型实现,为大多数组织提供了良好的技术可达性。

总结

本文提出的多模态RAG方法采用模态特定处理、后期融合和关系保留的技术架构,在性能表现、准确性指标和实现复杂度之间实现了最佳平衡。通过遵循该技术路线,能够构建一个有效处理复杂文档中全部信息的RAG系统。

在后续研究中,我们将重点探讨多模态RAG系统从实验阶段向生产就绪阶段的迁移方法,着重关注系统可扩展性、监控机制和持续优化策略等关键技术问题。

读者福利:倘若大家对大模型感兴趣,那么这套大模型学习资料一定对你有用。

针对0基础小白:

如果你是零基础小白,快速入门大模型是可行的。
大模型学习流程较短,学习内容全面,需要理论与实践结合
学习计划和方向能根据资料进行归纳总结

包括:大模型学习线路汇总、学习阶段,大模型实战案例,大模型学习视频,人工智能、机器学习、大模型书籍PDF。带你从零基础系统性的学好大模型!

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓
请添加图片描述

👉AI大模型学习路线汇总👈

大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;

第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;

第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;

第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉大模型实战案例👈

光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

在这里插入图片描述

👉大模型视频和PDF合集👈

这里我们能提供零基础学习书籍和视频。作为最快捷也是最有效的方式之一,跟着老师的思路,由浅入深,从理论到实操,其实大模型并不难。

在这里插入图片描述

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉获取方式:

😝有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

基于财报 PDF 的智能问答与溯源的多模态 RAG 图文问答系统——Datawhale AI夏令营 在信息载体多元化的背景下,企业财报等核心文档多以图文混排 PDF 形式呈现,传统文本导向的问答系统因无法融合图表信息,难以响应涉及跨模态关联的复杂查询(如 “某产品销售额在哪个季度下降”)。核心任务聚焦于构建多模态检索增强生成(RAG)系统,需完成四维度目标:解析图文混排 PDF 构建结构化知识库、实现跨模态语义检索、融合图文信息推理生成答案、精准标注答案来源(文件名及页码)。具体实践中,运用 Python 生态工具链:采用 MinerU 进行 PDF 深度解析,提取文本、表格及图像并生成图像语义描述; 阅读详情

相关推荐

python实现RAG相关思路与过程

python实现大模型向量检索RAG

NLP与推荐算法 1026

RAG入门实践:手把手Python实现搭建本地知识问答系统

向量数据库是AI时代的“数据配对专家”,用向量化思维解决非结构化数据的存储和检索难题,尤其适合需要。

Arbboter的专栏 7710

朴素RAG:Python从零实现

检索增强生成(RAG)是一种将信息检索与生成模型相结合的混合方法。它通过引入外部知识来增强语言模型的性能,从而提高准确性和事实正确性。数据摄取:加载并预处理文本数据。分块:将数据分成较小的块以提高检索性能。嵌入创建:使用嵌入模型将文本块转换为数值表示。语义搜索:根据用户查询检索相关块。响应生成:使用语言模型基于检索到的文本生成响应。本文实现了一个简单的RAG方法,评估模型的响应,并探索各种改进。

AI人工智能的学习之路 900

【Python大语言模型系列】不到两百行代码教你实现一个完整的RAG系统(案例+源码)

不到两百行代码教你实现一个完整的RAG系统(案例+源码)

数据杂坛 3675

RAG 优化:高效解析并接入图文、表格密集型文档

检索增强生成 (Retrieval-Augmented Generation, RAG) 已成为构建智能问答、文档摘要、内容创作等应用的利器。然而,标准的 RAG 流程往往假设输入是纯文本。当我们面对现实世界中更常见的文档——那些充斥着大量图片、图表和表格的报告、手册、论文或网页时,传统的 RAG 方法就会显得力不从心。这些非文本元素往往蕴含着关键信息,忽略它们将导致 RAG 系统理解片面、回答不准确。你想问一个产品手册中某个零件的安装步骤,而关键信息在一张流程图里。

kakaZhui的博客 588

unity打包流程整理-Windows/Mac/Linux平台

1.Platform(平台)功能: 选择目标构建的目标平台选项PC, Mac & Linux Standalone: 适用于 Windows、Mac 和 Linux 平台2.Target Platform(目标平台)功能: 选择具体的操作系统版本选项Windows: 针对 Windows 操作系统Mac: 针对 macOS 操作系统Linux: 针对 Linux 操作系统3.Architecture(架构)功能: 选择应用程序的目标处理器架构选项x86: 针对 32 位系统。

weixin_42333247的博客 5142

RAG-Anything:多模态RAG的全能王者,AI文档处理的终极形态!

在AI圈混久了,大家都知道RAG(Retrieval-Augmented Generation)是大模型落地的“黄金搭档”。但你有没有发现,现实世界的文档早已不是单纯的文本堆砌?学术论文、财报、技术文档、PPT、甚至日常的会议纪要,哪个不是“图文表公式”齐飞,内容花样百出? 传统RAG系统,面对这些“混搭风”文档,往往只能“望图兴叹”,遇到表格就“表”情凝重,碰到公式就“公式”无措。于是,AI开发者们的桌面上,常年堆着一堆专用工具:OCR、表格解析、公式识别、图片理解……每次处理一个文档,像在组装一台变形

Android23333的博客 1595

SAP BTP开发入门:从PaaS到CAP/UI5的30天学习路线

在云计算与数字化转型的大背景下,企业系统集成与云端扩展需求激增,传统的单点开发模式正面临深刻变革。PaaS(平台即服务)作为云原生的核心概念,将基础设施、开发环境与应用服务统一封装,为企业提供了灵活的扩展能力。SAP BTP正是SAP生态中的PaaS平台,它承载着系统集成、低代码开发、AI服务与数据管理,成为连接S/4HANA等核心业务系统与创新应用的桥梁。对于ABAP开发者而言,掌握BTP不仅是技能升级,更是应对从传统部署向云端订阅模式转型的必由之路。本文从平台基础出发,梳理BTP的核心服务与开发模型(如

weixin_31766003的博客 286

一文读懂:从RAG到多模态RAG

Retrieval Augmented Generation,检索增强生成。是一种结合了信息检索技术和大型语言模型提示功能的框架。它通过从数据源检索信息来辅助LLM生成答案,提高了模型在知识密集型任务中的准确性和可信度。

youmaob的博客 7125

WSL 运行make提示/lib/modules/xxx/build: No such file or directory. Stop.错误解决办法

WSL运行make提示/lib//modules/xxx文件或目录不存在。 WSL2的内核是修改过的,无法使用 ubuntu上游的内核头文件和modules文件,因此,我们需要手动编译并安装一个版本。

weixin_45668903的博客 1万+

Appsflyer S2S事件上报实战:从参数获取到避坑指南(附Firebase对比)

本文详细解析了Appsflyer S2S事件上报的实战技巧,包括核心参数获取、测试环境搭建、生产环境最佳实践以及高级场景处理。通过对比Firebase的事件上报机制,帮助开发者高效避坑并优化数据上报流程,提升应用分析与营销效果。

egg99的博客 886

大模型应用实战:从0到1教你构建多模态 RAG(图文 + 表格混合检索)系统

让我们先抛开复杂的术语,聚焦于一个真实的、触手可及的场景。“本款咖啡机采用最新的 Aroma+ 技术…”故障代码故障描述解决方案E21水箱缺水请为水箱加水E22传感器通讯故障检查传感器连接线,参考图 3-1一张名为的图片,清晰地展示了传感器的位置(即图 3-1)。传统 RAG 系统的窘境如果我们用传统的 RAG 方法来处理这份手册,系统会将所有文本内容(包括表格里的文字)切碎、向量化后存入数据库。当用户提问:“显示 E22 错误怎么办?

THMAIL的博客 1079

Roboguide与TIA V16通讯

Roboguide与TIA V16通讯

haier123888的博客 2677

【AI学习收藏】一文读懂多模态RAG:让AI真正理解图文混合文档的新技术

【AI学习收藏】一文读懂多模态RAG:让AI真正理解图文混合文档的新技术

python12345_的博客 1799

【教程4>第2章>第19节】 GMSK解调系统的FPGA开发与matlab对比验证

MSK(Minimum Shift Keying,最小频移键控)和GMSK(Gaussian Minimum Shift Keying,高斯最小频移键控)都是数字调制技术,主要用于无线通信系统中将数字信号转换为模拟信号进行传输。它们都是连续相位移键控(Continuous Phase Shift Keying, CPK)的一种形式,意味着相邻码元之间没有相位跳变的突变,而是连续过渡,这有助于减少信号带宽和降低邻道干扰。GMSK的解调过程与MSK类似,我们这里还是采用和MSK解调一样的1bit解调方法。

FPGA/MATLAB学习教程/源码/项目合作开发 1222

解决【x2openEuler环境检查未通过——CheckRepoCurlActor不通过】问题

摘要:x2openEuler使用默认repo源时出现环境检查失败问题,原因是默认源返回308永久重定向错误。解决方法包括:1)为CentOS主机配置华为yum源;2)在x2openEuler Web界面修改为自定义可用源。具体步骤包括备份原源、下载华为源、清除缓存,并通过curl测试确认新源可用性。最终成功配置openEuler-24.03-LTS-SP1版本的repo源后,环境检查顺利通过。

提供C#相关开发 、云计算、运维测试、网络安全相关技术分享与服务,有意向可联系。 259

RAG 表格问答为什么总出错?——四款解析工具实测与根因分析

文章摘要 RAG表格问答系统常因表格解析错误导致答案"正确但语义错误"。核心问题在于解析阶段破坏了表格的层级结构和字段归属关系,而非下游检索或生成模型的问题。通过对比xParse、PaddleOCR、MinerU和LlamaParse四种解析工具,发现主要存在三类破坏路径: 表格被拍平成文本,丢失层级导航; 单位/币种等元数据脱钩; 跨页表格切片导致上下文断裂。测试显示xParse在保留表格结构和上下文连贯性方面表现最优,而开源工具在复杂表格处理上存在明显不足。表格解析质量直接决定了RAG系统的答案上限。

沉淀所学,分享所思,让热爱与成长同行。商务记录AI实战经验,助力开发者快速成长。 热爱AI,希望做出有影响力的技术成果。 技术点亮生活,分享连接价值与机会。 专注AI落地实战,陪你走好技术每一步。 5万+

IIC软件协议及硬件知识汇总

IIC软件协议及硬件相关知识,真的是非常齐全了!

记得诚 1万+

Datawhale AI夏令营2025第三期——多模态RAG方向(多模态RAG图文问答挑战赛笔记)

此次夏令营活动是基于讯飞开放平台“多模态RAG图文问答挑战赛”,我在“Datawhile”公众号中发现有多模态RAG方向,本身感兴趣,想学习学习。简单来说就是很多提问问题所得到的信息,不仅仅局限于纯文本中,在图表中"隐藏"着Query的重要Answer,所以我们需要模型不仅能懂文本,还需要理解图片,二者结合使得回答的精确性与完整性都达到比较好的状态;而我们如果需要模型能够回答自己专业领域的一些问题,并且能够实时的更新,成本不要太高,那么多模态RAG 的重要性就体现出来了。

2301_77350531的博客 1956

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

LazyLLM教程 | 第13讲:RAG+多模态:图片、表格通吃的问答系统

通过共享的向量空间,文本和图像可以在相同的语义空间中进行比较和排序,从而提高多模态检索和生成的效率和准确性。然而,利用视觉多模态大模型对其进行嵌入和检索的相关方法有DSE、ColPali,M3DocRAG等,下文以ColPali为例,讲解与基于文档解析的方法之间的不同之处(图源ColPali论文)。因此,为了让普通 RAG 在更多真实场景下保持高效、智能的表现,我们亟需引入多模态能力,结合 OCR、图像理解等技术,让模型具备“读图识意” 的能力,从而真正实现对多模态信息的智能问答与生成。

SenseCore的博客 957

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

AI工程化实战《四》:多模态 RAG 全解——让 AI 看懂 PDF 表格、扫描件与流程图

企业多模态RAG技术已成为刚需,因关键文档多为含图表/表格的多模态格式。本文提出混合方案:使用Unstructured+PaddleOCR解析文档,结合Qwen-VL理解图像语义,通过Milvus存储多模态向量。技术亮点包括:1)表格识别准确率>92%;2)支持跨模态检索(文字搜图片/图片搜文档);3)本地部署Donut保障数据安全。实测合同处理准确率>88%,实现从扫描件到结构化数据的端到端自动化处理,标志着RAG技术从纯文本迈向多模态新时代。

小二丶的博客 1468

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

【Datawhale AI 夏令营】多模态RAG图文问答挑战赛分析

摘要:本文分析了"多模态RAG图文问答挑战赛"的核心任务与优化路径。该赛题要求处理财报PDF中的文本、表格、图片等多模态信息,构建可溯源的问答系统。评估标准强调答案准确性和来源精确性各占50%。当前Baseline方案存在丢失多模态信息、分块不合理等缺陷。优化方向包括:使用MinerU工具增强多模态解析能力,改进分块与索引策略,引入重排机制,以及针对财报领域微调Embedding和LLM模型,以提升信息完整性、检索精度和生成质量。

Morderay的博客 688
上一篇: 大家都在用Agent做什么?7种Agent框架对比!国内一站式Agent搭建平台大盘点!
下一篇: UltraRAG 2.0:仅需5%代码,轻松实现复杂RAG系统
大模型应用场景
博客等级 码龄5年 7677粉丝 1350原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值