AI Agent 评测数据集全景图:从 GUI 到具身智能,一文掌握主流 Benchmark

大模型Computer Use能力Benchmark全面解析:OSWorld等主流评测体系深度对比 Computer Use Benchmark是专门设计用于评估大模型在真实计算机环境中执行任务能力的评测框架。理解图形用户界面(GUI)元素执行多步骤操作序列处理跨应用程序的工作流适应动态变化的界面状态Computer Use Benchmark是衡量大模型实际生产力的重要工具。随着OSWorld等评测体系的不断完善,我们正朝着构建真正能替代人类完成计算机操作的AI Agent迈进。选择合适的Benchmark,持续评估和优化模型能力,将是每个AI开发者的必修课。 阅读详情

项目地址:https://github.com/dataanswer/awesome-agent-benchmarks
在线导航站:https://www.dataanswer.top

随着 LLM Agent 技术从实验室走向产业落地,“如何科学评估一个 AI Agent 的真实能力?” 已成为研究者与开发者的核心命题。

然而,当前 Agent 评测生态呈现 “百花齐放,标准缺失” 的局面:

  • 数据集散落在 GitHub、Hugging Face、论文附录中,难以系统检索
  • 缺乏统一的能力维度划分,跨任务对比困难
  • 新 benchmark 层出不穷,但质量参差不齐

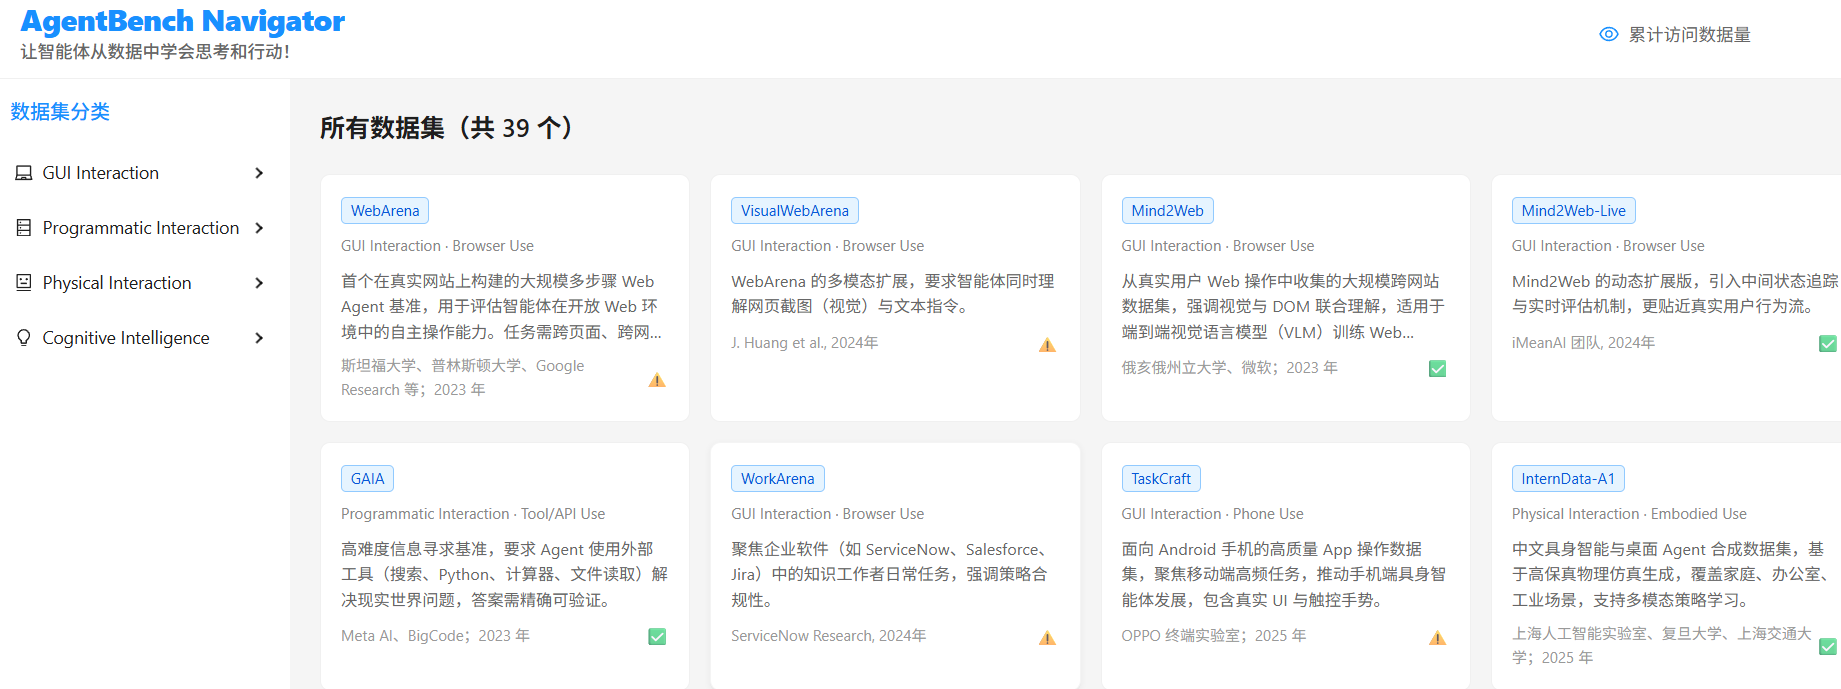
为此,我们系统梳理了 全球 39+ 主流 AI Agent 评测数据集,按 能力维度 分类整理,形成这份 《AI Agent 评测数据集全景图》,助你快速定位最适合的评估工具。
🔍 一、为什么需要结构化 Benchmark?

传统 LLM 评测(如 MMLU、HumanEval)聚焦 语言理解与代码生成,但 Agent 的核心能力远不止于此。一个真正的 Agent 需要:

能力维度关键问题对应 Benchmark
GUI 操作能力能否像人一样点击网页按钮、填写表单?WebArena, VisualWebArena
具身智能(Embodied)能否在 3D 环境中导航、操作物体?ALFWorld, VirtualHome
反思与规划(Cognitive)能否拆解复杂任务、自我修正错误?GAIA, SWE-bench
工具调用(Tool Use)能否正确选择并调用 API/函数?ToolBench, API-Bank
真实世界执行能否完成订票、购物等端到端任务?WorkArena, Mind2Web

✅ 结构化分类的意义:避免“用数学题考厨师”,确保评测任务与目标能力对齐。

🧪 二、主流 Agent 评测数据集详解

1️⃣ GUI Agent:让 Agent “看见”并操作界面

数据集特点链接
WebArena基于真实网站(电商、Wiki)的 800+ 任务,需操作 DOM 元素GitHub
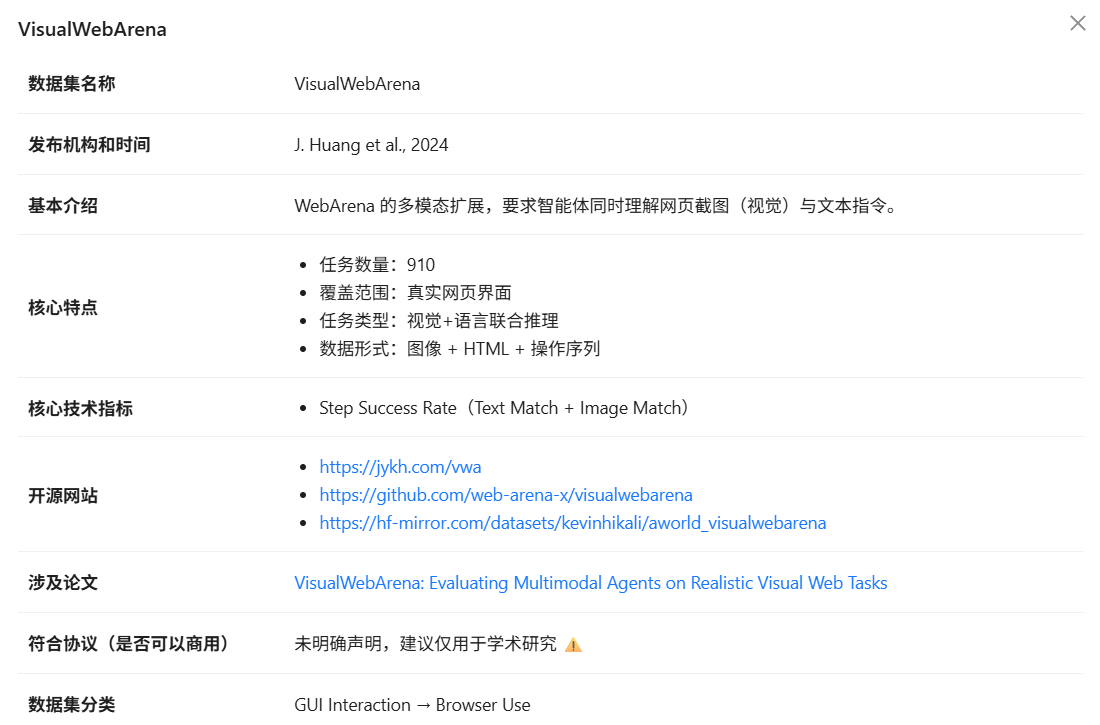
VisualWebArena (VWA)升级版!仅通过视觉像素操作网页,更接近人类行为Demo
Mind2Web从 30+ 真实网站采集的 27k 条操作轨迹,支持少样本学习HF Dataset

💡 适用场景:自动化测试、RPA、浏览器 Agent 开发

2️⃣ 具身智能(Embodied Intelligence)

数据集环境任务类型
ALFWorld家庭 3D 环境(Alfred)“把苹果放进冰箱”
VirtualHome程序化生成的家居场景多步指令执行
BEHAVIOR高保真物理仿真日常生活任务(做饭、清洁)

⚠️ 挑战:需结合 CV + 规划 + 物理引擎,评测成本高

3️⃣ 反思规划 / 认知智能

数据集核心能力亮点
GAIA多跳推理 + 工具调用由 Meta & Hugging Face 联合发布,含 466 个现实问题
SWE-bench软件工程修复直接在 GitHub Issues 上验证 PR 是否修复 bug
AgentBench综合能力(代码/数学/游戏)清华大学出品,覆盖 8 类任务

🌟 GAIA 示例问题:
“2023 年诺贝尔物理学奖得主是谁?他/她的主要贡献是什么?”
→ 需先搜索获奖者,再检索其科研成果

4️⃣ 工具调用与 API 使用

数据集工具数量评估重点
ToolBench16k+ APIs工具选择、参数生成、错误恢复
API-Bank53 个真实 API医疗、金融、天气等垂直领域
TaskCraft1.2k 复杂任务多工具协同(如“查航班+订酒店+发邮件”)

🔒 注意:部分数据集需申请权限(如 API-Bank)

🗺️ 三、如何选择合适的 Benchmark?

你的目标推荐数据集
评估网页自动化能力WebArena 或 VisualWebArena
测试复杂推理与规划GAIA + SWE-bench
验证多工具协同TaskCraft 或 ToolBench
构建具身 AgentALFWorld(轻量)或 BEHAVIOR(高保真)
快速横向对比AgentBench(多任务集成)

💡 建议:不要只看单一指标!结合任务成功率、步骤数、工具调用准确率综合评估。

🚀 四、开源项目推荐:Awesome Agent Benchmarks

为帮助开发者高效获取这些资源,我们开源了:

awesome-agent-benchmarks
—— 全球首个按 能力维度分类 的 Agent 评测数据集清单

✨ 项目特色:

  • ✅ 覆盖 GUI / 具身 / 认知 / 工具调用 四大核心场景
  • ✅ 提供 在线导航站(dataanswer.top),支持关键词搜索
  • ✅ 持续更新,已收录 39+ 权威数据集
  • ✅ 中英双语 README,全球开发者友好

GitHub 地址:https://github.com/dataanswer/awesome-agent-benchmarks
欢迎 Star ⭐ + 贡献新数据集!

📣 五、结语:评测驱动 Agent 进化

正如 ImageNet 推动了计算机视觉的发展,高质量、结构化的 Agent Benchmark 将是下一代 AI 突破的关键基础设施。

我们相信:

“无法测量,就无法改进。”
—— 彼得·德鲁克

希望这份全景图能成为你开发、评估、优化 AI Agent 的可靠指南。如果你有新的数据集推荐,欢迎提交 Issue 或 PR!

ARCGIS绘制全国各省PM2.5浓度图操作步骤 ArcGIS新手小白一枚,经常需要帮助老师绘制一些简单的空间图,利用ArcGIS绘制全国各省的pm2.5浓度图,简单又方便,不记下来会忘记~ 阅读详情

相关推荐

信创那些事儿——Spring Boot中集成东方通中间件(TongWeb)

在Spring Boot中集成东方通中间件(如TongWeb作为Servlet容器)通常涉及几个步骤,但需要注意的是,TongWeb本身是一个独立的Java EE应用服务器,而不是像Tomcat那样可以直接嵌入到Spring Boot应用中的中间件。因此,集成通常意味着将Spring Boot应用打包为WAR文件并部署到TongWeb服务器上。

来北欧写代码 6491

上海AI Lab:图形用户界面agent评测

如何系统性地评估和改进图形用户界面(GUI)代理的能力和表现?论文提出了MMBench-GUI,一个层次化的多平台评估框架,用于全面评估GUI代理的能力及其在实际应用中的局限性。

大模型任我行的博客 1190

去面试游戏测试工程师,面试官看着我的简历呆住了

!我个人整理了我这几年软件测试生涯整理的一些技术资料,包含:电子书,简历模块,各种工作模板,面试宝典,自学项目等。欢迎大家点击下方名片免费领取,千万不要错过哦。

MXB1220的博客 7329

亲测UI-TARS-desktop:用Qwen3-4B模型打造你的第一个GUI Agent

本文介绍了基于星图GPU平台自动化部署UI-TARS-desktop镜像的实践过程,该镜像集成Qwen3-4B模型,支持通过自然语言指令操控计算机界面。用户可在本地环境快速搭建GUI Agent,典型应用于自动化查询、模型微调与AI应用开发,实现高效、安全的多模态交互体验。

weixin_34581040的博客 628

在带有Intel Arc GPU的Windows上安装IPEX-LLM

本文将介绍在 Intel Arc GPU 环境下安装 IPEX-LLM。

wux_labs的博客 1635

实战指南:如何用DCCRN模型提升语音增强效果(附代码示例)

本文提供了基于DCCRN模型进行语音增强的实战指南。通过深入解析复数网络如何协同处理语音的幅度与相位信息,并附有完整的PyTorch代码实现,帮助开发者从数据准备、模型搭建到训练调优,构建高效的实时语音增强系统,有效提升嘈杂环境下的语音清晰度。

weixin_29054245的博客 478

阿里开源最强GUI Agent,操作App从此告别“一根筋”

你有没有过这样的经历:满怀期待地对你的智能助手说,“帮我把刚才那张黄昏的照片发给我妈”,结果它却一脸无辜地回答“对不起,我没听懂”?或者,你让一个自动化脚本“点击确认按钮”,结果软件一更新,按钮从“确认”变成了“好的”,脚本立刻“罢工”。这些让人哭笑不得的场景,暴露了当前AI在理解和操作我们日常软件界面时的一个核心困境:它们太“死板”了。它们能精确执行“点击屏幕坐标(350, 800)”这样的指令,却很难理解“点击那个红色的叉叉”这种充满人类智慧的模糊语言。

ljp1919的专栏 1203

STM32结合FFT与窗函数优化,实现高精度正弦信号提取

本文详细介绍了如何在STM32嵌入式平台上结合FFT算法与窗函数优化技术,实现高精度正弦信号提取。通过分析频谱泄漏原理,对比汉宁窗、汉明窗等窗函数特性,并提供实际代码示例和幅值补偿方法,有效解决了工业检测中信号精度不足的问题。

v5w6x的博客 221

一篇大模型GUI Agent最新综述

嘿,大家好!这里是一个专注于AI智能体的频道~从Agent到GUI Agent是今年下半年的一个大趋势。GUI的优势在于,相比于命令行界面(CLI),非技术用户也能有效地与复杂系统进行交互。但是早期的GUI自动化依赖于脚本或基于规则的方法,这些方法虽然对固定工作流程有效,但缺乏动态、现实世界应用所需的灵活性和适应性。限制了它们的可扩展性和多功能性。目前的像cursor、智谱AutoGLM 等“LLM-Brained” GUIAgent能够解释复杂的GUI元素,并根据自然语言指令自主执行动作。

2401_85375298的博客 2254

使用CiteSpace软件对知网文献进行关键词共现/聚类/突现分析

一、基本概念CiteSpace(引文空间)是一款专注于分析科学分析中蕴含的潜在知识的软件。它是在科学计量学、数据可视化背景下逐渐发展起来的引文可视化分析软件。通过可视化的手段,CiteSpace能够呈现科学知识的结构、规律和分布情况,并因此将这种分析得到的可视化图形称为“科学知识图谱”。二、主要功能和用途知识图谱构建:根据科学文献的引用关系,CiteSpace可以生成知识图谱,帮助研究人员更好地理解学术领域中不同文献之间的联系和演化过程。主题聚类分析。

m0_64336780的博客 1万+

Python 实战:全面解析“微信搜一搜”内容爬取,从入门到企业级架构

本文将带你从零搭建爬虫项目,采用 Requests、Scrapy、Selenium、Proxy 池、中间人监控(如 Fiddler/mitmproxy)、分布式调度、数据库持久化、断点续抓等方案,实现可持续、抗封能力强的内容抓取系统。理解“微信搜一搜”页面结构与 Javascript 渲染逻辑;使用 Scrapy 框架搭建分布式爬虫;使用 Selenium 模拟浏览器抓取;构建代理池提升爬取成功率;对抗验证码、IP 封禁与 cookie 过期问题;

2201_76125261的博客 1393

躺平神器!GUI Agent 直接模拟人类操作鼠标键盘

GUI Agent的核心价值在于“无接口自动化”,解决了90%中小企业的跨系统业务痛点。它不用你懂复杂的AI算法,只要会点基础Python,跟着本文的步骤就能搭建出实用工具。不管是给自己公司提效,还是做副业接定制化项目,GUI Agent都是低门槛、高回报的选择。现在AI落地的窗口期已经到了,早动手就能早抢占红利。如果在搭建过程中遇到环境配置、元素识别、流程优化等问题,欢迎在评论区留言,我会一一回复解答!也可以分享你的业务场景,一起探讨如何用GUI Agent实现自动化~

人工智能AI技术 1587

基于图像形态学处理的交通灯检测识别matlab仿真

图像形态学处理是基于数学形态学的理论,利用结构元素(如矩形、圆形等)对图像进行处理,通过将结构元素与图像进行特定的逻辑运算,来提取图像中的目标特征、去除噪声、改善图像质量等。在交通灯检测识别中,主要利用交通灯的颜色、形状等特征,通过形态学操作突出这些特征,抑制背景和噪声干扰,从而实现对交通灯的准确检测和识别。图像采集与预处理采集:通过安装在车辆或道路上的摄像头获取交通场景图像。灰度化:将彩色图像转换为灰度图像,减少数据量,便于后续处理。

平时工作较为繁忙,私信消息一般晚上回复,谢谢大家~~ 160

【LLM】Agent的相关Benchmark

AgentBench 评估维度: 8个任务环境:操作系统(OS)、数据库(DB)、知识图谱(KG)、卡牌对战(DCG)、情景猜谜(LTP)、家居(Alfworld)、网络购物(WebShop)和网页浏览(Mind2Web), 25 个不同的语言模型(包括基于 API 的模型和开源模型):有效性、上下文长度记忆、多轮对话一致性和代码生成执行等全面评估。 ![在这里插入图片描述](https://i-blog.csdnimg.cn/direct/01a8967e8318466f99697f692c75bd8a

发现问题,并解决问题,批判性思维 3601

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Agent 评测基准(Benchmark)专题

AI 大模型行业每日简报 · 常设板块(自 2026-09-21 起新增):Vals.ai(Finance Agent v2 / Harvey LAB)、Princeton HAL + HAL Reliability Dashboard、SWE-bench 官方、Terminal-Bench/Harbor、arXiv(τ²-bench、Meerkat 审计、OverclaimBench)

m0_37528953的博客 410

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

HarnessEval-W:用智能Agent自动化评测交互世界模型,打破AI评测黑箱

在人工智能领域,模型评测是衡量技术有效性的核心环节。传统评测方法主要依赖静态数据集和人工标注,难以评估模型在动态、复杂环境中的真实交互与决策能力,形成了“评测黑箱”。为解决这一问题,业界开始探索自动化、多维度、可扩展的智能评测体系。其基本原理是构建一个由任务生成器、环境模拟器和评测Agent组成的闭环系统,利用大语言模型(LLM)作为“考官”,自动执行任务、观察行为并给出多维度评分。这种技术的核心价值在于能够系统化地评估模型的交互能力、泛化性和稳健性,为AI智能体(Agent)的研发与优化提供客观、可重复的

weixin_33770878的博客 415

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

Terminal-Bench 终端评测:从 0 到跑通第一条 Benchmark 的完整路径

Terminal-Bench 是评测 AI agent 在真实终端环境中表现的基准,由任务数据集与执行 harness 两部分组成,把"agent 能不能把终端任务干完"变成可复现的分数。 ## 换个模型,测试就要重来一遍? 手工验证 agent 的终端能力很麻烦:写一批测试用例,换个模型,环境、评分口径和流程都要重新对。Terminal-Bench 把"任务、环境、评分"固定成可复现的单元—

gitblog_00631的博客 555

如何10分钟跑通skillbench-extend:新手首次技能匹配评测完全指南

skillbench-extend 是一个从 SkillsBench 派生的**能力匹配评测数据集**,覆盖 skill(技能)、MCP tool(工具)、workflow(工作流)三类匹配,共 141 个任务。它回答一个核心问题:*给定一个任务 prompt,你的路由/检索系统能不能为它找到正确的能力?* 本文带你从零开始,用不到 10 分钟完成首次技能匹配评测,并看懂输出报告。🎯 ## 一

gitblog_00054的博客 910

如何在Agents‘ Last Exam上快速跑通第一次AI Agent评测:从零到第一个分数的快速入门教程

Agents' Last Exam(简称 ALE)是一个面向真实专业工作场景的 AI Agent 评测基准与开源评测框架。它把真实职业任务拆进 13 个行业簇、55 个子领域,让 Claude Code、Codex 等 Agent 在真实操作系统沙箱里独立干活,再用隐藏的参考答案和确定性评分器打分(0~1 分)。本文带你从零开始,最快路径跑通第一次评测,拿到属于你的第一个分数。 [![Agent

gitblog_00477的博客 109

别再被跑分骗了:大模型 Benchmark 到底在考什么

MMLU 覆盖57个学科的选择题,从高中数学到法学到医学都有,它确实能反映一个模型的知识广度和选择题作答能力,但它不测长文本连贯性,不测多轮对话里的上下文保持,不测指令遵循在边缘 case 下的稳定性。GSM8K 和 MATH 测数学推理链,chain-of-thought 能力强的模型在这两个榜上分数好看,可真实工作中遇到的数学问题从来不是"小明有三个苹果"那样条件清晰的格式,条件是模糊的、信息是冗余的、你甚至要先判断该不该算。这些数字是真实的、可复现的,但我们内部评估的时候从来不会只看这两个数。

Mano-P是明略科技自研的,面向端侧设备的 GUI-VLA 智能体模型,既适合开发者快速构建GUI Agent工作流,也适合高安全要求场景进行本地部署。Mano-P让“人人拥有个性化 AI”从愿景变为现实。 610

做好 AI Agent 最重要的是什么?

OpenAI 姚顺雨近期提出“

2401_85390073的博客 713

Agent评测的核心:跳出答案比对,聚焦任务、界面与执行过程

随着大模型技术从内容生成走向工具调用与任务执行,AI Agent的评测方式也需要随之升级。传统大模型评测只比对最终答案,但Agent在真实场景中可能“答得漂亮却从未完成任务”。本文聚焦Agent评测的完整方法论,从任务完成度、流程完整性等任务层指标,到界面可感知性、操作稳定性等交互维度,再到执行轨迹采集与过程量化分析,层层拆解如何把“过程”变成可评测的数据。同时,文章结合工程实践,分享了评测能力建设的分层架构、评测集设计以及环境隔离、人工评审等落地经验。这套方法适用于大模型应用、Agent框架和垂直领域AI

weixin_34238633的博客 427

7x24 AI 生产线:高德如何构建自动化的研发交付闭环

7x24 AI 生产线的关键,不是让 AI 无限制生成代码,而是让 AI 在明确规则、标准组件、自动门禁和持续评测的约束下完成工业级交付。高德智能应用与基建平台团队的实践,将 AI 全托管、Self-Healing、Agent 驱动流水线、质量效率双飞轮和 Benchmark 评测体系组合成一条可运转的研发交付链路。在这一体系中,杨夕凯所带领的团队并不是单纯追求 AI 写代码更快,而是把重点放在如何让 AI 在真实超级应用中接得上、跑得稳、可验证、可持续演进。

wq199909的博客 334

2026年 Agent学习收藏指南:小白程序员必备大模型入门教程

对话式智能体(Conversational Agents)

qq_46094651的博客 1245

最新 AI 论文盘点(2026-05-14):5 篇新作看 Embodied Agent 验证器、Benchmark 防作弊、VLM 失效模式、GUI Grounding 与隐性偏好学习

5篇代表性论文揭示了这一方向的关键进展: 动作验证机制:VeGAS为Embodied Agent增加验证层,通过候选动作筛选提升长链路任务可靠性,实验显示性能提升达36%。 评测安全性:BenchJack系统发现10个流行Agent Benchmark中存在219个可被利用漏洞,揭示了当前评测体系存在的严重安全问题。 失效模式分析:REVELIO方法系统识别VLM

weixin_44369324的博客 622

具身智能评测实战:从零搭建基准环境与运行开源模型

在人工智能领域,模型评测是衡量技术进展与推动工程落地的关键环节。其核心原理在于通过标准化的任务、环境和指标,对智能体的能力进行量化评估,从而确保技术发展的透明性与可比性。对于具身智能这一前沿方向,评测体系的技术价值尤为突出,它不仅是学术研究公平比较的基础,更是工业选型与规模化应用的核心决策依据。当前,面对仿真环境复杂性、任务多样性以及仿真到真实的鸿沟等挑战,构建统一、可复现的评测基准已成为社区共识。本文聚焦于具身智能评测系统的核心组件,并通过一个完整的实战示例,演示如何从环境搭建、数据集准备到智能体接口与评

weixin_33937499的博客 347
上一篇: Palantir的研究到金融风控(二)
JavaChaoCo
博客等级 码龄12年 67粉丝 36原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值