


过去多年,细胞生物学一直致力于描绘细胞可能呈现的各种表型、不同状态之间的相互关系,以及细胞在发育和疾病过程中如何在这些状态之间发生转变。
单细胞 RNA 测序(scRNA-seq)数据集规模的大幅增长,为重新审视这类问题提供了新机会。然而,现有计算方法在联合分析这些高度多样化的数据集时仍面临困难,这是因为模型可能受到物种特异性限制、数据集特异性伪影或批次效应的影响。一些针对 scRNA-seq 数据的计算方法已经能够克服部分局限,但代价是:面对每一个新的数据集,都需要对模型进行专门调优。
在此背景下,来自斯坦福大学的研究团队提出了通用细胞嵌入(universal cell embedding,UCE)基础模型。UCE 具有独特的能力:其在无需模型微调或重新训练的情况下,为新的单细胞基因表达数据集生成表征,同时能够保持对数据集特异性和批次特异性伪影的鲁棒性。此外,UCE 既不需要细胞类型标注,也不要求对输入数据集进行基因筛选等预处理。UCE 可以应用于来自任意物种的任意一组蛋白质编码基因,即使这些基因与模型训练过程中见过的基因并不存在同源关系,也同样适用。通过这种方式,UCE 学习到了一种通用且具有内在生物学意义的细胞生物学表征,使研究人员能够获得超越实验直接观测数据本身的生物学洞见。
相关研究成果以「Universal cell embedding provides a foundation model for cell biology」为题,已刊登 Nature。
研究亮点:
* 对于新的细胞数据,无需进行数据标注、模型重新训练或微调,UCE 即可将其映射到这一统一的表征空间中
* UCE 学习得到的表征呈现出一种细胞类型和细胞状态的涌现式组织结构,并且与已知生物学规律相一致
* UCE 能够将新的数据映射到一个通用嵌入空间中,而这一空间中已经存在经过注释的参考细胞状态

论文地址:
https://www.nature.com/articles/s41586-026-10689-z
构建超过 3600 万个细胞的 IMA 训练数据集
研究团队构建了一个名为 Integrated Mega-scale Atlas(IMA)的训练数据集合,将来自不同公开来源的单细胞 RNA 测序数据整合到一起。UCE 的核心训练数据包含超过 3,600 万个细胞,其中绝大多数数据(共 3,390 万个细胞、285 个数据集)来自人类和小鼠,其余部分由来自 28 个数据集的 230 万个细胞组成,涵盖 8 个不同物种:人、小鼠、斑马鱼、恒河猴、食蟹猴、鼠狐猴、蛙和猪。
在对 IMA 进行可视化、预测绿猴细胞类型、匹配新物种细胞类型质心,以及预测 Norn 样细胞时,研究人员没有使用完整的 3,600 万个细胞,而是采用了 IMA 的一个代表性样本,这样做是为了加快 UMAP 计算等计算量较大的任务。该代表性样本通过从每个数据集中随机选择 10,000 个细胞构建,并采用无放回采样。对于细胞数量少于 10,000 个的数据集,则直接纳入整个数据集。最终得到的代表性样本共包含 2,969,114 个细胞,样本中每个数据集平均包含 9,486 个细胞。
为了评估模型在真正「陌生」数据上的表现,论文还使用了多个没有参与模型训练的数据集。例如,Tabula Sapiens v.2 包含 581,430 个细胞、27 种组织、167 个批次和 162 种独特细胞类型,是论文重要的零样本测试数据集。研究团队还准备了绿猴、裸鼹鼠和鸡等训练阶段未见过的物种数据,用来测试 UCE 是否真正具备跨物种泛化能力。在这些数据之外,论文还进一步分析了小鼠肾脏、人类肺部疾病等数据,用于验证 UCE 能否从已经存在的细胞图谱中发现新的生物学关系。
论文中分析的所有数据集均已公开,可供下载:
* 绿猴肺部和淋巴结数据集:登录号 GSE156755
* 裸鼹鼠数据集:登录号 GSE132642
* 鸡视网膜数据集:登录号 GSE159107
* 鸡心脏数据集:登录号 GSE149457
* 小鼠肾脏数据集:登录号 GSE193321
* 人类肺部疾病数据集:登录号 GSE136831
UCE:以生物学信息为基础的细胞基础模型
UCE 通过将细胞抽象为「 RNA 袋(bags of RNA) 」来克服整合 scRNA-seq 数据集面临的挑战。
UCE 完全采用自监督方式进行训练,不使用任何细胞类型标注或基于数据集的标注信息。如下图,UCE 首先将单个细胞的 RNA 基因表达数据转换为一个具有表达量权重的基因样本,随后利用蛋白质语言模型,根据这些基因所编码的蛋白质来表示样本中的基因。这使 UCE 能够仅依据蛋白质序列,有意义地表征来自任意物种的任意蛋白质编码基因,而不受该物种是否出现在训练数据中的限制。在进一步整合基因染色体位置等元数据后,这一表征会被输入一个大型 Transformer 模型。由此,UCE 能够在无需进一步训练的情况下,将来自任意组织或物种的细胞映射到一个共享的通用空间中。

UCE 模型概览
UCE 的输入包括两部分:(1)scRNA-seq 计数数据;(2)利用蛋白质语言模型 ESM2 生成的、与数据集中基因相对应的蛋白质嵌入。ESM2 蛋白质语言模型以氨基酸序列作为输入,并输出一种称为蛋白质嵌入(protein embedding*的数值表征。
对于某个细胞的基因表达计数数据,UCE 会按照表达量进行加权并归一化,在允许重复抽取的情况下对该细胞中的基因进行采样。这个样本只能包含具有非零表达量的基因,并且同一个基因可以在样本中出现多次。随后,这些基因会被标记化(tokenized),即转换为它们所编码蛋白质的蛋白质嵌入表征。
属于同一条染色体的基因会通过放置特殊标记进行分组,并按照它们在基因组中的位置进行排序。随后,在整个细胞表征的最前端加入一个代表整个细胞的特殊标记,即 CLS token。经过组合后的表征被输入 Transformer 神经网络,而细胞最终的嵌入则取自 Transformer 最后一层中 CLS token 对应的嵌入。
成果:获得超越实验直接观测数据本身的生物学洞见
基于 UCE,研究人员进一步构建了集成超大规模细胞图谱(Integrated Mega-scale Atlas),对 3,600 万个细胞进行了嵌入,其中包含超过 1,000 种具有唯一命名的细胞类型。借助这一统一的空间,得以进一步分析不同细胞类型与组织在其中的组织方式。
UCE 的嵌入空间表现出一些涌现能力(emergent behaviour)
研究发现,在 UCE 空间中,细胞会根据细胞类型等生物学条件自然聚类,同时不同实验条件下的细胞,例如来自不同批次的细胞,则能够相互混合(下图 b)。由于 UCE 在训练过程中只使用了未标注数据,因此这种组织结构并非模型被明确训练出来的结果,而是模型自身的涌现行为。

UCE 空间的统一流形近似与投影(UMAP)可视化
研究团队进一步考察了组织来源如何影响不同细胞类型的状态。尽管来自不同组织的巨噬细胞(macrophages)具有多样化的转录组特征,但它们在 UCE 空间中仍然能够高度对齐。例如,人类巨噬细胞分布于 73 种不同组织,其中有 72%(53个)的组织特异性巨噬细胞质心,在 UCE 空间中距离最近的细胞是来自其他组织的巨噬细胞质心。
类似的跨组织一致性也可以在其他大量存在的细胞类型中观察到,例如内皮细胞和神经元。这表明,UCE 无需经过显式训练或人工标签,就能够识别出巨噬细胞所具有的、在不同组织之间共享的独特细胞身份。这正是 UCE 一种与已知生物学规律相一致的涌现式组织结构,尽管模型并没有针对这一现象接受专门训练。
新数据集的零样本嵌入
研究人员在一个新的、尚未发表的数据集 Tabula Sapiens v.2 上评估了 UCE 的零样本表现。结果显示,UCE 的整体得分比表现最佳的 Geneformer 高出 13.9%,其中生物学信息保留得分高出 16.2%,批次效应校正得分高出 10.1%。与其他方法相比,UCE 生成的嵌入能够更加清晰地区分不同细胞类型(如下图)。
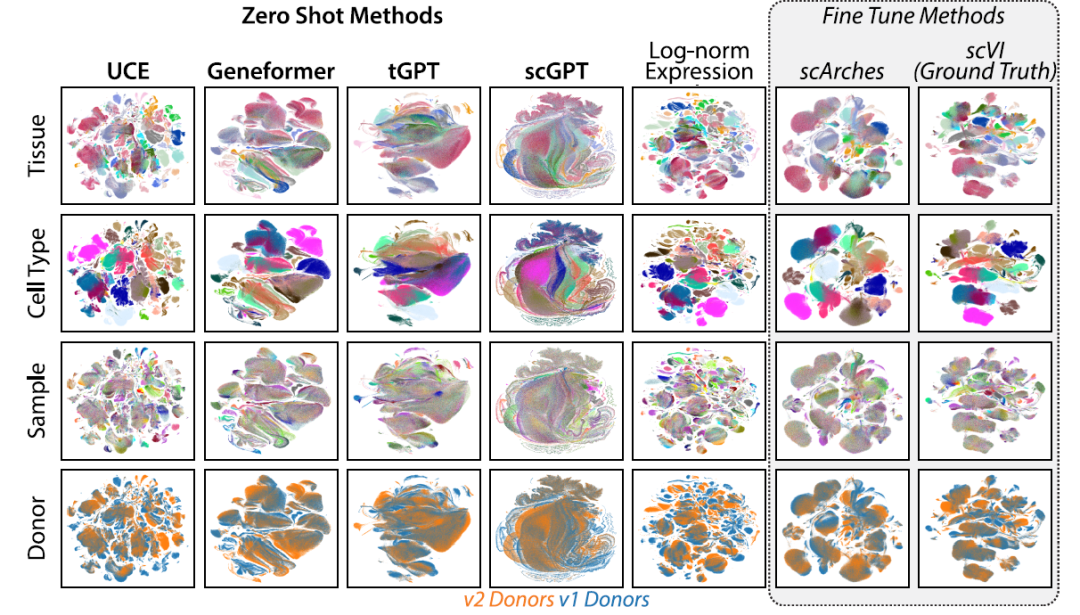
UCE 在整合 Tabula Sapiens v2 方面优于现有方法

UCE 能够重新捕捉 Tabula Sapiens v2 中的 B 细胞身份
新物种的零样本嵌入
研究人员进一步将 UCE 的表现与当前先进的跨物种标签迁移监督方法 SATURN 和 SAMap 进行了比较。在 4 个数据集中的 3 个上,UCE 在人类与新物种之间进行细胞类型标签迁移时的表现仍然优于 SATURN 和 SAMap。UCE 甚至能够针对高度进化分化的物种生成具有一致性的零样本嵌入,例如果蝇。
新数据中细胞类型的组织结构
除了关注单个细胞类型聚类的评价指标之外,研究团队还从整体层面考察了通用嵌入空间的结构,即分析不同细胞在该空间中的相对位置关系。将 Tabula Sapiens v.2 肺组织中的所有细胞进行嵌入后,可以观察到一种具有明确生物学意义的细胞类型组织结构(下图 a)。不同细胞类型不仅会分别聚集,例如 T 细胞、单核细胞和内皮细胞能够形成清晰的聚类,而且更高层级的细胞类别,例如免疫细胞和上皮细胞,也能够被明显区分。

针对新的、此前未见过的数据生成的 UCE 空间,呈现出具有生物学意义的细胞类型组织结构
研究人员进一步将这一结果与基于细胞本体得到的细胞层级结构进行比较。结果显示,与其他零样本嵌入方法相比,UCE 所识别出的细胞聚类与 Cell Ontology 之间具有更高的相似性。
更进一步的实验显示,UCE 能够有效学习一种通用的细胞生物学表征。这种表征不仅能够区分不同的细胞类型,还能够捕捉不同尺度下细胞类型之间的相对相似性,从而有望进一步揭示细胞发育和功能背后更深层次的生物学规律。
UCE 对肺部疾病结局的分析
最后,研究人员利用 UCE 以及此前构建的 Norn 细胞分类器,对肺部疾病中的 Norn 样细胞进行了研究——其对来自特发性肺纤维化(idiopathic pulmonary fibrosis,IPF)、慢性阻塞性肺疾病(chronic obstructive pulmonary disease,COPD)患者以及对照组患者的肺部细胞进行采样,并生成其细胞嵌入空间。在三组患者中,均识别出了表现出 Norn 标志基因偏好性表达的 Norn 样肺部细胞(下图 d);进一步分析发现,这些 Norn 样肺部细胞在不同疾病组之间存在表达差异(下图 e)。

Norn 细胞案例研究表明,UCE 能够支持对单细胞数据集的进一步分析
COPD 和 IPF 均与血液中 Epo 水平升高有关,但 COPD 患者的 Epo 水平高于 IPF 患者。此外,与 COPD 患者相比,IPF 患者的继发性红细胞增多症(secondary erythrocytosis)并不明显,或者其发生程度较低。鉴于研究在肺组织中发现了 Norn 样细胞,而 Norn 细胞能够产生 Epo,因此,这两种疾病在预后上的差异可能与疾病相关的 Norn 样细胞差异有关。
综合来看,这些结果表明,在机体其他组织中也能够发现与 Norn 细胞具有相似转录状态的细胞,而这些细胞可能在疾病过程中发挥此前尚未被描述的作用。由于 UCE 是一种不受组织、物种或疾病状态限制的通用模型,因此能够大幅促进对如此大规模、多样化数据的分析。
结语
通过构建 UCE,研究人员进一步拓展了对 scRNA-seq 数据进行分析的能力。尽管该模型代表了向通用细胞嵌入迈出的重要一步,但仍存在一些限制——目前的基准测试主要评估 UCE 恢复专家注释细胞类型的能力,但这类任务本身受到现有细胞标签的粒度和主观性限制。因此,这些评估可能无法充分反映模型表征更为细微的生物学过程的能力,例如细胞对扰动的响应,或不同模态数据之间的整合。此外,与其他大规模生物学基础模型一样,UCE 在很大程度上仍然是一个黑箱模型,因此很难解释某些嵌入为何以及如何形成。要解决这一不透明性,需要进一步开发可解释性工具,将模型学习到的表征与生物学机制层面的理解联系起来。UCE 的训练数据虽然规模庞大,但仍然偏向哺乳动物物种,尤其是人和小鼠,同时也偏向某些特定组织,例如脑组织,这引发了人们对模型能否泛化到代表性不足的物种和生物学场景的担忧。
最后值得强调的是,尽管 UCE 能够通过捕捉不同数据集之间共享的生物学信号来改善数据对齐,但它并不能取代传统的批次效应校正方法。对于处理已知的实验混杂因素而言,传统方法仍然具有重要价值。
参考文献:
https://www.nature.com/articles/s41586-026-10689-z

 225


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


