材料AI迈向「可解释时代」,日本团队破解高维光谱黑箱,锁定新材料发现关键特征

【信息科学与工程学】【通信工程】第十八篇 企业网、园区网、数据中心、广域网各类业务网络02 模型类别基本假设网络表示耦合函数渗透方程临界条件物理意义一对一依赖​每个交通节点与一个通信节点相互依赖双层网络:交通层G_T=(V_T,E_T),通信层G_C=(V_C,E_C),层间一一对应边E_I依赖函数:RT​=fT​(RC​,p),RC​=fC​(RT​,p)自洽方程: RT​=p[1−GT​0(1−RT​)][1−GC​0(1−RC​)] RC​=p[1−GC​0(1−RC​)][1−GT​0(1−RT​)]pc​=⟨kT2​⟩⟨kC2​⟩​1​ ⟨k²⟩=⟨k(k-1)⟩对称耦 阅读详情

近年来,机器学习在材料科学领域的应用备受关注,其应用已从早期的结构–性质标量预测(如带隙能量、点缺陷形成能、熔点等)逐步扩展到更复杂的高维物理量建模,其中最具挑战性的方向之一便是材料光谱的预测与解析。

介电函数、光谱(吸收、反射和发射)以及电子和声子态密度等光谱数据对于理解和设计材料至关重要。然而,与标量性质相比,高维光谱数据具有输出维度大、结构复杂、物理约束强等特点,使得传统机器学习方法难以同时兼顾精度与可解释性。深度学习模型虽然已经能够在一定程度上实现对光谱的预测,但「可解释性缺失」仍然是制约其在材料设计中进一步应用的关键瓶颈。

在此背景下,来自日本东京科学研究所的研究团队提出了一种深度学习模型的解释方法,能够处理材料科学中的高维光谱数据。研究人员构建了一个包含 2,681 种氧化物、硫族化合物及相关化合物的光吸收光谱第一性原理计算数据集。与标准密度泛函计算相比,对光谱起始能量和形状进行校正后,计算结果与已报道的实验光谱吻合度显著提高。

研究人员还利用该数据集和 ALIGNN 算法开发了一个高精度的光吸收光谱预测模型。通过特征提取和聚类分析相结合的方法,成功提取了主要决定光吸收起始能量和强度的关键元素种类及其配位环境。

相关研究成果以「Deep Learning–Based Extraction of Promising Material Groups and Common Features from High-Dimensional Data: A Case of Optical Spectra of Inorganic Crystals」为题,发表于 Advanced Intelligent Discovery。

研究亮点:

* 本研究提出了一种通过高维光谱数据的特征提取与聚类分析进行材料分类,从而提取潜在材料群组及其共性特征的方法。

* 本研究构建的第一性原理计算数据集和机器学习模型有望在未来的材料发现和材料信息学研究中发挥重要作用。

* 本研究提出的方法具有广泛的适用性,可用于各种光谱数据的分类和解释,其应用范围不仅限于无机晶体的光吸收光谱。

论文地址:https://advanced.onlinelibrary.wiley.com/doi/10.1002/aidi.202600007

利用高通量第一性原理计算构建数据集

研究人员首先从 Materials Project 数据库中筛选满足以下条件的氧化物、硫族化合物及相关材料:(1)材料至少包含 O、S、Se 中的一种元素,且其氧化数不一定为 −2;(2)材料不包含以下元素:H、卤素、稀有气体、Mn–Ni、Tc–Rh、Os–Ir、Po、镧系元素(La 与 Ce 除外)以及锕系元素;(3)材料不表现出自旋极化;(4)由于计算成本过高或晶体结构存在不确定性,排除空间群为 P1 且/或原始晶胞中原子数超过 40 的体系。

最终用于第一性原理计算的材料总数为 9,808 种,并按照下图所示流程构建计算数据库。

构建金属氧化物、硫族化合物及相关化合物介电函数的第一性原理计算数据库的工作流程

如图所示,该计算流程极为复杂,为了在保持一致性与高效利用计算资源的同时进行高通量计算,研究人员使用自研程序,并依赖 pymatgen、FireWorks、Custodian、atomate 以及 vise 等工具完成流程自动化。所有第一性原理计算均基于 VASP 软件包完成。该工作流程基于 PBEsol(+U) 计算生成光学吸收光谱与化合物形成能,并基于 nsc-dd 混合泛函以及 PBEsol(+U) 计算得到能带结构。

在机器学习数据集方面,研究人员剔除了:(1)在本地数据库中相对于竞争相不稳定的材料;(2)PBEsol(+U)带隙小于 0.3 eV 的材料。最终保留下来的材料数量为2681种。

构建基于光吸收光谱的 ALIGNN 模型

机器学习模型构建及预测精度

在模型层面,本研究采用 ALIGNN(Atomistic Line Graph Neural Network)作为核心预测框架,用于建模高维光学吸收谱。与传统晶体图卷积网络(CGCNN)相比,ALIGNN 的核心优势在于同时引入「原子图 + 键线图」双重表示,从而显式编码三体角度信息,实现对局域结构环境更精细的表达,下图上半部分给出了 ALIGNN 架构的示意图。

用于光学吸收光谱预测的ALIGNN模型及所提出解释方法的整体示意图

在该框架中,原子作为节点,原子间键作为边,并进一步将「边之间的关系」构建为线图,从而将键角信息转化为可学习的结构特征。这一设计使模型不仅捕捉两体距离信息,还能够刻画三体相互作用,从而更贴近真实的晶体物理行为。

特征提取和聚类

研究人员对优化模型的第一层 ALIGNN 进行了特征提取,并对每种材料所有原子位点的特征向量进行平均,然后进行层次聚类分析,如上图下半部分所示。该方法的目标是将材料分类为在输入特征(例如元素组成和原子配位特征,包括相邻原子数、原子间距离和键角)和输出属性(光吸收光谱)方面均表现出相似性的组。

下图显示了通过层次聚类得到的 96 个组的光学吸收光谱,每个簇内的光谱形状确实相似,证实了本研究聚类方法的有效性。

通过层次聚类得到的吸收光谱分类结果

成果:实现了材料群体结构与物理机制的可解释性提取

研究人员为了验证新深度学习模型在处理材料科学中高维光谱数据的能力,进行了系列试验:

预测性能能力

在预测性能方面,ALIGNN 模型在测试集中整体表现出较高精度,如下图所示,其中约 75% 的材料吸收谱预测平均绝对误差(MAE)低于 0.14,说明模型能够较好重现复杂光谱形状。
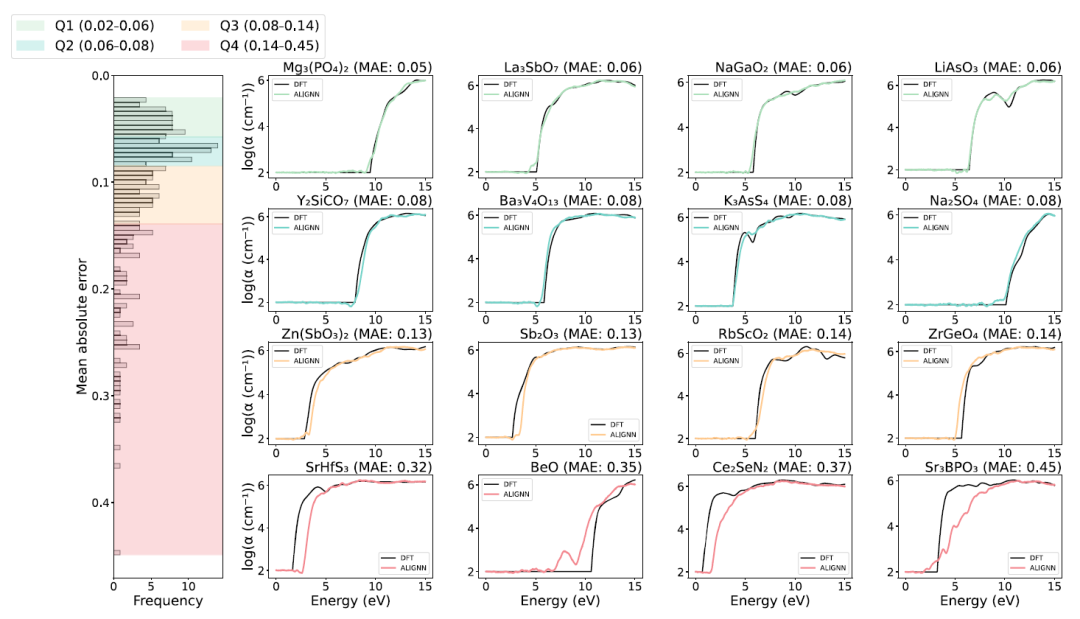
使用优化后的ALIGNN模型对测试集光学吸收光谱的预测结果

上图右侧面板展示了在各四分位区间中误差最大的四种材料的预测结果。对于前三个四分位区间中的材料,ALIGNN 预测结果(彩色曲线)与第一性原理参考计算结果(黑色曲线)吻合良;然而,第四四分位中的部分化合物在光学吸收光谱的起始位置上出现明显偏差,这些离群样本预测性能较差,主要原因在于其独特的电子结构,以及训练数据集中相似结构材料的不足。

捕捉光学吸收光谱起始位置的能力

尽管 MAE 是一个覆盖整个光谱范围的全局指标,研究人员还进一步考察了模型是否能够准确再现局部光谱起始能量。下图给出了一个一致性(parity)图:比较第一性原理计算与 ALIGNN 预测中,当 log₁₀ α(ω) 首次超过 2.5 时对应的最低光子能量,其中 α 表示吸收系数。

测试集光谱起始能量的配对图(parity plot)

结果显示,该起始能量预测的 R² 为 0.950,MAE 为 0.353 eV,表明 ALIGNN 模型能够较为准确地捕捉光学吸收光谱的起始位置。

可解释性分析

在可解释性分析方面,研究人员从 ALIGNN 第一层提取特征表示,并对材料进行层次聚类,从而形成 96 个材料群组。结果显示,同一簇内材料在光谱形状上高度一致,尤其在吸收起始位置与吸收边陡峭程度方面表现出明显共性,这说明模型在早期层已学习到与光谱相关的结构特征表达。

而进一步的案例分析显示,不同材料群组具有清晰的物理差异。以第 74 簇为例,该簇中的材料通常具有较宽的带隙以及在光谱起始附近较高的吸收系数。下图 a 显示,该簇中的所有材料均包含 V 或 Cr 元素,其他阳离子则主要为碱金属,这些材料大多以 VO₄³⁻、CrO₄²⁻ 或 Cr₂O₇²⁻ 形式存在,其中阳离子处于四面体配位环境。

属于第 74 簇的物质的光学吸收光谱,其中 α 表示吸收系数

研究人员使用 matminer 中实现的 CrystalFingerprintNN,对该簇中各材料的阳离子位点四面体配位指数进行计算,并分析所有阳离子位点最大值的分布。如下图 b 所示,大多数材料确实存在四面体配位位点。

第 74 簇材料(红色)与整体数据集(蓝色)的四面体配位相似性分布

从电子态密度来看,在导带底(CBM)附近可以观察到由 V-d 或 Cr-d 态引起的尖锐峰值。V⁵⁺ 与 Cr⁶⁺ 的高价态提供了大量可用于光学跃迁的未占据电子态。因此,从固体化学与物理角度来看,这些钒酸盐、铬酸盐与重铬酸盐具有较高的光学吸收系数是合理的。

这种从「模型聚类结果」反推「化学机制」的过程,使得机器学习结果不再是黑箱预测,而成为可用于材料设计的知识来源。此外,研究还对比了基于原始光谱数据直接聚类的结果,发现其虽然能够识别相似光谱,但难以形成清晰的化学结构分组,材料类型混杂严重。这进一步证明 ALIGNN 特征空间在「结构–性质一致性表达」方面的优势。

结语

本研究的意义不仅在于构建了一个高精度光学吸收光谱预测模型,更重要的是提出了一种将「深度学习表示学习」与「材料物理解释」相结合的方法框架。通过 ALIGNN 模型与层次聚类分析的结合,研究实现了从高维光谱数据中提取材料共性规律的能力,使得机器学习模型不仅能够预测结果,还能够揭示结果背后的结构与电子起源。

理想情况下,需要将电子–空穴相互作用、电子–声子耦合以及点缺陷的影响纳入考虑,以分别再现激子效应、声子辅助电子跃迁以及缺陷相关的光谱特征。然而,在包含这些效应的情况下进行高通量第一性原理光谱计算计算成本过高,因此本研究未予实现。即便如此,未来随着更高精度多体计算方法与机器学习模型的进一步融合,该类研究有望在材料发现过程中发挥更加核心的作用,推动材料设计从经验驱动走向数据驱动与机制驱动融合的新阶段。


【信息科学与工程学】【数据科学】数据科学领域 第六篇 算法设计 01 算法设计 阅读详情

相关推荐

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 205

地球Online逃生指南(上卷)

本书是一部系统探讨人类意识困境的哲学著作。全书通过七卷本的结构,依次解构人类认知牢笼、自我本质、世界实相、痛苦根源,最终指向自由、慈悲与终极实相。第一卷揭示大脑建构的认知幻象;第二卷剖析"自我"的神经机制;第三卷以系统论阐释世界空性;第四卷建立痛苦的数学模型;第五卷提出觉知训练体系;第六卷论证利他主义的科学基础;第七卷超越逻辑束缚直指存在本质。著作融合现代神经科学、量子物理、复杂性理论与东方哲学,构建了一个从认识到解脱的完整认知框架,最终指向无条件的临在与宇宙层面的觉知。

weixin_45747731的博客 836

船载 OpenHarmony AIS 航海工作台:告警与防碰撞预警系统

船载OpenHarmony AIS航海工作台的告警与防碰撞系统,集成十余类告警(超速、偏航、会遇、SOS等),通过网格空间索引实现高效邻近判定,保障实时性。告警管理器统一调度规则、去重、通知与日志,支持悬浮球、语音、跑马灯、弹窗多渠道触达,确保航行安全。SOS紧急通道独立运行,避免干扰。系统设计强调性能优化与多场景适配,为航海安全提供核心支撑。

专注于计算机研发知识和资讯分享 113

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 223

ESXI 7 :创建统信V20_1050d服务器系统虚拟机

记录一下在 X86 架构创建统信V20_1050d 虚拟机遇到的问题。已遇到的问题有①:常规服务器环境下网络连接失败重点:按照桌面版本,有问题处理简单。

guyuelin123的博客 1968

用Matlab系统辨识工具箱搞定温控系统建模:从阶跃响应到传递函数(附完整代码)

本文详细介绍了如何使用Matlab系统辨识工具箱进行温控系统建模,从阶跃响应数据采集到传递函数参数辨识的全过程。通过实际案例和完整代码,帮助工程师快速掌握PID控制参数整定技巧,提升温控系统设计效率。特别适合单片机开发者和自动化控制工程师参考。

weixin_30736301的博客 310

6 款电商 AI 图片生成软件实测|国内 + 跨境卖家工具清单

电商 AI 作图工具已经从 "能不能用" 进入了 "好不好用" 的阶段。对于绝大多数卖家而言,现在的 AI 工具已经可以覆盖 60%-80% 的基础商品图需求,显著降低拍摄和设计成本。选择工具的核心逻辑不是 "哪款最强",而是 "哪款最适配你的品类、平台规模和团队能力"。垂直电商工具胜在工作流效率,通用生图工具强在创意上限,模板类工具赢在上手速度。建议根据自身业务阶段,搭配 1-2 款主力工具 + 1 款辅助工具,形成适合自己的视觉生产流程。

Mardi_Ladin的博客 398

别再为跨页读写发愁了!STM32F407模拟I2C驱动24C256/512的避坑指南

本文详细解析了STM32F407模拟I2C驱动24C256/512的跨页写入问题,揭示了24C系列存储器'写满一页不会自动翻页'的关键机制,并提供了经过验证的分页写入算法和优化方案。通过GPIO时序优化、地址计算和错误处理等技巧,帮助开发者解决数据错乱、覆盖等常见问题,实现稳定可靠的EEPROM读写操作。

weixin_42631411的博客 377

我用 GPUWorks 在 M1 Pro 上搭了个发票识别原型

公司里经常要看电子发票。我想先做个小原型:把 PDF 发给一个自己部署的图文模型,让它提取发票类型、日期、交易双方和金额,再把结果交给同事核对。这个原型不用先接财务系统,先看看从部署到调用要走多少步,模型返回的内容能不能帮上忙。

鸽芷咕的博客 2万+

西门子RS485自由口通信Modbus RTU 通信协议

部分西门子的RS485模块不能使用西门子自带的Modbus RTU通信指令,需要通过自己拼接、发送、接收和解析报文完成Modbus RTU通信。通过多次尝试完成该功能: #R_TRIG_Instance(CLK := #触发, Q => #触发上升沿); IF #触发上升沿 THEN // 触发后先将读取完成复位 #读写完成 := 0; END_IF; CASE #功能码 OF 1: // 线圈状态读取 ; 2:

qq_20792765的博客 1万+

yolov5 部署jetson nano(通用) 保姆级教学

Jetson nano从配置环境到yolov5成功推理检测全过程 文章目录Jetson nano从配置环境到yolov5成功推理检测全过程一、烧录镜像二、配置环境并成功推理1.更新系统和包2、配置环境2.1 配置CUDA2.2 修改Nano板的显存1.打开终端输入:2.修改nvzramconfig.sh文件:3.重启:4.终端输入:3、安装archiconda(也就是jetson nano板上的anaconda)1.下载地址:2.安装:3.测试conda:4.创建运行yolov5的虚拟环境:5.在conda

weixin_44312422的博客 3万+

您您这可以把问小白的多个会话比如说。左侧的多个会话一次性导出吗?不是单条会话里面的多次会对话。AI导出鸭

第三层是格式编译层。这个决策背后的判断很清晰:一个批量导出工具的价值,不在于“试三次”,而在于你真正用它处理了几十份技术文档、访谈记录或课程讲义之后,它是否值得留在你的工作流里。问小白的会话列表通过分页接口加载,AI导出鸭 在页面运行时建立旁路监听,捕获每一次分页请求返回的完整对话清单,包括会话 ID、标题、时间戳和隐藏的元数据字段。让AI导出回归优雅——这句话说的是:导出不该是体力活,而应该是一次完整的、可预期的文件交付。注意:这里的“批量”指的是左侧列表里的多个独立会话,不是一条会话内的多轮对话。

laoyunsi的博客 246

Android HCE实战:手把手教你用Kotlin实现NFC公交卡模拟(含完整APDU指令解析)

本文是一份Android HCE实战指南,详细讲解如何使用Kotlin实现NFC公交卡模拟。内容涵盖HCE服务搭建、APDU指令(如SELECT AID、GET PROCESSING OPTIONS)的完整解析与响应逻辑,并提供读卡器端测试代码,帮助开发者深入理解基于主机的卡模拟技术。

qsc901234567的博客 1117

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 500

基于matlab不变矩的数字验证码识别系统

随着互联网技术的快速发展和应用,网络给人们提供了丰富的资源和极大的便利,但随之而来的是互联网系统的安全性问题,而验证码正是加强 Web 系统安全性的产物。全自动区分计算机和人类的图灵测试(Completely Automated Public Turing test to tell Computers and Humans Apart,CAPTCHA)也是验证码的一个应用程序,可以区分用户是人类还是计算机智能单击对象。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 917

MobileViT替换YOLOv11主干网络:轻量化新思路-(用MobileViT等轻量视觉Transformer降低计算成本)

在计算机视觉领域,目标检测一直是核心任务之一,而YOLO(You Only Look Once)系列算法因其出色的速度-精度平衡成为工业界和学术界的热门选择。随着YOLOv11的推出,模型性能达到了新的高度,但其计算复杂度和参数量也随之增加,这对资源受限的移动设备和嵌入式系统提出了挑战。与此同时,视觉Transformer(ViT)的出现为计算机视觉带来了全新范式,但其庞大的计算需求限制了在移动端的应用。MobileViT作为一种创新的轻量级视觉Transformer架构,巧妙结合了CNN的归纳偏置优势和V

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1647

河道漂浮物目标检测数据集

目标检测,yolo,河道漂浮物目标检测数据集

DL_data_set的博客 201

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

AI Agent之核心框架

A: 显式 Thought 有三类价值:可解释性(便于人类审计)、可调试性(定位哪一步选错工具)、学习信号(可做监督微调或评估中间步骤质量)。ReAct 把推理与 可执行行动 绑定,每一步行动后都有 真实 Observation 反馈,从而用工具结果约束生成,降低闭卷幻觉。做完不等于结束——还要 评估做得好不好,把 教训 记下来,下次 带着教训重试,反思作为 记忆,影响后续尝试的策略。工作流程:Action → Evaluation → Reflection → Retry。A: 普通 CoT 只在。

剑雨巍巍的博客 199

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

AI 应用开发工程师技术实践:大模型接入、通用组件封装与性能优化

本文提出AI应用从PoC到生产的核心挑战:模型调用的持续可用、可控与可优化。通过构建统一LLM网关实现多供应商路由与故障转移,封装对话、工具调用与RAG组件以解耦业务逻辑,结合前缀缓存、批处理与流式背压治理等性能优化手段,形成“接通→接稳→接快”的工程路径,最终以工程化能力决定AI应用的生产可用性。

2301_79189962的博客 558

AI前沿日报 · 2026-11-04 | 祛魅时刻:Astra“纯读权重“神话的崩塌

①Astra"裸权重通吃"被spaCy创始人Honnibal精准祛魅——仅1/3实验真裸读,数学能力提升依赖Python+50次迭代;②Simon Willison用Qwen 3.8-27B端侧复现权重空间编程;③Nvidia开源Auto-Ontology自动知识图谱;④$800开源全域抓取机器人Stringman;⑤OpenAI悄然重开Codex训练开关引信任危机;⑥DeepMind发布Gemini 4 Argon机器人基础模型;⑦美国科技巨头隐性AI债务达3.2万亿美元,6个月增90%。

johnsong2009的博客 573

大模型 Embedding 与向量相似度详解

Embedding 解决的问题:计算机不懂文字,但懂数字│▼文本 → 向量(1024维浮点数数组)│▼相似度解决的问题:怎么判断两个向量(文本)有多接近│▼余弦相似度:看向量方向的夹角,越接近0°越相似│▼最终效果:语义搜索——理解意思,而非字面匹配一句话总结:Embedding 把文字变成数字,余弦相似度比较数字的方向,两者结合实现了"理解语义"的搜索。

T3165919332的博客 90

GPT-1 架构和计算细节

下面配合框图,对 GPT-1 的每个组件做公式展开 + 数值实例(配置:12 层 × 768,12 头,FFN 3072,词表 40478,共 117M 参数)。GPT-1 把翻译模型的编码器-解码器砍掉一半,只留解码器,然后以"预测下一个词"为目标在 BooksCorpus 上预训练。与 2017 原版的四个架构差异(框图中标 ★):h0=E[token]+Epos[position],E∈R40478×768, Epos∈R512×768h^0 = E[\text{token}] + E_{pos}[\

eloudy的专栏 278

终端 AI 审计与 “龙虾” 类智能体风险治理:从可见性到闭环溯源

生成式 AI 办公普及之后,数据泄露风险逐步下沉到终端。员工将合同、源代码、客户资料粘贴至公有大模型,以及龙虾(OpenClaw)这类本地开源 AI 智能体的滥用,成为企业安全新挑战。传统网络边界防护存在审计盲区,本文从风险链路拆解、核心能力模型、分级治理策略、落地踩坑点以及技术局限性多角度,分享终端侧 AI 安全治理的实践思路。

2401_86491085的博客 640

2.53 基于极稀疏指纹的室内定位注意力图元学习

该论文发表于IEEE Transactions on Mobile Computing(TMC)2026年6月,面向极稀疏指纹条件下的WiFi室内定位,针对指纹采集人力成本高、标记指纹稀缺时定位精度大幅下降的痛点,提出注意力图元学习模型AGML(Attentional Graph Meta‑Learning),结合图神经网络、元学习、两种指纹数据增强与分布对齐技术,在标记指纹极少的场景实现高精度室内定位,同时公开了多套真实+仿真定位数据集用于基准测试。场景:二维室内空间,障碍物造成信号遮挡,

weixin_42963026的博客 338

语音识别与语音合成的技术原理及应用

语音识别 #语音合成 #人工智能 #大模型。语音识别与语音合成的技术原理及应用。一、语音识别的核心原理。二、语音合成的核心原理。三、工程落地的主要难点。五、需要关注的现实问题。

weixin_62919816的博客 210

设计师工作室 GEO 实操:如何提升 AI 实体推荐概率

设计工作室 GEO 的本质,是把创意服务转化为 AI 可理解的结构化信息。核心动作可归纳为:区分事实与审美、建立实体图谱、预判用户提问、输出脱敏内容、搭建多信源、持续测试验证。梳理工作室的 6 个实体属性:品类、城市、流程、边界、团队、渠道。在官网或作品集平台发布至少 3 篇结构化项目复盘,只陈述事实。输出 1 篇「设计报价影响因素」科普内容,覆盖甲方高频提问。争取 1 次行业媒体或本地媒体专访,形成第三方信源。每周用「XX 城市 + 品类 + 设计工作室推荐」指令测试,记录出现频率。

goujunwe的博客 337
上一篇: 基于Gemini 1.5长上下文能力,谷歌对话式医疗系统AMIE在100例多次就诊场景中达到全科医师的推理水平
下一篇: 在线教程丨UC伯克利/英伟达等发布3DGS开源库gsplat,节省4倍显存,训练时间缩短10%
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值