在线教程丨小身材大「码」力,Qwen3.6-27B编程能力达旗舰级

昇腾Atlas Duo 300I推理卡实战:从零部署Qwen大模型推理服务 本文详细记录了在华为昇腾Atlas Duo 300I推理卡上,从零部署Qwen1.5-14B-Chat大模型推理服务的完整实战过程。涵盖环境准备、MindIE容器配置、CANN工具链安装、服务启动与API测试等关键步骤,并分享了性能观察与排错经验,为国产AI算力平台部署LLM推理服务提供了实用指南。 阅读详情

4 月 22 日,继 Qwen3.6-35B-A3B 开源后,Qwen 团队带来了该系列模型中社区呼声更高的版本——Qwen3.6-27B。这个拥有 270 亿参数的稠密多模态模型,支持多模态思考与非思考模式,在智能体编程方面达到了「旗舰级」表现。

具体而言,Qwen3.6-27B 在 WE-bench Verified(77.2 vs. 76.2)、SWE-bench Pro(53.5 vs. 50.9)、Terminal-Bench 2.0(59.3 vs. 52.5)以及 SkillsBench(48.2 vs. 30.0)等主要编程基准测试中,均全面超越前代开源旗舰 Qwen3.5-397B-A17B。同时,其也大幅领先于同规模的稠密模型。在推理任务上,Qwen3.6-27B 在 GPQA Diamond 上取得了87.8的成绩,可与数倍于其规模的模型相媲美。

图片

此外,Qwen3.6-27B 原生支持多模态,支持视觉语言思考与非思考模式——与 Qwen3.6-35B-A3B 相同。它能够处理图像、视频与文本的多模态理解,支持视觉推理、文档理解和视觉问答等任务。

目前,HyperAI 官网(hyper.ai)的教程板块已经上线了「一键部署 Qwen3.6-27B」,完成环境配置,助力快速验证热门开源模型!

在线运行:https://go.hyper.ai/pYbes

图片

demo 效果示例,基于 prompt 生成可交互的重力模拟沙盒

更多在线教程:

https://hyper.ai/notebooks

欢迎登录官网查看更多内容:

https://hyper.ai/

Demo 运行

1.进入 hyper.ai 首页后,选择「教程」页面,或点击「查看更多教程」,选择「一键部署 Qwen3.6-27B」,点击「运行此教程」。

图片

图片

2.页面跳转后,点击右上角「Clone」,将该教程克隆至自己的容器中。

注:页面右上角支持切换语言,目前提供中文及英文两种语言,本教程文章以英文为例进行步骤展示。

图片

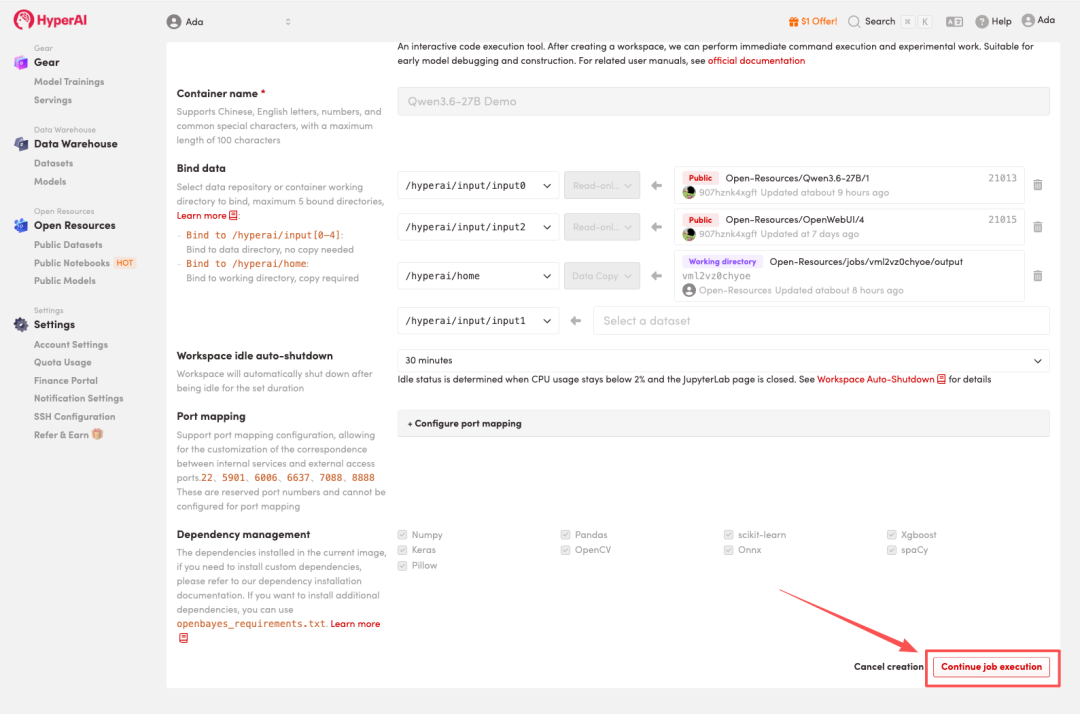
3.选择「NVIDIA RTX 5090 -4」以及「vLLM」镜像,点击「Continue job execution(继续执行)」。

HyperAI 为新用户准备了注册福利,仅需 $1,即可获得 20 小时 RTX 5090 算力(原价 $7),资源永久有效。

图片

图片

4.等待分配资源,当状态变为「Running(运行中)」后,点击「Open Workspace」进入 Jupyter Workspace。

图片

效果展示

1.页面跳转后,点击左侧 README 文件,进入后点击上方 Run(运行)。

图片

图片

2.待运行完成,根据 README 提示启动 Open WebUI 后,即可点击右侧 API 地址跳转至 demo 页面。

图片

图片

提升ARM Cortex-M系统性能的关键技术:TCM技术解析与实战指南 TCM技术为ARM Cortex-M处理器提供了宝贵的确定性性能提升手段,特别适合对时序敏感的实时应用。通过合理配置和优化,工程师可以显著提高系统性能、降低中断响应时间并优化功耗。随着嵌入式系统对实时性要求的不断提高,TCM技术将在工业控制、汽车电子、医疗设备等领域发挥更加重要的作用。未来,ARM处理器可能会进一步扩展TCM容量并优化其与其他内存子系统的协同工作方式,为开发者提供更强大的实时性能保障。 阅读详情

相关推荐

S型速度曲线进阶:基于Sin²(x)的PLC平滑运动控制实践(以伺服/步进系统为例)

本文深入探讨了基于Sin²(x)的S型速度曲线在PLC平滑运动控制中的实践应用,特别针对伺服/步进系统。通过对比传统梯形曲线和七段S曲线,详细展示了Sin²(x)曲线在加速度连续性、计算效率和参数自适应性方面的优势,并结合博图平台的具体实现技巧和实战案例,为精密运动控制提供了优化方案。

weixin_28718793的博客 242

Qwen3.6-27B 本地私有化部署 + Claude Code 连接应用

Qwen3.6-27B 相比与上一代的 Qwen3.5-27B,在编程能力上有了大的飞跃,平常我们使用Claude Code做任务开发的时候,往往会消耗巨大的 Token 量,如果将一些常用重复性的开发任务使用 Qwen3.6-27B 来开发,不仅可以节省一些 Token 的使用量,还能提高响应效率。因此本文主要实现Qwen3.6-27B的本地私有化部署,以及Claude Code连接使用。

小毕超博客 5602

手把手教你用WKT文件在Petrel中创建自定义坐标系统(附CGCS2000转换模板)

本文详细介绍了如何在Petrel软件中利用WKT文件创建自定义坐标系统,并重点提供了CGCS2000坐标系的完整转换模板与实战步骤。通过解析坐标系统的三大支柱(大地坐标系、投影坐标系、基准转换)和WKT文件结构,指导用户从零开始构建适用于本土化项目的坐标系统,确保地质建模与空间数据处理的精度与一致性。

gpt4scribbler的博客 279

27B 也能打穿旗舰线?Qwen3.6-27B 如何用“中杯体量”干翻巨无霸模型

Qwen3.6-27B开源大模型发布:270亿参数旗舰编码模型全面解析 2026年4月22日,千问团队开源了270亿参数的Qwen3.6-27B多模态模型,定位为"旗舰级编码能力"开源模型。该模型采用稠密Transformer架构,在编码基准上全面超越上一代397B参数的MoE模型Qwen3.5-397B-A17B,同时部署成本大幅降低。核心优势包括: 强化了仓库级代码理解与智能体编程能力 原生支持262k tokens长上下文和多模态输入

高丽大学人工智能硕士在读|专注大模型、RAG、OCR与AI工程实践 1256

使用DDR4控制器实现多通道数据读写

这种高带宽对于大量的数据的应用非常重要。对于Controller/PHY Mode 的选择,我们使用Controller + PHY模式,Xilinx UltraScale/UltraScale+等高端FPGA通常包含硬核PHY,选择Controller + PHY模式可直接利用硬核,降低功耗和延迟,并且此模式的开发更易上手。在Basic页面下,首先勾选上AXI4 Interface选项,我们选用的内存接口速度为2133MHz的ddr4芯片,由于双沿触发,频率为1066MHz,那么周期应为938ps。

weixin_38828382的博客 1364

Cadence导入tsmcN65GP PDK的完整流程与常见问题解析

本文详细介绍了Cadence导入tsmcN65GP PDK的完整流程,包括文件解压、目录结构解析、安装脚本运行及Cadence集成配置。重点解析了常见问题如文件路径错误、权限问题和工艺库显示不全的解决方案,并提供了实战技巧与优化建议,帮助用户高效完成PDK安装与配置。

weixin_29215391的博客 546

本地大模型的“甜点”时刻:为什么 Qwen 3.6 27B 是开发者的新宠?

Qwen 3.6 27B 被誉为本地部署的“甜点”模型,完美平衡了智力与硬件成本。本文将带你深入了解它为何能在消费级显卡上跑出 GPT 级体验,并手把手教你打造高效的本地 AI 编程环境,实现性能与成本的双赢!🚀

yweng18的博客 811

基于AR和SLAM技术的商场智能导视系统技术原理详解

本文针对智慧商场室内导航需求,提出基于AR和SLAM技术的商场智能导视系统技术方案,实现了沉浸式导览体验并促进消费转化,助力商场运营升级。

维小帮定位导航的博客 1243

Qwen3.6-27B开源:单卡部署最强中文模型的完整指南

模型能力不等于参数量。通过架构创新(Gated DeltaNet混合注意力)和训练优化(MTP多步预测),27B稠密模型在编程能力上超越了15倍参数的MoE模型。之前:要旗舰级编程能力,必须用云API或8卡H800现在:一张4090就够了你的情况推荐有32GB+ MacOllama跑Qwen3.6-27B,日常开发完全够用有4090vLLM跑Int4版,接入Claude Code做分工有A100 80GB跑BF16原版,可以做团队内部共享服务只有CPU。

在渔村里看AI,偶尔捕点新鲜的。 3264

手把手教你用Ubuntu Desktop搭建个人L2TP服务器,手机电脑都能连(Network Manager配置详解)

本文详细介绍了在Ubuntu Desktop上使用Network Manager图形化配置L2TP服务器的方法,实现手机、电脑等多设备安全连接。从环境准备、图形界面设置到各平台客户端配置,提供一站式解决方案,并包含常见问题排查与安全增强措施,帮助用户快速搭建个人远程访问网络。

weixin_30555125的博客 119

ABAP Cloud 里的高性能日志:CL_BALI_LOG、XCO_CP_BAL 与 AML 的性能对比与选型指南

ABAP日志框架性能对比与选型建议 本文对比了ABAP Cloud中三种主流日志框架的性能表现与适用场景: 标准BALI:适合明确需要保存日志的场景,保存路径短,性能较好 XCO_CP_BAL:API更现代但性能较低,适合需要即时可见性的场景 AML:开源框架,擅长消息缓冲,适合批量处理时暂存消息 测试结果表明: 纯记录不落库时AML最快 需要保存时BALI性能最优 second connection不提升性能但能确保日志留存 选型建议: 高频批处理优先AML+BALI组合 故障诊断考虑XCO的即时可见性

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 215

Qwen3.6-27B本地部署262K上下文:软硬件配置全解析

Qwen3.6-27B 本地部署262K上下文完整指南:270亿参数稠密架构、Gated DeltaNet注意力、vLLM推理框架配置与分级硬件方案详解。

专注IT技术、AI实践与架构思考。 1633

GFPS技术原理(一)-简介

GFPS(谷歌快速配对服务)利用BLE技术简化设备配对流程,相比传统方式大幅提升用户体验。首次配对时,设备广播包含型号ID和安全密钥的BLE信号,手机检测后弹出配对通知,用户点击即可完成安全连接并将设备与Google账户绑定。该技术支持跨设备同步、电量显示、找回设备等功能,后续配对更加便捷。GFPS通过BLE实现快速发现、一键配对和安全连接,结合Google后端服务提供元数据支持,已成为出海设备的认证标准。其核心优势在于简化操作步骤并增强功能性,特别适合非技术用户群体。

十多年蓝牙协议软件开发,擅长蓝牙协议分析 2062

Qwen3-32B 多任务处理能力全面测评,性能稳居前列

本文全面评测阿里云Qwen3-32B模型的多任务处理与长文本理解能力,分析其在中文场景下的性能优势。该模型以320亿参数实现高效推理,支持128K上下文,在企业级应用中展现高性能、低成本与高安全性,适合法律、金融、科研等复杂场景。

weixin_31597759的博客 1026

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Qwen3-32B与同类模型对比:综合性能稳居第一梯队

Qwen3-32B以320亿参数实现接近70B模型的性能,支持128K上下文、多任务处理与单卡部署,通过高参数效率、推理优化和开源可控性,成为企业级AI落地的理想选择。

weixin_32306683的博客 807

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Qwen3-32B 模型训练数据来源及合规性说明

Qwen3-32B以320亿参数实现接近700亿级模型的性能,支持128K超长上下文,具备强推理、多任务处理与私有化部署能力。通过RoPE、KV Cache、GQA等技术优化,在金融、医疗、政企等高安全要求场景中展现卓越实用性。

weixin_42602368的博客 908

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

虚拟试衣间智能推荐:Qwen3-VL-30B理解用户身形特征

阿里云Qwen3-VL-30B多模态大模型通过细粒度身形感知与跨模态推理,实现个性化穿搭建议。支持图像、文本及视频输入,结合稀疏激活架构,在保障隐私与效率的同时,提供秒级智能推荐,推动虚拟试衣技术迈向人性化、实时化新阶段。

weixin_33072399的博客 678

3分钟跑通Qwen3.8-2B-Distill-GGUF:llama.cpp本地大模型推理新手完整教程

**Qwen3.8-2B-Distill-GGUF** 是 Empero 开源的一套 **GGUF 量化大模型文件**,专为 llama.cpp、Ollama、LM Studio 等本地推理运行时设计。它把 Qwen3.8 2.4T 旗舰模型全参数蒸馏进 2B 级架构,无需 GPU、无需联网,普通笔记本甚至手机都能在 3 分钟内跑起这个强大的推理模型,是 **llama.cpp 本地大模型推理**

gitblog_01057的博客 730

Qwen3-8B爆款商品卖点提炼

Qwen3-8B是一款80亿参数的高效大模型,支持32K上下文,在消费级显卡如RTX 3090上可流畅运行。其在中文理解、推理速度和部署灵活性方面表现突出,适用于本地部署、企业服务与私有化场景,结合Ollama、vLLM等工具实现高性能推理,显著降低AI应用成本。

weixin_35754676的博客 295

Qwen3-VL-8B如何实现高质量跨模态推理?技术细节揭秘

本文深入解析轻量级多模态模型Qwen3-VL-8B的技术架构,涵盖视觉编码、跨模态对齐与语言生成三大核心模块,揭示其在单卡GPU上实现高效图文理解的原理,并提供部署实践与典型应用场景,展现小参数模型在真实业务中的落地价值。

weixin_42504649的博客 875

Phi-3-mini-4k-instruct参数详解:3.8B模型如何实现13B级推理能力?

本文介绍了如何在星图GPU平台上自动化部署【ollama】Phi-3-mini-4k-instruct镜像,充分发挥其3.8B参数下媲美13B模型的高效推理能力。该镜像适用于本地化AI助手搭建,典型场景包括逻辑严谨的医疗咨询分析、代码错误归因与修复、以及风格精准的创意文本生成,显著提升研发与教育场景下的交互效率。

weixin_35949153的博客 384

Qwen3-VL-30B如何识别服装款式?时尚产业应用测试

本文介绍阿里云Qwen3-VL-30B视觉语言大模型在时尚产业中的应用,解析其通过视觉编码、跨模态融合与语言生成实现服装款式、风格与场景的智能识别,并支持自动生成搭配建议与商品文案,提升电商自动化与个性化水平。

weixin_42513870的博客 870

Qwen3-8B跨境电商客服自动化解决方案

Qwen3-8B凭借80亿参数在中英文双语能力、32K上下文支持和低硬件要求方面表现突出,可在单卡RTX 4090上部署,结合RAG实现安全、高效的跨境电商客服自动化,支持私有化部署与快速集成。

weixin_35677363的博客 289

中文大模型新标杆:Qwen3-8B在长文本理解中的卓越表现

Qwen3-8B以80亿参数支持32K上下文,在长文本理解中表现卓越,具备高效推理与跨段落语义关联能力,适用于企业知识库、法律审查与教育批改等场景,且可在消费级显卡部署,推动大模型平民化。

weixin_35750747的博客 332

Qwen3-8B UserManual用户手册多语言版本一键生成

本文介绍如何利用阿里通义实验室推出的轻量大模型Qwen3-8B,构建自动化多语言用户手册生成流水线。该模型仅需80亿参数,支持32K上下文,在消费级显卡上即可高效运行,结合提示工程与术语统一机制,实现高质量、格式一致的多语言技术文档批量翻译。

weixin_35835030的博客 409

Qwen3-VL-8B真实生成效果展示:电商商品图+文案联合理解输出案例

本文介绍了如何在星图GPU平台自动化部署Qwen3-VL-8B AI聊天系统Web镜像,实现电商场景下的商品图文联合理解与智能描述生成。该镜像能够自动分析商品图片和文案,输出准确的产品特征描述,提升电商运营效率和内容生成自动化水平。

weixin_35755640的博客 350
上一篇: ICLR 2026 丨单任务可训练参数减少 125 倍!新方法 Task Tokens 助力具身智能提升复杂任务能力
下一篇: 天鹜科技发布MatwingsVenus™,给AI一个共享实验室
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值