


作者:梅菜
编辑:李宝珠
转载请联系本公众号获得授权,并标明来源
来自明尼苏达大学双城分校的研究团队开发了一种创新知识引导型机器学习模型,该模型的算法结构直接受到水文学科学知识的启发,被称为因子化层级神经网络(FHNN)。研究表明,在预报发布后 2–7 天的时间尺度上,该模型的性能与美国国家气象局的洪水预报相当甚至更好,并且优于未在结构中融入物理科学知识的主流机器学习方法。
洪水是全球最常见、影响范围最广的自然灾害之一,对社会经济和公共安全造成长期威胁。随着气候变化导致极端降雨事件频率增加,洪水风险在许多地区呈现出明显上升趋势。准确、及时的洪水预报不仅能够为防灾减灾提供重要依据,也能为水资源调度、城市管理以及农业生产提供关键决策支持。
长期以来,洪水预报主要依赖物理过程模型(Physics-Based Models, PBM),基于水文循环理论,通过模拟降水、蒸发、土壤含水量变化、地下水补给以及河流汇流等过程来预测径流变化,例如,美国国家气象局广泛使用的 Sacramento Soil Moisture Accounting Model(SacSMA)就是一种典型的流域水文模型。物理模型具有明确的科学机理基础,在水文研究和业务预报中发挥了重要作用。然而,这类模型通常需要复杂的参数校准,而且对于具有强非线性特征的水文过程,其模拟能力往往受到一定限制。
近年来,AI 技术在水文学领域迅速发展,尤其是深度学习模型在径流预测中的应用越来越广泛。长短期记忆网络(LSTM)等时间序列神经网络能够从大量历史数据中学习复杂的降雨—径流关系,在许多研究中表现出优于传统模型的预测能力。
然而,纯粹的数据驱动模型也面临新的挑战。一方面,这类模型往往缺乏物理可解释性,难以体现真实的水文过程;另一方面,在极端气候事件或未观测流域中,其泛化能力仍存在不确定性。因此,在水文学界逐渐形成了一种新的研究思路,即将领域知识融入机器学习模型,从而构建既具有高预测能力又符合物理规律的智能模型——这一方向被称为「知识引导机器学习(Knowledge-Guided Machine Learning, KGML)」。
在这一背景下,来自明尼苏达大学双城分校的研究团队开发了一种新的知识引导型机器学习模型。该模型的算法结构直接受到水文学科学知识的启发,被称为因子化层级神经网络(FHNN)。研究表明,在预报发布后 2–7 天的时间尺度上,该模型的性能与美国国家气象局的洪水预报相当甚至更好,并且优于未在结构中融入物理科学知识的主流机器学习方法。
相关研究成果以「Knowledge-Guided Machine Learning for Operational Flood Forecasting」为题,已发表于 Water Resources Research。
研究亮点:
* 研究提出的方法通过逆向模型整合观测信息,构建具有层级关系的多尺度流域状态表示
* 在预报生成 12–18 小时之后,FHNN 模型整体上优于使用物理机理模型的专家人工预报员
* 研究提出的方法优于一种当前最先进的替代模型(自回归 LSTM),尤其是在干旱流域中表现更好,而这些地区往往是其他方法较难预测的区域
论文地址:
https://agupubs.onlinelibrary.wiley.com/doi/10.1029/2024WR039064
关注公众号,后台回复「FHNN」获取完整 PDF
数据集:兼顾基准数据集和业务数据集
为了验证模型的预测能力,研究人员使用了两类数据集:
大样本 CAMELS-US 基准数据集
在模型训练与基础评估阶段,研究使用了著名的 CAMELS-US 数据集。CAMELS(Catchment Attributes and Meteorology for Large-Sample Studies)是近年来水文学研究中最具影响力的数据集之一,其核心特点是包含大量流域的长期水文气象观测数据。CAMELS-US 数据集覆盖美国大陆范围内数百个流域,包含降水、气温、蒸散量以及河流径流等日尺度数据,同时还提供丰富的流域属性信息,例如地形、气候类型、土壤条件以及植被覆盖情况等。这些信息为研究不同环境条件下的水文过程提供了重要基础。
在本研究中,研究人员选取了 531 个流域作为实验对象,并按照时间顺序将数据划分为训练期、验证期和测试期:
* 1985–1993 年作为训练期
* 1993–1995 年作为验证期
* 1995–2005 年作为测试期
业务洪水预报数据
除了标准数据集之外,研究还进一步引入了真实的业务洪水预报数据,以检验模型在实际预报环境中的表现。研究选择了美国国家气象局北中部河流预报中心(NCRFC)负责的多个流域作为案例。这些流域位于美国中西部地区,具有典型的大陆性气候特征,既会发生由强降雨引发的洪水,也可能出现融雪洪水,因此具有较强的代表性。相关水文数据主要来自美国地质调查局(USGS)的河流流量观测资料,而降水与温度等气象数据则来自国家气象局的预报数据库。
值得注意的是,美国国家气象局的洪水预报系统采用「人工参与预报」的模式。在这一模式下,物理模型首先生成初始预报结果,随后由经验丰富的水文预报员根据实时观测信息和专业知识对模型结果进行调整,最终形成官方预报。这种方法在许多情况下能够显著提高预报准确度。因此,在本研究中,将人工专家预报与自动化机器学习模型进行对比具有重要意义,因为这能够直接反映 AI 模型在真实业务环境中的应用潜力。
模型框架:知识引导型架构 FHNN
FHNN 是一种知识引导型架构,旨在建模多个时间尺度上复杂且具有层级关系的系统动力学过程。
这种层级相互作用的状态结构对于流域水文学建模至关重要。例如,一次暴雨事件会使近地表土壤水分储量迅速变化,这些水分会通过蒸散作用被植物利用,而蒸散过程又可能在小时、日和季节尺度上发生变化。同时,这次降雨还会随着时间推移,通过较深的土壤层为地下水储量进行补给,而地下水变化通常较为缓慢。此外,近地表土壤水分储量还会影响降雨或融雪有多少会转化为导致洪水的径流。
FHNN 方法旨在捕捉这些在水文学和径流生成过程中普遍存在的多尺度和层级结构过程,其整体架构如下图所示:
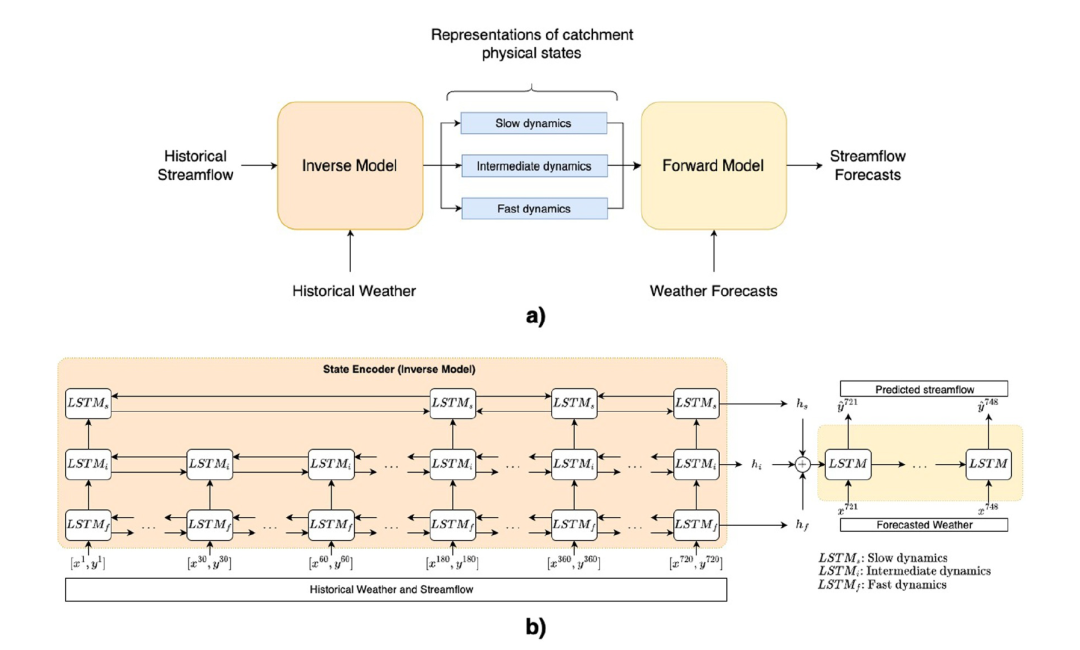
用于径流预测的多尺度 LSTM 架构
在 FHNN 架构中,知识通过两种方式被引入:
方式一:采用编码器—解码器(encoder-decoder)架构
该方式通过状态编码器(逆向模型)和响应解码器(正向模型)显式建模正向与逆向过程。编码器部分被视为「逆模型」,其主要功能是利用历史气象和径流数据推断当前流域的内部状态。例如,通过分析过去的降水、温度以及径流变化,模型可以估计当前土壤含水量、地下水储量等关键变量。虽然这些变量在现实中难以直接观测,但通过机器学习方法可以对其进行有效估计。在获得流域状态之后,模型进入解码阶段。
解码器被视为「正向模型」,其任务是在已知流域状态的基础上,根据未来天气预报信息预测未来的径流变化。
FHNN 模型通过端到端训练,以最小化预测响应与真实响应数据之间的差异。此外,每当获得一次径流观测值(响应)时,该架构都会在实时更新编码器状态,从而实现动态数据整合。
方式二:通过层级因子化设计将知识引入 FHNN 架构
在这种设计中,FHNN 的编码器被构建为能够捕捉多尺度过程及其相互作用。层级状态编码器使用多个双向 LSTM,输入历史径流观测和气象数据,为不同时间分辨率/尺度(例如慢、中、快)生成嵌入表示(embedding)。
这些嵌入提供了对历史驱动数据、系统响应以及它们多尺度相互作用(季节尺度、次季节尺度以及日/次日尺度)中所包含信息的压缩表示。这些嵌入作为潜在系统状态(例如土壤水分、空间连通性、积雪储量)的压缩表示(compressed representation),被拼接后用于初始化解码器的隐藏状态和单元状态。随后,解码器将未来天气驱动因子作为输入,生成径流预测。编码器与解码器通过一个目标函数进行联合训练,该目标函数最小化预测径流与观测径流在目标预测时间窗口内的均方根误差(RMSE)。
双向 LSTM 会同时从两个方向读取序列,这种方法使编码器能够利用观测数据中的所有可用关系,从而获得对流域内部状态更全面的认识。这种方法在水文学上也具有直观意义。例如,研究人员可以通过观察降雨及其滞后径流响应来获取土壤水分信息;同样也可以通过先观察径流响应,再分析产生该事件的降雨输入来推断土壤水分状况。双向 LSTM 编码器使模型能够通过这两种「视角」分析历史数据,并得到用于初始化解码器隐藏状态和单元状态的最终「最佳估计」。
FHNN 整体优于使用物理机理模型的专家人工预报员
研究人员通过多个实验展示 FHNN 在水文预报中的预测能力——第一组实验在大样本 CAMELS 数据集上,将 FHNN 与一种具有相同输入变量和数据整合能力的领先深度学习方法 LSTM-AR 进行比较;第二组实验则关注 FHNN 在业务预报环境中的表现,评估对象为美国中西部 NWS 官方预报站点。
与 LSTM 模型对比
在 CAMELS-US 数据集上,FHNN 与传统自回归 LSTM 模型(LSTM-AR)进行了对比。在 7 天预测期内以及总体上,FHNN 的预测能力均优于 LSTM-AR。即使在两种模型都只针对 1 天预报进行训练的情况下,FHNN 仍然表现出更好的性能,总体性能见下表:
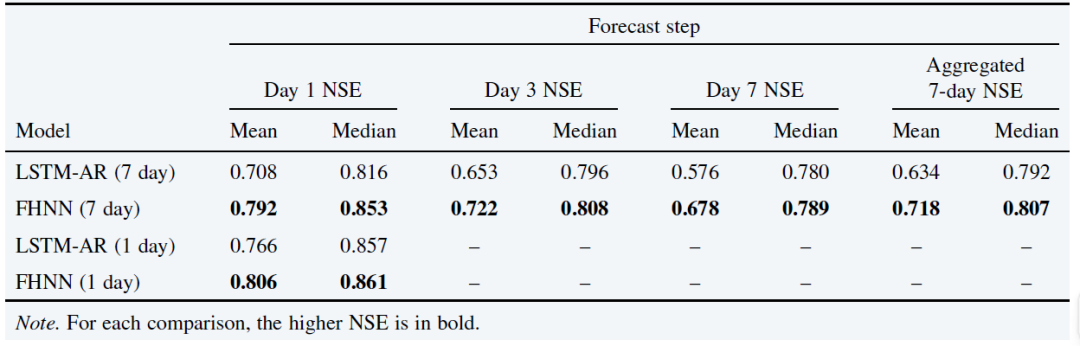
全局 FHNN 与 LSTM-AR 在大样本 CAMELS-US 数据集上的性能比较
通过分析各流域性能差异与流域特征之间的关系图,研究人员还发现 FHNN 在降水量较低的流域、径流系数较低的流域、干旱程度较高的流域表现优于 LSTM-AR,如下图:
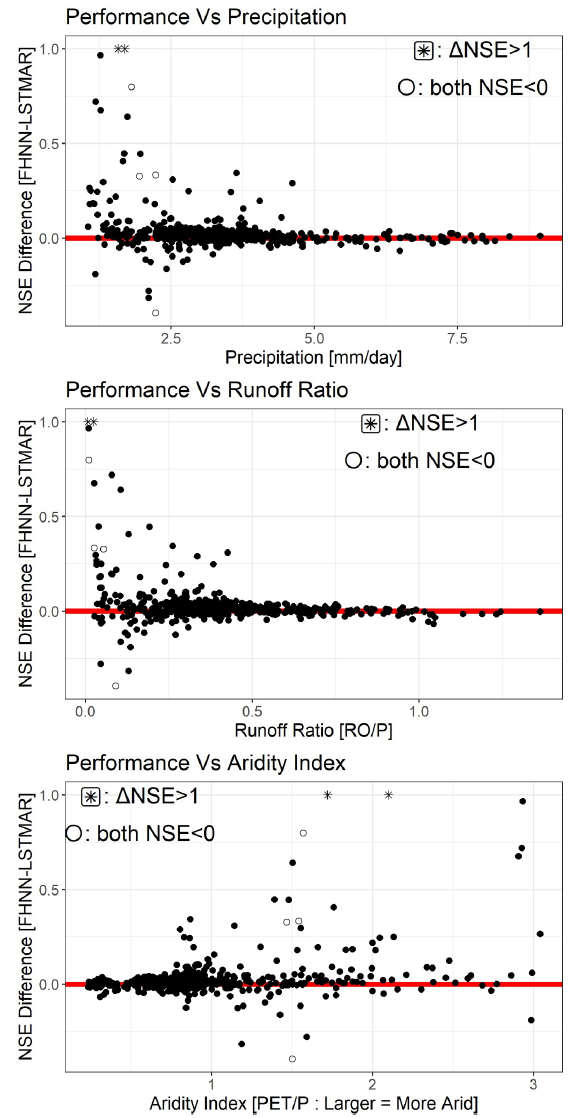
CAMELS-US 各流域 FHNN 与 LSTM-AR 的 NSE 差值
相对于降水量、径流系数和干旱指数的关系图
在基流指数、潜在蒸散量(PET)和流域坡度方面,没有观察到明显趋势。这一结果表明,在干燥流域以及总径流与总降水比例较低的流域中,FHNN 相对于 LSTM-AR 的性能优势最大。
研究人员还在 NWS 的 KALI4 流域上比较了 FHNN 与 LSTM-AR,并进一步与 NWS 专家人工预报员的预测能力进行比较,如下图:
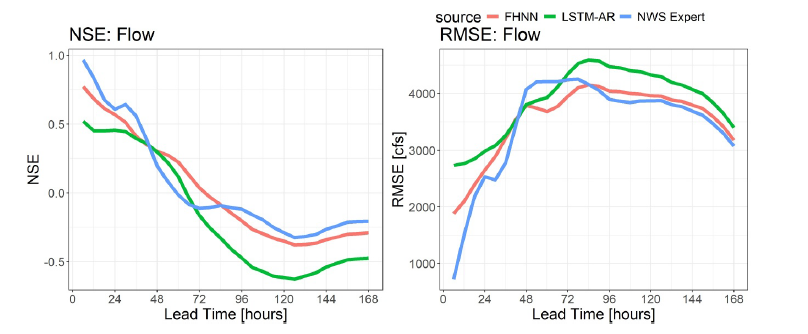
在 KALI4 流域(12 次洪水事件)中,对 FHNN、NWS 专家预报员和 LSTM-AR 的比较
结果表明:在预报发布后的第一天内,使用 SacSMA 模型的 NWS 专家预报员的预测能力高于 FHNN 和 LSTM-AR;但在同一时间段内,FHNN 的性能仍优于 LSTM-AR,并且在洪水事件中表现出更好的数据整合能力。在 2–4 天及更长的预报提前期内,FHNN 相对于 NWS 预报和 LSTM-AR表现出最高的相对预测能力。
与业务预报对比
研究还分析了46 次真实洪水事件,结果显示:FHNN 在 65% 的事件中优于官方预报,如下表:

各流域每次洪水事件中,美国国家气象局专家人工预报员与 FHNN 模型的业务预报表现对比
从预报提前期来看:对于水位预报(即 NWS 实际发布的预报),FHNN 在预报发布后 12 小时(2 个时间步)开始优于 NWS 专家预报员;对于流量预报,FHNN 在 18 小时(3 个时间步)之后优于 NWS 专家预报员,在第 2 天至第 3–4 天之间(取决于评价指标),FHNN 的预测能力明显高于人工预报员;第 4 天之后,FHNN 与人工预报员之间的预测能力不再存在显著差异。
洪峰预测能力
一个关键的性能指标是预测洪峰水位(stream stage crest)时的误差,即某次降雨或融雪过程在径流过程线(hydrograph)中所达到的最高峰值。于是,研究人员评估了 FHNN 与 NWS 人工预报员在洪峰预测方面的性能(两者都使用存在不确定性的未来降水预报)。同时,其还将 FHNN 与人工预报员的性能与预报员使用的基础 SacSMA 模型进行了比较。结果表明,FHNN 在洪峰预测方面明显优于未经人工修正的物理模型,但仍略低于专家预报水平。
在几乎所有提前期(除约 60 小时以上的提前期外),人工预报员在洪峰估计方面都优于 FHNN,如下图:
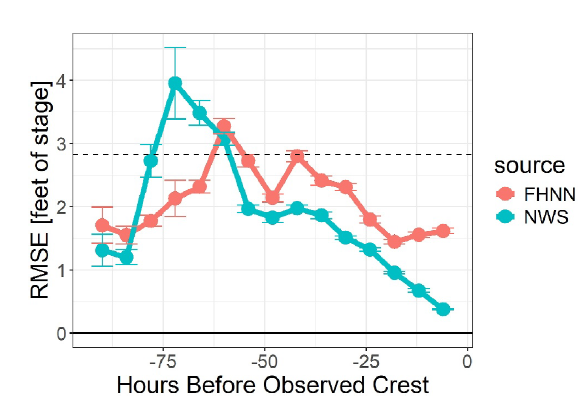
FHNN 方法在不同洪峰提前期下的洪峰预测误差
然而,即使使用不完全已知的未来天气条件,FHNN 对洪峰的估计仍然优于仅使用观测降水驱动、但没有预报员干预的 SacSMA 模型。
在洪峰发生前 48 小时至 18 小时之间,FHNN 与人工预报员通过数据整合带来的预测改进速率相似。在此期间,每 6 小时预报更新一次,洪峰预测误差(RMSE)大约减少 0.2 英尺;然而,在洪峰发生前 2.5 天以内的所有预报中,人工预报员仍保持预测优势;在洪峰前 12–18 小时(2–3 个时间步),FHNN 的洪峰预测 RMSE 基本不再下降,甚至略有上升。
这表明在接近洪峰时,FHNN 对系统变化的响应能力不如人工预报员敏感。这一结果也与整体预报能力的比较一致,即 NWS 在预报发布后的前 12–18 小时内具有更高预测能力。FHNN 在接近洪峰时响应能力不足,可能与极端值预测问题有关。对于任何 LSTM 模型而言,由于训练数据中极端洪峰事件较少,预测最高洪峰值往往比较困难。
人工智能在水文研究中的应用进展
近年来,人工智能技术正在深刻改变水文研究与业务预报的技术路径。从早期基于统计回归的方法,到如今以深度学习为代表的数据驱动模型,水文预测正逐步迈向更加智能化和自动化的发展阶段。
在具体应用层面,以长短期记忆网络(LSTM)为代表的时序深度学习模型已成为当前水文预测的主流工具之一。大量研究表明,这类模型在多流域径流模拟中普遍优于传统物理模型,尤其是在数据丰富的地区,其预测能力更加突出。
近年来,Transformer 架构也逐步被引入水文领域,其在长序列建模方面的优势,为捕捉长期水文记忆提供了新的可能。与此同时,学术界和工程界也逐渐认识到,单纯依赖数据驱动模型存在一定局限。例如,模型缺乏物理约束可能导致结果在极端情况下不符合水文规律,且模型可解释性较弱。因此,「物理信息驱动」或「知识引导」的机器学习方法成为新的研究热点。
在最新研究进展方面,多源数据融合正成为提升水文模型能力的重要方向。遥感数据(如卫星降水、土壤湿度、雪水当量)与地面观测数据的结合,使模型能够获得更加全面的流域信息。同时,图神经网络(GNN)也开始被用于流域之间的空间关系建模,有助于提升区域尺度洪水预测能力。
近期,Google Research 开源了洪水数据集 Groundsource,用于从非结构化数据中提取经过验证的地面实况信息,从而以前所未有的精度绘制出历史灾害的足迹。研究人员对来自 150 多个国家的超 500 万篇新闻报道进行自动化处理,最终整理出超过 260 万条历史洪水事件记录,为全球洪水研究提供了前所未有的数据规模与覆盖度。
目前,「Groundsource 全球洪水事件数据集」已上线至 HyperAI 官网(hyper.ai)的数据集板块,支持在线使用:
https://go.hyper.ai/KO3dB
在更早之前,来自 Google Research 的 Grey Nearing 及其团队还开发了一个基于机器学习的河流预报模型 (river forecast model),该模型能够提前 5 天实现对洪水的可靠预测,在对 5 年一遇的洪水事件进行预测时,性能优于或相当于目前预测 1 年一遇的洪水事件,系统可覆盖 80 多个国家。
论文标题:Global prediction of extreme floods in ungauged watersheds
论文地址:https://www.nature.com/articles/s41586-024-07145-1
从业务应用角度看,人工智能并不会完全取代传统水文预报员,而更可能以「人机协同」的方式发挥作用。AI 模型可以提供快速、稳定的预测结果,而专家则可基于经验对关键情景进行修正和判断。这种协同模式不仅能够提升预报效率,也有助于增强系统在极端事件中的可靠性。随着数据规模的持续扩大和算法能力的不断提升,未来的洪水预报系统将更加智能、高效且具备更强的适应性,为防灾减灾和水资源管理提供更加坚实的技术支撑。
参考文献:
1.https://agupubs.onlinelibrary.wiley.com/doi/10.1029/2024WR039064
2.https://phys.org/news/2026-03-ai-higher-accuracy-current-methods.html
3.https://mp.weixin.qq.com/s/ZWU-v_4k7FIm0MoDh6Rxuw
4.https://www.nature.com/articles/s41586-024-07145-1
一键获取 2023—2024 年 AI4S 领域高质量论文及深度解读文章 ⬇️

往期推荐


戳“阅读原文”,免费获取海量数据集资源!
 6888


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


