
PyTorch 官方博客:PyTorch Profiler v1.9 详解

PyTorch 2.1 模型复杂度分析:fvcore vs torch.profiler 实测 2 倍差异解析 本文深入解析了PyTorch 2.1中fvcore与torch.profiler在模型复杂度分析上的2倍差异,揭示了MACs与FLOPs的数学关系及硬件视角的技术内幕。通过实测数据和代码示例,提供了学术论文报告的最佳实践和工程优化方案,帮助开发者准确评估模型计算复杂度。 阅读详情
AI摘要

PyTorchProfiler1.9更新带来了分布式训练视图、内存视图、GPU应用可视化、云存储支持和源代码跳转功能。这些新特性帮助用户在分布式训练中诊断问题,优化内存使用,提高GPU利用率,并从云存储读取数据,还支持直接从堆栈跟踪跳转到源代码进行代码优化。通过这些工具,开发者能够更有效地调试和提升深度学习模型的性能。

在这里插入图片描述
Profiler v1.9 的改进主要针对在运行时和/或内存上能耗最严重的执行步骤,同事将 GPU 和 CPU 之间的工作负载分配进行可视化。

Profiler v1.9 新增五个主要功能包括:

1、分布式训练视图: 这有助于你掌握分布式训练任务中,消耗的时间和内存。假设你有一个训练模型,当你要把负载分成 Worker 节点并行运行时,可能会像黑盒一样,出现各种各样的问题。模型整体的目标是提高训练速度。这个分布式训练视图有助于你诊断和调试单个节点内的问题。

2、内存视图: 借助该视图,你可以更好地了解内存使用情况。这个工具能显示程序在不同运行阶段的活动内存分配情况,从而帮助你避免 Out of Memory 错误的发生。

3、GPU 应用可视化: 该工具可以确保 GPU 得到充分利用。

4、云存储支持: Tensorboard 插件现在可以从Azure Blob Storage、Amazon S3和Google Cloud Platform 读取解析数据。

5、跳转源代码: 该功能支持堆栈跟踪信息可视化,并可以直接跳转至源代码。这有助于你根据分析结果快速优化和迭代代码。

PyTorch Profiler Colab 传送门

汉化版 Colab 传送门

Colab 内容一览:

  • 准备数据和模型

  • 使用 Profiler 记录执行事件

  • 运行 Profiler

  • 使用 TensorBoard 查看结果并分析模型性能

  • 借助 Profiler 提高性能

  • 使用其他高级功能分析性能

开始使用 PyTorch Profiling 工具

首先:

$ pip install torch-tb-profiler

import torch.profiler as profiler
With profiler.profile(XXXX)

备注: 关于 CUDA 和 CPU 的分析,详见 Here

with torch.profiler.profile( 
activities=[ 
torch.profiler.ProfilerActivity.CPU, 
torch.profiler.ProfilerActivity.CUDA],
  • profiler.record_function("$NAME"):允许为函数区块添加装饰器 (decorator,指与名称相关的标签)。

  • profiler.profile 下的 Profile_memory=True 参数,可以对 CPU 和 GPU 的内存占用情况进行分析。

对 PyTorch 模型性能进行可视化

分布式训练

深度学习的最新进展证明了大型数据集和大型模型的价值,这也意味着模型训练需要更多的计算资源。

分布式数据并行 (DDP) 和英伟达多卡通信框架 (NCCL) 是 PyTorch 中广泛采用的范式,用于加速深度学习训练。

在这个版本的 PyTorch Profiler 中,现已支持 NCCL 后端的 DDP。
在这里插入图片描述

计算/通信概览

在分布式训练视图中的「计算/通信概览」中,用户可以观察所有 Worker 之间「load balancer」节点的计算与通信比,这是按照颗粒度来衡量的。

load balancer 相关链接: Here

情景 1:

如果一个 Worker 的计算和重叠时间,比其他 Worker 长,这可能表示工作负载均衡中存在问题,或有一个节点是 straggler。计算是 GPU 内核时间之和,减去重叠时间。重叠时间是指计算过程中,通过交错通信节省的时间。

重叠时间越长,表示计算和通信之间的并行性更好。理想状况下,计算和通信完全相互重叠。通信是总的通信时间减去重叠时间。

以下示例展示了这种情况在 Tensorboard 上的表现。
在这里插入图片描述
straggler 示例

情景 2:

如果批尺寸较小(即所有 Worker 上的计算都比较少),或需要传输的数据较大,那么计算通信比也可能较小,在 Profiler 中可以看到 GPU 利用率低,等待时间长。

用户可以根据这种计算/通信视图 review 代码,通过采用梯度累积来减少通信,或通过增加批尺寸来减少通信比例。DDP 通信时间取决于模型大小。批尺寸与模型大小无关。因此,增加批尺寸可以使计算时间更长、计算通信例更大。

同步/通信概览

在同步/通信视图中,用户可以观察通信效率。这是用步骤时间减去计算和通信时间得出来的。同步时间是等待并与其他 Worker 同步的总通信时间的一部分。同步/通信视图包括初始化、数据加载器、CPU计算等。

从该视图中可以得知:总通信量中真正用于交换数据的比例是多少,等待其他 Worker 提供数据的空置时间是多少。

在这里插入图片描述

例如,如果存在低效的工作负载均衡或 straggler 问题,就可以在同步/通信视图中发现。这个视图将展示一些 Worker 的等待时间比其他 Worker 长。

图片

从上表可以得知每个节点中所有通信算子的详细统计数据。通过该表可以了解调用了哪些算子类型,每个算子被调用了多少次,每个算子所传输的数据大小是多少,等等。

内存视图

利用该工具,可以了解模型中算子的硬件资源消耗。了解算子层面的时间和内存消耗,有助于解决性能瓶颈问题,进而加快模型运行速度。鉴于 GPU 内存大小有限,优化内存使用效率有助于:

  • 允许运行更大规模的模型,在终端级别的任务上表现更好。

  • 允许更大的批尺寸,提高训练速度。

Profiler 记录了 Profiler 间隔期间的所有内存分配。选择「设备」就可以看到每个算子在 GPU 侧或主机侧的内存使用详情。

注意:必须启用 profile_memory=True 来生成以下内存数据。

相关链接: Here

With torch.profiler.profile(
Profiler_memory=True # this will take 1 – 2 minutes to complete. 
)

重要定义:

  • 「Size Increase」显示所有分配字节的总和,减去所有内存释放字节。

  • 「Allocation Size」显示不包括内存释放的所有分配字节的总和。

  • 「Self」意味着分配的内存不是来自任何 child 算子,而是由算子自行分配的。

图片

时间轴上的 GPU 指标

利用该功能,你可以在一个或多个 GPU 利用不充分时,轻松调试性能问题。理想情况下,你的程序应该有很高的 GPU 利用率(尽可能达到 100% 的 GPU 利用率),CPU 到 GPU 的通信成本最低,且没有功耗。

概述: 概述页面强调了三个重要的 GPU 使用指标 (即 GPU Utilization、Est. SM Efficiency 以及 Est. Achieved Occupancy) 在不同层面的结果。

从本质上讲,每个 GPU 都有很多 SM,每个 SM 都有很多 Warp,可以同时执行很多线程。Warp 执行 的线程多,是因为其数量取决于 GPU。从更高角度来看,时间轴上的 GPU 指标可以帮助开发者对整个堆栈有全局观,这非常重要。

如果 GPU 利用率很低,则表明模型有潜在问题。常见原因如下:

  • 内核中的并行性不足,即批尺寸过小

  • 在一个循环中调用小内核,即启动 overhead 没被摊销

  • CPU 或 I/O 瓶颈导致工作内容不足,GPU 利用率低

在概览页面中,性能建议部分是一些可以提高 GPU 利用率的可行性建议。在这个例子中,GPU 利用率很低,所以性能建议是增加批尺寸。根据性能建议,将批尺寸从 4 增加到 32,使 GPU 利用率增加了 60.68%。

GPU 利用率: 在 Profiler 中,当 GPU 引擎执行一个工作负载时会出现一个步骤间隔时间 (step interval time)。利用率百分比越高越好。仅通过 GPU 利用率来判断性能瓶颈,结果并不准确。你无法借此得知到底有多少流处理器 (Streaming Multiprocessor) 在运行。

注意,虽然这个指标对检测空闲期很有帮助,但高数值并不代表 GPU 的利用率很高。如,一个单线程连续运行的内核,其 GPU 利用率将达到 100%。

预估流处理器效率 (Est. SM Efficiency) 是一个更细化的指标, 它表示在跟踪全过程中,正在使用的 SM 的百分比,代表 SM 上至少有一个活动 wrap 的 time 百分比,以及那些空闲 warp。

NVIDIA 文档: Here

Est. SM Efficiency 也有局限性。如每个区块只有一个线程的内核,无法完全利用所有 SM。只依据 SM Efficiency 无法得知每个 SM 的利用率,只能知道每个 SM 正在进行的操作,这包括等待内存加载结果时的停顿。

为了保持 SM 的高利用率,必须保证足够数量的 ready wrap,只要发生停滞就可以运行。

对于性能诊断问题而言,预估实现的占用率(Est. Achieved Occupancy)比 Est. SM Efficiency 和 GPU 利用率更准确。预估实现的占用率表明每个 SM 有多少 warp 可以同时活动。拥有数量足够多的活动 warp 通常是实现良好吞吐量的关键。与 GPU 利用率和 SM Efficiency 不同,让这个值尽可能高并不是终极目的。

从经验角度出发,通过将这个指标提高到 15% 或以上,可以获得良好的吞吐量收益。但在某些时候,也会遇到收益递减的情况。例如,如果该值已经达到 30%,接下来的收益就变得不确定了。这个指标展示了内核执行期间,所有 warp scheduler 的平均值

NVIDIA 文档: Here

Est. Achieve Occupancy 的值越大越好。

图片

详细细节:Resnet50_batchsize4

图片

详细细节:Resnet50_batchsize32

内核视图:内核有「Blocks per SM」和「Est. Achieved Occupancy」。

Est. Achieved Occupancy 是比较模型运行状况的有利工具。

图片

每个 SM 的平均取块数 (Mean Blocks per SM):

每 SM 的区块数量=该内核的区块数/该 GPU 的 SM 数。如果这个数字小于 1,表明 GPU 多处理器没有被完全利用。"Mean Blocks per SM "是这个内核 name 所有运行的加权平均值,使用每次运行的时长作为权重。

平均 Est. Achieved 占用率 (Mean Est. Achieved Occupancy:

Est. Achieved Occupancy 的定义与上述概述相同。Mean Est. Achieved Occupancy 是这个内核 name 所有运行的加权平均值,使用每次运行的持续时长作为权重。

跟踪视图:

跟踪视图显示的是一个时间线,表示模型中算子的持续时间,以及是哪个系统执行的操作。这个视图可以帮助你识别高消耗和长执行,是不是由于输入或模型训练引起的。目前,该跟踪视图可显示一个时间线内的 GPU 利用率和 Est. SM Efficiency。

图片

上述例子中,「ProfilerStep5」在线程 28022 期间的 GPU 利用率比「Optimizer.step」期间要高。可以通过放大来查看相关原因。

图片

从上图可知,前者的内核比后者长。后者的内核执行时间太短,导致 GPU 利用率降低。

Est. SM Efficiency: 每个内核都有一个计算出的EST. SM Efficiency,介于 0-100% 之间。例如,下面的内核只有 64 个区块,而这个 GPU 的 SM 为 80,则它的「Est. SM Efficiency」为 64/80,即 0.8。

图片

云存储支持

运行 pip install tensorboard 后,为了通过云供应商读取数据,你可以运行:

torch-tb-profiler[blob] 
torch-tb-profiler[gs] 
torch-tb-profiler[s3]

借助 pip install torch-tb-profiler[blob], pip install torch-tb-profiler[gs],或 pip install torch-tb-profiler[S3] 可以通过云服务商读取数据。

更多信息,请参考: Here

跳转至源代码

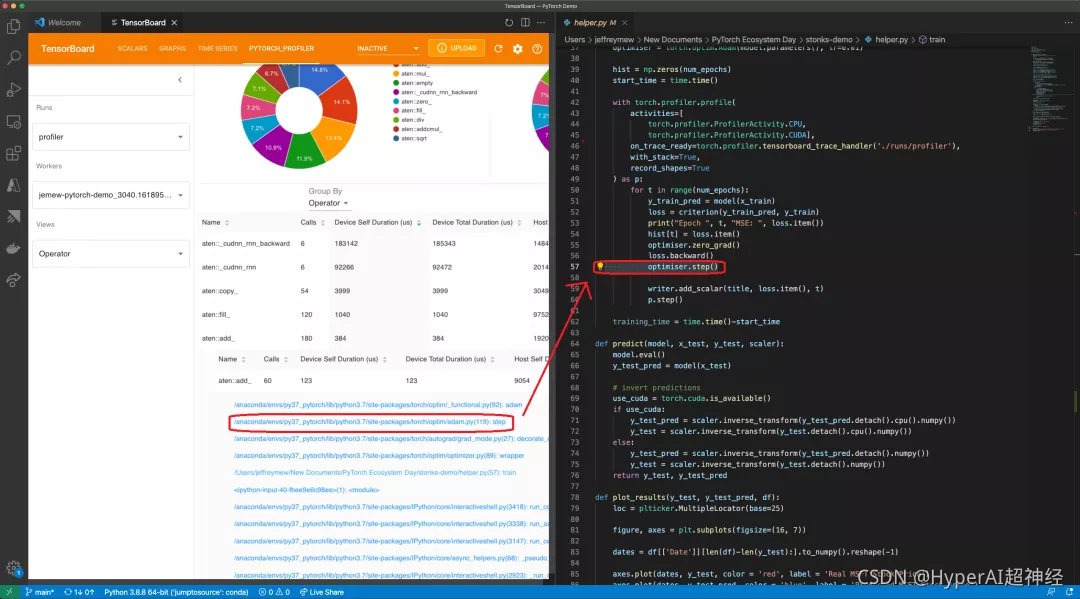
将 TensorBoard 和 PyTorch Profiler 直接集成到 Visual Studio Code (VS Code) 中的一大好处,就是能从 Profiler 的 stack trace 直接跳转至源代码(文件和行)。VS Code Python 扩展现已支持 TensorBoard 集成。

只有当 Tensorboard 在 VS Code 中运行时,跳转到源代码才可用。如果profiling with_stack=True,stack trace 就会出现在插件 UI上。点击 PyTorch Profiler 中的 stack trace,VS Code 就会打开相应的文件,并直接跳转到对应代码,以便进行调试。这样就可以根据分析结果和建议,迅速对代码进行优化和修改。
图片

用 Visual Studio Code Plug In UI 跳转至源代码

关于如何优化批尺寸性能,请查看详细教程: Here

PyTorch Profiler 也可以与 PyTorch Lightning 集成,只需用 trainer.profiler=pytorch 来启动 lightning 训练任务即可生成 trace。

详细示例: Here

原文地址: Here

PyTorch Profiler:详细解析与使用指南 本文介绍了PyTorch Profiler的使用方法,包括代码分析、内存分析和时间分析。PyTorch Profiler是PyTorch官方提供的一个工具,旨在帮助开发者深入分析他们的PyTorch模型的性能瓶颈和效率问题。代码分析是PyTorch Profiler的一个重要功能,它可以帮助我们了解模型中各个部分的执行时间和资源占用情况。除了代码分析,PyTorch Profiler还提供了内存分析功能,可以帮助我们了解模型在训练过程中的内存使用情况。来获取分析结果的汇总表格,并按照CPU时间进行排序。 阅读详情

相关推荐

pytorch性能分析工具Profiler

PyTorch Profiler 是一个开源工具,可以对大规模深度学习模型进行准确高效的性能分析。分析model的GPU、CPU的使用率各种算子op的时间消耗trace网络在pipeline的CPU和GPU的使用情况Profiler利用可视化模型的性能,帮助发现模型的瓶颈,比如CPU占用达到80%,说明影响网络的性能主要是CPU,而不是GPU在模型的推理,各种kernel的运算的消耗。

@bangbang的博客 4663

【小白学习tensorflow教程】二、TensorBoard可视化模型训练

@Author:Runsen 本想在Torch和Keras更新TensorBoard,还是决定扔在了tensorflow。 TensorBoard是用于可视化图形和其他工具以理解、调试和优化模型的界面。它是一种为机器学习工作流提供测量和可视化的工具。它有助于跟踪损失和准确性、模型图可视化、低维空间中的项目嵌入等指标。 在本篇博客中,将介绍 TensorBoard 的基础知识,并了解如何可视化训练模型中的一些基本信息。 下面,我们使用MNIST 数据的图像分类模型 ,将首先导入所需的库并加载数据集。模型的建立

微信号:RunsenLiu 2116

解锁PyTorch Profiler:性能优化全攻略

再次使用 Profiler 评估优化效果在完成一系列优化措施后,再次使用 PyTorch Profiler 对模型进行性能评估是至关重要的。这一步骤就如同对优化后的机器进行全面检测,能够准确验证我们所采取的优化策略是否有效。通过再次评估,我们可以清晰地看到模型在各个方面的性能变化,从而确定优化的方向是否正确,以及是否还存在其他需要改进的地方。以之前分析的 ResNet50 模型为例,在实施了数据加载优化、内存管理优化和计算优化等策略后,重新使用 Profiler 进行评估。

远程部署调试 运行安装 项目调试 二次开发 项目技术新 持续迭代 部分源码免费分享 2053

PyTorch Profiler v1.9的隐藏功能:你不知道的性能调优技巧

本文深入解析PyTorch Profiler v1.9的隐藏功能,揭示如何通过分布式训练视图、内存分析和GPU利用率优化提升模型性能。特别介绍了计算/通信比分析、内存视图高级技巧和GPU指标解读等实用技巧,帮助开发者高效诊断和解决性能瓶颈问题。

algae的博客 623

利用PyTorch Profiler实现大模型的性能分析和故障排查

什么是PyTorch Profiler?PyTorch作为一款应用于深度学习领域的库,其影响力日益显著。PyTorch Profiler是PyTorch生态中的一个组件,用来帮助开发者分析大规模深度学习模型的性能。该组件不仅收集GPU硬件层面的数据,还同步整合PyTorch框架内的运行信息,通过这种深层次的数据关联,自动识别模型执行过程中的瓶颈问题,并提出具体的改进建议,所有收集到的信息经过整理后,均能在TensorBoard上直观展示。

2401_88127808的博客 2664

STM32F103+AX58100 EtherCAT从站SPI移植实战:CubeMX配置避坑指南

本文详细介绍了STM32F103与AX58100 EtherCAT从站控制器的SPI接口移植实战,重点解析CubeMX配置中的关键参数与常见陷阱。内容涵盖硬件连接规范、SPI模式设置、中断优先级规划及协议栈对接技巧,帮助开发者高效实现工业自动化领域的实时通信方案。特别强调CPOL/CPHA配置与AX58100的匹配要求,避免数据错位问题。

weixin_29230865的博客 331

深入解析 PyTorch Profiler v1.9:GPU 与 CPU 负载均衡优化实战

本文深入解析了PyTorch Profiler v1.9在GPU与CPU负载均衡优化中的实战应用。通过分布式训练视图、内存视图和GPU可视化等新功能,开发者可以精准定位性能瓶颈,优化模型训练效率。文章还提供了计算/通信比分析、同步时间优化等实用技巧,帮助提升GPU利用率和内存管理。

weixin_29081101的博客 301

AEB(自动紧急制动)

AEB系统对静止物体的误判率受多种因素影响,包括传感器精度、算法复杂性以及环境条件等。通过多传感器融合、算法优化、硬件升级以及环境适应性增强等技术手段,可以有效减少误判问题。美国和欧洲的AEB法规均强调了技术性能和安全性,但具体要求有所不同。美国的NHTSA规定更注重高速和复杂场景下的紧急制动能力,而欧盟的ECE R152法规则更侧重于基础的AEB功能覆盖范围。

百态·数智思维 | 聚焦大数据、量化与未来AI 2550

PyTorch 2.9新增Profiler性能分析工具实测

PyTorch 2.9推出的增强版torch.profiler,结合CUDA容器镜像,让模型性能调优变得高效透明。通过低侵入式采样、跨设备追踪和调用栈关联,开发者能精准定位训练瓶颈,配合标准化环境实现团队间一致的分析体验,显著提升调试效率。

weixin_32324637的博客 1087

手把手教你用Cadence Virtuoso完成LNA全套仿真:基于SpectreRF手册的实战补充

本文详细指导如何使用Cadence Virtuoso和SpectreRF完成LNA的全套仿真,涵盖噪声仿真、增益压缩、THD分析及双音IP3测量等关键步骤。针对官方手册中的常见问题,提供了12个实战解决方案,包括hbnoise函数选择、双音信号源配置等,帮助工程师高效完成射频IC设计。

weixin_29102619的博客 524

PLDM入门(七):FRU Data Format

每个字段为TLV(Type-Length-Value)格式,具体类型、长度范围和值定义需参考。通过条件过滤(记录句柄、类型、字段类型等)分块获取FRU记录数据(可选功能)。整个FRU数据表由多个FRU记录数据块组成,每个数据块对应表2的结构(即包含。决定,每个字段按顺序排列(Type→Length→Value)通过分块传输方式写入FRU记录表数据(需终端支持写入操作)。(文档未提供表5内容,需结合标准文档完整版)。、字段数量、编码类型及具体字段的TLV数据)。无请求数据(空请求)。

weixin_44032634的博客 1762

PyTorch-CUDA-v2.7镜像中使用Profiler分析性能瓶颈

通过PyTorch-CUDA容器镜像快速搭建环境,结合内置Profiler工具精准识别训练中的性能瓶颈,如数据加载阻塞、内存传输延迟等。借助Trace View可视化分析CPU与GPU的执行流,优化数据管道后GPU利用率从25%提升至78%,实现吞吐量翻倍。无需改动模型即可显著提速。

weixin_35752645的博客 981

Autosar入门_OS_5

os hook函数说明

u012406840的博客 398

深度学习开发利器:PyTorch-CUDA-v2.9镜像 + Profiler,提升调试效率

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,快速搭建深度学习开发环境。该镜像集成了CUDA工具包和增强版Profiler,特别适用于模型性能分析与优化场景,如Transformer模型的训练加速与显存管理,显著提升开发效率。

weixin_42577735的博客 393

图像处理入门007:图像处理中的数学基础:线性代数与卷积

一种:把 OpenCV 当黑盒,调用,效果不对就乱调参数;另一种:理解每个像素是怎么被周围邻域"加权平均"的,理解核翻转、边界填充、stride 的含义。前者能干活,后者能解难题。一旦遇到自定义核(比如 ISP 上的锐化)、深度学习反向传播、医学图像重建,你就必须把卷积、相关、矩阵乘法这些基本功捡回来。线性代数三件套:向量点积、矩阵乘法、线性变换;2D 卷积的数学定义:核翻转、滑动窗口、边界填充。并手写一个,验证它与和的结果完全一致(误差 < 1e-9)。f∗gn∑m−∞∞f。

专注:太空算力、AI infra、异构调度、大模型成本工程 387

电子电器架构 -- 汽车零部件DV试验与PV试验的定义及关键差异

电子电器架构 -- 汽车零部件DV试验与PV试验的定义及关键差异

Soly_kun的博客 733

PyTorch Profiler分析模型性能瓶颈位置

深度学习训练慢?GPU利用率低?真正的问题往往藏在数据加载、张量搬运或算子执行中。借助PyTorch内置的Profiler工具,结合CUDA镜像环境,可以精准追踪CPU与GPU的耗时热点,生成可视化报告,快速识别并优化模型性能瓶颈,让调优从玄学变成可复现的工程实践。

weixin_32836713的博客 1012

【Unity】【Pico】【VR开发】为何PICO打包后真机运行闪退

由于并没有开版权验证,而且闪退后也并没有弹框说版权问题,所以还是怀疑环境有什么地方不对。设置步骤,项目配置都没问题,Build也成功,Unity版本是符合要求的2022LTS版本,但是一在真机上运行就闪退。

每日出拳老爷子的博客 3175

保姆级指南:用PyTorch 2.9镜像和Profiler,快速优化你的模型训练

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,快速优化深度学习模型训练性能。该镜像预装了增强版torch.profiler工具,可精准分析GPU/CPU执行流程和显存使用情况,适用于图像分类、自然语言处理等AI模型的训练效率提升。

weixin_42186387的博客 20

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

PyTorch 2.9性能调优指南:用内置Profiler让模型训练速度提升18%

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,利用其内置Profiler工具实现深度学习模型训练性能调优。该工具通过精确分析GPU/CPU使用率、内存瓶颈等关键指标,帮助用户识别并优化训练流程,典型应用场景包括BERT等大模型训练速度提升(实测可达18%),显著提高AI开发效率。

weixin_42437253的博客 28

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

从零到英雄:如何用PyTorch Profiler优化你的深度学习模型性能

本文详细介绍了如何使用PyTorch Profiler v1.9优化深度学习模型性能,包括GPU利用率提升、内存瓶颈分析和分布式训练调优。通过实战案例和代码示例,帮助开发者快速掌握性能诊断与优化技巧,显著提升模型训练效率。

carrot的博客 540

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

PyTorch 2.9实战:用Profiler分析BERT微调,找出LayerNorm性能瓶颈

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,用于BERT模型微调的性能分析。通过内置Profiler工具,开发者可快速识别LayerNorm等关键组件的性能瓶颈,优化训练效率。该方案特别适用于自然语言处理任务中的模型调优场景。

weixin_31185473的博客 363

深挖Qwen3.5-9B-MLX-4bit架构:线性注意力混合设计与MLX推理提速5技巧

Qwen3.5-9B-MLX-4bit 是一款约 90 亿参数的多模态大模型,经 MLX 框架 4-bit 量化,专为 Apple Silicon(M 系列芯片)优化,支持文本、图片与视频输入。本文带你读懂它的"线性注意力 + 全注意力"混合架构设计,并分享 5 个让 MLX 推理提速的实用技巧。 ## 一、模型速览:一只"跑在 Mac 上"的 9B 多模态模型 ⚡ 一句话概括:**体积小(约

gitblog_00022的博客 210

pytorch profiler使用及apex安装遇到的cuda问题

pytorch profiler使用及apex安装遇到的cuda问题

qq_35985044的博客 929

PyTorch-CUDA-v2.9镜像中分布式训练启动命令详解

深入剖析PyTorch-CUDA-v2.9镜像中torchrun命令的工作机制,揭示分布式训练为何不能直接用python运行脚本。从环境变量设置到NCCL通信,从DDP初始化顺序到数据加载采样,系统梳理多GPU训练的关键细节与常见陷阱,帮助开发者真正掌握高效稳定的分布式训练方法。

weixin_42298778的博客 966

PyTorch 2.9性能分析实战:5分钟用Profiler找出模型训练慢的元凶

本文介绍了如何在星图GPU平台上自动化部署PyTorch 2.9镜像,快速搭建深度学习性能分析环境。通过内置的torch.profiler工具,用户可在5分钟内定位模型训练速度瓶颈,优化GPU利用率,特别适用于大规模神经网络训练的效率调优场景。

weixin_27645199的博客 45
上一篇: 死侍在新片中,扮演了一个 AI 驱动的 NPC
下一篇: 农民用上全自动除草机,每小时除草 10万株
HyperAI超神经
博客等级 码龄7年 8872粉丝 1753原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值