【LLM进阶-Agent】8. Reflexion Agent 介绍

Agent之推理模式:Reflection、Reflexion、LATs 反思的定义:LangChain博客的介绍说是一种用来提供Agent质量和成功率的。归根结底,核心还是prompt的设计。用额外的计算来获得更好的输出质量,这点有点像CoT和ToT的设计。但与之不同的是,CoT和ToT是和LLM单轮的交互,而Reflection一般是和LLM多轮的交互(封装在Agent框架当中),尽管看起来和人类的交互是单轮的。 阅读详情

深度解析 LLM Agent 演进:从 ReAct 到 Reflexion 的“自我反思”之路
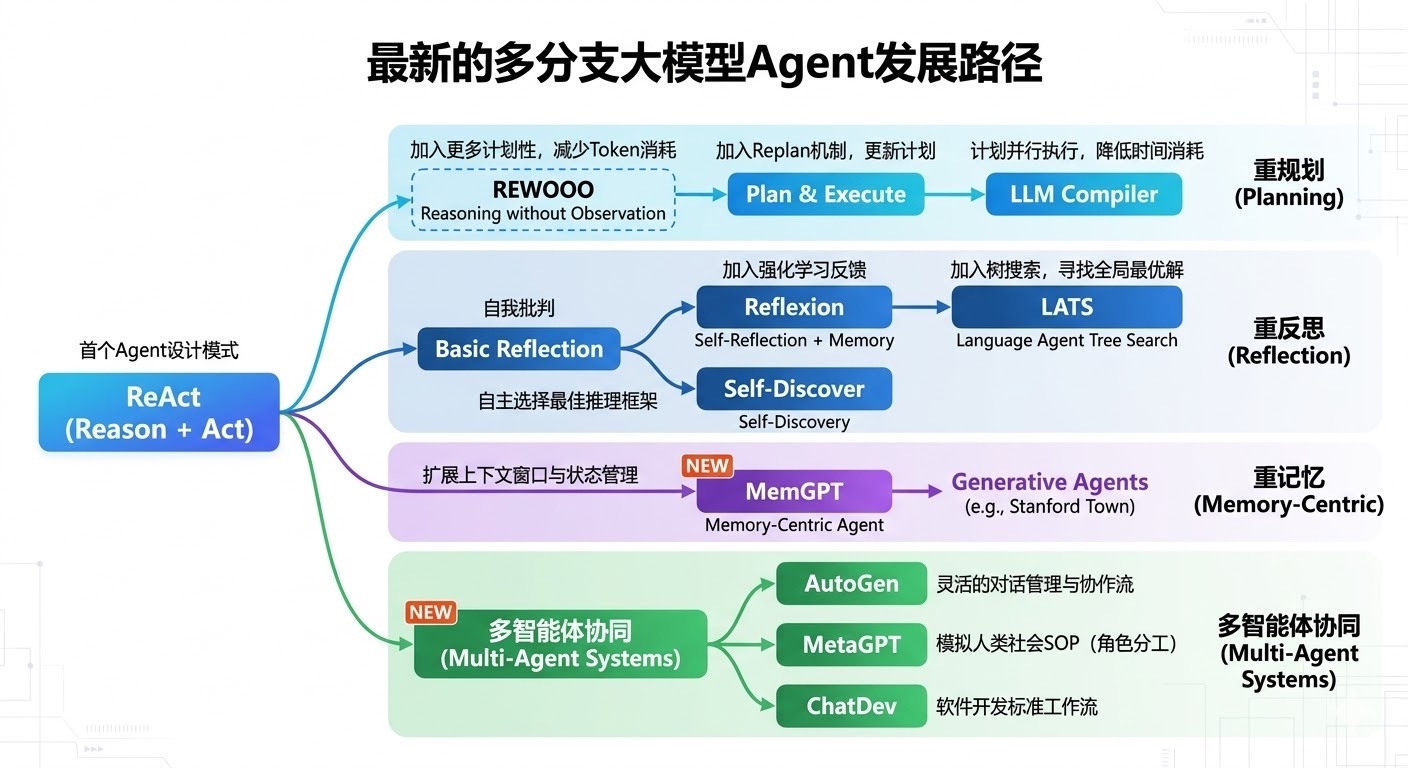
在这里插入图片描述
在复杂任务场景下,业界早期广泛采用的是 ReAct (Reason + Act) 范式。然而,在实际落地中我们常常发现:大模型像是一个固执且健忘的员工。当它陷入幻觉或采取错误行动时,往往会在一个错误逻辑里无限循环(Infinite Loop),即使你在系统提示词里让它“仔细想想”,它也很难自行跳出泥潭。

为了打破这种死循环,Agent 架构图中衍生出了一个极其重要的分支——重反思(Reflection)。而在这个分支中,Reflexion 无疑是一个里程碑式的架构。但是无论是 Basic Reflection 还是 Reflexion 都还是所有步骤执行完了才会触发反思,无法做到中间步骤失败后立即触发反思。下一篇文章介绍的 LATS 就是针对该问题的优化。

一、 澄清误区:Reflexion 是错别字吗?只是加了外部工具吗?

Reflexion 并不是错别字! 它出自 2023 年的一篇论文《Reflexion: Language Agents with Verbal Reinforcement Learning》。传闻 作者故意将 Reflection 改为 Reflexion,是为了致敬并融合 Reinforcement Learning(强化学习,RL) 的概念(无凭据,大家当一乐看就好了)。

同时,Reflexion 并不仅仅是“Basic Reflection + 外部工具”这么简单。

  • Basic Reflection(基础反思):通常是 单次尝试(Intra-trial) 内部的自我检查。比如 Agent 生成了一个答案,系统再调一次 LLM 问:“你觉得这个答案对吗?有漏洞吗?”这完全依赖 LLM 自身的内部知识边界,如果它本身认知有误,它的反思也会是盲目的。
  • Reflexion(强化学习反思):这是一种跨尝试(Inter-trial)的记忆与反思机制。它引入了“环境反馈”,将 LLM 的反思转化为一种文本化强化学习(Verbal Reinforcement Learning)。它并不是简单地在节点加上工具,而是让 Agent 在尝试完整个任务、收到外部“评估器”的客观打分后,将失败的教训总结成长期经验(Memory),并在下一次重新挑战该任务时带着这些经验。

二、 Reflexion 的底层架构与原理:文本化强化学习

在这里插入图片描述

传统的强化学习(RL)通过标量奖励(Scalar Reward)来更新模型的神经网络权重(Weights)。但在推理阶段更新 LLM 权重成本太高且容易灾难性遗忘。

Reflexion 提出了一种替代方案:用自然语言文本代替标量奖励,用短期/长期记忆池代替神经网络权重的更新。

其核心包含三个主要组件,我们可以用数学表达来严谨定义:

  1. Actor(执行者, 可以是CoT或者ReAct):基于当前的上下文 x x x(短期记忆)、历史轨迹 h t h_t ht​ 和过去的经验教训(长期记忆) m m m,生成下一步动作或文本 a t a_t at​。
    a t ∼ π θ ( a t ∣ x , m , h t ) a_t \sim \pi_{\theta}(a_t | x, m, h_t) at​∼πθ​(at​∣x,m,ht​)
    pass: 怕大家不懂 x, m, h t h_t ht​的区别,下面举个 拼接后的prompt 例子直观感受下:

    ================ [ System Message (x 和 m) ] ================
    你是一个高级程序员Agent。
    【任务目标 (x)】:写一个爬虫脚本爬取某网站的内容。
    【过往惨痛教训 (m)】:上次你忘记加 User-Agent 导致被封禁了,这次一定要加上。
    
    ================ [ Agent Action History ($h_t$) ] ================
    【第 1 步】:
    Thought: 我需要先发送请求测试一下网站连通性。
    Action: requests.get(url)  <-- (a_1)
    Observation: 403 Forbidden  <-- (o_1)
    
    【第 2 步】:
    Thought: 哦!我遇到了403,而且我想起了教训,我应该加伪装。
    Action: requests.get(url, headers={'User-Agent': 'Mozilla...'}) <-- (a_2)
    Observation: 200 OK,返回了HTML网页内容... <-- (o_2)
    
    ================ [ Current Step ($a_t$) ] ================
    请基于上述信息,给出你的下一步思考和动作:
    
    
  2. Evaluator(评估器, 定义奖励函数:稀疏奖励):这是 Reflexion 打破“盲目自信”的关键。它对 Actor 产生的完整轨迹进行客观评估,计算出一个标量分数或布尔值 r r r。这个评估器可以是外部代码编译器、测试用例、或者另一个被设定为严格裁判的 LLM。
    r = f e v a l ( x , h f i n a l ) r = f_{eval}(x, h_{final}) r=feval​(x,hfinal​)

  3. Self-Reflection(自我反思器):当评估器返回失败信号时,反思器介入。它接收 x x x, h f i n a l h_{final} hfinal​, r r r,并生成一段自然语言经验总结 s r sr sr(比如:“我在步骤 3 错误地假设了变量为负数,下次遇到类似情况我应该先检查变量的符号”)。
    s r = LLM r e f l e c t ( x , h f i n a l , r ) sr = \text{LLM}_{reflect}(x, h_{final}, r) sr=LLMreflect​(x,hfinal​,r)
    随后,这个 s r sr sr 会被追加到经验记忆池 m m m 中,供 Actor 下次尝试时使用: m ← m ∪ { s r } m \leftarrow m \cup \{sr\} m←m∪{sr}。

三、 基于LangGraph 实现的核心组件与代码

在 LangGraph 中实现 Reflexion,核心思想是构建一个带有重试循环的状态机,并在每次失败时累积 reflections。

以下是 LangGraph 伪代码实现:

from typing import Annotated, List, TypedDict
from langgraph.graph import StateGraph, END
import operator

# 1. 定义状态 (State)
# 这里的 reflections 就是 Reflexion 论文中提到的长期记忆(Memory)
class AgentState(TypedDict):
    task: str
    current_trajectory: Annotated[List[str], operator.add] # 当前尝试的执行轨迹 (短期记忆)
    reflections: List[str] # 跨尝试的经验总结 (长期记忆)
    is_success: bool
    iterations: int

# 2. 节点:Actor (执行者)
def actor_node(state: AgentState):
    task = state["task"]
    reflections = "\n".join(state["reflections"])
    
    # 巧妙之处:Prompt 中注入过往的惨痛教训
    prompt = f"""
    你的任务是: {task}
    
    【过去的教训】:
    如果你之前失败过,请务必参考以下教训,不要重蹈覆辙:
    {reflections}
    
    请给出你的推理和行动步骤。
    """
    # 模拟 LLM 调用和工具执行
    trajectory = llm_invoke_and_act(prompt) 
    return {"current_trajectory": [trajectory], "iterations": state["iterations"] + 1}

# 3. 节点:Evaluator (评估器) - 提供客观的外部环境反馈
def evaluator_node(state: AgentState):
    trajectory = state["current_trajectory"][-1]
    # 调用外部环境(如Python编译器、单元测试、或者LLM Judge)判断是否真正解决
    is_success, feedback = external_environment_check(state["task"], trajectory)
    return {"is_success": is_success, "eval_feedback": feedback}

# 4. 节点:Reflector (反思器) - Verbal RL 的核心
def reflector_node(state: AgentState):
    task = state["task"]
    trajectory = state["current_trajectory"][-1]
    
    prompt = f"""
    任务: {task}
    你的执行轨迹: {trajectory}
    环境评估结果: 失败。
    
    请作为一位严厉的复盘专家,分析你在上述轨迹中为何失败。
    不要给出借口,用一两句话总结根本原因,并给出一个明确的、针对下次尝试的【行动建议】。
    """
    reflection_text = llm.invoke(prompt)
    return {"reflections": state["reflections"] + [reflection_text], "current_trajectory":[]} # 清空短期轨迹,准备重试

# 5. 定义图结构 (Graph)
workflow = StateGraph(AgentState)

workflow.add_node("Actor", actor_node)
workflow.add_node("Evaluator", evaluator_node)
workflow.add_node("Reflector", reflector_node)

# 定义边和条件路由
workflow.set_entry_point("Actor")
workflow.add_edge("Actor", "Evaluator")

def check_success(state: AgentState):
    if state["is_success"]:
        return "end"
    if state["iterations"] >= MAX_ITERATIONS:
        return "end"
    return "reflect"

# 根据 Evaluator 的结果决定是结束还是去反思
workflow.add_conditional_edges(
    "Evaluator",
    check_success,
    {
        "end": END,
        "reflect": "Reflector"
    }
)

workflow.add_edge("Reflector", "Actor") # 反思完后,带着经验重新交给 Actor 尝试

app = workflow.compile()

四、 常见疑难杂症 QA

Q1: 如果充当 Reflector的大模型自身能力不足,或者我们让同一个较弱的模型(如 7B 的开源小模型)同时兼任 Actor 和 Reflector,它生成的 Reflection 会不会全是幻觉,从而带偏下一次尝试?

深度解析:这是业界常说的“能力倒挂”问题。如果让同一个 LLM 既当运动员又当裁判,它很可能会为自己的错误辩护。
解决方案:

  1. 解耦评估与反思:正如架构图所示,Evaluator 最好是确定性的环境反馈(如代码报错信息 Traceback、正则匹配测试用例)。Reflection 节点只负责将确定性的失败信号“翻译”成自然语言指导。
  2. 异构模型协同:Actor 可以用轻量级模型(如降低成本),而 Reflection / Evaluator 节点使用推理能力最顶尖的模型(如 GPT-4 / Claude 3.5 Opus)。

Q2: 随着重试次数增加,Reflections 数组越来越大,导致 Token 消耗爆炸且 LLM 发生“注意力涣散(Lost in the middle)”,怎么解决?

深度解析:传统的 Reflexion 只是简单地 Append 记忆,这在多步复杂任务中不可持续。
解决方案:

  1. 记忆压缩(Memory Summarization):在 Reflector 节点中,不应仅仅追加新的总结,而应该让大模型对现有的 [Reflection 1, Reflection 2, ...] 结合当前的错误进行融合与提炼,保持记忆池始终只有少数几条最高密度的“行动守则”。
  2. 引入向量检索(下一篇文章介绍的 LATS 演进方向):只将与当前执行步骤语义相似的过往反思通过 RAG(Retrieval-Augmented Generation)召回,而不是全量注入 Prompt。

Q3: Reflexion 下一步演进是 LATS (Language Agent Tree Search)。为什么要引入 LATS?Reflexion 最大的瓶颈是什么?

  • Reflexion 的瓶颈:它本质上是一个 线性重试(Linear Trial-and-Error) 的过程。它抛弃了之前的失败轨迹,只是带着经验从头开始。这在步骤极多的任务中效率极低(类似于每次做错一道大题,都要把试卷擦了从第一步重新写)。
  • 为何演进为 LATS:LATS(结合了蒙特卡洛树搜索 MCTS + 反思)。它保留了整个状态树!如果在第 5 步走错了,Agent 不需要从第 1 步重头开始,它可以退回到第 4 步的节点,带着环境的负向反馈(Reward = -1)去探索另外的节点。LATS = Reflexion(评估与反思) + Tree Search(状态回溯与全局最优搜索)。

【AI技术】主流Agent思想研究——Cot+ReAct+Reflexion 从24年初开始的时候,吴恩达(Andrew Ng)、Harrison Chase(LangChain创始人)等人开始在红杉资本AI论坛等公开场合,提倡Agent、workflow、flow engineering等概念,整个Agent和大模型结合的范式在2024年逐渐由学界研究转到终端应用的实际开发与实践上,大量的软件架构(Langchain、LlamaIndex、MetaGPT)等逐渐建设整个agent 生态吴恩达观点:2024年,目前通过Reflection(反思)和外部工具的调用,是比较成熟的技巧;通 阅读详情

相关推荐

Reflexion:Agent实时自我修正的控制范式与工程落地

Agent长链任务中的语义漂移(Semantic Drift)是导致‘越跑越偏’的核心难题,传统重试(Retry)和静态Prompt自检无法识别跨步骤、多模态、上下文强依赖的偏差。Reflexion作为一种新型Agent Control Patterns,通过硬规则触发、轻量模型校验与LLM深度审查的三级漏斗机制,实现自我状态监控—偏差识别—策略修正的闭环决策。其技术价值在于将review前置到偏差可逆临界点,并以环形缓冲区、状态快照、受控research子任务等工程设计保障低延迟与高可靠性。广泛应用于财报

weixin_34341229的博客 383

论文理解【LLM-agent】—— 【Reflexion】Language Agents with Verbal Reinforcement Learning

本文介绍 LLM agent 领域的经典方法 Reflexion,它通过引入 episodic memory 为 agent 提供长期记忆,在不微调模型的参数的同时实现了基于上下文的试错学习,性能提升显著

佚失的诗篇 4623

基于Reflexion框架的AI Agent自我反思与迭代优化实践

在AI Agent开发领域,如何让大语言模型(LLM)具备从失败中学习的能力是一个核心挑战。传统方法往往依赖简单的重试或参数调整,但缺乏对失败原因的深度分析和经验积累。Reflexion框架通过引入文本化的反思机制,为Agent提供了元认知层面的优化路径。其核心原理在于构建一个包含执行者、评估者和反思模块的闭环系统,让Agent能够基于环境反馈生成结构化的反思文本,并将这些经验融入后续决策过程。这种机制的技术价值在于显著提升了Agent在复杂动态环境中的适应性和成功率,尤其在编程调试、决策推理等需要多轮试错

weixin_30843605的博客 387

Agent开发02-关键思想(ReAct、ReWOO、Reflexion、LLM Compiler等)

前文概述了Agent开发定义和一些基本概念,本文目的是概述目前Agent开发的一些关键论文和思想。

君子之学必日新,日新者日进也。不日新者必日退,未有不进而不退者 1052

Reflexion框架解析:如何通过语言反馈实现LLM Agent的自我强化

本文深入解析Reflexion框架如何通过语言反馈实现LLM Agent的自我强化。该框架结合自然语言反馈与强化学习,显著提升AI在编程、数学解题等复杂任务中的表现。核心组件包括执行者、评估者和自我反思模块,相比传统强化学习,Reflexion框架具有更高的可解释性和训练效率。实际应用案例展示其在智能编程助手、数学解题系统和商业决策模拟中的卓越效果。

weixin_28568819的博客 302

C语言由scanf(“%d“,)非法输入字符造成的死循环及其解决方案

声明:此文章仅作为C语言学习历程中的思路整理,用于解决入门阶段较为浅显的问题,如有错误还请指正。 现象描述: 代码要求实现用户输入1或2,通过scanf("%d",&a)读取这个值,从而判断分属于1或2的两种情况。输入非1,2的数字都应该返回"Invalid Number!",并且要求重新输入数字。 while(a!=1&&a!=2) { printf("Invalid Number!\n"); printf("Enter the number:"); scan

weixin_49764077的博客 8720

Agent 的设计模式总结:ReAct、Plan-Execute 和 Reflexion 工程对比

Agent 设计模式的选择,本质上是在灵活性与可控性之间做权衡。ReAct 给了你最大的灵活性,但可能让成本失控。Plan-Execute 让你对流程有掌控力,但碰上变化快的场景就捉襟见肘。Reflexion 让 Agent 能自我进化,代价是更高的延迟和更复杂的系统设计。实际工程中,我的建议是:从 ReAct 起步、用 max_steps 兜底。当任务复杂度上来后,再加入 Plan-Execute 做任务分解。最后引入 Reflexion 的反思机制,让 Agent 在长时间运行中持续自我优化。

2401_87746054的博客 4687

华南理工大学电子与信息学院23年预推免复试面试经验贴

华南理工大学电子与信息学院23年预推免复试面试经验贴

Scut_Ty的博客 3298

AI Agent自我反思框架Reflexion:让智能体从失败中学习

在人工智能领域,智能体(Agent)的核心挑战在于如何从错误中学习并持续改进。传统基于提示词的Agent往往缺乏结构化记忆机制,导致在复杂任务中反复犯同样的错误。为解决这一问题,强化学习(Reinforcement Learning)提供了通过环境反馈优化策略的范式,而Reflexion框架创新性地将自然语言反思作为强化信号,实现了语言驱动的自我改进。该技术通过引入反思器和经验存储器,使Agent能够分析失败轨迹、总结教训并形成可指导未来行动的经验,从而显著提升在代码生成、逻辑推理等任务中的成功率。这种基于

weixin_33910137的博客 423

VSCode下载、安装+C语言环境配置(超详细)

ps:我的更改部分:"D:/BaiduNetdiskDownload/x86_64-8.1.0-release-win32-seh-rt_v6-rev0/mingw64。③ 找到【系统变量】中的【Path】变量 ---- 双击打开后,将刚刚复制的地址添加进去 ---- 点击【确定】;① 双击【此电脑】---- 点击【属性】---- 进入到下面这个界面,单击【高级系统设置】;② 进入到 系统属性界面 ---- 点击【环境变量】,进入环境变量页面;并进行安装,安装成功后,打开VSCode;

weixin_48820458的博客 1万+

从隐私保护到生命守护:CPD技术中的传感器选择与权衡

本文探讨了智能座舱中儿童存在检测(CPD)技术的传感器选择与隐私保护平衡策略。通过分析毫米波雷达、UWB等先进技术的性能与隐私风险,揭示了如何在确保儿童安全的同时保护用户隐私。文章还展望了CPD技术与座舱生态系统的未来融合趋势,为汽车安全领域提供了重要参考。

weixin_29159441的博客 301

【智能体】Reflexion 深度解析:用“反思“让 Agent 越错越强

Reflexion = 用语言反思替代数值奖励的零梯度自我改进。Agent 失败后,用自然语言分析错误原因、生成改进方案,将反思作为记忆注入下一次尝试,实现 "越错越强"。本文从起源、原理、三组件(Actor/Evaluator/Self-Reflection)、工作流程、演进史、性能数据、优缺点、vs 强化学习到含重复检测的伪代码,系统拆解这一 Agent 反思范式。

m0_66705151的博客 380

GitHub 新手使用手册

理论说太多容易忘,来实践实践吧。

2501_90226046的博客 1054

Reflexion Agent是什么?怎么实现?

Reflexion Agent是一种通过语言反馈实现自我强化的智能体框架,它由LLM、语言反思模块和经验记忆池组成。与传统强化学习不同,它不需要权重更新,而是通过:1)Actor执行任务;2)Evaluator评估结果;3)Self-Reflection生成语言总结;4)将反思文本存入记忆(短期记忆记录当前轨迹,长期记忆存储反思)。这种机制使Agent能通过言语层面的反思不断优化决策。该框架已在论文《Reflexion: Language Agents with Verbal Reinforcement L

weixin_51590845的博客 473

开源 AHB不对称半桥反激电路设计(六)死区时间,谐振腔电流,谐振电感函数表达式

电流跌落可以使副边电流峰值和有效值降低,减小损耗,但如果开关管 S2 导通期间,谐振电流谐等于励磁电流,即副边电流A 点降至 0,会在原边变压器内形成环流,产生损耗,同时也不利于副边同步整流管驱动的正常工作,为了保证开关管 S2 导通期。在开关管 S1 和开关管 S2 均关断的死区时间内,谐振电流给原边开关管结电容和副边整流管结电容充放电,因此会引起开关 S1 关断瞬间电流跌落与开关 S2 关断瞬间电流震荡现象,受寄生参数影响原边谐振电流波形和副边电流波形如图。降到最低,变压器以最高效率向副边传递能量。

【Simon】的博客 1229

【飞控】UAV Toolbox Support Package for PX4 Autopilots安装与配置

安装配置UAV Toolbox Support Package for PX4 Autopilots硬件安装包

m0_58373406的博客 1617

【收藏学习】LLM Agent实战指南:超越传统LLM的智能体架构与实现方法

要理解什么是 LLM Agent,首先我们需要回顾一下 LLM 的基本功能。传统上,LLM 的工作方式是通过预测下一个词元(token)实现的。在生成多个词元的过程中,模型逐步扩展输入内容,从而模拟对话,生成更长且更连贯的回应。然而,随着对话的进行,LLM 的一个主要缺点逐渐显现——它无法记住之前的对话内容!除了记忆缺失的问题外,LLM 在执行一些看似简单的常见任务时也经常犯错。例如,基础的数学运算如乘法和除法都可能出错。然而,这并不意味着 LLM 无法胜任这些任务。

python12345_的博客 935

【瑞芯微px30】【RTL8363】【一】驱动移植-网卡驱动概述

linux rtl8363驱动移植

weixin_34799243的博客 1180

万字长文深度解析Agent反思工作流框架Reflexion上篇:安装与运行

今天,我们将迈出从理论到实践的关键一步——通过安装和测试Reflexion框架,我们将揭开智能体工作流的神秘面纱,实现知识的深度融合与应用。

2401_82469710的博客 2152

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

AI Agent自我反思机制:Reflexion框架原理与工程实践

在AI Agent开发领域,大语言模型(LLM)在复杂任务中常面临重复犯错、经验难以复用等挑战。为解决这些问题,研究者提出了基于语言强化学习的反思机制,其核心原理是通过自然语言分析失败轨迹,生成改进策略,使Agent具备从错误中学习的能力。这一技术通过“行动-评估-反思-规划”的循环,显著提升了任务成功率,尤其在编程调试、复杂决策等场景中展现出重要价值。其中,自我反思和错误重复是Reflexion框架解决的关键问题,它让Agent能够持续优化决策过程,而无需增加模型参数。这种机制为构建更可靠、更智能的自主系

aoe41606的博客 430

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

万字长文深度解析Agent反思工作流框架Reflexion上篇:安装与运行,大模型入门到精通,收藏这篇就足够了!

今天,我们将迈出从理论到实践的关键一步——通过安装和测试Reflexion框架,我们将揭开智能体工作流的神秘面纱,实现知识的深度融合与应用。

DEVELOPERAA的博客 1162

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

Reflexion框架解析:如何通过语言反馈实现LLM Agent的自我强化学习

本文深入解析了Reflexion框架如何通过语言反馈实现LLM Agent的自我强化学习。该框架利用情景记忆、自然语言反馈和多模型协作系统,显著提升AI在编程、问答等任务中的表现,无需调整模型权重即可实现能力提升。实验显示,Reflexion在HumanEval编程测试中通过率高达91%,比直接使用GPT-4高出11个百分点。

algae的博客 751

AI Agent 反思机制全解:单轮反思、多 Agent 互评与 Reflexion 进阶面试指南

本文纠正对 Agent 反思的浅层误解,讲解反思是生成、评估、改进的完整闭环,拆解评估提示词两大设计要点,对比步骤级、任务级两种反思粒度的开销与适用场景,分析 Critic 多 Agent 互评优于单模型自查的核心原因,给出防止无限循环的工程约束方案,介绍可沉淀错题经验的 Reflexion 进阶机制,整理分层面试答题思路,帮你分清单次纠错与跨任务经验沉淀的差异。

海市公约的博客 560

【LLM进阶-Agent】10. LATS (Language Agent Tree Search) 介绍

摘要:LATS架构演进与核心原理 大模型智能体(LLM Agent)的演进路径经历了从ReAct到LATS的技术跃迁。ReAct虽开创了推理-行动模式,但缺乏纠错能力;Reflexion引入反思机制却仍限于单一路径优化。LATS通过融合蒙特卡洛树搜索(MCTS)和语言模型特性,构建了包含选择、扩展、评估、模拟、回溯、反思六步循环的全局搜索框架。其核心创新在于: 采用UCT算法平衡探索与利用 通过LLM生成多候选动作实现思维发散 引入Critic模型进行预评估 将反思记忆注入搜索过程 该架构通过状态-动作树实

FDGFGFDGFD的博客 844

从ReAct到Reflexion:Planning Agent架构演进与工程实践

在人工智能应用开发中,任务分解与执行是核心挑战。其基本原理在于将复杂问题拆解为可管理的子任务,并通过有序执行来达成目标。这一技术价值在于显著提升了大语言模型处理长链条、多步骤任务的可靠性与可控性,使其从简单的对话工具转变为能够自主工作的智能体。在应用场景上,它广泛适用于自动化工作流、智能客服、数据分析与报告生成等领域。本文聚焦于Planning Agent的架构演进,深入剖析了ReAct、Plan-and-Execute和Reflexion三种核心模式,并结合工程实践中的工具调用与状态管理等热词,探讨了如何

weixin_34034670的博客 311

ReAct、Reflexion、Plan-and-Execute:三大 LLM Agent 范式一文吃透

ReAct、Reflexion、Plan-and-Execute 是三大主流LLM Agent范式:ReAct实现边想边做,提升可解释性;Reflexion通过事后反思优化决策,增强纠错能力;Plan-and-Execute先规划后执行,提高任务全局性。三者并非互斥,可叠加使用,构建更智能、稳健的AI代理系统。

2403_83506820的博客 229
上一篇: 【LLM进阶-Agent】7. Basic Reflection Agent 介绍
下一篇: 【LLM进阶-Agent】9. self-discover Agent 介绍
RuiBo_Qiu
博客等级 码龄11年 158粉丝 56原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值