
NVIDIA Triton系列01-应用概论

NVIDIA Triton系列-YOLOV5 部署(1) -环境搭建及部署并使用Perf_Analyze测试ONNX YOLOV5M 利用英伟达高性能部署方案Triton完成YOLOV5的trt+ensemble+python backend的部署 阅读详情

NVIDIA Triton系列01-应用概论
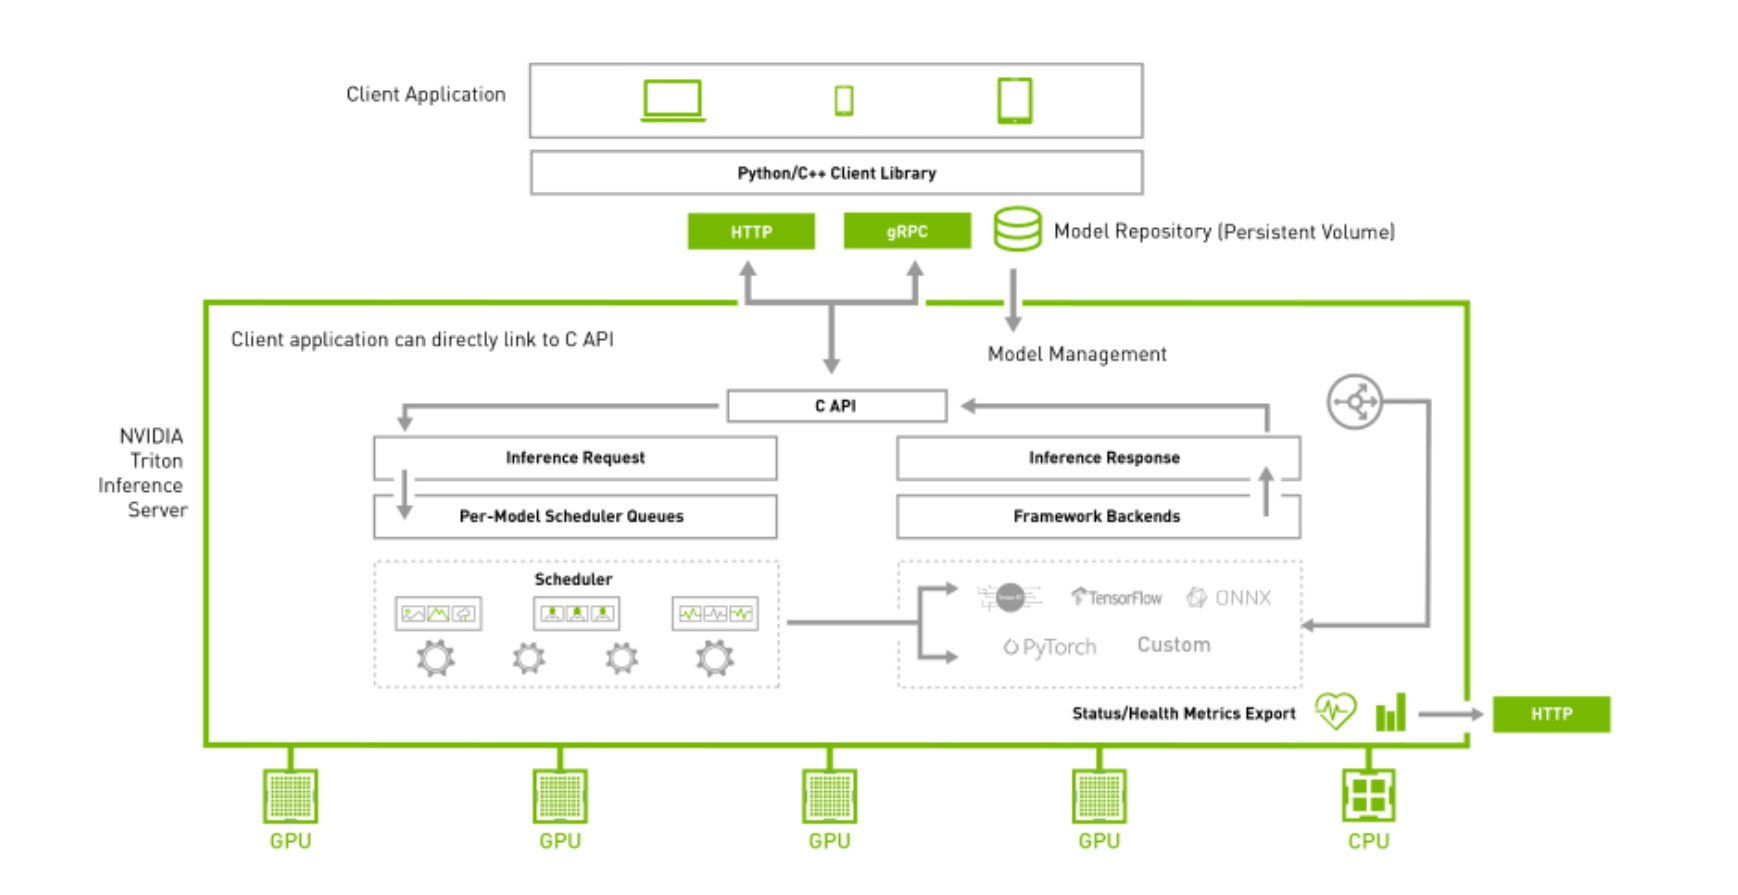
image-20240615113403856

推理识别是人工智能最重要的落地应用,其他与深度学习相关的数据收集、标注、模型训练等工作,都是为了得到更好的最终推理性能与效果。

几乎每一种深度学习框架都能执行个别的推理工作,包括 Tensorflow、Pytorch、MXNet 等通用型框架与 YOLO 专属的 Darknet 框架,此外还有 ONNX 开发推理平台、NVIDIA TensorRT 加速推理引擎,也提供推理相关的 C / C++ 与 Python 开发接口,这是大部分技术人员所熟悉的方法。

在垂直应用方面,NVIDIA 的 DeepStream 智能分析工具是非常适合用在种类固定且需要长期统计分析的场景,包括各种交通场景的人 / 车流量分析、工业流水线质量检测等应用,并且在早期视觉(Visualization)类推理功能之上,再添加对话(Conversation)类推理功能,让使用范围更加完整。

上述的推理方式通常适合在识别固定种类与固定输入源的使用场景,在交通、工业自动化领域、无人设备等领域的使用比较普及。

但是这种方式并不适合在网络相关的服务类应用中使用,包括在线的产品推荐、图像分类、聊天机器人等应用,因为在线服务需要同时面对未知数量与类型的数据源,并且透过 HTTP 协议进行数据传输的延迟问题,也是严重影响用户体验感的因素,这是绝大部分网路服务供应商要导入 AI 智能识别技术所面临的共同难题。

NVIDIA Triton 推理服务器的最大价值,便是为服务类智能应用提供一个完整的解决方案,因此首先需要解决以下的三大关键问题:

1. 高通用性:

(1) 广泛支持多种计算处理器:包括具备 NVIDIA GPU 的 x86 与 ARM CPU 设备,也支持纯 CPU 设备的推理计算。

(2) 广泛支持各种训练框架的文件格式:包括 TensorFlow 1.x/2.x、PyTorch、ONNX、TensorRT、RAPIDS FIL(用于 XGBoost、Scikit-learn Random Forest、LightGBM)、OpenVINO、Python 等。

(3) 广泛支持各种模型种类:包括卷积神经网络 (CNN)、循环神经网络 (RNN)、决策树、随机森林和图神经网络等算法。

2.部署便利:

(1) 可在横向扩展的云或数据中心、企业边缘,甚至 NVIDIA Jetson 等嵌入式设备上运行。

(2) 支持用于 AI 推理的裸机和虚拟化环境,包括 VMware vSphere 与基于 Docker 技术的 Kubernetes 管理机制。

(3) 可托管于多种人工智能云平台,包括 Amazon SageMaker、Azure ML、Google Vertex AI、阿里巴巴 AI、腾讯 TI-EMS 等平台。

3.性能优化:

(1)动态批量处理:推理优化的一个因素是批量大小,或者您一次处理多少个样本,GPU 以更高的批量提供高吞吐量。然而,对于实时应用程序,服务的真正限制不是批量大小甚至吞吐量,而是为最终客户提供出色体验所需的延迟。

(2)模型并发执行:GPU 是能够同时执行多个工作负载的计算设备,NVIDIA Triton 推理服务器通过在 GPU 上同时运行多个模型来最大限度地提高性能并减少端到端延迟,这些模型可以是相同的,也可以是来自不同框架的不同模型。GPU 内存大小是同时运行模型数量的唯一限制,这会影响GPU利用率和吞吐量。

以上是 NVIDIA Triton 推理服务器的基本特性说明,要满足上面所列的特性,是相对复杂的内容,这是本系列文章所要为读者逐一探索的内容,不过在讲解技术内容之前,我们可以先看看有哪些比较具有代表性成功案例,能让大家对于 Triton 推理服务器的使用场景有更进一步的了解。

案例1:微软 Teams 会议系统使用 Triton 提升生成实时字幕和转录性能

微软 Teams 是全球沟通和协作的重要工具,每月有近 2.5 亿活跃用户,其 Azure 认知服务提供 28 种语言的字幕和转录,实时字幕功能帮助与会者实时跟踪对话,转录功能方便与会者在日后回顾当时的创意或回看未能参与的会议,实时字幕对聋哑人、听力障碍者,或者异国与会者特别有用。

底层语音识别技术作为认知服务中的一个 API,开发人员可以使用它定制和运行自己的应用程序,例如客服电话转录、智能家居控制或为急救人员提供 AI 助手。认知服务会生成 Teams 的转录和字幕,将语音转换为文本,并识别说话人。同时也能够识别专业术语 、姓名和其他会议背景,提高字幕的准确性。

微软 Teams 首席项目经理 Shalendra Chhabra 表示:“这样的 AI 模型非常复杂,需要数千万个神经网络参数才能识别几十种不同的语言。但模型越大,就越难以经济高效地实时运行。”

为了提高服务质量,微软使用 NVIDIA Triton 开源推理服务软件,来帮助 Teams 使用认知服务优化语音识别模型,以及认知服务所支持的高度先进语言模型,在极低的延迟状态下提供高度准确、个性化的语音转文本结果,同时可以保证运行这些语音转文本模型的 NVIDIA GPU 充分发挥计算资源,在消耗更少计算资源的同时为客户提供更高的吞吐量,进而降低成本。

NVIDIA GPU 和 Triton 软件能够帮助微软,在不牺牲低延迟的情况下,通过强大的神经网络,实现高准确性,确保语音-文本的实时转换,当启用转录功能时,与会者可以在会议结束后轻松补上错过的内容。

Triton 推理服务器有助于简化 AI 模型部署并解锁高性能推理,用户甚至可以为自己的应用开发自定义后端。下面三种关键功能,是协助微软将 Teams 的字幕和转录功能扩展到更多会议和用户的效能:

流推理:新型流推理功能—通过跟踪语音上下语境,提高延迟、敏感性字幕的准确度,协助 Azure 认知服务合作定制语音转文本的应用程序。

动态批量处理:批量大小指神经网络同时处理的输入样本数量,通过 Triton 的动态批量处理功能,单项推理请求被自动组合成一个批次,因此能够在不影响模型延迟的情况下更好地利用 GPU 资源。

并发模型执行:实时字幕和转录需要同时运行多个深度学习模型,Triton 使开发人员能够在单个 GPU 上同时完成这些工作,包括使用不同深度学习框架的模型。

案例2:Triton 助力微信加速视觉应用,提高可靠性

本案例中,通过 NVIDIA 的 GPU 执行 Triton 推理服务器与 TensorRT 推理加速引擎, 帮助微信的二维码光学识别(OCR)计算降低 46% 时间,并将系统的失败率降低 81%,同时减少 78% 的服务器使用数量。

腾讯微信是一款跨平台的通讯工具,支持通过手机网络发送语音、图片、视频和文字等。截至 2021 年 6 月,微信在全球拥有超过 12 亿活跃用户,是国内活跃用户最多的社交软件。

微信识物是一款主打物品识别的 AI 产品,通过相机拍摄物品,更高效、更智能地获取信息。2020 年微信识物拓展了更多识别场景,上线了微信版的图片搜索,打开微信扫一扫,左滑切换到 “识物” 功能,对准想要了解的物品正面,可以获取对应的物品信息,包括物品百科、相关资讯、相关商品。

2021 年 1 月,微信发布的 8.0 版本更新支持图片文字提取的功能,用户在聊天界面和朋友圈中长按图片就可以提取图片中文字,然后一键转发、复制或收藏。

在识物的过程包含检测、图像召回、信息提炼等环节,其中二维码扫描的使用频率也是非常高,主要包括识别和检测,这两种应用都有非常大的计算量。但原本使用 Pytorch 进行模型的推理时,遇到以下三大问题:

请求的延迟很大,影响用户体验感;

显存占用很大,单张 NVIDIA T4 GPU 卡能部署的模型数比较少,导致推理请求的并发数上不去,请求失败的概率太高,只能通过增加机器的方式来提高并发能力,业务部署成本较高。

使用的模型经常变化,而业务需要更换后的模型需要能够快速地加速和上线部署。

为了解决上述问题,微信团队使用 Triton 推理服务器结合 TensorRT 加速推理器的综合方案,主要技术内容如下:

通过使用 TensorRT 对微信识物和 OCR 的模型进行加速,在都使用 FP32 的情况下,比 Pytorch 的延迟降低 50% 左右;

在 OCR 的识别和检测阶段,使用 TensorRT 结合 NVIDIA T4 GPU 的 FP16 Tensor Core,在保证精度的前提下,识别的延迟降低 50%、检测的延迟降低 20%;

在微信识物的分类和检测任务中,通过使用 NVIDIA T4 GPU 的 int8 Tensor Core 并结合 QAT,在满足精度要求的前提下,进一步大幅提升了性能;

通过使用 FP16 和 int8 低精度模式,在大幅降低推理延迟的同时,大大减少了显存的占用,在 FP16 模式下,单模型显存占用仅占 FP32 模式的 40%–50%, 而在 int8 模式下,单模型显存占用仅占 FP32 模式的 30% 左右。在提高单张 T4 卡上部署的模型数量的同时,大幅提高了单 GPU 的推理请求并发能力;

Triton 的动态批量处理(dynamic batch)和多实例等特性,帮助微信将在满足延迟要求的同时,提高了系统整体的并发能力,将系统失败降低了 81%;

TensorRT 对个别模型得到推理的加速,Triton 则对加速后的模型进行快速的部署,满足了业务对修改后的模型进行快速部署的需求,也大大减少工程人员的工作量。

通过使用 NVIDIA 的 TensorRT 对微信识物和 OCR 的模型进行加速,在降低单次推理延迟 50% 以上的同时**,节约了多达 64% 的显存**。结合 Triton 的动态批量处理和多实例的功能,OCR 的整体时延降低了 46%,系统失败率降低了 81%。大大提高了用户的体验,并且服务器的数量减少了多达 78%,极大降低了服务的成本。

案例3:腾讯 PCG 使用 Triton 加速在线推理,提高设备效能

腾讯平台与内容事业群(简称 腾讯 PCG)负责公司互联网平台和内容文化生态融合发展,整合 QQ 软件、QQ 空间等社交平台,和应用宝、浏览器等流量平台,以及新闻资讯、视频、体育、直播、动漫、影业等内容业务,推动 IP 跨平台、多形态发展,为更多用户创造海量的优质数字内容体验。

腾讯 PCG 机器学习平台部旨在构建和持续优化符合 PCG 技术中台战略的机器学习平台和系统,提升 PCG 机器学习技术应用效率和价值,建设业务领先的模型训练系统和算法框架,提供涵盖数据标注、模型训练、评测、上线的全流程平台服务,实现高效率迭代,在内容理解和处理领域,输出业界领先的元能力和智能策略库。

这个机器学习平台服务于 PCG 所有业务产品,面对上述所提到的综合需求,有以下三大挑战:

1. 业务繁多,场景复杂**:**

(1) 业务开发语言包括 C++ 与 Python;

(2)模型格式繁多,包括 ONNX、Pytorch、TensorFlow、TensorRT 等;

(3)模型预处理涉及图片下载等网络 io;

(4)多模型融合流程比教复杂,涉及循环调用;

(5)支持异构推理;

2.模型推理结果异常时,难以便利地调试定位问题;

3.需要与公司内现有协议 / 框架 / 平台进行融合。

基于以上挑战,腾讯 PCG 选择了采用 NVIDIA 的 Triton 推理服务器,以解决新场景下模型推理引擎面临的挑战,在提升用户研效的同时,也大幅降低了服务成本。

NVIDIA 的 Triton 推理服务器是一款开源软件,对于所有推理模式都可以简化在任一框架中以及任何 GPU 或 CPU 上的运行方式,从而在生产环境中使用推理计算,并且支持多模型 ensemble,以及 TensorFlow、PyTorch、ONNX 等多种深度学习模型框架,可以很好的支持多模型联合推理的场景,构建起视频、图片、语音、文本整个推理服务过程,大大降低多个模型服务的开发和维护成本。

通过将 Triton 编译为动态链接库,可以方便地链入公司内部框架,对接公司的平台治理体系,符合 C 语言规范的 API 也极大降低了用户的接入成本,借助 Python 后端和自定义后端,用户可以自由选择使用 C++ 或 Python 语言进行二次开发。

NVIDIA DALI 是 GPU 加速的数据增强和图像加载库,使用 Triton 的 DALI 后端可以替换掉原来的图片解码、缩放等操作,Triton 的 FIL 后端可以替代 Python XGBoost 模型推理,进一步提升服务端推理性能。

借助 NVIDIA Triton 推理框架,配合 DALI / FIL / Python 等后端与 TensorRT,整体推理服务的吞吐能力最大提升 6 倍,延迟最大降低 40%。帮助腾讯 PCG 各业务场景中,以更低的成本构建了高性能的推理服务,同时更低的延迟降低了整条系统链路的响应时间,优化了用户体验,也降低了 20%-66% 总成本。

透过以上三个成功案例,就能很明显看出,Triton 推理服务器在面对复杂的智能识别应用场景时,能发挥非常有效的整合功能,特别是模型来自不同训练平台时,以及面对不同前端开发语言时,更能体现其便利性。

在后面的文章会带着大家,先从宏观的角度来了解 Triton 推理服务器的应用架构以及所需要的配套资源,接着搭建 Triton 的使用环境,包括建立模型仓、安装服务端/用户端软件,然后执行一些实用性强的基础范例,以及结合 NVIDIA 的 TensorRT 与 DeepStream 等推理工具,让更多开发人员能利用 Triton 整合更多 AI 推理资源。

出处:NVIDIA Triton系列文章(1):应用概论 - 最新资讯 - 英伟达AI计算专区 - 智东西 (zhidx.com)

Nvidia Triton Inference Server——强大推理和部署引擎,你值得拥有! Triton Inference Server(Triton推理服务器)是一个开源的深度学习模型推理服务框架,旨在简化深度学习模型的部署推理过程。Triton 能够从多个深度学习和机器学习框架部署任何AI模型。Triton支持在NVIDIA GPU、x86和ARM CPU或AWS Inferentia上进行云、数据中心、边缘和嵌入式设备上的推理。Triton推理服务器针对多种查询类型提供了优化的性能,包括实时、批量、集成和音视频流式处理。 阅读详情

相关推荐

TensorRT&Triton学习笔记(一):triton和模型部署+client

前言 先介绍TensorRT、Triton的关系和区别: TensorRT:为inference(推理)为生,是NVIDIA研发的一款针对深度学习模型在GPU上的计算,显著提高GPU上的模型推理性能。即一种专门针对高性能推理的模型框架,也可以解析其他框架的模型如tensorflow、torch。 主要优化手段如下: Triton:类似于TensorFlow Serving,但triton包括server和client。 triton serving能够实现不同模型的统一部署和服务,提供http和grpc协

sgyuanshi的博客 2万+

Nvidia Triton 使用入门教程

所谓自定义backend就是自己写推理过程,正常情况下整个推理过程是通过模型直接解决的,但是有一些推理过程还会包含一些业务逻辑,比如:整个推理过程需要2个模型,其中要对第一个模型的输出结果做一些逻辑判断然后修改输出才能作为第二个模型的输入,最简单的做法就是我们调用两次triton服务,先调用第一个模型获取输出然后进行业务逻辑判断和修改,然后再调用第二个模型。不过在triton中我们可以自定义一个backend把整个调用过程写在里面,这样就简化调用过程,同时也避免了一部分http传输时延。

JineD的博客 3202

NVIDIA全栈AI工具链解析:从CUDA到Triton的实战指南

GPU并行计算作为现代人工智能的核心基础,通过CUDA架构实现了大规模数据的高效处理。其原理是利用数千个计算核心同时执行任务,显著提升深度学习模型的训练和推理速度。在技术价值层面,GPU加速使得Transformer等大模型成为可能,为计算机视觉和自然语言处理领域带来突破性进展。应用场景涵盖从自动驾驶的实时感知到医疗影像的智能分析,其中模型部署的标准化尤为关键。NVIDIA Triton推理服务器通过动态批处理和统一内存管理等热词技术,解决了生产环境中模型服务的性能瓶颈。TensorRT的层融合优化则进一步

weixin_30883311的博客 375

解释一下英伟达的triton

英伟达 Triton 是一种基于英伟达 GPU 的服务器端推理引擎,用于部署机器学习模型进行实时预测。它旨在为企业、服务提供商和研究机构提供一种高效、易于使用的方法来部署和管理机器学习推理。Triton 可以与英伟达的深度学习框架 TensorRT 集成,使开发人员能够轻松地将训练的模型部署到生产环境中。Triton 还提供了一个简单的 REST API,可用于在客户端应用程序中轻松调用机器学习模...

weixin_42584758的博客 808

保姆级教程:解决Ubuntu 22.04上nvidia-container-toolkit安装失败,让Triton Server顺利跑在GPU上

本文提供Ubuntu 22.04上nvidia-container-toolkit安装失败的完整解决方案,帮助用户顺利部署支持GPU加速的Triton Server。从软件源配置到Docker运行时设置,详细步骤解决'无法定位软件包'问题,确保GPU推理环境正常运行。

weixin_30687051的博客 438

triton操作干货

Triton Inference Server 的自定义后端(backends)通常需要以共享库(SO库)的形式实现,这是因为 Triton 使用插件架构,可以加载和卸载这些库以实现不同的模型后端。作为实现后端的共享库。请求的URL应该是Triton Inference Server的推理端点,例如http://:/v2/infer,其中是服务器IP地址,是Triton的端口号。然而,Triton本身有一个主配置文件,通常是以YAML格式编写的,用于定义Triton推理服务的整体配置,包括多个模型的配置。

skjmom的博客 1368

NVIDIA Triton Inference Server 与 TensorRT-LLM 的关系以及部署Qwen3模型部署

摘要:本文介绍了NVIDIA Triton Inference Server与TensorRT-LLM的协同关系,并详细指导了Qwen系列模型(如Qwen2.5/3-14B)的部署流程。TensorRT-LLM作为底层推理引擎负责模型优化,而Triton Server则提供高性能服务框架。部署步骤包括:1)准备GPU环境;2)通过TensorRT-LLM编译模型为高效引擎文件;3)配置Triton模型仓库;4)启动推理服务;5)测试API调用。整个过程强调了对大模型的高效部署方法,特别适用于需要高并发、低延

破烂PAN 的博客 876

DeepStream系列之Triton部署模型

deepstream 官方文档介绍,支持与 Triton Server 对接,把 nvinfer 的部分放到 triton 上来实现,即 nvinferserver,那么这种方式可以解决什么问题呢?首先,triton server 支持更多种类的模型,如 pytorch、tensorflow、tensorrt 等,而 nvinfer 只专注于做 tensorrt 模型的集成,这对于模型的开发调试有利;但是如果在实际生产环境中,还是建议使用 nvinfer 插件,因为这种方式更高效,对内存...

ZONGXP的博客 7293

NVIDIA全栈AI实战:从模型训练到Triton部署完整指南

GPU并行计算是现代人工智能的核心基础,通过CUDA架构实现大规模矩阵运算加速。其技术原理在于利用GPU的数千个计算核心同时处理数据,显著提升深度学习模型的训练和推理效率。这一技术价值体现在能够将传统需要数周的训练任务缩短到几天甚至几小时,为AI应用落地提供算力保障。在实际应用场景中,从数据预处理、模型训练到推理部署的全流程都可以通过NVIDIA技术栈实现优化。TensorRT作为高性能推理SDK,能够对训练好的模型进行优化加速;而Triton Inference Server则提供了生产级模型部署解决方案

weixin_33875564的博客 384

Deepseek:物理神经网络PINN入门教程

物理信息网络(Physics-Informed Neural Networks, PINN)是一种将物理定律(如偏微分方程、守恒定律等)嵌入神经网络训练过程的深度学习方法。其核心思想是通过神经网络同时拟合观测数据并满足物理约束,从而解决传统数值方法难以处理的高维、噪声数据或复杂边界条件问题。

金石软件 9298

LabVIEW与MySQL的连接:软件下载与安装至UDL文件创建全过程

依据个人经验编辑的十分完备的使用教程

tiaowudexiaoyu的博客 5574

Triton学习-01-vector-add

我选择的是直接根据官方示例的源码进行学习链接:首先使用源码进行执行的时候,遇到了第一个报错:AttributeError: 'BangDriver' object has no attribute 'get_active_torch_device'查阅相关的信息发现有网友说是NVIDIA的相关接口变掉了,导致triton中无法加载(不是特别确定,因为我使用的是国产的MLU显卡),总之这个网友给了一个解决方案,是可以采纳使用的。将替换为这样我们就获取到了当前正在使用的GPU名称和卡号。

shencc__的博客 1080

手把手教你用Apple Developer App完成苹果开发者账号注册(含证件验证失败解决方案)

本文详细指导如何通过Apple Developer App完成苹果开发者账号注册,特别针对证件验证失败问题提供解决方案。从准备工作到注册流程,再到验证失败的处理方法,帮助开发者顺利完成注册,避免常见错误。

moss5的博客 1157

EVA-01部署教程:NVIDIA Triton推理服务器封装Qwen2.5-VL-7B并接入EVA-01前端

本文介绍了如何在星图GPU平台上自动化部署🟣 EVA-01: VISUAL NEURAL SYNC SYSTEM镜像,快速构建一个基于Qwen2.5-VL-7B多模态大模型的视觉分析服务。通过该平台,用户可轻松实现模型的工业级封装与部署,并将其应用于智能图片内容分析与问答等场景,显著提升开发与集成效率。

weixin_29215509的博客 214

Halcon dyn_threshold详解

dyn_threshold 原型 dyn_threshold(OrigImage, ThresholdImage : RegionDynThresh : Offset, LightDark : ) 功能 利用局部阈值分割图像 参数列表 OrigImage (input_object):原始图像 ThresholdImage (input_object):处理后图像(一般采用滤波处理) RegionDynThresh (output_object):分割后区域 Offset (input_control):灰

ZiLiangQin的博客 1万+

Windows 环境下 OpenClaw 的安装与千问大模型配置

为了不占用 C 盘空间,重装系统也不丢失配置,本文详细记录了如何将 OpenClaw 安装在非系统盘,比如D 盘,并对接阿里云 通义千问大模型的全过程。主要是利用 NVM 和 npm 进行安装,方便后续一键升级,配置具有免费额度的Qwen API,这个只需要在阿里云百炼注册一个账号就能获得免费额度。

博客 6537

EVA-01部署教程:NVIDIA Triton推理服务器集成Qwen2.5-VL-7B优化方案

本文介绍了如何在星图GPU平台上自动化部署🟣 EVA-01: VISUAL NEURAL SYNC SYSTEM镜像,该镜像集成了Qwen2.5-VL-7B模型与NVIDIA Triton推理服务器。通过此方案,用户可快速搭建高并发的视觉语言模型服务,典型应用场景包括对上传的图片进行智能内容分析与描述,实现高效的多模态AI推理。

weixin_33750664的博客 583

Kill5.37版本下,使用ARMcomplier6编译__asm 函数报错的问题

Kill5-5.37版本下,使用ARMcomplier6编译__asm 函数报错的问题 问题简要描述: 昨日更新了keil5软件的版本,从5.17更新到了5.37版本,然后编译STM32项目文件时,软件提示编译报错。报错问题如下: Build started: Project: QKsoftware *** Using Compiler 'V6.18', folder: 'E:\MDK-ARM\ARM\ARM\ARMCLANG\Bin' Build target 'QKsoftware' compiling

weixin_43644424的博客 1万+

SenseVoice Small部署教程:NVIDIA Triton推理服务器集成方案

本文介绍了如何在星图GPU平台上自动化部署SenseVoice Small镜像,构建高性能语音转写服务。依托NVIDIA Triton推理服务器,该方案支持API调用、并发处理与GPU资源隔离,适用于会议记录、课程听写及办公场景下的实时语音识别,显著提升本地化AI服务的稳定性与工程落地效率。

weixin_35835030的博客 440

Android车载蓝牙开发全攻略:从基础到高级优化

本文系统介绍了Android车载蓝牙开发的核心技术与实践指南。文章首先阐述了蓝牙在智能汽车中的关键作用,包括免提通话、音频流媒体等应用场景。随后详细解析了蓝牙协议基础,重点介绍了HFP、A2DP等车载常用协议。开发实战部分提供了设备发现、连接、数据传输的完整代码示例,并融入多线程和内存优化技巧。通过真实车载案例,展示了启动时间、流畅度和资源使用的优化策略。最后针对面试需求,提供了专业的技术问答,涵盖蓝牙开发全流程。全文紧密结合Android车载开发职位要求,为开发者提供了一套完整的蓝牙技术解决方案。

郑伟强dev的专栏 118

RK3568笔记十七:LVGL v8.2移植

若该文为原创文章,转载请注明原文出处。本文介绍嵌入式图形库移植到Linux开发板ATK-RK3568上的步骤。

4231

万象视界灵坛部署教程:NVIDIA Triton推理服务器集成CLIP模型

本文介绍了如何在星图GPU平台上自动化部署🔮 万象视界灵坛 | Omni-Vision Sanctuary 🔮镜像,实现基于CLIP模型的多模态智能感知。该平台通过集成NVIDIA Triton推理服务器,可快速搭建图像语义分析环境,应用于游戏化交互界面中的实时视觉语义匹配,提升用户体验和分析效率。

weixin_34438187的博客 296

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

【环境部署】Triton Server GPU推理环境搭建:从nvidia-container-toolkit安装到Docker运行时配置全解析

本文详细解析了Triton Server GPU推理环境的完整搭建流程,从nvidia-container-toolkit安装到Docker运行时配置,解决常见问题如'无法定位软件包'等。通过步骤详解和性能优化建议,帮助开发者高效部署AI推理服务,实现GPU加速。

weixin_42524708的博客 416

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

精通 triton 使用 MLIR 的源码逻辑 - 第001节:triton 的应用简介

OpenAI Triton 是一个开源的编程语言和编译器,旨在简化 GPU 高性能计算(HPC) 的开发,特别是针对深度学习、科学计算等需要高效并行计算的领域。既允许开发者编写高度优化的代码,又不必过度关注底层硬件细节。这样,通过简化高性能计算,可以加速新算法的实现和实验。传统 GPU 编程(如 CUDA)需要深入理解硬件架构和复杂的优化技术,而 Triton 旨在提供更高层次的抽象,降低开发门槛,但是设计 triton 语言及其编译器本身,门槛却非常高。

eloudy的专栏 1198

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

27:【PyTorch】nvidia / triton依赖没装(2.6+版本常见)

本文详细分析2026年PyTorch 2.6+版本中常见的nvidia和triton依赖未安装问题,提供了完整的依赖检查、安装和验证流程。文章包含详细的错误分析、解决方案、自动化工具以及性能对比,帮助开发者快速解决依赖问题,充分发挥PyTorch的性能优势。

欢迎来到智能安全前线!这里是AI与信息安全交汇之地。我们以代码为武器,深入大模型攻防实战,破解系统漏洞。追踪OpenAI、Meta前沿动态,用红蓝对抗思维,锻造智能时代的坚盾与利矛。 634

MogFace-large部署指南:NVIDIA驱动/CUDA/Triton兼容性配置要点

本文介绍了如何在星图GPU平台上自动化部署MogFace人脸检测模型-large镜像,快速搭建高性能人脸检测环境。该平台简化了NVIDIA驱动、CUDA和Triton服务器的兼容性配置流程,用户可轻松部署该模型,并将其应用于图片或视频流中的人脸识别与框选等典型场景,显著提升开发效率。

weixin_29041443的博客 210
上一篇: Nvidia TensorRT系列01-基本介绍
下一篇: Nvidia TensorRT系列01-TensorRT的功能1
肆十二
肆十二 优质创作者: 人工智能技术领域 优质创作者: 人工智能技术领域
博客等级 码龄9年 2万+粉丝 241原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

肆十二

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值