北大联合港中文提出BlobCtrl!高保真元素级生成和编辑统一新框架!

7-1 链式基数排序 (20 分) 7-1 链式基数排序 (20 分) 实现链式基数排序,待排序关键字n满足1≤n≤1000,最大关键字数位≤5。 输入样例: 第一行输入待排序个数n(1≤n≤1000),再输入n个数(n的数位≤5)。 10 278 109 63 930 589 184 505 269 8 83 输出样例: 输出每趟分配-收集后链表中的关键字,趟数为序列中最大值的数位(如样例中930的数位为3),每行结尾有空格。 930 63 83 184 505 278 8 109 589 269 505 8 109 930 63 26 阅读详情

🌐 社群导航

🔗 点击加入➡️【AIGC/LLM/MLLM/3D/自动驾驶】 技术交流群

🔗 点击加入➡️【2-3月CCF投稿】交流群

数源AI 最新论文解读系列

图片

论文名:BlobCtrl: A Unified and Flexible Framework for Element-level Image Generation and Editing

论文链接:https://arxiv.org/pdf/2503.13434

开源代码:https://liyaowei-stu.github.io/project/BlobCtrl/
导读

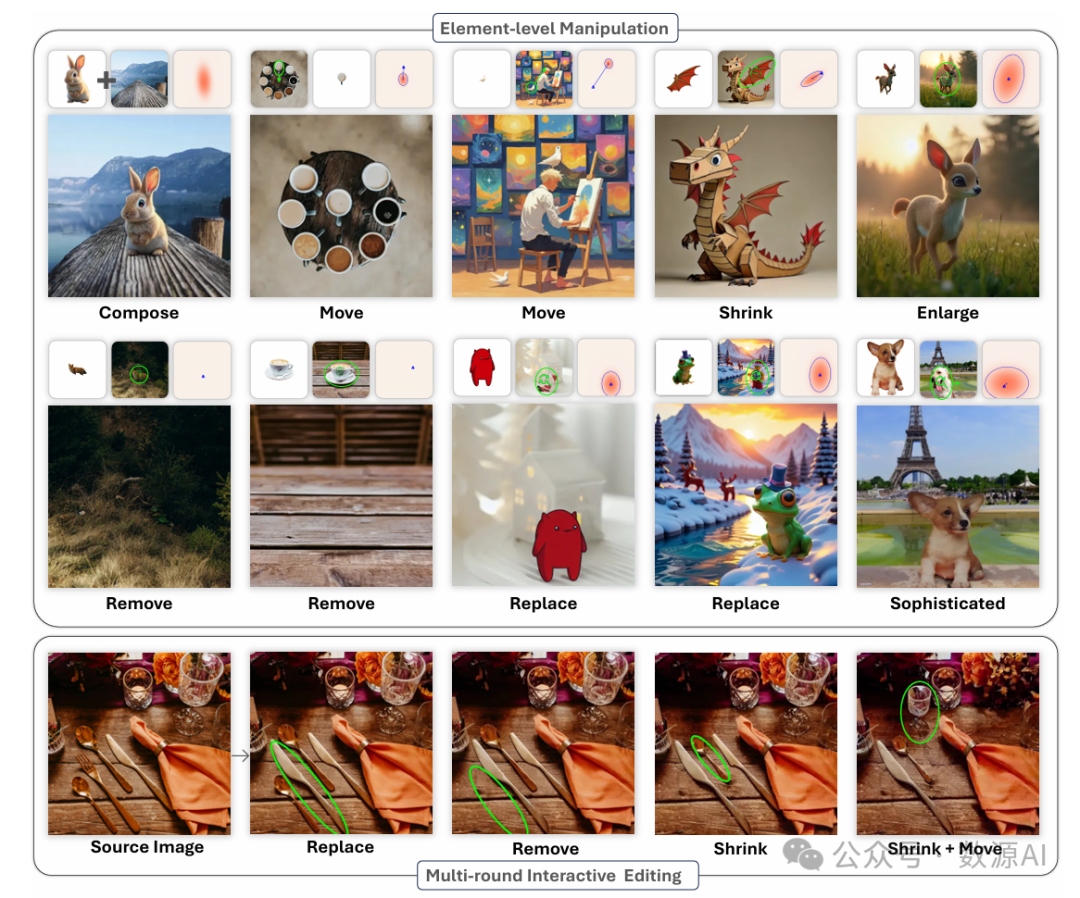
元素级图像操作长期以来一直是数字艺术的目标,像Adobe Photoshop这样的工具能够对视觉元素进行精确操作。虽然最近的人工智能模型在高质量图像合成方面表现出色,但它们往往缺乏对单个元素的细粒度控制,而这正是传统工具的关键特性。像ControlNet和IP - Adapter等进展虽然提高了可控性,但仍然不支持创意工作流程中至关重要的交互式、多轮次、基于元素的操作(例如组合、调整大小、排列)。挑战包括:1)视觉元素的解耦和表示;2)连续的布局控制;3)保留外观和身份;4)保持视觉和谐;5)用于端到端训练的大规模配对训练数据稀缺。

简介

元素级视觉操作在数字内容创作中至关重要,但当前基于扩散模型的方法缺乏传统工具的精度和灵活性。在这项工作中,我们引入了,这是一个使用基于概率团块(blob)表示法来统一元素级生成和编辑的框架。通过将团块用作视觉基元,我们的方法有效地解耦并表示了空间位置、语义内容和身份信息,从而实现了精确的元素级操作。我们的主要贡献包括:1)具有分层特征融合的双分支扩散架构,用于实现前景 - 背景的无缝集成;2)采用定制数据增强和得分函数的自监督训练范式;3)可控的丢弃策略,以平衡保真度和多样性。为了支持进一步的研究,我们引入了用于大规模训练的BlobData和用于系统评估的BlobBench。实验表明,BlobCtrl在各种元素级操作任务中表现出色,同时保持了计算效率,为精确灵活的视觉内容创作提供了一个实用的解决方案。

方法与模型
图片

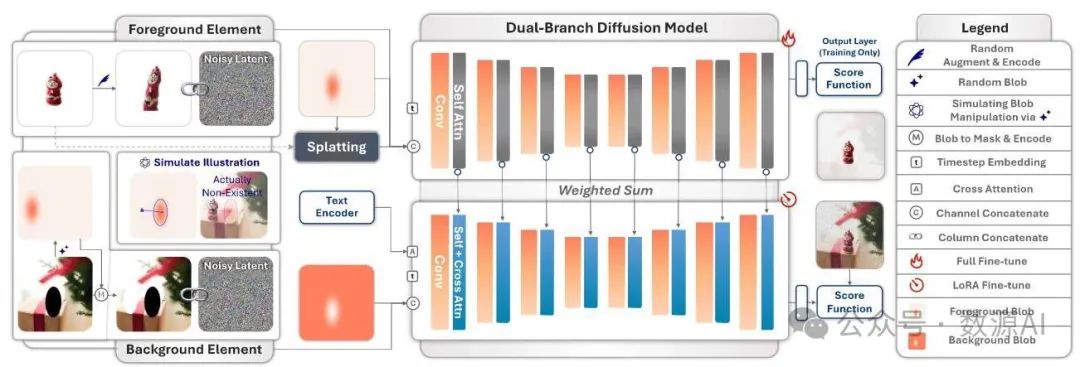
图3:BlobCtrl 概述。我们的框架包括:(1)一个双分支架构,其中前景分支用于元素身份编码,背景分支用于场景上下文保存和协调。两个分支都使用噪声潜变量和参考条件的拼接输入(第3.1节)。(2)一种通过随机位置生成和目标重建优化进行元素级操作的自监督训练范式。通过分支之间的特征融合,我们的框架在保持视觉连贯性的同时实现了对元素的精确控制。

1. 模型架构

我们提出了一种双分支扩散模型,分别处理前景和背景元素。如图3所示,我们的模型主要由两个关键组件组成:

前景分支。前景分支旨在保留前景元素的身份和外观,同时实现灵活的布局控制。如图3所示,我们将噪声潜变量  与参考前景条件  沿列维度拼接,作为前景分支的输入。这种按列拼接策略提高了模型的上下文学习能力,使其能够更有效地掌握和保留元素的特征。参考前景条件  是通过沿通道维度拼接三个关键组件构建的:(1)用于布局信息的不透明度图 ;(2)用于身份保留的空间感知语义特征 ;(3)用于外观编码的变分自编码器(VAE)潜变量 。为了确保  和  按列拼接时的维度兼容性,我们还将  和  沿  的通道维度进行拼接。前景分支的输入构建过程可以正式表示为:

其中  和  分别表示沿通道和列的拼接。

为了处理元素级的前景输入,我们使用了一个经过修改的预训练扩散主干网络,移除了交叉注意力层。这种方法有两个目的:预训练的权重为有效的前景特征处理提供了强大的生成先验,移除交叉注意力层确保模型仅关注视觉内容,而不受更广泛上下文的影响。

背景分支。背景分支作为一个扩散主干网络,旨在保留原始背景,同时将前景元素和谐地融入场景。同样,我们将噪声潜变量  与参考背景条件  沿列维度拼接作为输入,如下所示:

其中背景分支缺乏空间感知语义特征,因为它倾向于完全保留信息。

在元素级编辑中,背景是一个掩码图像,其中前景元素的原始区域和目标区域都被掩码掉。例如,当移动一只鸟时,背景在鸟的初始位置和目标位置都有掩码。

背景分支使用一个带有交叉注意力层的完整扩散主干网络。为了无缝集成前景和背景元素,我们采用分层特征融合方法,在背景分支的多个分辨率级别逐步注入前景特征。我们还使用零初始化(Zhang等人,2023a)  进行稳定训练。第i个块的特征融合公式为:

其中  和  分别是背景分支和前景分支的输入条件, 是特征融合的权重。

2. 自监督训练

虽然不同位置的对象配对数据对于训练来说是理想的,但这种数据非常稀缺。以前的方法(Chen等人,2023;Alzayer等人,2024)依赖于视频数据,但这会引入不必要的复杂性,降低模型性能。

相反,我们提出了一种自监督训练策略,采用的思路是任何图像都可以看作是一个元素操作过程的目标结果。对于每个训练图像,我们确定目标元素的位置,并在不同位置随机生成一个斑点来模拟源位置。这模拟了操作过程,如图3所示,一个玩具似乎从随机的左侧位置移动到了实际的右侧位置。我们在训练过程中使用噪声预测得分函数来优化我们的模型:

其中  是源图像的潜在表示,  是时间步  时的含噪潜在表示。该得分函数促使模型在目标布局处填充前景元素,在原始前景位置修复背景元素,并确保整个场景的和谐融合。

3. 身份保留与场景和谐

随机数据增强。为防止模型默认采用简单的复制粘贴解决方案,我们在训练期间对前景元素进行大量数据增强。这包括颜色抖动、缩放、旋转、擦除和透视变换等随机变换。这些增强有两个主要目的:迫使模型根据指定的布局和外观和谐地放置前景元素,随机擦除培养对不完整元素的强大修复能力。这种方法确保模型学会灵活且根据上下文生成和处理元素,与背景保持视觉连贯性。

身份保留得分函数。为有效分离前景和背景分支——确保前景分支注入元素级信息,而背景分支整合这些元素,我们提出了一种身份保留得分函数。在训练期间,我们保留前景分支中扩散模型的输出层(推理时丢弃),并应用仅在前景元素区域内操作的得分函数。

其中  是指示前景元素区域的前景掩码。这有助于确保准确保留前景元素外观,同时允许在背景整合方面具有灵活性。在训练期间,总体优化目标是:

其中  是控制身份保留权重的超参数。我们在训练期间将  从 1.0 逐渐衰减到 0.6,这鼓励模型在训练后期更多地关注场景和谐,同时仍保持合理的身份保留。

4. 可控的保真度 - 多样性权衡

为了在外观保真度和创意多样性之间实现灵活控制,我们在训练期间实施随机丢弃策略。首先,我们随机丢弃前景分支的权重,使模型能够在基于全局文本信息自由生成前景元素和严格保留给定的前景身份之间进行调整。其次,我们随机丢弃要散布的语义特征和前景元素的变分自编码器(VAE)特征,从而灵活控制语义和外观之间的平衡。具体来说,我们应用:

其中  是指示函数, 是均匀随机变量, 分别是分支权重、语义特征和 VAE 特征的丢弃概率。

实验与结果

1. 数据集、基准和指标

BlobData 整理。为了训练 BlobCtrl,我们构建了 Blob - Data(186 万个样本),其来源是 BrushData,包含图像、分割掩码、拟合椭圆参数(带有导出的二维高斯分布)和描述性文本。数据集整理过程包括:(1)过滤源图像,保留短边超过 480 像素且具有有效实例分割掩码的图像。(2)应用掩码过滤标准,保留面积比占图像总面积 0.01 到 0.9 之间的掩码,并排除位于图像

BlobCtrl:用于元素级图像生成和编辑的统一灵活框架边界的掩码。(3)对于过滤后的掩码,拟合椭圆参数  并导出二维高斯分布。(4)去除无效样本,特别是协方差值低于 1e - 5 的样本。(5)使用 InternVL - 2.5(Chen 等人,2024)生成详细的图像描述。

BlobBench数据集整理。现有的评估基准,如DreamBooth(Ruiz等人,2023年)、COCOE(Yang等人,2023年)、COCO Val(Lin等人,2014年)和CreatiLayout(Zhang等人,2024a),要么评估定位能力,要么评估身份保留能力,但不能同时评估两者。它们也没有涵盖元素级操作的所有范围,如组合、移动、调整大小、删除和替换。为了弥补这些不足,我们引入了BlobBench,这是一个包含100张精心挑选图像的综合基准,这些图像均匀分布在不同的元素级操作中。每张图像都由专家标注了椭圆参数、前景掩码和详细的文本描述。BlobBench包括来自不同场景(如室内和室外场景、动物和风景)的真实世界图像和人工智能生成的图像,确保了评估的公平性和有效性。

评估指标

我们使用客观指标和人工评估来评估,包括客观评估(身份保留、定位准确性、生成质量和协调性)和主观评估。有关这些指标的详细信息,请参阅附录A。

2. 实现细节

训练细节。BlobCtrl基于Stable Diffusion v1.5(Rombach等人,2022年)构建。在训练期间,所有图像和注释都被调整为像素。我们使用预训练的UNet权重初始化前景和背景分支。前景分支在移除交叉注意力层的情况下进行全量微调,而背景分支使用LoRA(Hu等人,2021年)进行微调,秩为64。我们使用Adam优化器(Kingma & Ba,2014年),学习率为1e - 5,权重衰减为0.01。该模型在我们精心整理的Blob - Data数据集上进行训练,该数据集包含个样本,使用24块NVIDIA V100 GPU,批量大小为192,训练7天。为了实现可控的保真度 - 多样性权衡,我们将丢弃概率设置为0.1。在训练过程中,身份保留损失的权重从1.0逐渐衰减到0.6。此外,为了在推理过程中实现无分类器引导,我们将字幕丢弃概率设置为0.1。

评估细节。我们在BlobBench基准上,将BlobCtrl与三种最先进的方法进行了比较:Gli - Gen(Li等人,2023年),一种基于边界框的文本到图像模型;Anydoor(Chen等人,2023年),一种基于分割掩码的图像到图像模型;以及Magic Fixup(Chen等人,2023年),该方法专门用于协调变换区域。为了系统地评估五种基本的元素级操作(组合、移动、调整大小、替换和移除),我们为基线方法适配了特定的工作流程。对于Anydoor,我们通过将背景传送到前景区域来创建干净的背景,然后通过将前景对象传送到目标位置进行编辑。对于GliGen,我们使用BlobCtrl移除元素以获得干净的背景,然后应用带有文本和图像条件的边界框约束。对于Magic Fixup,我们使用编辑操作中的刚性变换对前景元素进行变形,然后进行场景协调。

3. 定量评估

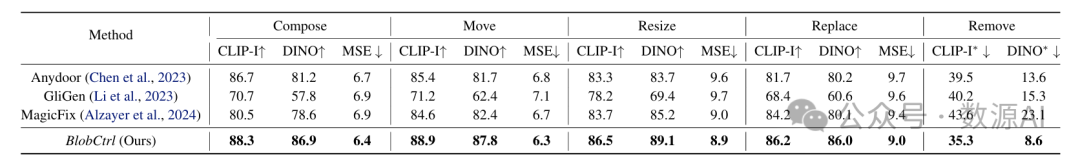
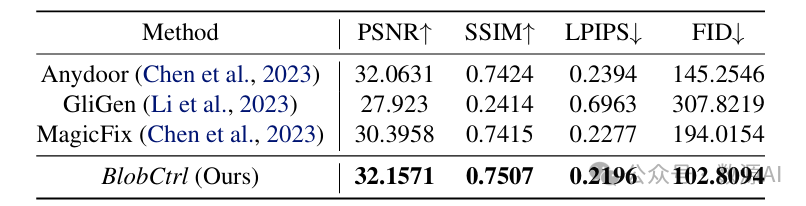
与最先进方法的比较。如表1和表2所示,BlobCtrl在所有评估指标上都比现有方法有持续且显著的改进:

  • 身份保留:对于需要身份保留的任务(组合、移动、调整大小、替换),与最佳基线相比,BlobCtrl的平均CLIP - I得分(87.48对84.28)和DINO得分(87.45对81.70)显著更高。对于移除任务,我们的方法显示出更低的身份得分(CLIP - I和DINO的平均得分)(21.95对26.55),表明元素消除更彻底。
图片

图片

4. 定性评估

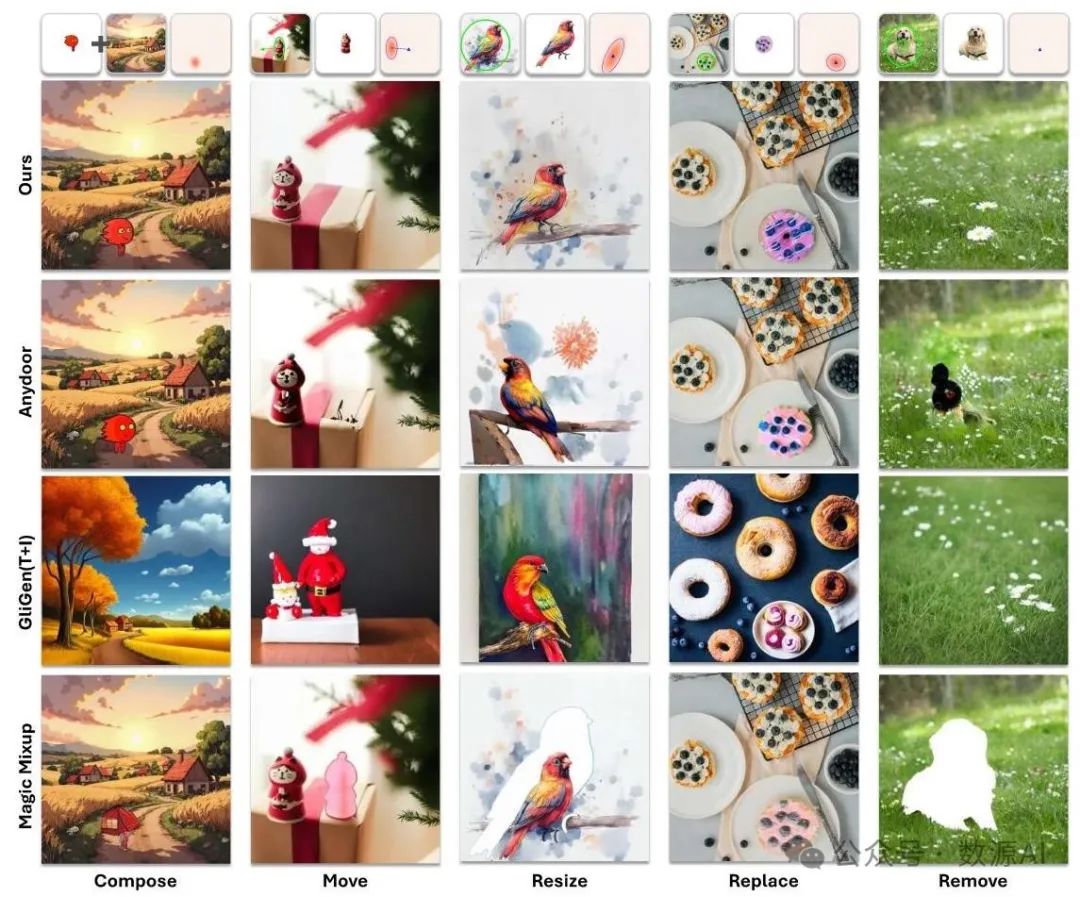
图4展示了BlobCtrl与最先进方法在各种元素级操作场景下的定性比较。结果显示了我们方法的几个关键优势:
图片

图4:不同方法在元素级操作能力上的可视化比较。我们评估了五项基本操作:组合、移动、调整大小、替换和移除。Anydoor(Chen等人,2023年)在精确保留元素身份方面存在困难,GliGen(Li等人,2023年)无法保留任何身份信息,而Magic Fixup(Chen等人,2023年)生成的结果在视觉协调性方面较差。相比之下,BlobCtrl在所有操作中都取得了卓越的效果,同时既保留了元素身份又实现了视觉和谐。我们建议放大查看源图像和元素级操作说明的细节。

  • Anydoor(Chen等人,2023年)在元素操作过程中难以准确保留元素身份,并且在元素级移除方面存在局限性,常常会留下伪影或修改不完整。

  • 虽然GliGen(Li等人,2023年)具备布局控制能力,但它无法有效保留被操作元素的视觉外观和身份,导致输出结果不一致。

  • Magic Mixup(Alzayer等人,2024年)的协调能力不足,导致修改后的元素与其周围环境在视觉上不一致。

相比之下,BlobCtrl在各个方面都表现出卓越的性能——对不同场景有更好的泛化能力、更准确的身份保留以及在保持视觉连贯性的同时进行精确的布局控制。

5. 消融研究

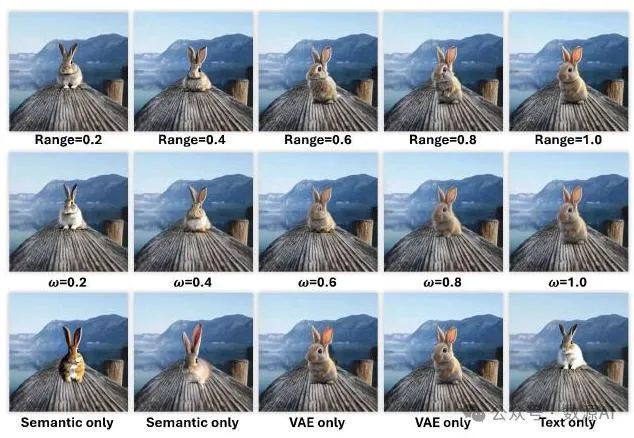
可控性和灵活性分析 如图5所示,BlobCtrl通过调整双分支融合的控制时间步长间隔和控制强度,实现了对身份保留和多样性之间权衡的灵活控制。当仅使用带有文本提示的背景分支时,身份保留和布局准确性都会受到影响。最佳结果来自于结合空间感知语义特征和变分自编码器(VAE)特征。

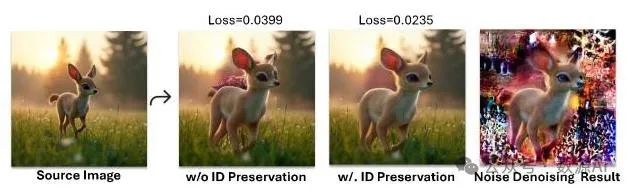
身份保留得分函数的消融实验。我们进行了一项消融研究,以分析我们的身份保留得分函数的有效性。如图6所示,在相同的训练步骤下,使用身份保留得分函数的模型的噪声预测损失(0.0235)明显低于未使用该函数的模型(0.0399),这表明其收敛速度更快。为了更好地理解该得分函数如何影响生成过程,我们使用前景分支的预测噪声对去噪结果进行了可视化。
图片

图5:灵活控制。我们的双分支融合机制通过调整控制时间步长间隔和融合强度,实现了对多样性和外观保留之间权衡的灵活控制。此外,特征丢弃机制为控制生成过程提供了更灵活的接口。

可视化结果显示,当受到身份保留得分函数的引导时,前景分支能够有效地专注于生成前景内容,这验证了我们通过该机制将前景和背景元素生成解耦的设计选择。
图片

图6:身份保留得分函数的消融实验。对一只鹿进行缩放操作时的训练损失和去噪可视化,展示了身份保留得分函数如何在元素级操作过程中实现更快的收敛和有效的前景 - 背景解耦。

结论

本研究引入了BlobCtrl,这是一个统一的框架,它使用基于概率斑点(blob)的表示方法集成了元素级生成和编辑功能。斑点作为视觉基元,用于编码空间布局、语义和身份信息,从而实现精确的元素操作。采用自监督训练的双分支架构能够保留前景元素的身份信息并保持背景的协调性。随机数据增强和丢弃策略可在外观保真度和创意多样性之间实现灵活控制。在BlobBench上进行的大量实验表明,BlobCtrl在元素级操作任务中达到了当前的最优性能。

记录Rancher集群中coredns问题导致的服务DNS解析超时 coredns问题处理 阅读详情

相关推荐

lumerical-环形谐振器

利用mode求解器优化得到所需的环的总长度,即环形器的半径,然后通过varFDTD得到光场分布和透过率.

m0_61776728的博客 2189

3D ACIS Modeler 在测量软件里怎么用?几何查询、区域判断与测点布点

本文面向测量软件开发团队,梳理 CAD 模型导入三坐标测量软件后的几何判断工作:如何借助 3D ACIS Modeler 完成模型对象访问、测量区域判断与空间关系分析,并结合 LK Metrology CAMIO 官方案例说明内核与应用的分工,最后给出自研与引入内核的评估思路。

HuiduCADTech的博客 326

1.2 重叠因子:双重指数移动平均(Double Exponential Moving Average, DEMA)概念与Python实战

双重指数移动平均(Double Exponential Moving Average, DEMA)是一种改进的移动平均线指标,由Patrick Mulloy在1994年开发。相比传统的指数移动平均线(EMA),DEMA通过减少滞后性来提供更快的市场反应。它通过两次计算EMA并进行特殊组合来实现这一目标,可以在保持平滑性的同时减少滞后。

Kewin的博客 2168

3D CAD参数化建模原理详解:尺寸参数、几何约束与特征关系

3DCAD参数化建模通过尺寸参数、几何约束与特征依赖关系,将设计意图融入模型,实现自动更新。其核心在于明确变量关联、合理设置约束、理顺特征逻辑。修改时,系统依规则重算几何,但需防范约束冲突、依赖失效等问题。提升可维护性需规划关键参数、优化建模结构,并验证多场景适用性。大腾智能ZCAD以自主内核与智能交互支持高效参数化设计,兼顾传统建模与同步修改需求,助力系列化开发与持续迭代。

大腾智能的博客 315

基于PlatformIO与CMSIS的STM32库函数开发实战:从环境搭建到外设驱动

本文详细介绍了基于PlatformIO与CMSIS的STM32库函数开发实战,从环境搭建到外设驱动实现。通过对比传统IDE,PlatformIO结合CMSIS框架在跨平台开发、代码可移植性和调试体验上更具优势。文章包含PlatformIO.ini配置详解、GPIO/USART驱动开发实例及常见问题解决方案,帮助开发者高效完成STM32项目开发。

weixin_29190169的博客 423

离心泵级间导叶的设计计算

离心泵级间导叶的设计计算高速离心泵级间流道的作用是将第一级复合叶轮流出的高速液流收集起来并送入第二级复合叶轮。级间流道的设计应考虑降低液体的流速,实现动能向压力能转化,减小液体的水力损失。级间流道主要有蜗壳形流道和导叶两种结构形...

cqzc55322的博客 2566

AI时代,Delft3D如何打通标量输运、波浪、粒子与溢油模拟

学完不仅能独立完成模型构建、参数设置和结果分析,还能真正掌握从“建模型”到“用模型解决实际问题”的完整方法。做 Delft3D 模拟,最难的不是“会点软件”,而是理论如何落地、参数如何设置、案例如何跑通,以及模型结果如何真正用于科研和项目。既适合零基础入门,也适合已有水动力基础、想进一步提升应用能力的科研人员、研究生及水文、水环境、海洋、水利、环评等领域技术工作者。1.拉格朗日粒子模型理论2.拉格朗日粒子法的适用情况3.拉格朗日粒子法的参数4.波浪模型后处理。这门课从基础到进阶,一次打通。

weixin_56135535的博客 175

西门子1200与FANUC机器人Profinet通讯

近期在做发那科FANUC的通讯,会吧CC-LINK、Profibus-DP、Profinet I/O、DeviceNet、EtherNet/IP这些常用通讯做成文档发上来,大家喜欢的话可以关注 注:做对应的通讯,在机器人控制柜都需要安装对应的板卡以及软件功能 PLC项目已经归档,只需要恢复就可以看到。对应Profinet通讯的GSD文件也都在博文最后有连接 机器人柜子:R-30IB Mate 机器人主体:M-10IA 12 一、硬件介绍 机器人Profinet I/O通讯板卡:...

七兔自习室 2万+

虚拟仿真实训基地的技术实现路径:从3D采集、资源库到仿真平台的完整链路

本文提出“五段式”虚拟仿真实训链路——采集、建模、资源、平台、展示,破解职业教育实训资源持续产出难题。通过设备选型、AI建模、统一管理与过程留痕,实现教学资源标准化、可复用、可更新。强调元数据规范、轻量化处理与验收指标,避免“只采不建”“仿真脱节”等五大工程陷阱,确保基地长效运行,支撑岗位技能对接与教学改革。

Jmyd0123的博客 328

32、社交媒体大数据中的情感分析与网络欺凌检测

本文探讨了社交媒体大数据在情感分析和网络欺凌检测中的应用。情感分析有助于应对自动化带来的社会变化、促进社会包容和推动环境保护。网络欺凌作为一种严重的在线危害,其检测依赖于数据预处理、特征提取与深度学习模型(如CNN、LSTM)进行分类。文章还总结了大数据在欺诈检测、医疗、制造、交通等领域的广泛应用,并分析了数据存储、处理速度、质量和技术工具等方面的挑战,提出了相应的应对策略。未来,随着技术进步,社交媒体大数据将在更多领域发挥关键作用。

cc789的博客 91

AE 与 ISP 参数联动机制解析:自动曝光系统与图像信号处理模块协同设计实践

AE(自动曝光)并不是一个独立的图像控制模块,而是与 ISP(Image Signal Processor)深度耦合运作的系统协同体。其输出的曝光参数直接决定了图像处理链路中 Gamma 曲线选择、黑电平补偿、去噪级别、边缘增强等一系列关键参数的取值。本文基于主流平台(如高通、MTK、海思)的工程实战经验,详细剖析 AE 与 ISP 在曝光驱动、调节优先级、图像还原逻辑等环节的联动机制,并结合拍照与视频等不同场景,给出可落地的联调方法。

努力分享一些人工智能、计算机视觉、影像等相关的知识干货! 1528

【测评】SenseNova6.8Flash模型正式发布,支持动态 PPT 及 3D 设计

SenseNova 6.8 Flash将设计生成拓展至多种创作形态,支持Web、SVG、Three.js、Blender、PPT等形式,满足多样化的AI Native Design需求,并支持动态PPT、动态Poster与Agentic 3D设计。同时,模型可接入Figma等专业工作流,帮助用户将AI设计能力融入现有的专业设计流程。此外,模型还支持三维场景与交互内容创作,可综合处理空间布局、材质与光照、镜头控制及动画编排等因素,构建可在网页中实时渲染的三维内容,拓展从立体视觉展示到动态交互的表达方式。

Enweitech Software Works 331

Oracle EBS FA 如何打开关闭的资产会计期间?

用户“运行折旧”,误勾选为“关闭期间”,还有一部分资产还需要操作报废和调整,希望后台打开关闭的资产会计期。

陈显平的专栏-Oracle EBS 1029

船舶安全培训怎么用AI生成3D预演?从甲板通道、设备热点到网页回放

船舶甲板能够漫游,不等于培训内容可信。本文梳理从培训任务、资料台账、空间白模到设备热点、步骤关联和网页交付的制作流程,说明如何用稳定设备 ID 追溯来源,通过三轮审核核对技术、课程与网页表现,并提供弱网图文回退和上线清单。AI 适合辅助场景与交互原型,不能替代专业审核、上船实训或正式安全程序。

Solange__的博客 548

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

DEM 数据源选型完全指南:SRTM、ASTER GDEM、ALOS AW3D30 与商业高分辨率的工程级对比

本文回答一个工程选型问题:SRTM、ASTER GDEM、ALOS AW3D30 和商业高分辨率 DEM 怎么选。核心结论:先确认数据表达的是裸地还是含地物表面,再确认垂直基准,最后才看分辨率。格网再细,表面层错了或基准没对齐,断面和汇水结果仍然不可用。

TuxinyunGIS的博客 288

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

项目选型 3D 相机推荐|自动化项目落地全流程选型指南

项目选型和单纯产品选型最大区别:所有参数都要服务于产线工艺目标,优先锁定 5 个基础边界条件,这是筛选相机的前置条件,也是很多项目踩坑的源头。项目选型 3D 相机,核心不是选出参数最好的硬件,而是选出适配项目工况、可控风险、可按时验收、运维成本可控的整套视觉方案。对于自动化系统集成商来说,优先选择拥有自研光学、算法、标定工具链,并且具备大量量产项目沉淀的国产 3D 视觉厂商,能够有效降低方案设计、现场调试、项目交付的不确定性。

加搜科技观察 115

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

百炼 CLI 生成物流主题 3D 视觉概念图教程:一个关键词出主视角/鸟瞰/特写/风格变体一套图,含默认开关与水印坑实测

做物流投标配图、方案配图的人经常遇到同一个需求:手里只有一个关键词,交付物却是一整套 3D 视觉概念图。本文以「无人仓储中心」为例,用百炼命令行的两条命令搭一条两段式生图链路,一个关键词产出主视角、鸟瞰、设备特写与风格变体成套图,并把四条可选路线的等待时间、画面文字注入情况和成套一致性一次测完,给出可直接抄的接法与参数。

weixin_43540568的博客 83

机器视觉 3D 相机与机器人引导全解析:四大成像原理、手眼标定与七步落地流程

3D 视觉的精度上限,80% 取决于。

2501_94699871的博客 193

从CAD装配模型到3D装配动画:模型复用与工艺步序设计

本文阐述了从三维CAD模型生成装配动画的关键流程,涵盖模型准备、结构确认、工艺步序定义、动画表达与资料输出五大环节。指出传统方法存在重复整理、工艺脱节等问题,提出通过“3D工艺大师”等工具实现模型复用与工艺步序驱动,由工艺人员直接定义装配逻辑,自动生成动画并协同输出工艺文件,提升效率与准确性,真正实现设计数据向生产指导的无缝转化。

大腾智能的博客 633

把带贴图的 OBJ / glTF 转成 3D Tiles:我写了个 mesh-to-tiles

做倾斜摄影或单体模型上 Cesium 时,经常卡在同一件事:手上是一份带贴图的 OBJ 或 glTF,场景里要的是 3D Tiles。现成工具能转,但 LOD、图集和纹理压缩往往要再串一圈。我把这条链路收成了一个 Node 命令行工具,输入网格,输出 3D Tiles 1.1 隐式八叉树。,协议 MIT。

m0_69250830的博客 192

连锁门店方案怎么用AI生成3D预演?从需求表、空间白模到网页评审

连锁门店如何用 AI 辅助比较布局,并让品牌、运营与设计团队在线评审?本文从需求表和场地底稿出发,介绍双尺寸核对、区域与设备编号、固定观察点,以及从审核母版派生网页轻量版的方法,并通过品牌运营、空间资料、网页权限三轮审核保持版本对应。AI 用于生成候选与辅助表达,网页用于沟通方案,两者都不能替代现场测量、专业设计及工程审核。

Solange__的博客 452

微缩场景怎么用AI生成3D?单图、分件参考还是布局草图,按4层输入减少返工

一张港口概念图能说明场景气氛,却未必交代道路、高差、建筑背面和对象边界。本文按整体构图、空间布局、对象分件、尺寸与交付四层整理 AI 生成 3D 场景的输入,比较主图、布局草图和分件参考各自的作用与局限,并提供三轮试跑方法和可复制输入卡。生成后通过检查背面、量测尺寸、单独移动房屋及重新导入目标软件,判断候选是否满足后续编辑要求。

Solange__的博客 438

3D Forward Simulation of TMI Data:三维总磁场强度正演入门

本文面向初学者,基于SimPEG教程介绍三维磁法正演模拟。通过构建含球体的地下磁化率模型,结合地形与地磁场,预测地表17×17个测点的总磁场强度异常(TMI)。重点讲解磁化率、诱导磁化、TMI测量原理及三维积分正演机制,演示如何使用TensorMesh、active_cells和Simulation3DIntegral实现正演计算。代码可复现地形图、磁化率剖面与TMI异常图,并支持导出合成数据。实验建议调整磁化率、飞行高度、倾角等参数,理解其对异常形态的影响。强调磁异常非唯一性,需结合地质约束。适用于磁测设

m0_57685225的博客 360

影视场景怎么用AI生成3D镜头预演?从概念图、场景白模到网页审片

概念图有氛围,不代表能直接用于镜头预演。本文围绕剧本拆镜、资料与尺度假设、场景白模、机位走位、动作节拍和网页审片,介绍 AI 生成 3D 场景的预演流程。通过稳定对象与相机编号、统一镜头表、意见关联版本和三轮审核,让讨论落到具体镜头,同时明确白模与网页预演不能替代真实场地勘景及现场安全判断。

Solange__的博客 540

YaksueEngine(3)3D空间三角形

把三角形平放在 3D 场景里,顶点坐标变成世界空间的坐标; 实现鼠标控制的相机,可以围绕三角形旋转、平移、缩放。

主要记录了工作之余胡乱学习的知识,大部分是入门级别的内容。 主要是为了自己未来有用到时能快速上手,相当于是个备忘录。 当然,也很开心其他人可以从中找到对自己有用的信息。^_^ 359

3D虚拟展厅的埋点与成本归集,投入产出表该怎么建?

2026年3D虚拟展厅投入产出评估的核心在于数据对齐,而非公式复杂度。关键路径为:先构建四层事件模型(会话、空间、展项、转化),统一用session_id与lead_id双键打通行为数据;再将CAPEX、OPEX、内容迭代、投放四类成本科目逐笔归集至统一project_code;最后通过按天调度的ETL链路,实现季度对账。分子取去重有效线索数,分母为四类成本合计。需严控首屏1.8秒、移动端30fps、面数分级预算,并分40人持续负载与2000人瞬时峰值两类压测。技术落地依赖事件级SDK、数据导出接口与私有化

Jmyd0123的博客 377
上一篇: 谷歌提出新方法UniFluid!视觉生成和理解统一自回归框架!
下一篇: 苹果提出UniVG:首个统一扩散模型!单一权重覆盖7大图像生成任务,性能竟超专项模型!
DataSourceAI
博客等级 码龄3年 470粉丝 62原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值