
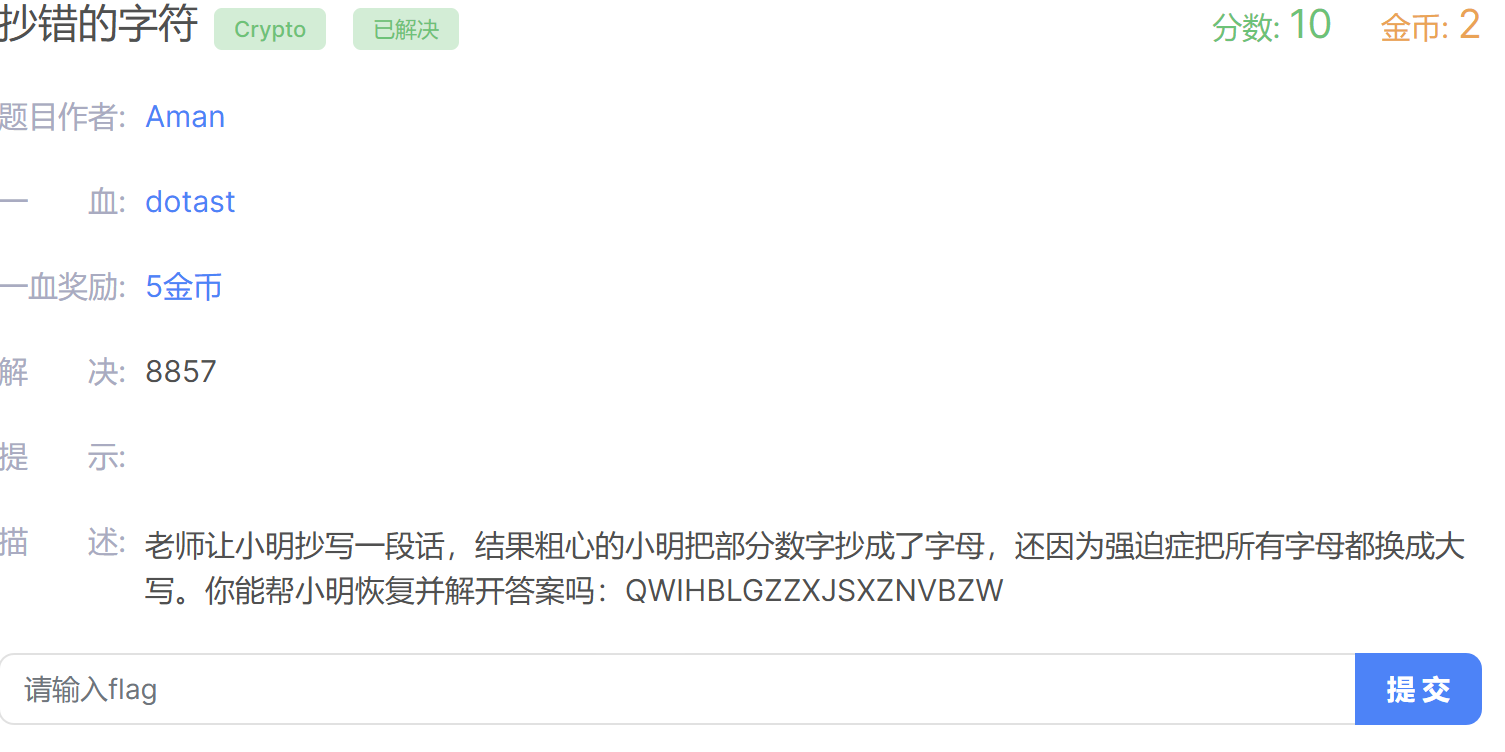
抄错的字符 bugku

【Crypto】BUGKU-抄错的字符 提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 【Crypto】BUGKU-抄错的字符BUGKU-抄错的字符一、解题思路&&考察内容二、在线工具1.多功能加解密工具:2.十六进制解码总结: BUGKU-抄错的字符 题目描述 一、解题思路&&考察内容 解题思路: 1.观察猜测:有可能是 I–>1,G(g)–>9,z–>5,猜测是QW1hbl92ZXJ5X2Nvb2w 2.符合base64的特征:Base64 含有a-z、A-Z、0-9 阅读详情
AI摘要

该博客围绕CTF题目‘抄错的字符’展开,整体思路是先进行初步的base64解码并导出结果,接着识别有意义的英文单词,再依据结构用正则表达式定位。经过一系列筛选和匹配,最终得到有效数据并提交,得出答案flag{Aman_very_cool}。

QWIHBLGZZXJSXZNVBZW

题目如上

整体思路:

用随波逐流解码,base64是最接近的,有数字有大小写字母
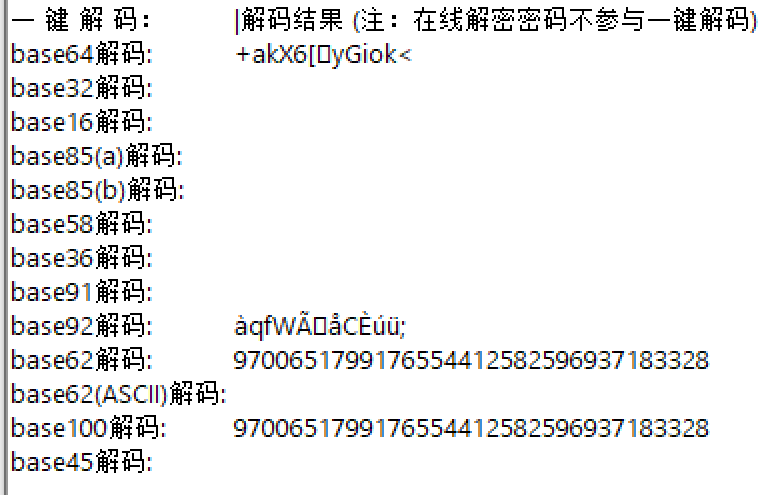
每个字符找到可能的小写、长得像的数字,然后全部重新排列组和,再用base64解码(原字符串为19位,补个=)。解码后判断该字符串是否为有意义的英文单词。

将以上思路告诉deepseek,形成python代码。

第一步:初步解码

将base64解码后的结果导出为文件(后面修改代码就不需要重新跑生成过程了)

import itertools
import base64


cipher = 'QWIHBLGZZXJSXZNVBZW='
dic = {
    'Q': ['Q', 'q', '9'],
    'W': ['w', 'W'],
    'I': ['I', 'i', '1'],
    'H': ['H', 'h'],
    'B': ['B', 'b', '8'],
    'L': ['L', 'l', '1'],
    'G': ['G', 'g', '9'],
    'Z': ['Z', 'z', '2'],
    'X': ['X', 'x'],
    'J': ['J', 'j'],
    'S': ['S', 's', '5'],
    'N': ['N', 'n'],
    'V': ['V', 'v'],
    '=': ['=']
}

combine = []
file_path = "./output.txt"

# 打开文件(追加模式),确保文件关闭由 with 管理
with open(file_path, 'a', encoding='utf-8') as f:
    # 遍历所有可能的组合
    for possible in itertools.product(*[dic[char] for char in cipher]):
        possible_str = ''.join(possible)  # 组合成字符串
        
        try:
            # 尝试 Base64 解码
            decoded_bytes = base64.b64decode(possible_str)
            decoded_str = decoded_bytes.decode('utf-8')  # 转换成字符串
            
            # 存入 combine
            combine.append(decoded_str)
            print("存入" + decoded_str)
            
            # 立即追加写入文件
            f.write(decoded_str + '\n')  # 每个字符串后加换行符
            f.flush()  # 确保立即写入磁盘(可选)
            
        except (base64.binascii.Error, UnicodeDecodeError):
            # 如果解码失败(非法 Base64 或非 UTF-8 编码),跳过
            continue

第二步:识别有意义的英文单词

import enchant
import re

def filter_lines_with_english_words(input_file, output_file):
    # 初始化英文词典
    d = enchant.Dict("en_US")
    
    # 统计变量
    total_count = 0
    valid_count = 0
    
    # 打开输入文件和输出文件
    with open(input_file, 'r', encoding='utf-8') as infile, \
         open(output_file, 'w', encoding='utf-8') as outfile:
        
        for line in infile:
            total_count += 1
            line = line.strip()
            
            # 跳过空行
            if not line:
                continue
                
            # 检查行中是否包含有效英文单词
            contains_valid = False
            # 使用正则表达式分割出可能的单词
            for word in re.findall(r"[a-zA-Z']+", line):
                if len(word) > 1 and d.check(word):  # 忽略单字母"单词"
                    contains_valid = True
                    break
            
            if contains_valid:
                outfile.write(line + '\n')
                valid_count += 1
                print(f"'{line}': 包含有效英文单词 → 已写入{output_file}")
            else:
                print(f"'{line}': 不包含有效英文单词")
    
    # 输出统计信息
    print(f"\n处理完成!共检查 {total_count} 行,其中 {valid_count} 行包含有效英文单词")
    print(f"结果已保存到: {output_file}")

# 使用示例
input_file = "output.txt"      # 输入文件路径
output_file = "vaild.txt"    # 输出文件路径

filter_lines_with_english_words(input_file, output_file)

第三步:根据结构找共同点,用正则表达式定位

可能存在有意义单词的字符串长这样,得到25000+的数据
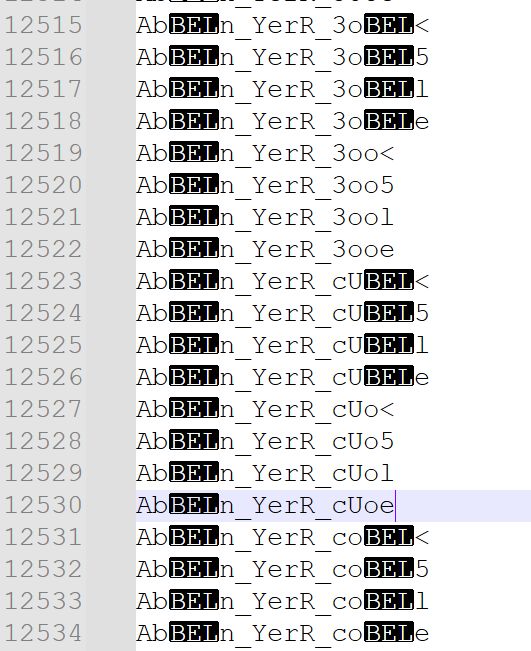
可以看到还不太正常,这时候需要进一步整理,筛选只由字母和下划线构成的字符串

import re

def is_all_alpha_substrings(line):
    """检查一行是否满足:被下划线分隔的所有子串都是纯字母"""
    line = line.strip()
    if not line:  # 跳过空行
        return False
    
    # 使用下划线作为分隔符
    substrings = re.split(r'_+', line)  # 匹配一个或多个连续下划线
    
    # 检查每个子串是否都是纯字母(长度至少1)
    return all(sub.isalpha() and len(sub) >= 1 for sub in substrings if sub)

def filter_lines(input_file, output_file):
    """过滤文件内容,将符合条件的行写入新文件"""
    with open(input_file, 'r', encoding='utf-8', errors='replace') as infile, \
         open(output_file, 'w', encoding='utf-8') as outfile:
        
        total = passed = 0
        for line in infile:
            total += 1
            if is_all_alpha_substrings(line):
                outfile.write(line)
                passed += 1
                print(f"保留: {line.strip()!r}")  # !r显示原始格式
            else:
                print(f"过滤: {line.strip()!r}")
    
        print(f"\n处理完成!共处理 {total} 行,保留 {passed} 行")
        print(f"结果已保存到: {output_file}")

# 使用示例
filter_lines("vaild.txt", "words.txt")

最终得到240条有效数据

合理推断,可能是 xx_very_cool 的组合,用notepad++正则表达式匹配并复制高亮文本,得到结果
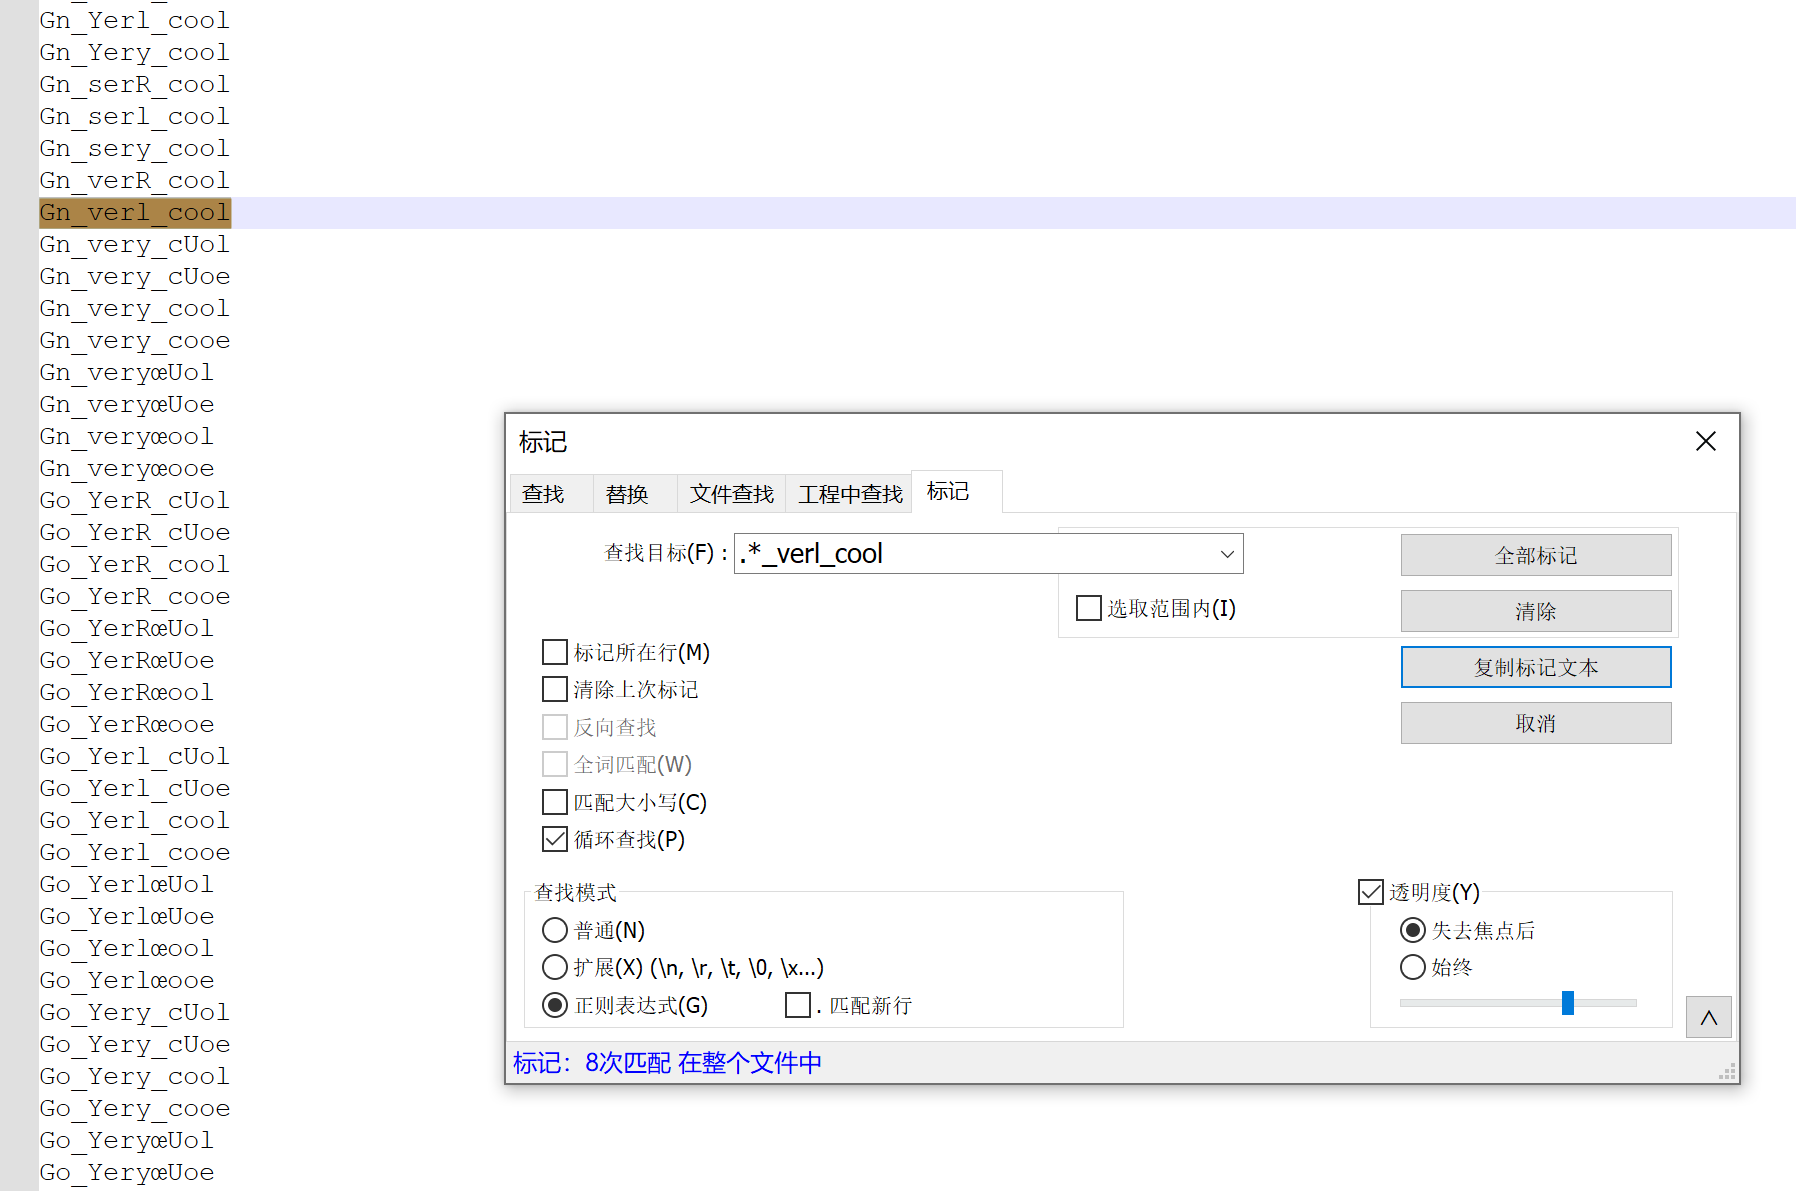
最终得到8条有效数据,挨个提交
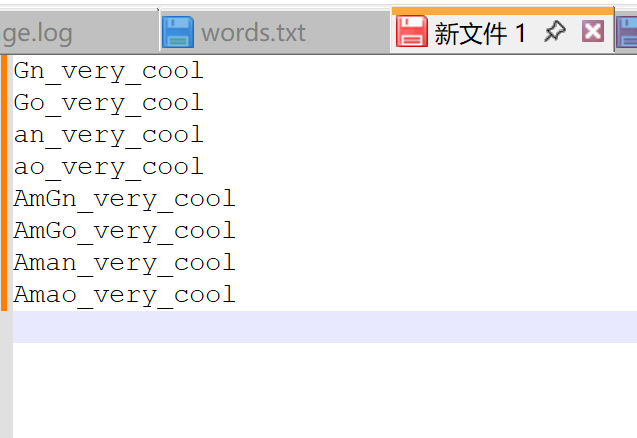
最终答案

flag{Aman_very_cool}

Bugku CTF 密码学刷题 Bugku CTF 密码学刷题前言一、抄错的字符二、/.-三、聪明的小羊四、ok五、[+-<>]六、把猪困在猪圈里七、你喜欢下棋吗八、小山丘的秘密九、EN-气泡十、你以为是md5吗十一、Math&English十二、easy_crypto十三、黄道十二官十四、一段新闻十五、7+1+0十六、这是个盲兔子,竟然在唱歌!总结 前言           密码学可以分为古典密码学和现代密码学。古典 阅读详情

相关推荐

CTF BugKu平台——Crypto篇刷题记录(后续更新)_抄错的字符 ctf

前言 记录一下密码学的刷题记录 也是为了更好的巩固自己 基本有的解码 都附有超链接 希望大家能顺利通关 感谢观看!描述: 老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW解码网站:http://www.hiencode.com/railfence.html 解码网站:https://www.splitbrain.org/services/ook解码网站:http://www.hiencode.com

2401_87204876的博客 1776

bugku-writeup-Crypto-抄错的字符

“使用一种简单的思路解决的。” 题目:抄错的字符

dark的博客 3436

OpenVPN 新增 windows 客户端

虚拟私人网络(Virtual Private Network,简称VPN)是一种网络技术,它允许用户通过公共网络(如互联网)建立一个安全的连接通道。本文介绍如何添加 windows 客户端。

利昂的技术存档 3781

BugKu 抄错的字符

1.QWIH的一系列小写,大写字母和数字进行转换,可以确定QW1h是正确的。③密文有数字,字母,可使用base64试一试。(四个四个组合,最后可加一个=)可能有1->I,6->b,0->g,2->z,5->s。②有小写字母被换成大写字母。(有一种可能是一开始全是小写字母(概率比较小))得到的flag值为flag{Aman_very_cool}3.ZXJS经过转换,得到ZXJS,ZXJ5。4.XZNV经过转换,得到X2NV,X2Nv。2.BLGZ经过转换,得到bl92。5.BZW=经过转换,得到b2w=...

m0_57463864的博客 1636

CVPR 2027 投稿规划:基于近3年录用率与截稿周期的5步时间管理法

本文为计算机视觉研究者提供CVPR 2027投稿的完整规划指南,基于近三年录用率与截稿周期数据,提出五步时间管理法。涵盖选题策略、实验设计、论文写作、同行评审到最终提交的全流程优化,特别针对CVPR日益激烈的竞争环境(2024年投稿量达11532篇,录取率仅23.6%)提供实用解决方案,帮助研究者提升投稿成功率。

weixin_34079177的博客 1186

Acgis中实现栅格经纬度和行政区关联

目前已有意大利的shp文件,希望将意大利划分成0.1*0.1经纬度的栅格,并且关联每个栅格中心点所属的省份信息。最终希望得到的输出是一个表格,里面包含栅格的经纬度、所属省份信息。

qq_42183184的博客 3369

Bugku CTF——抄错的字符

老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW。题外话:猜测真正的密文有点费时间,所以咱还是老实写编程暴力破解吧.....1.由描述可知,原来的密文是由数字、小写字母、大写字母组成。真正的密文:QW1hbl92ZXJ5X2Nvb2w=错误的密文:QWIHBLGZZXJSXZNVBZW。因此明文极大概率是由Base64编写的。

2401_83809941的博客 1863

【ubuntu】如何搭建AFTR+B4环境

为何要使用ipv6 目前ipv4地址已经不够用了,而IPv6采用128位地址长度,几乎可以不受限制地提供地址。而且ipv6具有更高的安全性。 主流的ipv6方案 1.双栈方案 :所有设备同时支持IPv4/IPv6协议栈,核心理念在于其传送网同时支持IPv4和IPv6 2.DS-Lite方案 :IPv4‐in‐IPv6 隧道和 NAT 这两个基本技术,同时支持IPV4与IPV6,对于ipv4用户,可以通过ipv6隧道与ipv4业务平台实现通信;针对ipv6用户,可直接通过ipv6网络通信。 3.6RD方案 :

weixin_43863426的博客 2726

bugku_抄错的字符

ccccccsngbydxm

suisuisama的博客 452

计组实验4 控制冒险与分支预测

目录前言实验内容背景知识分支预测技术⭐阻塞周期计算方法不开启 BTB开启 BTBpart 1 矩阵乘法与优化未开启 BTB 的分析开启 BTB 的分析part 2 设计代码使 BTB 无效part 3 循环展开优化矩阵乘法未开启 BTB开启 BTB结束语结论 前言 上一篇博客:计组实验3 mips冒险之流水线冒险 摸了半个月了。。。咕咕咕 今天来写计组实验 4 这个实验非常简单,就是有点难。 这个实验比较容易算错,或者是被模拟器出人意料的结果搞的神神叨叨的,所以今天来记录并且详细分析该实验。 注:请务必阅

AKGWSB 's blog 5669

Python3.8下MvCameraControl.dll加载失败?3种方法彻底解决FileNotFoundError

本文针对Python3.8及以上版本在Windows平台调用MvCameraControl.dll时出现的FileNotFoundError问题,深入剖析了其根源在于Python 3.8引入的DLL加载安全机制变更。文章提供了三种核心解决方案:显式指定DLL完整路径、使用os.add_dll_directory()添加可信目录,以及利用ctypes的winmode参数进行精细控制,并给出了工程化封装建议,帮助开发者彻底解决此兼容性问题。

weixin_29093017的博客 193

Bugku CTF 抄错的字符 WP

Bugku CTF 抄错的字符 WP 题目 思路: 由描述知给出的字符串中的每个字符原来可能是大小写字母或数字,应该先暴力枚举,并且优先级:数字 > 小写字母 > 大写字母,然后将枚举出来的字符进行解密(根据评论区知道是base64,实际做题过程中可能就需要一个一个尝试了) ps:字符串最后还要加一个=是真的搞 代码如下: import base64 s = "QWIHBLGZZXJSXZNVBZW=" dic = {'I': '1', 'B': '6', 'S':'5','G': '9','

jnwlhh的博客 5386

大模型新闻摘要生成质量评估工具

大模型新闻摘要生成质量评估工具 关键词:大模型、新闻摘要、质量评估、自然语言处理、算法 摘要:本文将探讨大模型新闻摘要生成质量评估工具的设计与应用。首先介绍大模型新闻摘要生成的背景和问题,然后深入分析质量评估的难点和重要性,接着介绍大模型的

AI天才研究院 829

bugku 抄错的字符

题目: 老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW 根据题目描述,可知 字符串原来是字母大小写+数字的。 而数字和字母相似的有 I(i)=>1、L(l)=>1、G(g)=>9、Z(z)=>2、S(s)=>5。 <?php $list=[]; function fun($str,$index=0){ if($index==strlen($str)){

PRCORANGE的博客 7424

【AI智能体】Dify集成 Echarts实现数据报表展示实战详解

Dify集成 Echarts 实现智能数据报表集成与展示实战详解

congge 5962

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Bugku题目--抄错的字符

老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW。大概就是以上的情况,然后就是大小写的转换。分析完毕后发现这并不是什么明文,有点像Base64。简单尝试一下发现可行。根据题目作者名字(Aman)和正确单词拼写,构成正确的flag。根据提示,需要恢复原来的字符串才行。

Arrebolcwn的博客 678

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Bugku,Crypto:抄错的字符

1.

Pai_Space 1015

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

Bugku Crypto 抄错的字符

这题分析一下,一共19位,每一位都有可能是大写字母,小写字母,数字,算下来如果暴力破解,是3981312万条数据,将近400万条数据 那肯定不能硬跑,于是分析一下,大写,小写,数字,很有可能是base64编码 那么就决定局部跑一下,只保留那些像base64编码的字符串 先借用大佬的脚本看一下思路 <?php $list=array(); function fun($str,$index=0){ if($index==strlen($str)){ global $list;

qq_41696858的博客 700

bugku中抄错的字符。(字符的转换)

老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW。最后结果是这个QW1hbl92ZXJ5X2Nvb2w=;然后再去base64在线工具就可以得到flag了。(1).数字抄成了字母(可能的变化有):l-1;(2).小写字母换成了大写字母:H-h;然后就是一个个去试,虽然会比较麻烦,但没办法。

2301_79622897的博客 413

Bugku - 抄错的字符(密码的小明)

摘要: 题目要求恢复被小明抄错的字符串"QWIHBLGZZXJSXZNVBZW",其中部分数字被替换为大写字母。通过排列组合所有可能的字符替换(如Q可能为9,Z可能为2等)并尝试Base64解码,最终生成了497,664种可能结果。由于正确答案隐藏在海量数据中(第94,050条),直接暴力破解不可行。文章展示了Python实现这一过程的代码,同时幽默地指出"密码的小明"制造了一个难以破解的谜题。

rem166的博客 1021

BugKu CTF(Crypto):Caesar cipher & 抄错的字符 & /.- & 聪明的小羊 & ok

BugKu是一个由乌云知识库(wooyun.org)推出的在线漏洞靶场。乌云知识库是一个致力于收集、整理和分享互联网安全漏洞信息的社区平台。BugKu旨在提供一个实践和学习网络安全的平台,供安全爱好者和渗透测试人员进行挑战和练习。它包含了各种不同类型的漏洞场景,如Web漏洞、系统漏洞、密码学等,参与者需要通过解决这些漏洞来获取Flag。

Flag少侠的博客 1万+

CTF BugKu平台——Crypto篇刷题记录(后续更新)_抄错的字符 ctf(2)

记录一下密码学的刷题记录 也是为了更好的巩固自己 基本有的解码 都附有超链接 希望大家能顺利通关 感谢观看!描述: 老师让小明抄写一段话,结果粗心的小明把部分数字抄成了字母,还因为强迫症把所有字母都换成大写。你能帮小明恢复并解开答案吗:QWIHBLGZZXJSXZNVBZW解码网站:http://www.hiencode.com/railfence.html 解码网站:https://www.splitbrain.org/services/ook解码网站:http://www.hiencode.com/br

2401_84281748的博客 1538

网络安全最全CTF BugKu平台——Crypto篇刷题记录(后续更新)_抄错的字符 ctf

扔进AZdecrypt进行解码(工具下载太慢了)

2401_84301389的博客 5482

2024年最全CTF BugKu平台——Crypto篇刷题记录(后续更新)_抄错的字符 ctf,2024年最新写得太好了

还有兄弟不知道网络安全面试可以提前刷题吗?费时一周整理的160+网络安全面试题,金九银十,做网络安全面试里的显眼包!王岚嵚工程师面试题(附答案),只能帮兄弟们到这儿了!如果你能答对70%,找一个安全工作,问题不大。对于有1-3年工作经验,想要跳槽的朋友来说,也是很好的温习资料!【完整版领取方式在文末!!】93道网络安全面试题内容实在太多,不一一截图了最后给大家分享一份全套的网络安全学习资料,给那些想学习 网络安全的小伙伴们一点帮助!对于从来没有接触过网络安全的同学,我们帮你准备了详细的学习成长路线图。可以说

2401_84281703的博客 1344
上一篇: sql注入补充——get注入
下一篇: hex文件结构速查
Coder_Chang
博客等级 码龄11年 82粉丝 81原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值