回归模型的不稳定性

回归分析的几个问题:异方差性、自相关性、多重共线性 在 回归分析学习笔记(一):尽量详细且说人话 中介绍了经典回归分析的基本假设,如果假设条件不满足会出现一些问题,现在就来具体的介绍一下。对于我们分析的具体问题,叙述逻辑为:概念描述——产生原因——导致结果——补救措施。 基本假设 x1,...,xpx_1,...,x_px1​,...,xp​ 是确定性变量,不是随机变量; 解释变量之间不相关,样本容量个数大于解释变量个数,即X\boldsymbol XX的秩为 p+1<n; Gauss−Markov条件{E(ϵi)=0,i=1,2,...,nCov( 阅读详情

作者:chen_h
微信号 & QQ:862251340
微信公众号:coderpai


介绍

由于各种原因,回归系数可能存在且不稳定。这篇文章会简单介绍这种情况。

回归分析允许我们估计函数中的系数,该函数用于设计的多个数据集。我们假设这个函数的一个特定形式,然后找到适合数据的系数,假设偏离模型可以被认为是噪声。

在构建这样的模型时,我们接受它不能完美的预测因变量。在这里,我们想要评估模型的准确性。而不是它如何解释因变量,而是评估我们的样本数据的稳定性(即回归系数的稳定性)。毕竟,如果一个模型真的很合适,那么它应该类似于我们单独建模的两个随机的数据集的模型。否则,我们认为模型仅仅是适合我们选择的特定数据样本的结果。

我们将此处使用线性回归来说明这个问题,但同时也应该适用于所有回归模型。下面我们为 stasmodels 的线性回归定义一个包装函数,以便我们以后可以使用它。

import numpy as np
import pandas as pd
from statsmodels import regression, stats
import statsmodels.api as sm
import matplotlib.pyplot as plt
import scipy as sp

def linreg(X,Y):
    # Running the linear regression
    x = sm.add_constant(X) # Add a row of 1's so that our model has a constant term
    model = regression.linear_model.OLS(Y, x).fit()
    return model.params[0], model.params[1] # Return the coefficients of the linear model

有偏见的噪音

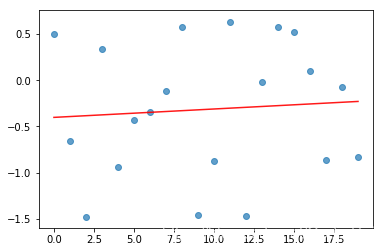
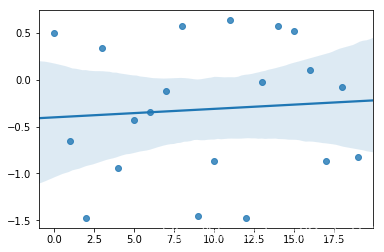
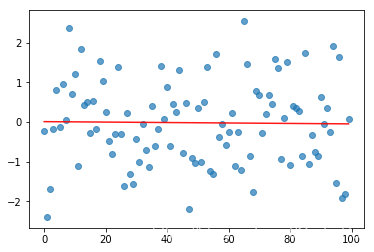
我们为数据选择的特定样本会影响我们生成的模型,不均匀分布的噪声会导致模型不准确。下面我们生成正太分布数据,但由于我们没有很多数据点,因此我们看到了显著的向下偏差。如果我们进行更多测量,那么两个回归系数都将趋向于零。

# Draw observations from normal distribution
np.random.seed(107) # Fix seed for random number generation
rand = np.random.randn(20)

# Conduct linear regression on the ordered list of observations
xs = np.arange(20)
a, b = linreg(xs, rand)
print('Slope:', b, 'Intercept:', a)

# Plot the raw data and the regression line
plt.scatter(xs, rand, alpha=0.7)
Y_hat = xs * b + a
plt.plot(xs, Y_hat, 'r', alpha=0.9);

plt.show()
Slope: 0.009072503822685526 Intercept: -0.40207744085303815
在这里插入图片描述

import seaborn

seaborn.regplot(xs, rand)
在这里插入图片描述

# Draw more observations
rand2 = np.random.randn(100)

# Conduct linear regression on the ordered list of observations
xs2 = np.arange(100)
a2, b2 = linreg(xs2, rand2)
print('Slope:', b2, 'Intercept:', a2)

# Plot the raw data and the regression line
plt.scatter(xs2, rand2, alpha=0.7)
Y_hat2 = xs2 * b2 + a2
plt.plot(xs2, Y_hat2, 'r', alpha=0.9);

plt.show()
Slope: -0.0005693423631053353 Intercept: 0.009011767319021785
在这里插入图片描述

回归分析对异常值非常敏感。有时候这些异常值又会包含很多信息,在这种情况下我们要考虑他们。但是,在上述情况下,它们可能只是随机噪音。虽然我们的数据点通常比上面的例子多很多,但我们可能会有(例如)数周或者数月的波动,这会显著改变回归系数。

结构性改变

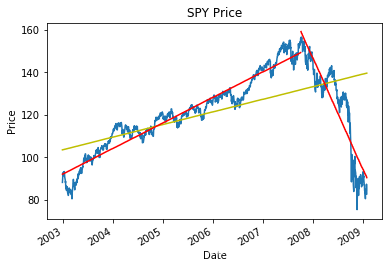
制度变化(或者结构性变化)是指在生成数据的过程中发生变化,导致未来样本遵循不同的分布。下面,我们可以看到在 2007 年底有一个政权更改,并且在那里分割数据导致比整个数据集(黄色)的回归更好(红色)。在这种情况下,我们的回归模型将无法预测未来的数据点,因为底层系统不再与样本中的相同。实际上,回归分析假设误差是不相关的并且具有恒定的方差,如果存在制度变化,则通常不是这种情况。

import pandas_datareader as pdr

start = '2003-01-01'
end = '2009-02-01'
#pricing = get_pricing('SPY', fields='price', start_date=start, end_date=end)
data = pdr.get_data_yahoo('SPY', start = start, end=end)
pricing = data['Close']
# Manually set the point where we think a structural break occurs
breakpoint = 1200
xs = np.arange(len(pricing))
xs2 = np.arange(breakpoint)
xs3 = np.arange(len(pricing) - breakpoint)

# Perform linear regressions on the full data set, the data up to the breakpoint, and the data after
a, b = linreg(xs, pricing)
a2, b2 = linreg(xs2, pricing[:breakpoint])
a3, b3 = linreg(xs3, pricing[breakpoint:])

Y_hat = pd.Series(xs * b + a, index=pricing.index)
Y_hat2 = pd.Series(xs2 * b2 + a2, index=pricing.index[:breakpoint])
Y_hat3 = pd.Series(xs3 * b3 + a3, index=pricing.index[breakpoint:])

# Plot the raw data
pricing.plot()
Y_hat.plot(color='y')
Y_hat2.plot(color='r')
Y_hat3.plot(color='r')
plt.title('SPY Price')
plt.ylabel('Price');
在这里插入图片描述

当然,我们打破数据集的碎片越多,我们就越准确的适应它。避免去拟合噪声数据是非常重要的,噪声总是会波动并且不能预测。我们可以在我们已经识别的特定点或一般情况下测试结果中断的存在。下面我们使用来自 statsmodels 的测试,该测试计算在没有断点的情况下观察数据的概率。

stats.diagnostic.breaks_cusumolsresid(
    regression.linear_model.OLS(pricing, sm.add_constant(xs)).fit().resid)[1]
5.713702903582742e-59

多重共线性

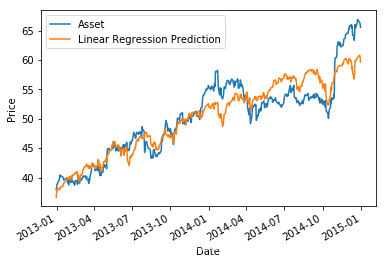
上面我们只考虑一个因变量对一个独立变量的回归。但是,我们也可以有多个自变量。如果自变量高度相关,则会导致不稳定。

想象一下,我们使用两个独立变量 X 1 X_{1} X1​ 和 X 2 X_{2} X2​ ,并且它们具有很高的相关性。然后,如果我们添加一个新的观察结果,那么系数可能会急剧变化,这个观察结果稍微好一点。在极端情况下,如果 X 1 = X 2 X_{1} = X_{2} X1​=X2​ ,则系数的选择将取决于特定的线性回归算法。

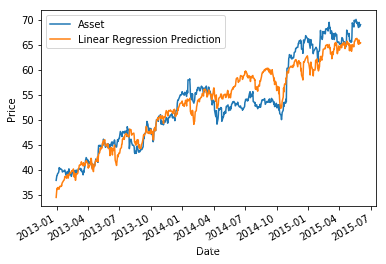
下面,我们运行多元线性回归,其中自变量高度相关。如果我们将采样周期设为 2013-01-01 至 2015-01-01,则系数约为 0.25 和 0.1 ,但如果我们将期限延长至 2015-06-01,则系数分为约为 0.18 和 0.20。

# Get pricing data for two benchmarks (stock indices) and a stock
start = '2013-01-01'
end = '2015-01-01'
#b1 = get_pricing('SPY', fields='price', start_date=start, end_date=end)
#b2 = get_pricing('MDY', fields='price', start_date=start, end_date=end)
#asset = get_pricing('V', fields='price', start_date=start, end_date=end)

data = pdr.get_data_yahoo('SPY', start = start, end=end)
b1 = data['Close']
data = pdr.get_data_yahoo('MDY', start = start, end=end)
b2 = data['Close']
data = pdr.get_data_yahoo('V', start = start, end=end)
asset = data['Close']


mlr = regression.linear_model.OLS(asset, sm.add_constant(np.column_stack((b1, b2)))).fit()
prediction = mlr.params[0] + mlr.params[1]*b1 + mlr.params[2]*b2
print('Constant:', mlr.params[0], 'MLR beta to S&P 500:', mlr.params[1], ' MLR beta to MDY', mlr.params[2])

# Plot the asset pricing data and the regression model prediction, just for fun
asset.plot()
prediction.plot();
plt.ylabel('Price')
plt.legend(['Asset', 'Linear Regression Prediction']);
Constant: -16.243603405890557 MLR beta to S&P 500: 0.2492404646507781  MLR beta to MDY 0.09349176682768158
在这里插入图片描述

# Get pricing data for two benchmarks (stock indices) and a stock
start = '2013-01-01'
end = '2015-06-01'

#b1 = get_pricing('SPY', fields='price', start_date=start, end_date=end)
#b2 = get_pricing('MDY', fields='price', start_date=start, end_date=end)
#asset = get_pricing('V', fields='price', start_date=start, end_date=end)

data = pdr.get_data_yahoo('SPY', start = start, end=end)
b1 = data['Close']
data = pdr.get_data_yahoo('MDY', start = start, end=end)
b2 = data['Close']
data = pdr.get_data_yahoo('V', start = start, end=end)
asset = data['Close']

mlr = regression.linear_model.OLS(asset, sm.add_constant(np.column_stack((b1, b2)))).fit()
prediction = mlr.params[0] + mlr.params[1]*b1 + mlr.params[2]*b2
print('Constant:', mlr.params[0], 'MLR beta to S&P 500:', mlr.params[1], ' MLR beta to MDY', mlr.params[2])

# Plot the asset pricing data and the regression model prediction, just for fun
asset.plot()
prediction.plot();
plt.ylabel('Price')
plt.legend(['Asset', 'Linear Regression Prediction']);
Constant: -28.3571287326346 MLR beta to S&P 500: 0.18023806033366943  MLR beta to MDY 0.20011277731901822
在这里插入图片描述

我们可以通过计算他们的相关系数来检查我们的自变量是否相关。此数字始终位于 -1 和 1 之间,值 1 表示两个变量完全相关。

# Compute Pearson correlation coefficient
sp.stats.pearsonr(b1,b2)[0] # Second return value is p-value
0.988746070194985

来源:quantopian

浅谈共线性的产生以及解决方法(上篇——前世) 标题:浅谈共线性的产生以及解决方法(上篇——前世) 1. 多元线性回归模型 在线性相关条件下,两个或两个以上解释变量对一个被解释变量的数量变化关系,称之为多元线性回归分析,由多元线性回归分析得到的数学表达式称为多元线性回归模型。 一般我们认为,多元线性回归问题中涉及的数据由被解释变量Y和p个解释变量x1x_{1}x1​,x2x_2x2​,x3x_3x3​,…,xpx_pxp​的n次观测组成,如下表所示: 多元线性回归模型的一般形式为:y=β0β_0β0​+β1 阅读详情

相关推荐

使用car包的vif函数计算方差膨胀因子并检测多重共线性

使用vif函数计算方差膨胀因子(Variance Inflation Factor, VIF),VIF用于衡量每个预测变量与其他预测变量之间的相关性程度。通过对VIF值进行判断,我们可以及时发现模型中存在的多重共线性问题,并采取相应的措施进行处理。多重共线性是指在回归模型中,自变量之间存在高度相关性,这可能导致模型的不稳定性和不可靠的系数估计。为了识别和评估特征之间的多重共线性,可以使用R语言中的car包中的vif函数。如果任何一个自变量的VIF值超过阈值,就会打印出"存在多重共线性"的提示。

2301_79326930的博客 945

多元线性回归的缺陷_多元线性回归模型常见问题及解决方法概要.ppt

多元线性回归模型常见问题及解决方法概要多元线性回归模型 基本假设 (1)随机扰动项ui数学期望(均值)为零。E(ui)=0 (2)随机扰动项ui的同方差性且无自相关Var(ui)=σ2 (3)解释变量X列线性无关。R(Xn×k)=K (4)随机扰动项ui与解释变量X不相关。cov(ui,X)=0 异方差性的定义 对于线性回归模型 同方差性假设为 如果出现 即对于不同的样本点,随机误差项...

weixin_31943957的博客 3484

42、为何P2P流媒体冷门频道中的节点稳定性较差?

本文探讨了P2P流媒体系统中冷门频道节点稳定性较差的原因,通过系统监测和数据分析,揭示了缓冲级别、节点入度以及观看时间等因素对节点寿命的影响。研究采用生存分析和Cox回归模型,对关键因素进行建模分析,为提高冷门频道的流媒体质量提供了理论支持和实践策略。

docker8compose的博客 90

《误差理论》——回归分析(1)

回归分析是寻找两个变量或多个变量之间的内在关系

qq_40777436的博客 1533

用R计算回归模型中每个样本的DFBETAS值:衡量样本对估计系数的影响

然而,有时候某个样本可能对某个系数的估计产生较大的影响,这可能导致模型的不稳定性。DFBETAS值的解读方式是,如果某个样本的DFBETAS值超过2/√n,其中n是样本数量,那么该样本对于估计系数的影响被认为是显著的。通常,我们会关注那些DFBETAS值较大的样本,以评估其对回归模型的影响。通过计算每个样本的DFBETAS值,我们可以更全面地了解每个样本对于回归模型估计的影响程度。为了计算回归模型中每个样本的DFBETAS值,我们可以使用R语言中的stats包中的。函数打印出每个样本的DFBETAS值。

TechSavant的博客 778

用R语言计算方差膨胀因子(Variance Inflation Factor,VIF)来分析自变量之间的共线性程度

上述代码中,我们使用read.csv()函数导入包含自变量和因变量的数据集,然后,使用lm()函数拟合一个多元线性回归模型,其中因变量为"Y",自变量为"X1"、“X2"和"X3”,请确保将"your_dataset.csv"替换为实际的数据集文件名。首先需要准备一个包含自变量的数据集,假设我们有一个名为"dataset"的数据集,其中包含了自变量"X1"、“X2"和"X3”,以及因变量"Y",我们将使用lm()函数来拟合一个多元线性回归模型,并计算VIF。运行上述代码后,将会输出每个自变量的VIF值。

weixin_50547796的博客 1617

Python实现向量自回归(VAR)模型——完整步骤

废话不多说,先开始分享: 1. 首先啥是VAR模型,我这里简略通俗的说一下,想看代码的童鞋直接跳到第3部分就好了: 以金融价格为例,传统的时间序列模型比如ARIMA,ARIMA-GARCH等,只分析价格自身的变化,模型的形式为: 其中称为自身的滞后项。 但是VAR模型除了分析自身滞后项的影响外,还分析其他相关因素的滞后项对未来值产生的影响,模型的形式为: 其中就是其他因子的滞后项......

mooncrystal123的博客 12万+

从0到1搭建StarRocks3.4.1存算一体架构(VM 虚拟机版)

本文详细介绍了如何在VM虚拟机上从零搭建StarRocks 3.4.1存算一体架构。首先阐述了StarRocks作为高性能分布式SQL数据仓库的优势,重点讲解了其存算一体架构的设计原理。随后提供完整的安装指南,包括环境准备(3台CentOS 8虚拟机配置)、网络互通验证、Java环境配置、软件包解压安装等关键步骤。文章特别详细说明了FE和BE节点的配置文件修改(fe.conf和be.conf)以及必要的防火墙端口开放配置。通过图文并茂的方式,帮助开发者和运维人员快速掌握StarRocks集群部署方法,为后续

小 tom的博客 1335

使用Python的VAR模型

VAR,Python

interval_package的博客 6066

从原理到实践:详解RGBD相机深度与彩色图像对齐(D2C)算法

本文深入解析了RGBD相机深度与彩色图像对齐(D2C)算法的原理与实现。针对自组装相机中深度图与彩色图不匹配的核心痛点,文章从相机模型、坐标系变换等数学基础讲起,剖析了传统点映射算法的缺陷,并重点介绍了高效的矩形区域映射算法。该算法通过将深度像素视为矩形区域进行映射,有效解决了空洞和遮挡问题,并附有可直接复用的C++代码与优化技巧,为三维重建、机器人视觉等应用奠定坚实基础。

weixin_28363123的博客 243

COCO2017数据集类别分布深度解析

本文深入解析了COCO2017数据集的类别分布情况,包括80个常见物体的分类统计和样本数量分析。通过对比训练集与验证集的分布一致性,探讨了数据均衡性问题,并针对高频和低频类别提出了实用的数据预处理和模型训练建议,帮助优化计算机视觉任务的性能。

weixin_42533751的博客 370

齐发3篇!国家杰青、北大学者霸屏计量经济学顶刊JoE!

据Journal of Econometrics官网消息,十多篇中国境内和香港高校学者撰写的论文发表在计量经济学顶级期刊Journal of Econometrics 5月刊(in progress)。其中教育部“长江学者奖励计划”青年长江学者,国家自然科学基金杰出青年科学基金获得者、北京大学光华管理学院商务统计与经济计量系和北京大学统计科学中心联席教授涂云东齐发三篇,分别为“When structural break meets threshold effect: Factor analysis unde

2301_78812497的博客 979

Unity特效序列帧输出全攻略:Recorder+Timeline保姆级教程(解决透明通道问题)

本文提供Unity特效序列帧输出的完整解决方案,重点讲解如何结合Recorder与Timeline工具,实现带透明通道的PNG序列帧高效输出。通过保姆级教程,详细解析摄像机隔离、层级设置、参数配置等关键步骤,并深度解决透明通道丢失等常见问题,帮助特效师和动画师打通引擎创作与后期合成的工作流。

tensorflowjs6的博客 430

帮我改写这段话“在碳排放预测主要分为了不确定和确定两方面,相应预测方法也有所差异,研究学者常采用情景设置法确定相应的作用因素进而预测碳排放,碳排放的不确定预测相关研究较少。基于情景设置方法是设定确定的...

碳排放的预测通常被分为确定和不确定两个方面。因此,相应的预测方法也会有所不同。为了确定相应的作用因素并进行碳排放的预测,研究学者通常使用情景设置法。不确定性预测相关研究较少,需要通过计算和研究碳排放中的不确定因素数据来进行。目前,许多文献研究(例如[5-8])使用机器学习和各种回归模型来预测交通运输碳排放,并利用情景设置法设定确定的因素作为碳排放的影响因子。这种方法基于各类作用因素数据,可以清晰地...

weixin_42603332的博客 87

Alipay 支付唤起 h5 测试

测试地址 https://recharge.apps.oppomobile.com/recharge-center/recharge/?from=message try { //唤起客户端快捷参数 var data = {"requestType":"SafePay","fromAppUrlScheme":"alipays","dataString":"h5_ro...

六桥风月IT随笔 1万+

RK3568平台(camera篇)点亮imx586摄像头

mipi摄像头硬件确认点:1.供电:5V,2.8V,1.2V,1.8V,reset脚(硬拉3.3,上电的时候从低到高),pwron脚外接3.3V。2,时钟:MCLKOUT是24兆时钟。3.4组差分mipi线。mipi的data线的波形为方波。

weixin_49303682的博客 7260

python 回归去掉共线性_SPSS方法|岭回归分析

前言岭回归:岭回归分析是在构建多重线性回归模型时, 对基于“最小二乘原理”推导出的估计回归系数的计算公式作一下校正,使回归系数更稳定。当自变量之间存在较强的多重共线性时,求得的多重线性回归模型很不稳定; 尤其是某些自变量回归系数的正负号与实际问题的专业背景不吻合时,岭回归分析可以很好地解决这一问题。1 实施的一般步骤1 岭回归分析通常要先对 X 变量作中心化和标准化处理, 以使不同自变量处于同样数...

weixin_39796868的博客 1118

心理学量表汇总 50多个 附下载

目录一、心理健康与精神病态量表二、行为问题量表三、人格评估量表四、智力测验一、心理健康与精神病态量表1.一般症状自评量表(SCL-90)症状自评量表 (The self-report symptom inventory ,Symptom checklist ,90,简称 SCL90) 有 90 个评定项目 , 每个项目分五级评分 , 包含了比较广泛的精神病症状学内容, 从感觉、 情 感、思维、意识、行为直至生活习惯、人际关系、饮食等均有涉及,能准确刻划被试的自觉 症状,能较好地反映被试的问题及其严重程度和变

南七小僧的学海无涯 1906

【机器学习300问】110、什么是Lasso回归模型?

什么是Lasso回归模型?Lasso回归的原理、Lasso回归的局限性

qq_39780701的博客 2168

QML实现ListView的拖动排序

现有一种需求,就是用鼠标拖动某项,动态去改变某一项在ListView中显示的顺序位置,经过研究及实践实战,实现方式的核心代码如下: import QtQuick 2.4 import QtQuick.Controls 1.3 import QtQuick.Window 2.2 import QtQuick.Dialogs 1.2 Rectangle { width: 800 ...

草上爬的博客 7565

深度学习工具包 DeepLearningToolbox

深度学习工具包Deprecation notice.-----This toolbox is outdated and no longer maintained.There are much better tools available for deep learning than this toolbox, e.g. [Theano](http://deeplearning.net/software/theano/), [torch](http://torch.ch/) or [tensorflow](http://www.tensorflow.org/)I would suggest you use one of the tools mentioned above rather than use this toolbox.Best, Rasmus.DeepLearnToolbox================A Matlab toolbox for Deep Learning.Deep Learning is a new subfield of machine learning that focuses on learning deep hierarchical models of data.It is inspired by the human brain's apparent deep (layered, hierarchical) architecture.A good overview of the theory of Deep Learning theory is[Learning Deep Architectures for AI](http://www.iro.umontreal.ca/~bengioy/papers/ftml_book.pdf)For a more informal introduction, see the following videos by Geoffrey Hinton and Andrew Ng.* [The Next Generation of Neural Networks](http://www.youtube.com/watch?v=AyzOUbkUf3M) (Hinton, 2007)* [Recent Developments in Deep Learning](http://www.youtube.com/watch?v=VdIURAu1-aU) (Hinton, 2010)* [Unsupervised Feature Learning and Deep Learning](http://www.youtube.com/watch?v=ZmNOAtZIgIk) (Ng, 2011)If you use this toolbox in your research please cite [Prediction as a candidate for learning deep hierarchical models of data](http://www2.imm.dtu.dk/pubdb/views/publication_details.php?id=6284)```@MASTERSTHESIS\{IMM2012-06284, author = "R. B. Palm", title = "Prediction as a candidate for learning deep hierarchical models of data", year = "2012",}```Contact: rasmusbergpalm at gmail dot comDirectories included in the toolbox-----------------------------------`NN/` - A library for Feedforward Backpropagation Neural Networks`CNN/` - A library for Convolutional Neural Networks`DBN/` - A library for Deep Belief Networks`SAE/` - A library for Stacked Auto-Encoders`CAE/` - A library for Convolutional Auto-Encoders`util/` - Utility functions used by the libraries`data/` - Data used by the examples`tests/` - unit tests to verify toolbox is workingFor references on each library check REFS.mdSetup-----1. Download.2. addpath(genpath('DeepLearnToolbox'));Example: Deep Belief Network---------------------```matlabfunction test_example_DBNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit RBM and visualize its weightsrand('state',0)dbn.sizes = [100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);figure; visualize(dbn.rbm{1}.W'); % Visualize the RBM weights%% ex2 train a 100-100 hidden unit DBN and use its weights to initialize a NNrand('state',0)%train dbndbn.sizes = [100 100];opts.numepochs = 1;opts.batchsize = 100;opts.momentum = 0;opts.alpha = 1;dbn = dbnsetup(dbn, train_x, opts);dbn = dbntrain(dbn, train_x, opts);%unfold dbn to nnnn = dbnunfoldtonn(dbn, 10);nn.activation_function = 'sigm';%train nnopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.10, 'Too big error');```Example: Stacked Auto-Encoders---------------------```matlabfunction test_example_SAEload mnist_uint8;train_x = double(train_x)/255;test_x = double(test_x)/255;train_y = double(train_y);test_y = double(test_y);%% ex1 train a 100 hidden unit SDAE and use it to initialize a FFNN% Setup and train a stacked denoising autoencoder (SDAE)rand('state',0)sae = saesetup([784 100]);sae.ae{1}.activation_function = 'sigm';sae.ae{1}.learningRate = 1;sae.ae{1}.inputZeroMaskedFraction = 0.5;opts.numepochs = 1;opts.batchsize = 100;sae = saetrain(sae, train_x, opts);visualize(sae.ae{1}.W{1}(:,2:end)')% Use the SDAE to initialize a FFNNnn = nnsetup([784 100 10]);nn.activation_function = 'sigm';nn.learningRate = 1;nn.W{1} = sae.ae{1}.W{1};% Train the FFNNopts.numepochs = 1;opts.batchsize = 100;nn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.16, 'Too big error');```Example: Convolutional Neural Nets---------------------```matlabfunction test_example_CNNload mnist_uint8;train_x = double(reshape(train_x',28,28,60000))/255;test_x = double(reshape(test_x',28,28,10000))/255;train_y = double(train_y');test_y = double(test_y');%% ex1 Train a 6c-2s-12c-2s Convolutional neural network %will run 1 epoch in about 200 second and get around 11% error. %With 100 epochs you'll get around 1.2% errorrand('state',0)cnn.layers = { struct('type', 'i') %input layer struct('type', 'c', 'outputmaps', 6, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %sub sampling layer struct('type', 'c', 'outputmaps', 12, 'kernelsize', 5) %convolution layer struct('type', 's', 'scale', 2) %subsampling layer};cnn = cnnsetup(cnn, train_x, train_y);opts.alpha = 1;opts.batchsize = 50;opts.numepochs = 1;cnn = cnntrain(cnn, train_x, train_y, opts);[er, bad] = cnntest(cnn, test_x, test_y);%plot mean squared errorfigure; plot(cnn.rL);assert(er<0.12, 'Too big error');```Example: Neural Networks---------------------```matlabfunction test_example_NNload mnist_uint8;train_x = double(train_x) / 255;test_x = double(test_x) / 255;train_y = double(train_y);test_y = double(test_y);% normalize[train_x, mu, sigma] = zscore(train_x);test_x = normalize(test_x, mu, sigma);%% ex1 vanilla neural netrand('state',0)nn = nnsetup([784 100 10]);opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samples[nn, L] = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.08, 'Too big error');%% ex2 neural net with L2 weight decayrand('state',0)nn = nnsetup([784 100 10]);nn.weightPenaltyL2 = 1e-4; % L2 weight decayopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex3 neural net with dropoutrand('state',0)nn = nnsetup([784 100 10]);nn.dropoutFraction = 0.5; % Dropout fraction opts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex4 neural net with sigmoid activation functionrand('state',0)nn = nnsetup([784 100 10]);nn.activation_function = 'sigm'; % Sigmoid activation functionnn.learningRate = 1; % Sigm require a lower learning rateopts.numepochs = 1; % Number of full sweeps through dataopts.batchsize = 100; % Take a mean gradient step over this many samplesnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex5 plotting functionalityrand('state',0)nn = nnsetup([784 20 10]);opts.numepochs = 5; % Number of full sweeps through datann.output = 'softmax'; % use softmax outputopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, train_x, train_y, opts);[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');%% ex6 neural net with sigmoid activation and plotting of validation and training error% split training data into training and validation datavx = train_x(1:10000,:);tx = train_x(10001:end,:);vy = train_y(1:10000,:);ty = train_y(10001:end,:);rand('state',0)nn = nnsetup([784 20 10]); nn.output = 'softmax'; % use softmax outputopts.numepochs = 5; % Number of full sweeps through dataopts.batchsize = 1000; % Take a mean gradient step over this many samplesopts.plot = 1; % enable plottingnn = nntrain(nn, tx, ty, opts, vx, vy); % nntrain takes validation set as last two arguments (optionally)[er, bad] = nntest(nn, test_x, test_y);assert(er < 0.1, 'Too big error');```[![Bitdeli Badge](https://d2weczhvl823v0.cloudfront.net/rasmusbergpalm/deeplearntoolbox/trend.png)](https://bitdeli.com/free "Bitdeli Badge")

回归模型评估指标:MSE、RMSE、MAE与R²的原理、实现与应用

在机器学习与数据科学领域,模型评估是衡量预测性能的关键环节。其核心原理在于量化模型预测值与真实值之间的差异,从而为模型优化提供客观依据。从技术价值看,不同的评估指标各有侧重:MSE(均方误差)通过对误差平方来放大较大误差的影响,适用于需要严惩大偏差的场景;RMSE(均方根误差)则解决了MSE量纲问题,使结果更易解释;MAE(平均绝对误差)计算绝对误差的平均值,对异常值不敏感,能稳健反映典型误差水平;而R²(决定系数)则评估模型对数据波动的解释能力,是衡量拟合优度的综合指标。这些指标共同构成了回归任务中模型诊

weixin_29044713的博客 294

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

决策树回归(概念+实例)

决策树回归(Decision Tree Regression)是一种常用的机器学习算法,用于预测连续型变量的取值。它基于树结构来对数据进行建模和预测,通过将数据集划分为不同的区域,并在每个区域内预测一个常数值来实现回归任务。在本文中,我将详细介绍决策树回归的原理、构建过程、优缺点以及应用场景。

weixin_47151388的博客 1万+

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

R语言实战:Cox回归模型中的逐步变量筛选技巧

本文详细介绍了在R语言中运用逐步回归(Stepwise Variable Selection)为Cox比例风险模型进行变量筛选的实战技巧。通过解析向前、向后及双向三种筛选策略,并结合My.stepwise.coxph函数演示了从数据清洗、参数调整到模型诊断的全流程。文章旨在帮助研究者从冗余变量中提炼出独立、显著的影响因素,构建简洁、稳健且易于解释的生存分析模型,并探讨了该方法的局限性与替代方案。

cicd6pipeline的博客 1089

【机器学习-40】VIF

VIF 是一个非常有用的工具,帮助我们判断回归模型中是否存在多重共线性问题。如果 VIF 值过高,说明模型中存在冗余的信息,可能导致回归系数的不稳定和不准确。通过适当的处理,可以有效提高模型的稳定性和预测能力。

m0_69378371的博客 1305

人工智能在燃烧反应流中的应用

例如,基于样本增量量子神经网络和改进型量子蜂群算法的智能燃烧优化方法,可以动态建立燃煤锅炉的NOx排放浓度和煤耗的综合优化模型,并实现模型参数的滚动优化,以保证模型的辨识能力和泛化能力。通过引入人工智能算法与反应网络研究的融合,可以突破人类大脑性能和视觉认知的极限,深入了解化学过程机理,并实现过程机理的可视化。例如,基于图卷积神经网络的反应特征智能迁移学习算法,可以从反应网络图的本征拓扑结构出发,逐步深入研究,并提出一套由非结构化的反应机理出发进行可解释性的过程分析和过程建模的智能化过程。

khhdp的博客 1561
上一篇: pandas系列学习(七):数据透视表
下一篇: 置信区间
coderpai
博客等级 码龄10年 1082粉丝 469原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值