置信区间

如何在Python中绘制置信区间? 置信区间是从观测数据的统计量计算的一种估计值,它给出了一个可能包含具有特定置信水平的总体参数的值范围。平均值的置信区间是总体平均值可能位于其间的值的范围。如果我预测明天的天气在零下100度到+100度之间,我可以100%肯定这是正确的。然而,如果我预测温度在20.4到20.5摄氏度之间,我就不那么有信心了。注意置信度如何随着区间的减小而减小。这同样适用于统计置信区间,但它们也依赖于其他因素。 阅读详情

作者:chen_h
微信号 & QQ:862251340
微信公众号:coderpai


介绍

在统计中,置信区间用于表示可能存在正确答案的范围。他们是量化不确定性的优雅方式,在统计测试的许多部分中它是无处不在的。

样本均值和总体均值

样本均值和总体均值是不同的,通常,我们想要了解总体均值,但我们只能计算样本均值。然后,我们希望使用样本均值来估计总体均值。我们使用置信区间来尝试确定我们的样本均值估计总体均值的准确程度。

置信区间

如果我要求你估计美国女生的平均身高,你可以通过测量 10 名女生的身高,然后估计该样本的平均值来计算总体均值。接下来让我们来试试吧:

import numpy as np
import seaborn as sns
from scipy import stats
import matplotlib.pyplot as plt
# We'll set a seed here so our runs are consistent
np.random.seed(10)

# Let's define some 'true' population parameters, we'll pretend we don't know these.
POPULATION_MU = 64
POPULATION_SIGMA = 5

# Generate our sample by drawing from the population distribution
sample_size = 10
heights = np.random.normal(POPULATION_MU, POPULATION_SIGMA, sample_size)
print(heights)
mean_height = np.mean(heights)
print('sample mean: ', mean_height)
[70.65793252 67.57639487 56.27299854 63.95808075 67.10667987 60.3995722
 65.32755793 64.54274263 64.02145715 63.12699895]
sample mean:  64.29904154070394

不幸的是,简单的计算样本均值对我们没有太大作用,因为我们不知道它与总体均值的关系。为了了解它的相关性,我们可以查看样本中存在多少差异,方差越大表明不稳定和不确定性越大。

print('sample standard deviation: ', np.std(heights))
sample standard deviation:  3.759878018454642

这对我们来说仍然不够,真正了解我们的样本均值和总体的关系意味着我们需要计算标准误差。标准误差是样本均值方差的度量。

重要的事!!!

计算标准误差设计假设你采样的方式,并且数据是正常且独立的。如果违反这些条件,你的标准误差将是误差的。标准误差的公式是:

S E = σ n SE = \frac{\sigma}{\sqrt{n}} SE=n ​σ​

其中, σ \sigma σ 是标准偏差, n n n 是样本数。

SE = np.std(heights) / np.sqrt(sample_size)
print('standard error: ', SE)
standard error:  1.1889778262717268

Scipy 的统计库中有一个函数用于计算标准误差。请注意,默认情况下,此功能包含通常不需要的自由度矫正(对于足够大的样本,它实际上是无关紧要的)。你可以通过将参数 ddof 设置为 0 来省略校正。

stats.sem(heights, ddof=0)
1.1889778262717268

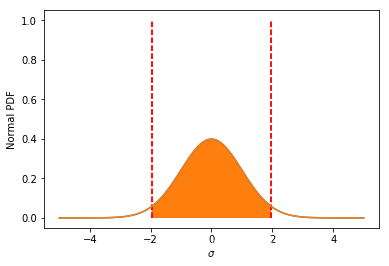
假设我们的数据是正太分布的,我们可以使用标准误差来计算置信区间。为此,我们首先设置所需的执行水平,比如 95%,然后我们确定有多少标准偏差包含 95% 的质量。事实证明,在标准正太分布上,95% 的系数是位于 -1.96 和 1.96 之间的。当样本足够大时(通常 > 30 作为阈值),中心极限定理适用,并且可以安全的假设正态性。如果样本量较小,则更安全的方法是使用具有适当指定自由度的分布。计算值的实际方法是使用累积分布函数(CDF)。如果你不熟悉(CDF),反向CDF及其伴随PDF,你可以阅读这几个链接,1,2,3。

注意:在应用中心极限定理时要小心,因为金融中的许多数据集基本上是非正太的,并且随意应用定理或不注意微妙性是非常不安全的。

我们可以在这里可视化 95% 置信区间:

# Set up the x axis
x = np.linspace(-5,5,100)
# Here's the normal distribution
y = stats.norm.pdf(x,0,1)
plt.plot(x,y)

# Plot our bounds
plt.vlines(-1.96, 0, 1, colors='r', linestyles='dashed')
plt.vlines(1.96, 0, 1, colors='r', linestyles='dashed')

# Shade the area
fill_x = np.linspace(-1.96, 1.96, 500)
fill_y = stats.norm.pdf(fill_x, 0, 1)
plt.fill_between(fill_x, fill_y)

plt.xlabel('$\sigma$')
plt.ylabel('Normal PDF');

plt.show()
在这里插入图片描述

一些诀窍

现在,我们可以计算一个区间,而不是报告我们的样本均值没有任何正确的概率,我们可以计算一个区间,并且更有信心总体均值位于该区间内。为此,我们采用样本均值和区间: ( μ − 1.96 S E , μ + 1.96 S E ) (\mu - 1.96SE, \mu + 1.96SE) (μ−1.96SE,μ+1.96SE) 。

这是有效的,因为我们假设正太分布 。

细微之处

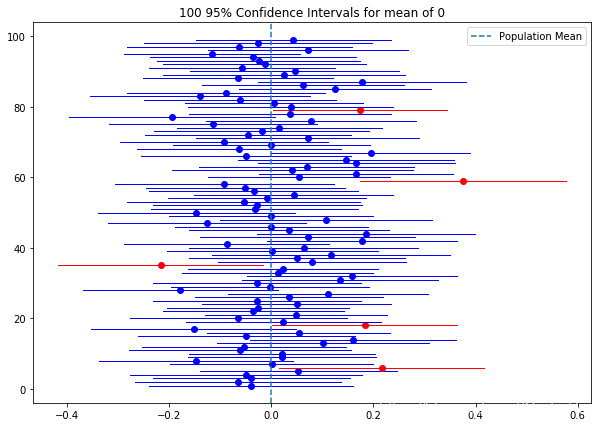
在任何给定的情况下,估计的真实值和置信区间的界限是固定的。说“全国平均女性身高在 63 到 65 英寸之间,概率为 95%” 是不正确的,但不幸的是,这是一个非常常见的误解。相反,95% 指的是这样一个事实:在 95% 置信区间的许多计算中,真实值将在 95% 的情况下在区间内。但事实上,对于单个样本和从中计算的单个置信区间,我们无法评估区间包含总体均值的概率。下面的可视化演示了这一点。

在下面的代码块中,有两点需要注意。首先,虽然样本来那个足够大到保持正太,但我们使用分布只是为了演示我们是如何使用它的。其次,所需的值(类似于上面的使用)是根据反向累积密度函数计算的,即 scipy.stats 中的 ppf 。

np.random.seed(8309)
n = 100 # number of samples to take
samples = [np.random.normal(loc=0, scale=1, size=100) for _ in range(n)]

fig, ax = plt.subplots(figsize=(10, 7))
for i in np.arange(1, n, 1):
    sample_mean = np.mean(samples[i])  # calculate sample mean
    se = stats.sem(samples[i])  # calculate sample standard error
    h = se*stats.t.ppf((1+0.95)/2, len(samples[i])-1) # calculate t; 2nd param is d.o.f. 
    sample_ci = [sample_mean - h, sample_mean + h]
    if ((sample_ci[0] <= 0) and (0 <= sample_ci[1])):
        plt.plot((sample_ci[0], sample_ci[1]), (i, i), color='blue', linewidth=1);
        plt.plot(np.mean(samples[i]), i, 'bo');
    else:
        plt.plot((sample_ci[0], sample_ci[1]), (i, i), color='red', linewidth=1);
        plt.plot(np.mean(samples[i]), i, 'ro');
plt.axvline(x=0, ymin=0, ymax=1, linestyle='--', label = 'Population Mean');
plt.legend(loc='best');
plt.title('100 95% Confidence Intervals for mean of 0');


plt.show()

在这里插入图片描述

HDFView安装及使用教程 简介:直接用记事本打开hdf5文件的话,是一团乱码。HDFView是用来查看hdf5文件的软件,可以免费使用,好多人都有闪退的情况,这是因为没有添加环境变量。 阅读详情

相关推荐

Cadence OrCAD常见引脚错误排查指南:从原理图到封装的完整解决方案

本文详细解析Cadence OrCAD设计中常见的引脚错误问题,提供从原理图到封装的系统化解决方案。涵盖错误诊断、元件库修复、封装管理及自动化处理技巧,帮助工程师高效解决ORCAP-36022等典型错误,确保设计流程顺畅。

weixin_29294975的博客 258

概率论:计算置信区间

1. 均值、方差、标准差。2.置信区间的计算公式。置信区间是一种常用的区间估计方法,所谓置信区间就是分别以统计量的置信上限和置信下限为上下界构成的区间 。下图来自书本《概率论与数理统计》:参考: https://blog.youkuaiyun.com/alyssa520/article/details/85329083..................

weixin_39450145的博客 6万+

ISO26262 功能安全各个阶段测试要求

1. 开发过程说明 系统层面:包括软硬件集成测试、系统集成测试以及整车测试。 硬件层面:包括硬件集成与测试。 软件层面:单元测试、集成测试。 2. 功能安全总体要求 2.1 各项指标 2.2 诊断覆盖度举例 针对一个信号举例说明: 3. 功能安全测试要求 3.1 测试计划 核心内容应包括, 测试对象:需要测试的对象描述,以及测试的范围描...

AgingMoon的博客 1万+

置信区间(confidence interval)

要理解置信区间,就要从统计学最基本最核心的思想去思考,那就是用样本估计总体。 置信水平(Confidence level)是指总体参数值落在样本统计值某一区内的概率; 而置信区间(confidence interval)是指在某一置信水平下,样本统计值与总体参数值间误差范围。 置信区间越大,置信水平越高。 一、置信区间的概念 1.1 置信区间 置信区间,就是一种区间估计 先来看看什么是点估计,什么是区间估计。 1.1.1 点估计与区间估计 以前很流行一种刮刮卡: 游戏规则是(假设只有一个大奖): 大

Anne033的博客 4万+

EB TRESOS 29.0.0安装教程用于MCAL配置开发

本文介绍的搭建基于NXP官网提供EB软件,进行基于标准AUTOSAR软件底层驱动配置的开发

qq_53260940的博客 1887

Camera metadata

Camera metadata

weixin_42136255的博客 2532

概率论--置信区间和置信度

例如,如果一个研究者计算出某城市居民平均收入的95%置信区间为[5000元, 7000元],这意味着在多次重复抽样并计算置信区间的情况下,有95%的置信区间会包含真实的平均收入值。较高的置信度意味着更宽的置信区间,而较窄的置信区间则意味着较低的置信度。例如,如果置信水平为95%,则表示在多次重复抽样并计算置信区间的情况下,有95%的置信区间会包含真实的总体参数值。其中,点估计值是基于样本数据得出的总体参数的最佳估计,可靠性系数(也称为置信系数)反映了置信区间的可靠程度,标准误差则是衡量估计精度的一个指标。

🌟【AI炼丹师 | 你的数字技术搭子】 大二解锁3200+道友同行👾 1万+

用Multisim仿真AD630锁定放大器:从2012年电赛A题实战到避坑指南

本文详细介绍了如何使用Multisim仿真AD630锁定放大器,从2012年电赛A题实战出发,提供完整的电路搭建、参数优化及避坑指南。重点解析AD630的开关调制架构和双相位检测的工程实现,帮助读者在强噪声背景下有效提取微弱信号,提升电子设计竞赛和工程实践中的信号处理能力。

weixin_42549451的博客 204

置信区间(Confidence Interval)

95%置信区间(Confidence Interval,CI):当给出某个估计值的95%置信区间为【a,b】时,可以理解为我们有95%的信心(Confidence)可以说样本的平均值介于a到b之间,而发生错误的概率为5%。一直做着的不确定性分析,很多时候会涉及到置信区间的概念,但一直没能有个清晰的认识,今天终于从网上查资料,具体核实了置信区间的含义。有时也会说90%,99%的置信区间,具体含义可参考95%置信区间。当求取90% 置信区间时 lower=5 upper=95;置信区间上限:a=M + n。

彬彬侠的博客 8146

学Simulink--基础储能管理场景实例:基于Simulink的储能系统恒流-恒压(CC-CV)充电策略仿真

本文详细介绍了基于Simulink的储能系统恒流-恒压(CC-CV)充电策略仿真方法。CC-CV策略通过恒流阶段快速充电(CC阶段)和恒压阶段防过充(CV阶段)的协同控制,实现了充电效率与电池寿命的平衡。文章系统阐述了CC-CV工作原理、控制架构和Simulink建模步骤,包括Thevenin电池模型搭建、阶段切换逻辑实现和动态电流调节。仿真结果显示,该策略能在3.5小时内完成10Ah电池充电,电压超调<2%,SOC跟踪误差0.8%,能量效率96.2%,显著优于纯CC充电策略。最后提出了多阶段扩展、温

amy_mhd的博客 256

YOLO数据集实现数据增强的方法(裁剪、平移 、旋转、改变亮度、加噪声等)

数据集样本太少怎么办?数据集优质图像不够怎么办?如何做到更好的数据预处理?一文带你学会数据增强,还可实现带标签的扩充。

路人贾的博客 4万+

python 置信区间

置信区间是指由 样本统计量 所构造的总体参数的估计区间。 这句话也就是说 ( 这里统计量一般指均值 ) 利用样本均值来估计总体均值的可靠程度, 这个"可靠程度"用"置信区间"来表示, 置信区间(是一个系数)取值范围为: 0<置信区间<1; 这个置信区间就是用来描述真实的均值发生在某范围的概率 当样本量越大, 则越可靠. 置信区间计算公式: ci = mean±stdN(ppf)...

with_still_water的博客 1万+

Himall商城ExpressDaDaHelper 取消订单(线上环境)

Himall商城ExpressDaDaHelper 取消订单(线上环境)

GZM888888的博客 401

matlab置信区间,置信区间(Confidence Interval)

一直做着的不确定性分析,很多时候会涉及到置信区间的概念,但一直没能有个清晰的认识,今天终于从网上查资料,具体核实了置信区间的含义。95%置信区间(Confidence Interval,CI):当给出某个估计值的95%置信区间为【a,b】时,可以理解为我们有95%的信心(Confidence)可以说样本的平均值介于a到b之间,而发生错误的概率为5%。有时也会说90%,99%的置信区间,具体含义可参...

weixin_39945816的博客 2万+

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

什么是预测区间和置信区间

什么是预测区间和置信区间 最近需要画带有置信区间的拟合图,其中在matlab的doc中搜索“Confidence and Prediction Bounds”,出现了两种置信区间。 原博客:https://www.cnblogs.com/100thMountain/p/5539024.html 置信区间估计 (confidence interval estimate):利用估计的回归方程,对于自变...

weixin_44791014的博客 4万+

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

正态分布 置信区间 威尔逊置信区间(Wilson score interval)

一、正态分布 标准正态分布 标准正态分布就是均值为0,标准差为1的分布,如下图 一般正态分布 一般正态分布n,假设其均值是 μ,标准差为σ ,即服从 n~N(μ,σ) 经过变换可以转换成标准正态分布:另X = (N - μ)/ σ,则X就是服从标准的正态分布了X~N(0,1) 二、置信区间 上图中的面积就是标准正态分布的概率,而置信区间就是变量的区间估计,例如图中的-1到1就是一个置信区间:...

weixin_40901056的博客 7万+

一文快速搞懂对95%置信区间的理解

一文快速搞懂对95%置信区间的理解   综合知乎上各大神的解答和网络资料得到本文对95%置信区间的理解 先给出结论 最常出现的对置信区间的错误理解: 在95%置信区间内,有95%的概率包括真实参数  (错误!!) 在95%置信区下构建的模型,意味着模型参数对于试图近似的函数有95%的概率是真实值的估计值(错误!!) 正确解释应为: 95%置信区间,意味着如果你用同...

13万+

python 置信区间_关于置信区间的完整指南和Python示例

python 置信区间Confidence Interval (CI) is essential in statistics and very important for data scientists. In this article, I will explain it thoroughly with necessary formulas and also demonstrate how to...

weixin_26737625的博客 1万+

深度解析机器学习中的置信区间(附代码)

作者:Jason Brownlee翻译:和中华校对:丁楠雅本文约4000字,建议阅读15分钟。本文介绍了置信区间的概念以及如何计算置信区间和bootstrap置信区间。机...

数据派THU 2万+

用R语言求置信区间

用R语言求置信区间是很方便的,而且很灵活,至少我觉得比spss好多了。 如果你要求的只是95%的置信度的话,那么用一个很简单的命令就可以实现了 首先,输入da=c(你的数据,用英文逗号分割),然后t.test(da),运行就能得到结果了。 我的数据是newbomb t.test(newbomb)得到的结果如下   如果要求任意置信度下的置信区间的话,就需要自己

LittleYearYear的专栏 6万+

如何理解置信区间

置信区间,就是一种区间估计。 先来看看什么是点估计,什么是区间估计。 1 点估计与区间估计 以前很流行一种刮刮卡: 游戏规则是(假设只有一个大奖): 大奖事先就固定好了,一定印在某一张刮刮卡上 买了刮刮卡之后,刮开就知道自己是否中奖 那么我们起码有两种策略来刮奖: 点估计:买一张,这就相当于你猜测这一张会中奖 区间估计:买一盒,这就相当于你猜测这一盒里面会有某一张中奖 很显然区间估计的命中率会更高(当然费用会更高,因为风险降低了)。 接下来,我们看看置信

马同学 8251

置信区间的置信区间_xgboost的置信区间

置信区间的置信区间Gradient Boosting methods are a very powerful tool for performing accurate predictions quickly, on large datasets, for complex variables that depend non linearly on a lot of features. 梯度提升方法是...

weixin_26712065的博客 2574

置信区间的临界值_怎样全面理解95%置信区间

前文我们解释了正态分布和抽样分布,今天终于要开始讲解置信区间了。有不少小伙伴在后台留言希望多讲讲假设检验和置信区间的内容,在此对同学们的关注表示感谢,同时,我们也会尽力加快推文速度。首先,简单回顾一下,抽样分布是针对样本统计量而言的,比如样本均数。在同一个总体中,重复多次抽取样本量为n的多组样本,每一组样本均可计算出一个样本均数,将这些样本均数汇集在一起就获得了所谓的样本均数的抽样分布。...

weixin_39673742的博客 8525

置信区间的概述

置信区间的概述 1、对于具有特定的发生概率的随机变量,其特定的价值区间:一个确定的数值范围(“一个区间”)。   2、在一定置信水平时,以测量结果为中心,包括总体均值在内的可信范围。 3、该区间包含了参数θ真值的可信程度。   4、参数的置信区间可以通过点估计量构造,也可以通过假设检验构造。 关于置信区间的宽窄   窄的置信区间比宽的置信区间能提供更...

weixin_45983644的博客 4118

置信区间的置信区间_什么是置信区间,为什么人们使用它们?

I’m going to try something a little different today, in which I combine two (completely unrelated) topics I love talking about, and hopefully create something that is interesting and educational. 今天,我...

weixin_26713521的博客 2496
上一篇: 回归模型的不稳定性
下一篇: 基于回归分析的股票价格预测
coderpai
博客等级 码龄10年 1082粉丝 469原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值