


所有关于 assignment1 的代码已开源在:
https://github.com/ACEEE-1222/Standford-CS336-Assignment-1
如果对你有帮助的话,记得顺手点个star喔!
在之前的内容中,我们完成了字节级 BPE 分词器的训练部分,得到了词汇表(vocab)和合并规则(merges)。而要让分词器能够实际应用,还需要实现编码和解码功能。本文将详细介绍 Stanford CS336 课程第一个作业中分词器(Tokenizer)的实现过程,包括其核心方法和关键细节。
一、作业要求概述
本次作业的核心任务是实现一个 Tokenizer 类,该类基于训练得到的词汇表(vocab)和合并规则(merges),能够将文本编码为整数 ID 序列,以及将整数 ID 序列解码为文本。同时,需要支持用户提供的特殊符号。
具体要求如下:
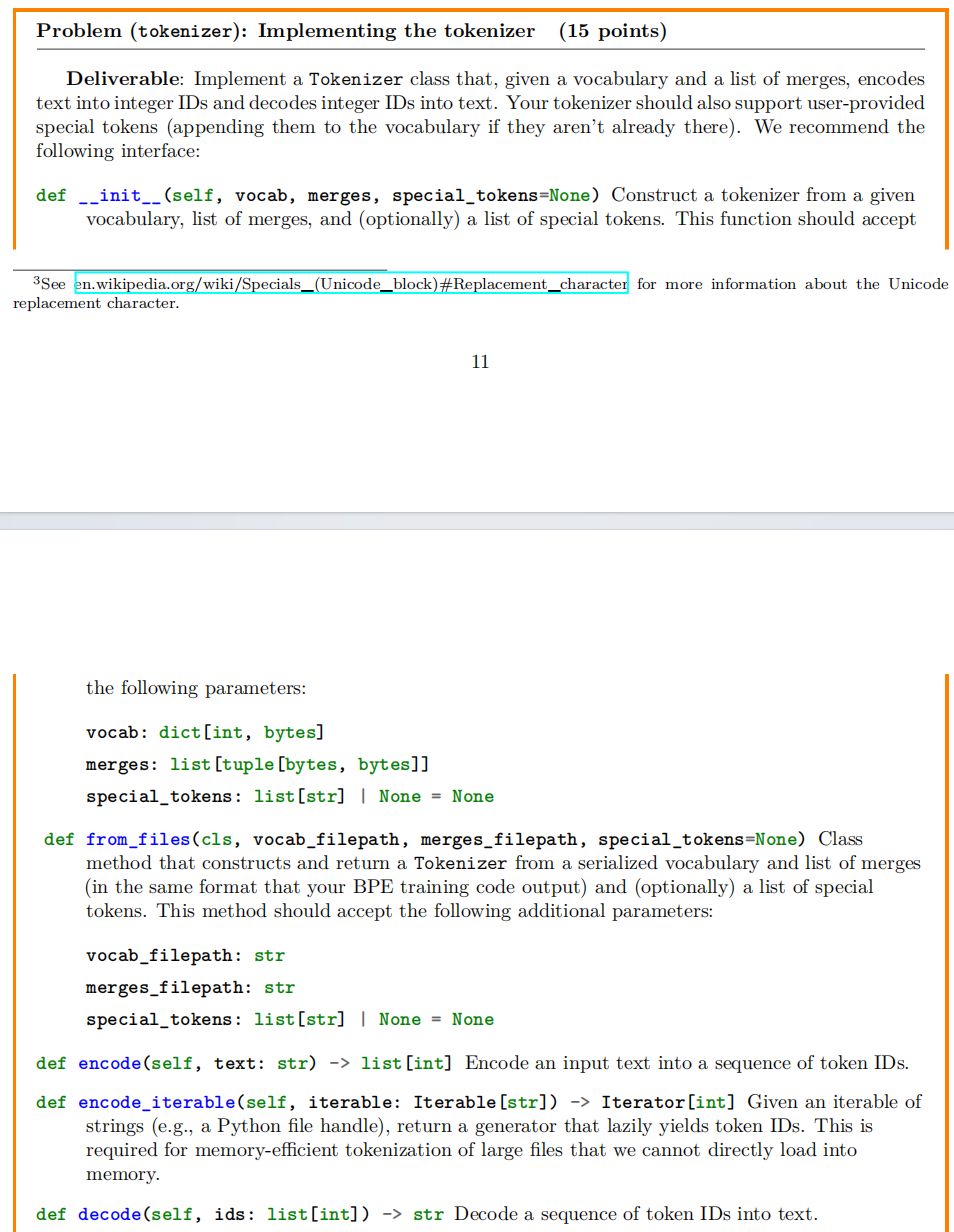
- 编码(encode):将输入的文本字符串转换为 token ID 列表。过程需先进行预分词,再应用 BPE 合并规则。
- 解码(decode):将 token ID 列表转换为文本字符串。对于无效的 token ID,需用 Unicode 替换字符(U+FFFD)处理。
- 支持从文件加载:实现
from_files类方法,从文件加载词汇表和合并规则。 - 支持迭代式编码:实现
encode_iterable方法,支持对大型文件进行内存高效的编码。 - 特殊符号处理:若特殊符号不在词汇表中,需将其添加进去,并在编码中保持独立。
二、Tokenizer 类的实现
1. 类的初始化(__init__ 方法)
def __init__(self, vocab: dict[int, bytes], merges: list[tuple[bytes, bytes]], special_tokens: list[str] | None = None):
    self.vocab = vocab
    self.vocab_reversed = {v: k for k, v in self.vocab.items()}
    self.merges = merges
    self.special_tokens = sorted(special_tokens or [], key=lambda x: -len(x))
初始化方法中我们做了如下工作:
- 存储词汇表、合并规则和特殊符号;
- 构建词汇表的反向映射
vocab_reversed,便于编码时查表; - 对特殊符号按长度降序排序,防止短符号干扰长符号匹配。(在测试样例中有条就是关于这个的)
2. 从文件加载(from_files 类方法)
@classmethod
def from_files(cls, vocab_filepath: str, merges_filepath: str, special_tokens: list[str] | None = None) -> "Tokenizer":
    vocab: dict[int, bytes] = {}
    with open(vocab_filepath, "r", encoding="utf-8") as f:
        for line in f:
            id_str, token_str = line.strip().split("\t")
            vocab[int(id_str)] = token_str.encode("utf-8")

    merges: list[tuple[bytes, bytes]] = []
    with open(merges_filepath, "r", encoding="utf-8") as f:
        for line in f:
            parts = line.strip().split()
            if len(parts) == 2:
                merges.append((parts[0].encode("utf-8"), parts[1].encode("utf-8")))

    return cls(vocab=vocab, merges=merges, special_tokens=special_tokens)
工作流程:
- 加载 vocab.tsv,将每一行的 token ID 和字符串转为
dict[int, bytes]; - 加载 merges.txt,将每一行的合并对转为
tuple[bytes, bytes]; - 返回
Tokenizer实例。
3. 编码方法(encode)
def encode(self, text: str) -> list[int]:
    token_ids = []
    pre_tokens_list = process_chunk((text, self.special_tokens, True))
    for tokens in pre_tokens_list:
        for pair in self.merges:
            a, b = pair
            new_tok = a + b
            new_tokens: list[bytes] = []
            i = 0
            while i < len(tokens):
                if i < len(tokens) - 1 and (tokens[i], tokens[i+1]) == pair:
                    new_tokens.append(new_tok)
                    i += 2
                else:
                    new_tokens.append(tokens[i])
                    i += 1
            tokens = new_tokens
        for token in tokens:
            token_ids.append(self.vocab_reversed.get(token))
    return token_ids
编码流程:
- 调用
process_chunk进行预分词;(注意,在上篇文章的基础上,加入了keep_special_tokens参数,来决定是否在预分词时保留special tokens ) - 对每个预分词 token 应用合并规则;
- 将合并后的 token 映射为 ID。
4. 可迭代对象编码(encode_iterable)
def encode_iterable(self, iterable: list[str]) -> iter:
    for line in iterable:
        token_ids = self.encode(line)
        yield from token_ids
- 用于大规模文本处理,如按行读取大文件;
- 每次处理一行文本,节省内存。
5. 解码方法(decode)
def decode(self, ids: list[int]) -> str:
    tokens = bytes()
    vocab_size = len(self.vocab)
    replacement_char = "\uFFFD"
    for token_id in ids:
        if token_id < vocab_size:
            token = self.vocab[token_id]
        else:
            token = bytes(replacement_char, encoding='utf-8')
        tokens += token
    decoded = tokens.decode(encoding='utf-8', errors='replace')
    return decoded
- 拼接所有字节;
- 使用
errors='replace'容错解码; - 超出词表范围的 ID 使用 U+FFFD 替换。
6. 预分词函数(process_chunk)
def process_chunk(args: tuple[str, list[str], bool]) -> list[list[bytes]]:
    chunk, special_tokens, keep_special_tokens = args
    pattern = "|".join(re.escape(tok) for tok in special_tokens)
    if keep_special_tokens and pattern:
        pattern = f"({pattern})"
    segments = re.split(pattern, chunk) if pattern else [chunk]

    pre_tokens_bytes: list[list[bytes]] = []
    PAT = r"""'(?:[sdmt]|ll|ve|re)| ?\p{L}+| ?\p{N}+| ?[^\s\p{L}\p{N}]+|\s+(?!\S)|\s+"""

    for segment in segments:
        if keep_special_tokens and segment in special_tokens:
            token_bytes = [segment.encode("utf-8")]
            pre_tokens_bytes.append(token_bytes)
        else:
            tokens = [match.group(0).encode("utf-8") for match in re.finditer(PAT, segment)]
            for token in tokens:
                token_bytes = [bytes([b]) for b in token]
                pre_tokens_bytes.append(token_bytes)
    return pre_tokens_bytes
功能说明:
- 正则方式匹配特殊符号与普通 token;
- 普通 token 按字节切分;
- 保证不跨 token 合并。
7. 完整代码
class Tokenizer:
    def __init__(self, vocab: dict[int, bytes], merges: list[tuple[bytes, bytes]], special_tokens: list[str] | None = None):
        """
        Initialize the Tokenizer with a vocabulary, BPE merge rules, and optional special tokens.

        Args:
            vocab (dict[int, bytes]): A mapping from token IDs to byte-encoded tokens.
            merges (list[tuple[bytes, bytes]]): A list of merge operations as tuples of byte pairs.
            special_tokens (list[str] | None): Optional list of user-defined special tokens to include.
        """
        self.vocab = vocab
        self.vocab_reversed = {v: k for k, v in self.vocab.items()}  # bytes: int
        self.merges = merges
        self.special_tokens = sorted(special_tokens or [], key=lambda x: -len(x))

    @classmethod
    def from_files(cls, vocab_filepath: str, merges_filepath: str, special_tokens: list[str] | None = None) -> "Tokenizer":
        """
        Construct a Tokenizer from serialized vocabulary and merges files.

        Args:
            vocab_filepath (str): Path to the vocabulary file (from BPE training).
            merges_filepath (str): Path to the merges file (from BPE training).
            special_tokens (list[str] | None): Optional list of special tokens to include.

        Returns:
            Tokenizer: A Tokenizer instance initialized with the given files.
        """
        vocab: dict[int, bytes] = {}
        with open(vocab_filepath, "r", encoding="utf-8") as f:
            for line in f:
                id_str, token_str = line.strip().split("\t")
                vocab[int(id_str)] = token_str.encode("utf-8")  # store as bytes

        merges: list[tuple[bytes, bytes]] = []
        with open(merges_filepath, "r", encoding="utf-8") as f:
            for line in f:
                parts = line.strip().split()
                if len(parts) == 2:
                    merges.append((parts[0].encode("utf-8"), parts[1].encode("utf-8")))

        return cls(vocab=vocab, merges=merges, special_tokens=special_tokens)

    def encode(self, text: str) -> list[int]:
        """
        Encode an input string into a list of token IDs using the BPE algorithm.

        Args:
            text (str): The input text to tokenize.

        Returns:
            list[int]: A list of token IDs representing the encoded text.
        """
        # byte_special_tokens = [token.encode('utf-8') for token in self.special_tokens]
        token_ids = []
        pre_tokens_list = process_chunk((text, self.special_tokens, True))
        for tokens in pre_tokens_list:
            for pair in self.merges:
                a, b = pair
                new_tok = a + b
                new_tokens: list[bytes] = []
                i=0
                while i < len(tokens):
                    if i < len(tokens) -1 and (tokens[i],tokens[i+1]) == pair:
                        new_tokens.append(new_tok)
                        i += 2
                    else:
                        new_tokens.append(tokens[i])
                        i += 1
                tokens = new_tokens

            for i in range(len(tokens)):
                token_ids.append(self.vocab_reversed.get(tokens[i]))

        return token_ids


    def encode_iterable(self, iterable: list[str]) -> iter:
        """
        Lazily encode an iterable of strings into a stream of token IDs.

        Useful for memory-efficient tokenization of large datasets.

        Args:
            iterable (list[str]): An iterable of strings (e.g., lines from a file).

        Returns:
            iter: A generator that yields token IDs one at a time.
        """
        for line in iterable:
            token_ids = self.encode(line)
            yield from token_ids

    def decode(self, ids: list[int]) -> str:
        """Decode a sequence of token IDs into text."""
        tokens = bytes()
        vocab_size = len(self.vocab)
        replacement_char = "\uFFFD"

        for token_id in ids:
            if token_id < vocab_size:
                token = self.vocab[token_id]
            else:
                token = bytes(replacement_char, encoding='utf-8')   # Replace tokens with Unicode replacement characters if index out of bounds

            tokens += token
        decoded = tokens.decode(encoding='utf-8', errors='replace')

        return decoded
三、测试情况
完成 Tokenizer 实现后,可通过官方测试文件进行验证:
uv run pytest tests/test_tokenizer.py

测试全部通过后,说明实现功能符合预期。
如对实现细节或测试思路有疑问,欢迎评论交流。
 2251


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


