提示工程还没搞懂,上下文工程(Context Engineering)已成大模型新战场

什么是上下文工程 上下文工程(Context Engineering)就像是人工智能时代的“魔法师之手”,它决定了我们与AI互动时,AI能听懂多少、理解多深、最终表现多好。它不仅仅是关于“提示词”那么简单,更是关于。 阅读详情

上下文工程: AI应用核心技术剖析

在人工智能飞速发展的今天,一个新词汇—“上下文工程”(Context-Engineering)正逐渐取代“提示工程”(Prompt-Engineering),成为构建高效 AI 应用的核心关注点。它不仅是 AI 编码助理的新潮流,更是让 AI 真正工作的关键。

一、什么是上下文工程?

虽然“上下文工程”的原理并非全新,但这个术语提供了一个有用的抽象,帮助我们理解构建有效 AI 智能体时面临的最紧迫挑战。简单来说,AI 智能体需要相关上下文才能合理地执行任务。

与传统“提示工程”主要关注如何巧妙措辞和提供指令不同,上下文工程将重点放在如何用最相关的信息填充 LLM 的上下文窗口,无论这些信息来源于何处。它不仅仅是短任务描述,更是“将正确的信息在正确的时间填入上下文窗口的精妙艺术与科学”。Andrej Karpathy 将 LLM 类比为新型操作系统,模型是 CPU,而上下文窗口就是 RAM,上下文工程正是精巧地把对的信息在对的时机塞进上下文窗口的微妙艺术与科学。它就像为 AI 编写一个完整的剧本,而非仅仅一张便条或提词器。

二、上下文的构成要素

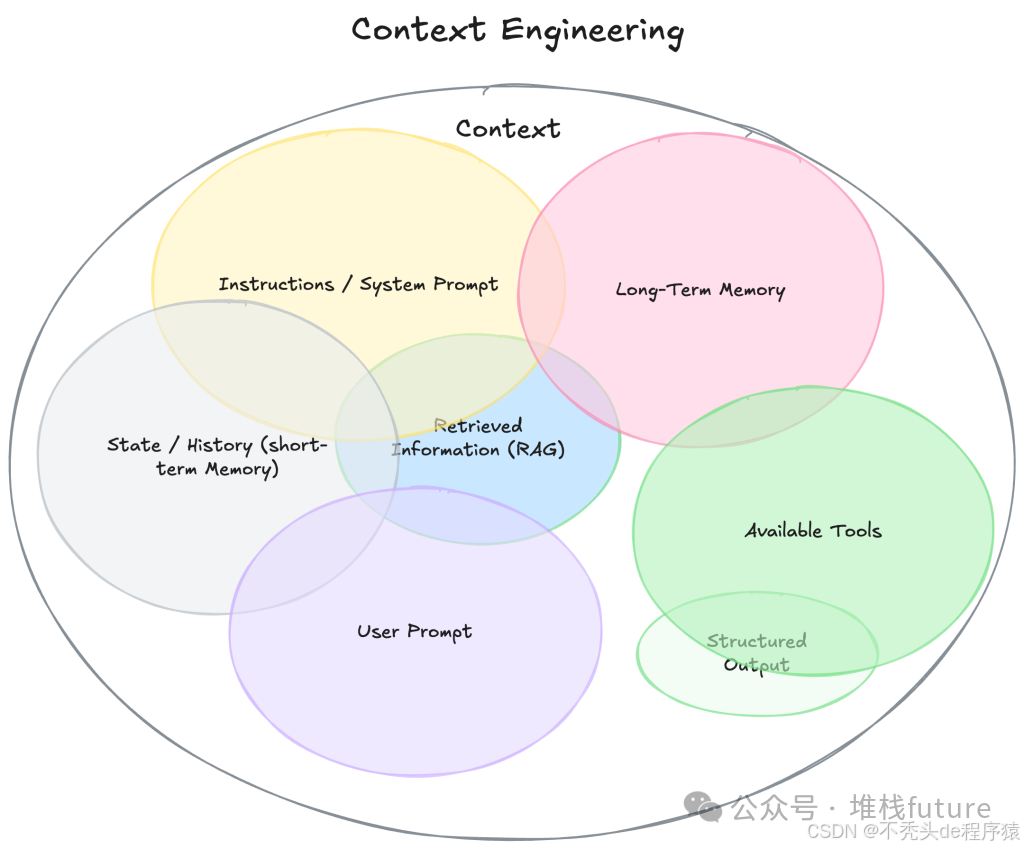
在实际的 AI 智能体或 LLM 应用中,上下文由多种元素组成:

  • 系统提示词/指令(System Prompt/Instruction):为智能体设定场景,定义模型行为的初始指令和风格,明确其任务类型。
  • 用户输入(User Input):用户的具体问题或任务请求。
  • 短期记忆或聊天历史(Short Term Memory / Chat History):提供 LLM 关于当前对话的上下文,包含用户和模型的所有回应。
  • 长期记忆(Long-Term Memory):用于存储和检索长期聊天历史或其它相关信息,例如跨对话的用户偏好、过去对话摘要、被告知要记住的事实等。
  • 从知识库中检索的信息(Information retrieved from a knowledge base):通过 RAG(Retrieval Augmented Generation)技术从数据库、API 调用、MCP 工具或其它外部来源检索到的相关信息。
  • 工具及其定义(Tools and their definitions):向 LLM 提供它可访问的工具的额外上下文。
  • 工具的响应(Responses from tools):工具运行后返回给 LLM 的结果,作为新的上下文供其继续工作。
  • 结构化输出(Structured Outputs):定义模型回应的格式,也可以反过来提供凝练的结构化信息作为特定任务的上下文。
  • 全局状态/工作流上下文(Global State/Workflow Context):特别适用于 LlamaIndex 构建的智能体,可作为暂存器,在智能体步骤中存储和检索全局信息,或在多步骤 Agent/Workflow 中暂存任务进度、先前结果等。

所有这些元素的某种组合构成了几乎所有智能体 AI 应用程序中底层 LLM 的上下文。
在这里插入图片描述

三、上下文工程的重要性

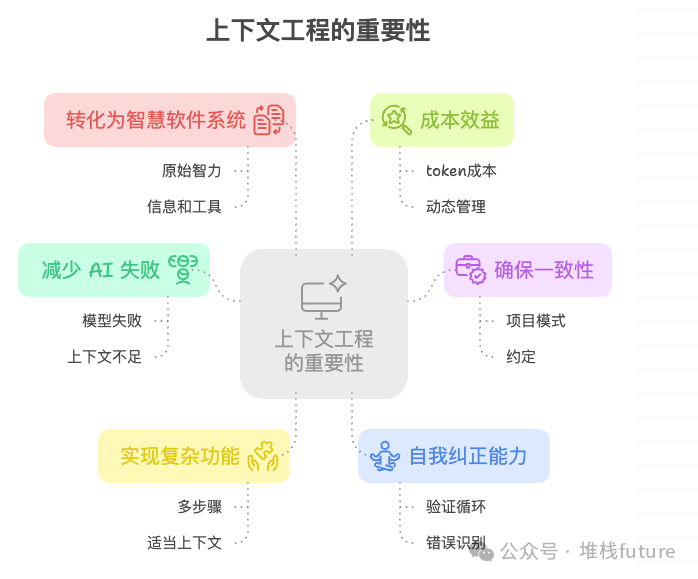
上下文工程之所以如此重要,原因在于它能显著提升 AI 系统的性能和可靠性:

  • 减少 AI 失败:大多数智能体失败并非模型本身的失败,而是上下文提供的不足或不当。
  • 确保一致性:通过提供全面的上下文,AI 能更好地遵循项目模式和约定。
  • 实现复杂功能:AI 能够处理多步骤的复杂实现,得益于适当的上下文。
  • 自我纠正能力:结合验证循环,AI 能够识别并修正自身的错误。
  • 将“原始智力”转化为“智慧软件系统”:LLM 的“智力”只是基石,要使其真正有效,必须通过上下文工程提供其所需的所有信息和工具。
  • 成本效益:上下文并非免费,每个 token 都有成本,并且会影响模型行为。因此,动态管理上下文能有效优化成本和性能。
图片
在这里插入图片描述

四、上下文工程的技术与策略

鉴于上下文构成的复杂性,上下文工程面临两大挑战:选择正确的上下文和让上下文适应上下文窗口限制。以下是一些关键的架构选择和策略:

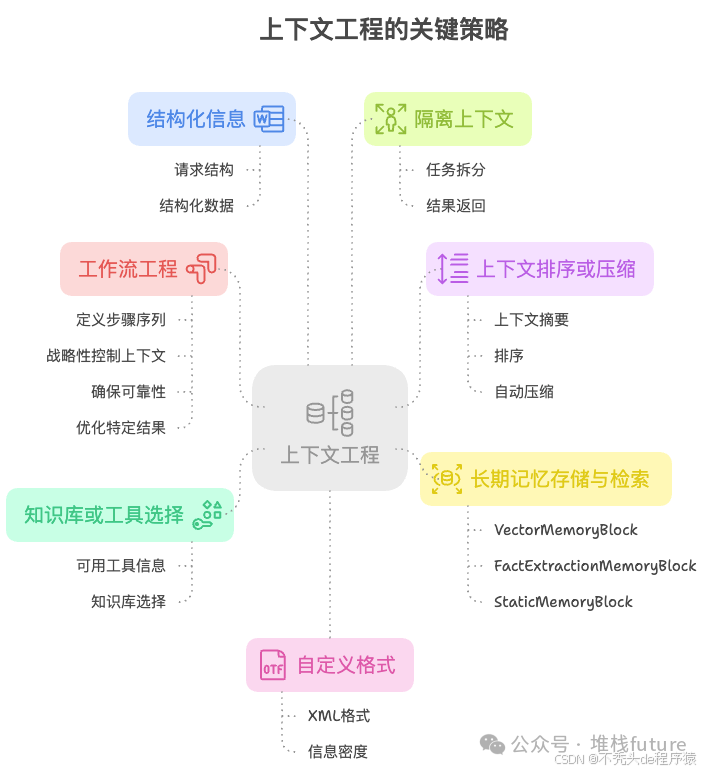
  1. 知识库或工具选择(Knowledge base or tool selection): 与仅针对单一知识库(如向量存储)进行问答的 RAG 应用不同,现在的智能体应用通常需要访问多个知识库和工具。智能体首先需要关于可用工具或知识库的信息,这是确保智能体选择正确资源的关键上下文。
  2. 上下文排序或压缩(Context ordering or compression): 由于上下文窗口的限制,需要最大化利用有限空间。技术包括:
    • 上下文摘要:在检索步骤后对结果进行摘要,再添加到 LLM 上下文中。
    • 排序:在某些情况下,信息的顺序也很重要,例如当信息的日期高度相关时,通过排序步骤可以确保 LLM 收到最相关的信息。
    • 自动压缩(Auto-compact):例如 Claude Code 在上下文窗口超过 95% 时,会执行自动压缩,总结当前状态并重新开始。
  3. 长期记忆存储与检索(Long-term memory storage and retrieval): 对于需要持续对话的应用,对话历史本身就是上下文。LlamaIndex 提供了多种长期记忆实现方式,例如:
    • VectorMemoryBlock:从向量数据库存储和检索聊天消息。
    • FactExtractionMemoryBlock:从聊天历史中提取事实。
    • StaticMemoryBlock:存储静态信息。 选择合适的长期记忆类型以及它应返回多少上下文,是构建智能体时的重要决策。
  4. 结构化信息(Structured Information): 避免提供所有不必要的上下文是常见错误。结构化输出能显著提高提供给 LLM 上下文的相关性:
    • 请求结构:向 LLM 提供一个 schema,要求其输出符合该 schema。
    • 作为额外上下文提供的结构化数据:以凝练的方式提供相关上下文,避免上下文过载。 LlamaExtract 等工具可以从复杂文件中提取最相关的数据,然后将这些结构化输出用作下游智能体应用的精简上下文。
  5. 工作流工程(Workflow Engineering): 虽然上下文工程关注优化每次 LLM 调用中的信息,但工作流工程则更宏观地考虑“需要什么样的 LLM 调用序列和非 LLM 步骤才能可靠地完成工作?”。它能从根本上优化上下文:
    • 定义明确的步骤序列:规划复杂任务所需任务的确切流程。
    • 战略性控制上下文:精确决定何时调用 LLM,何时使用确定性逻辑或外部工具。
    • 确保可靠性:内置验证、错误处理和回退机制。
    • 优化特定结果:创建专门的工作流,持续交付业务所需结果。 从上下文工程的角度来看,工作流至关重要,因为它们可以防止上下文过载。通过将复杂任务分解为专注的步骤,每个步骤都有自己的优化上下文窗口,而不是将所有内容塞入一个 LLM 调用。
  6. 隔离上下文(Isolating Context): 通常出现在多智能体(Multi-Agents)的实现中。任务可以拆分到另一个子智能体(Sub Agent)去执行,执行完成后只返回结果,从而大大节省主智能体的上下文用量。
  7. 自定义格式(Custom Formats): 不一定需要遵循模型厂商预设的 message-based 格式。可以为特定使用场景创建优化的上下文格式,例如将上下文用 XML 格式都塞到单一用户提示中,以获得最大的信息密度,用更少的 Token 传递相同信息。
在这里插入图片描述

五、实践:利用模板进行上下文工程

要将上下文工程付诸实践,我们可以参考一些优秀的项目,例如coleam00/context-engineering-intro这个 GitHub 仓库。它提供了一个全面的上下文工程模板,旨在帮助用户为 AI 编码助手设计和工程化上下文,使其能够端到端地完成工作。该模板以 Claude Code 为中心,但其策略可应用于任何 AI 编码助手。 该模板强调:上下文工程比提示工程优秀 10 倍,比“vibe coding”优秀 100 倍。它是一个完整的系统,用于提供全面的上下文,包括文档、示例、规则、模式和验证。 其模板结构包括:

  • .claude/commands/:定义自定义命令,如generate-prp(生成综合性 PRP)和 execute-prp(执行 PRP 以实现功能)。
  • PRPs/:存放PRP(Product Requirements Prompts),这是一种综合的实现蓝图,包含完整上下文、文档、实现步骤、验证、错误处理模式和测试要求。
  • examples/:存放代码示例,这对于成功至关重要,AI 编码助手在有模式可循时表现更好。
  • CLAUDE.md:定义项目范围内的全局规则,如项目意识、代码结构、测试要求、风格约定和文档标准。
  • INITIAL.md:用于描述初始功能请求,包含功能描述、示例引用、相关文档链接和其它注意事项。

整个工作流程大致如下:

  1. 设置全局规则:在CLAUDE.md中定义项目范围的规范。
  2. 创建初始功能请求:编辑INITIAL.md,详细描述要构建的功能。
  3. 生成 PRP:使用/generate-prp INITIAL.md命令,该命令会阅读功能请求、研究代码库、搜索相关文档,并生成一份全面的 PRP 文档。
  4. 执行 PRP:使用/execute-prp PRPs/your-feature-name.md命令,AI 编码助手会阅读 PRP 中的所有上下文,创建详细的实现计划,执行每个步骤并进行验证,运行测试并修复问题,确保满足所有成功标准。

这种方法大大减少了 AI 智能体的失败,确保了一致性,并使复杂功能的实现成为可能。

结语

上下文工程已经成为 AI 时代更重要的能力。它意味着提示工程师需要转型,可以转变为上下文工程师。这种工程思路要比vibe coding更具流程性和专业性。未来,无论是构建复杂的智能体还是优化现有的 AI 应用,理解并精通上下文工程都将是 AI 工程师的核心竞争力。它将解放工程师,并让人们能够更直观、更强大地控制计算机,实现真正的人机协作。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

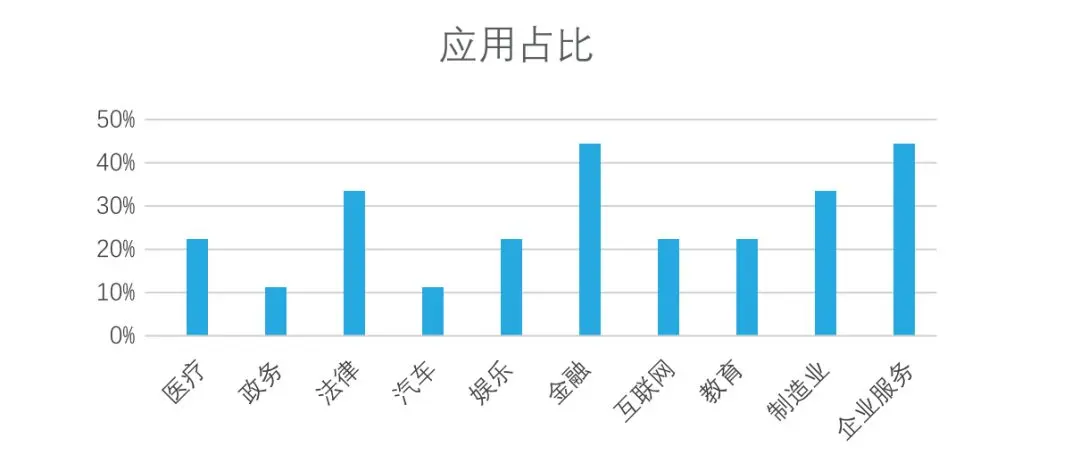
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
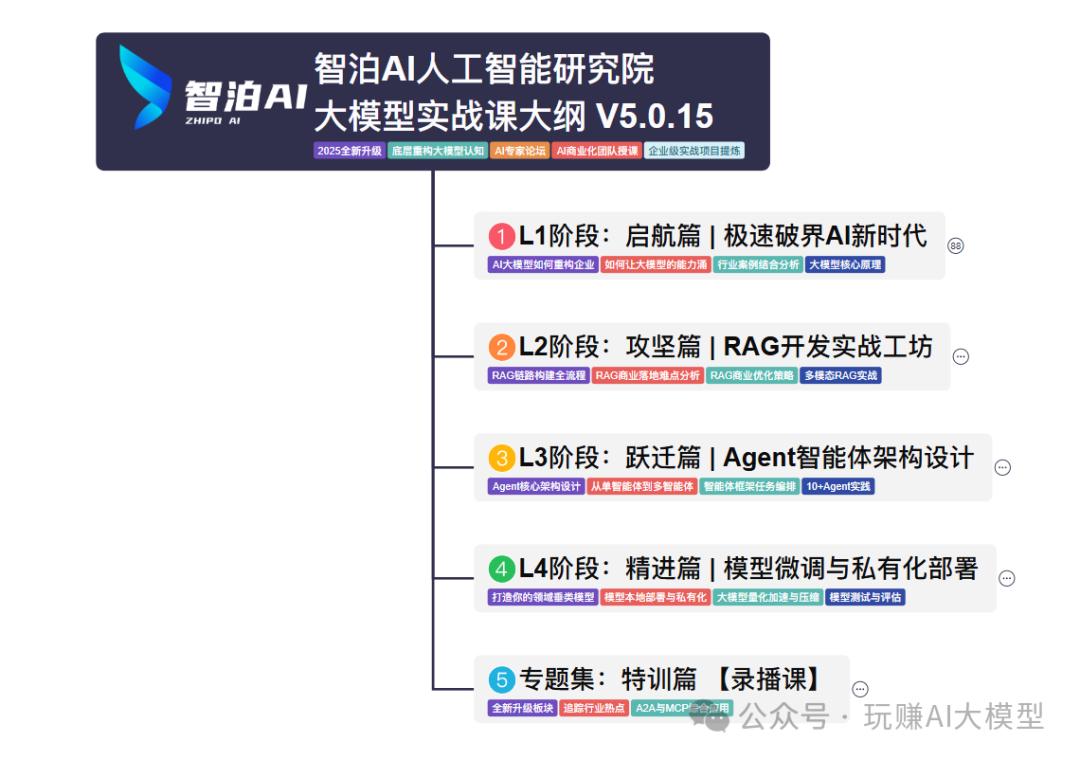
图片

  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

Python:同花顺全数据接口 # -*- coding: utf-8 -*- from iFinDPy import * from datetime import datetime import pandas as pd import time as _time import json from threading import Thread,Lock,Semaphore import requests sem = Semaphore(5) # 此变量用于控制最大并发数 dllock = Lock() #此变量用来控制实时行情推 阅读详情

相关推荐

MTK pwm beeper配置记录

如果正常,系统启动后会在/dev/input下生成 一个event节点,使用方法参考标准linux使用。dts相关修改如下,全都在里面,注意一下位置。对应的配置文件中增加如下定义。

hclydao的专栏 729

Context Engineering:重构大模型信息注入的工程范式

Context Engineering 是面向大语言模型应用落地的核心工程方法,它超越传统 Prompt Engineering 的语言优化范畴,聚焦于信息如何高保真、低衰减、有时序与空间锚点地注入模型上下文。其本质是解决模型‘看不见关键信息’这一根本瓶颈,通过结构化编码、动态调度与语义加固,提升事实召回率与逻辑一致性。在 RAG、Agentic 系统、Geo-AI 等高频场景中,它已成为保障 context window 有效利用率的关键技术路径,尤其适用于交通预测、政策问答、多源异构文档理解等强时空约束

weixin_34280237的博客 388

小白跑WRF第三天,安装三方依赖库

小白跑WRF第三天,安装三方依赖库各类安装包的准备 各类安装包的准备 官网教程:https://www2.mmm.ucar.edu/wrf/OnLineTutorial/compilation_tutorial.php 根据官网教程需要的安装包有以下几个 系统环境 用途 zlib-1.2.7 zlib是提供数据压缩用的函式库。 netcdf-4.1.3 读nc文件的。 mpich-3.0.4 用于并行运算的工具。 libpng-1.2.50 libpng是一款C语言编写的比较底层

weixin_42372313的博客 1万+

一文搞懂:大语言模型的上下文工程(Context Engineering for Large Language Models)是什么?

一文搞懂:大语言模型的上下文工程(Context Engineering for Large Language Models)是什么?

2301_76168381的博客 1117

KNX智能家居工程设计应用

KNX,是一个起源于欧洲的总线标准,主要应用于家居和楼宇中,对末端电气设备进行总线式的控制,比如照明、空调、地暖、电动窗帘和遮阳设备等等。根据2017年英国著名咨询公司BSRIA的数据报告显示,在中国的智能家居和灯光控制市场,KNX产品的市场份额为各类产品中排名第一,占据了42%的市场份额,远远领先于其他的标准协议。设备中一个继电器表示一路输出,某些功能可能需要用到多个输出,比如1个窗帘AC输出需要占用两路继电器输出,一个继电器用于控制正转,一个用于控制反转,而普通开关输出则需要占用一路继电器输出即可。

hhhh5555666的博客 935

pycharm下载continue插件接入DeepSeek的API,向其提问输出乱码,如何解决?

🏆本文收录于 《全栈Bug调优(实战版)》 专栏,该专栏专注于分享我在真实项目开发中遇到的各类疑难Bug及其深层成因,并系统提供高效、可复现的解决思路和实操方案。无论你是刚入行的新手开发者,还是拥有多年项目经验的资深工程师,本专栏都将为你提供一条系统化、高质量的问题排查与优化路径,助力你加速成长,攻克技术壁垒,迈向技术价值最大化与职业发展的更高峰🚀!

**My Coding Family** 2231

LLM开发者必看|上下文工程详解:让你的模型更“聪明”

随着大语言模型(LLM)的快速发展,从GPT-3到ChatGPT,再到Claude、GPT-4等更强大的模型,我们见证了一个重要趋势:上下文窗口的不断扩大。早期的模型可能只能处理几千个token,而现代模型已经能够处理数十万甚至数百万个token的上下文。为解决这些问题,上下文工程(Context Engineering)作为专门优化模型输入信息质量的技术体系应运而生,本文将从以下方面介绍:

dmx123789的博客 1206

大模型角色提示词写得再严密,也能被绕过?我用攻击者思维把自己吓了一跳!

很多人以为提示词是“只要写清楚了,模型就能理解”,但实际上——模型并不具备严格的规则意识,它只是在预测下一句话。所以我们必须从“攻防”角度出发,设计更强的防护机制。我这次就是亲身踩坑,用红队思维模拟攻击,才意识到原来提示词注入这么容易中招。你如果也在做 AI 应用、角色系统、提示词驱动的功能,建议你也用类似方式测试一下,不然被绕了都不知道。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 1032

深入理解上下文工程(Context Engineering):从入门到精通

想象这样一个场景:你正在用ChatGPT帮助分析一份50页的市场调研报告。开始时,AI的回答精准到位,但随着对话深入,你发现它开始"健忘"——忘记了报告中的关键数据,甚至开始给出与前面矛盾的建议。这不是AI模型本身的问题,而是遇到了上下文管理的挑战。

2401_85373691的博客 1838

LangGraph实战训练营-打造 WhatsApp 全自动消息收发AI智能助手

本文系统梳理了项目架构(WhatsApp Bridge + Talon Host + LangGraph Agent Harness三层设计)、完整环境搭建流程(Docker/本地双模式部署)、核心原理(WhatsApp桥接机制、NVIDIA Parakeet语音转录管线、Cron定时调度、Agent图状状态机),并提供了基础对话、文件操作、语音处理、定时任务等六大实战示例。同时涵盖安全策略、性能优化、数据备份等生产级运维实践,以及十个高频问题的排查方案。

program哲学 195

【超详细】MIT 液态神经网络(LNNs)——深度学习新动向

输入可以是任何形式的时间序列数据,其中表示时间。例如传感器读数、金融市场数据、语音信号等。

allein_STR的博客 2615

别再死磕提示词工程了!上下文工程才更关键,一文看懂上下文工程到底是什么?

别再死磕提示词工程了!上下文工程才更关键,一文看懂上下文工程到底是什么?

m0_48891301的博客 1334

27、视网膜血管识别与分类的数据集和验证过程

本文介绍了视网膜血管自动识别与分类方法所使用的数据集及其验证过程。通过30张高分辨率的近红外反射视网膜图像,结合专业医生的手动标注结果,构建了包含597个血管段的基准数据集。研究采用准确率、召回率、F1分数和混淆矩阵等评估指标对模型进行验证,并提出了特征增强和分类器优化策略以提升性能。实验结果显示,该方法在复杂区域具有较强的鲁棒性和较高的准确性,为临床应用提供了可靠的依据。

i7j8k9l的博客 148

Harness Engineering:Agent 时代,工程师的新战场

关注 AI 的同学大概率对这两个词已经不陌生了:提示词工程(Prompt Engineering)和上下文工程(Context Engineering)。前者教你怎么跟模型说话,后者教你往模型的上下文窗口里塞什么内容。但从 2026 年初开始,一个新的词开始在工程圈里流传——**Harness Engineering**。

Python_cocola的博客 520

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

AI应用核心转向Context Engineering

—从“快餐式提问”到“米其林级喂料”的认知升级。

微信公众号:互联网之路 743

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

如何为AI智能体构建高效的上下文工程(Context Engineering)?

摘要:随着AI智能体从单次问答转向复杂长周期任务,上下文工程正取代提示工程成为核心技术。研究表明,大模型的注意力资源有限,过载会导致性能衰减,因此关键在于用最小最密的信息集精准引导模型行为。文章提出三大策略:压缩冗余信息、结构化笔记实现跨会话记忆、子智能体架构分工协作。未来AI应用的竞争焦点将从模型规模转向上下文管理能力,法律、金融等长周期领域将成为主战场。核心原则是"最好的提示是让模型不需要看太多提示",这要求开发者放弃信息过载思维,构建更智能的信息筛选系统。

817

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

Context Engineering:AI上下文结构化与可信度工程实践

在大模型应用落地中,'上下文管理'正从简单拼接文本升级为系统级工程——这本质上是面向AI工作流的数据库思维重构。其核心在于将非结构化输入转化为具备Schema定义、可信度锚定、意图对齐能力的可验证契约,解决传统Prompt Engineering无法应对的幻觉、噪声敏感、长程依赖衰减等顽疾。关键技术包括上下文结构化四层框架(Schema/关系/规则/契约)、多维可信度证据链(新鲜度/权威性/证据强度/一致性)以及声明式意图-上下文对齐机制。该范式已广泛应用于金融合规问答、ERP智能审批、医疗知识推理等强约束

weixin_30740295的博客 437

Prompt Engineering与Context Engineering:后端工程师构建AI应用的核心差异与实战指南

在构建集成大模型的AI应用时,理解提示工程与上下文工程的区别至关重要。提示工程关注单次交互的输入优化,通过精心设计的指令引导模型输出,属于自然语言处理中的基础技巧。而上下文工程则是一套系统工程,旨在解决无限增长的信息与有限模型上下文窗口之间的矛盾,其核心在于构建高效、稳定的对话记忆管理系统。从技术原理看,这涉及向量检索、对话历史压缩、外部知识库集成等关键技术,其价值在于能显著提升AI应用在多轮对话和长文档处理中的性能,并有效控制API调用成本。在实际应用场景中,后端开发者需设计检索增强生成架构、选择向量数据

weixin_34006468的博客 338

Context Engineering:AI推理的事实基底与工程化实践

在大模型能力趋同的今天,决定AI输出质量的核心已从Prompt转向Context——它不再是提示词的补充信息,而是模型推理所依赖的事实基底、逻辑约束与可信边界。Context Engineering本质是将非结构化知识转化为可计算、可验证、可运维的工程对象,涵盖数据切分、语义标注、规则嵌入与动态保鲜四大维度。其技术价值在于突破token经济瓶颈、抑制语义漂移、承载实时知识,广泛应用于金融合规、智能客服、法律合同等强准确率与高可信度场景。本文聚焦生产级落地,详解如何用结构化schema、轻量模式标注与可执行规

weixin_30267785的博客 449

LLM - AI Agent的上下文工程(Context Engineering)不完全指北

本文探讨了AI Agent从Demo到生产环境面临的核心挑战——上下文工程(Context Engineering)。文章指出,当前AI系统的主要瓶颈不在于模型能力,而在于如何高效管理上下文窗口中的信息流动。作者分析了上下文窗口的本质限制,揭示了四种典型失败模式(污染、分散、混淆、冲突),并提出了构建生产级AI Agent的六大支柱框架:Agent编排中枢、查询增强、智能检索、提示技术、记忆系统和工具集成。文章强调,上下文工程是确保AI系统在真实场景中保持稳定性和可靠性的关键,需要从战略层面设计信息的选择、

小工匠 2234

Context Engineering:重构大模型输入层的四大杠杆与七步工作流

Context Engineering 是大语言模型应用中决定效果上限的关键技术,它超越传统 Prompt Engineering,聚焦于输入上下文的结构设计、信息密度调控、时序编排与信噪比优化。其核心原理在于构建模型可高效解码的‘认知脚手架’,通过语义结构化、高密度表达、首尾强化和噪声过滤,显著提升准确率、降低幻觉并加速响应。该技术广泛应用于企业级问答系统、RAG增强、政务智能客服及金融合规咨询等强准确性与可溯源性要求的场景,是当前大模型落地从‘能用’迈向‘好用’的核心工程能力。

afeyfre41671的博客 421

一文读懂Anthropic的Context Engineering核心基础知识

别再只卷 Prompt 了:Anthropic 这篇 Context Engineering,把 AI Agent 的真问题讲透了

Rocky Ding相信人工智能、数据科学、商业逻辑、金融工具、终身成长以及顺应时代的潮流会赋予我们超能力。 1021

从Prompt到Agent再到Context:大模型应用的三代控制范式演进

在人工智能领域,如何有效管理和控制复杂模型的能力,是工程实践中的核心挑战。这涉及到从基础的概念交互到系统级架构设计的演进。其基本原理在于,随着模型能力的增强,需要更高级的抽象层来确保其行为的可靠性、可控性和可扩展性。这一过程的技术价值在于将前沿的AI能力转化为稳定、可用的生产级应用。典型的应用场景包括智能客服、代码助手、数据分析等需要复杂推理和工具调用的任务。本文聚焦于大模型应用的演进脉络,探讨了从初期的Prompt Engineering(提示工程),到赋予模型行动与记忆的Agent(智能体)框架,再到精

weixin_30571465的博客 337

LLM - 从 Prompt 到 Context:2026 Agent 时代的核心战场

2025年大模型Agent从概念走向爆发,但多数产品仍停留在Demo阶段。Anthropic在AWS re:Invent上提出了2026年Agent发展的三大方向:更强的模型能力、可长时运行的Agent以及GUI操作能力,并提出以Context Engineering为核心的方法论。关键突破包括模型能力显著提升(SWE-bench得分从49%到80%)、成本逻辑从单价思维转向任务总成本思维,以及安全能力的强化。Agent与传统Workflow的根本区别在于运行时决策权归属,其本质是"模型+工具+循

小工匠 4009

AI应用开发核心:Prompt工程与Context工程的区别与实战协同

在构建基于大语言模型(LLM)的智能应用时,提示工程(Prompt Engineering)与上下文工程(Context Engineering)是两项核心的工程化能力。提示工程专注于如何设计指令和示例,以引导模型更好地理解和执行任务,其本质是优化与模型的交互方式。上下文工程则侧重于如何高效地为模型筛选、组织和注入外部知识,通常通过检索增强生成(RAG)等技术实现,旨在扩展模型的知识边界并提升回答的准确性与时效性。从技术价值看,前者以极低的额外资源开销提升模型在已知知识范围内的输出质量与风格;后者则通过引入

weixin_30740581的博客 362

Context Engineering:构建大模型可验证语义坐标系的七道工业级工序

在大模型应用落地中,context engineering 是指对输入数据进行结构化、可验证、有时空坐标的系统性治理,其核心在于解决‘模型该基于什么事实作答’这一基础问题。它超越传统RAG中的简单文本检索,涵盖结构化锚定、语义消歧与逻辑缝合等关键技术原理,显著提升模型在金融、医疗、法务等高风险场景下的准确性、鲁棒性与可审计性。相比依赖语言指令的prompt engineering,context engineering 通过可信度分级、时空坐标注入、实体关系标准化等工程手段,将原始业务数据转化为机器可理解、

weixin_30258901的博客 373
上一篇: 大模型训练入门:SFT 是什么?它和七大相关技术的核心区别到底是什么?
下一篇: 深度解读企业级AI架构:MCP协议与混合智能体开发
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1482原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值