大模型训练入门:SFT 是什么?它和七大相关技术的核心区别到底是什么?

展会客流统计的客流统计系统,WiFi客流每时每客 一般展会的举行时间都在3-7天之间,展会作为市场部门一项重要工作,一直以来没有一项有效的工具能够提供数据支持。 展会最重要的是通过活动和产品来吸引参展者的参观,如何统计展会期间的客流量呢?如何通过将数据转化成为活动数据的支撑呢? 目前成熟的解决方案有,视频客流统计、WiFi客流统计、红外线客流统计等方式。由于展会通常的时间都比较短,视频、红外线客流统计采购及安装价格都比较高,需 阅读详情

作为AI领域的从业者,我们每天都在与各种模型优化技术打交道。今天想和大家深入聊聊大模型训练中一个核心技术——SFT(监督微调),以及它与其他常用技术的区别。很多刚入行的朋友经常会混淆这些概念,希望通过这篇文章能帮大家理清思路。

什么是SFT?

监督微调(SFT)是大模型训练流程中的关键一步,它就像是给通用大模型"上专业课"——在预训练的基础上,通过特定领域的标注数据进一步训练模型,使其在特定任务上表现更优。业内大佬常说:“预训练让模型识字,SFT让模型懂行”。

SFT与七大相关技术的核心区别

1. SFT vs 预训练

维度SFT预训练
目标提升特定领域能力获得通用语言理解能力
数据量2K-10W样本海量数据(通常数十亿tokens)
训练方式监督学习自监督学习(next token prediction)

2. SFT vs RLHF

这是最容易混淆的一对概念,业内大佬总结了四个核心区别:

  1. 目标不同:SFT提升特定领域能力,RLHF让模型输出更符合人类意图
  2. 学习方式:SFT是监督学习,RLHF是强化学习
  3. 反馈机制:SFT只给正向示例,RLHF可提供负反馈纠错
  4. 优化粒度:SFT优化单个token,RLHF优化整个语句

3. SFT vs RAG

技术原理优势劣势适用场景
SFT模型参数微调底层认知对齐、延迟低可能导致模型遗忘、数据静态定制能力、固定知识库
RAG外挂知识库检索动态数据、可解释性高仅表层特征提取、依赖检索质量实时信息、动态知识库

4. SFT vs Continue-pretrain

增量预训练(Continue-pretrain)和SFT都属于模型优化,但定位完全不同:

  • 时机不同:增量预训练在预训练之后,SFT之前
  • 数据量:增量预训练需要的数据量远大于SFT
  • 应用场景:当基础模型与目标领域差异极大时才考虑增量预训练,99%的情况都不需要

5. SFT vs In-context learning

In-context learning(上下文学习)就是我们常说的"提示词工程",它与SFT的核心区别在于:

  • 参数是否变化:SFT修改模型参数,提示词工程不修改参数
  • 持久化:SFT的效果是永久的,提示词的效果是临时的
  • 资源需求:SFT需要训练资源,提示词工程只需推理资源

6. SFT vs LoRA/PEFT

很多人会问:"现在都用LoRA了,还要全量SFT吗?"业内大佬的回答是:“看场景”。

全参数SFT精度上限更高,但资源消耗大;PEFT(参数高效微调)如LoRA只需训练少量参数,节省资源,但精度略低。实际应用中,大厂通常会先用全量SFT做基础模型,再用LoRA做领域适配。

7. SFT vs Prompt tuning

Prompt tuning是另一种参数高效微调方法,它与SFT的区别在于:

  • 训练对象:Prompt tuning只训练提示词相关参数,SFT训练模型全部或大部分参数
  • 适用场景:Prompt tuning适合迁移学习,SFT适合深度定制

SFT的核心挑战:数据决定一切

业内有个共识:SFT从业者95%的时间都在处理数据。高质量的训练数据是SFT成功的关键。有位资深工程师分享经验:“之前调了很久模型效果都上不去,最后老老实实人工清洗数据,效果立刻就稳定了”。

SFT数据构建有三个关键点:

  1. 格式统一:所有数据使用相同的JSON格式,包括markdown风格、缩进等
  2. 质量优先:Meta的LIMA论文证明,1万高质量样本足以达到良好效果
  3. 多样性:要刻意增加任务多样性和表达方式多样性,甚至加入noisy prompt提升抗噪性

写在最后

SFT是连接通用大模型与行业应用的桥梁,理解SFT及其与其他技术的区别,是做好大模型落地的基础。记住业内大佬的忠告:“不要迷恋调参技巧,数据质量才是王道”。

普通人如何抓住AI大模型的风口?

领取方式在文末

为什么要学习大模型?

目前AI大模型的技术岗位与能力培养随着人工智能技术的迅速发展和应用 , 大模型作为其中的重要组成部分 , 正逐渐成为推动人工智能发展的重要引擎 。大模型以其强大的数据处理和模式识别能力, 广泛应用于自然语言处理 、计算机视觉 、 智能推荐等领域 ,为各行各业带来了革命性的改变和机遇 。

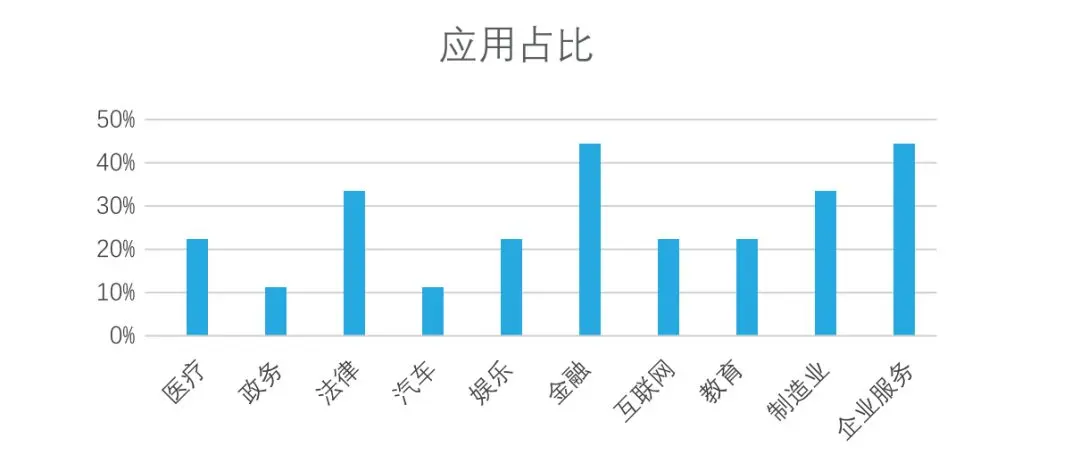
目前,开源人工智能大模型已应用于医疗、政务、法律、汽车、娱乐、金融、互联网、教育、制造业、企业服务等多个场景,其中,应用于金融、企业服务、制造业和法律领域的大模型在本次调研中占比超过 30%。
在这里插入图片描述

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

在这里插入图片描述

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

最后

只要你真心想学习AI大模型技术,这份精心整理的学习资料我愿意无偿分享给你,但是想学技术去乱搞的人别来找我!

在当前这个人工智能高速发展的时代,AI大模型正在深刻改变各行各业。我国对高水平AI人才的需求也日益增长,真正懂技术、能落地的人才依旧紧缺。我也希望通过这份资料,能够帮助更多有志于AI领域的朋友入门并深入学习。

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发
在这里插入图片描述

大模型全套学习资料展示

自我们与MoPaaS魔泊云合作以来,我们不断打磨课程体系与技术内容,在细节上精益求精,同时在技术层面也新增了许多前沿且实用的内容,力求为大家带来更系统、更实战、更落地的大模型学习体验。

图片

希望这份系统、实用的大模型学习路径,能够帮助你从零入门,进阶到实战,真正掌握AI时代的核心技能!

01 教学内容
图片

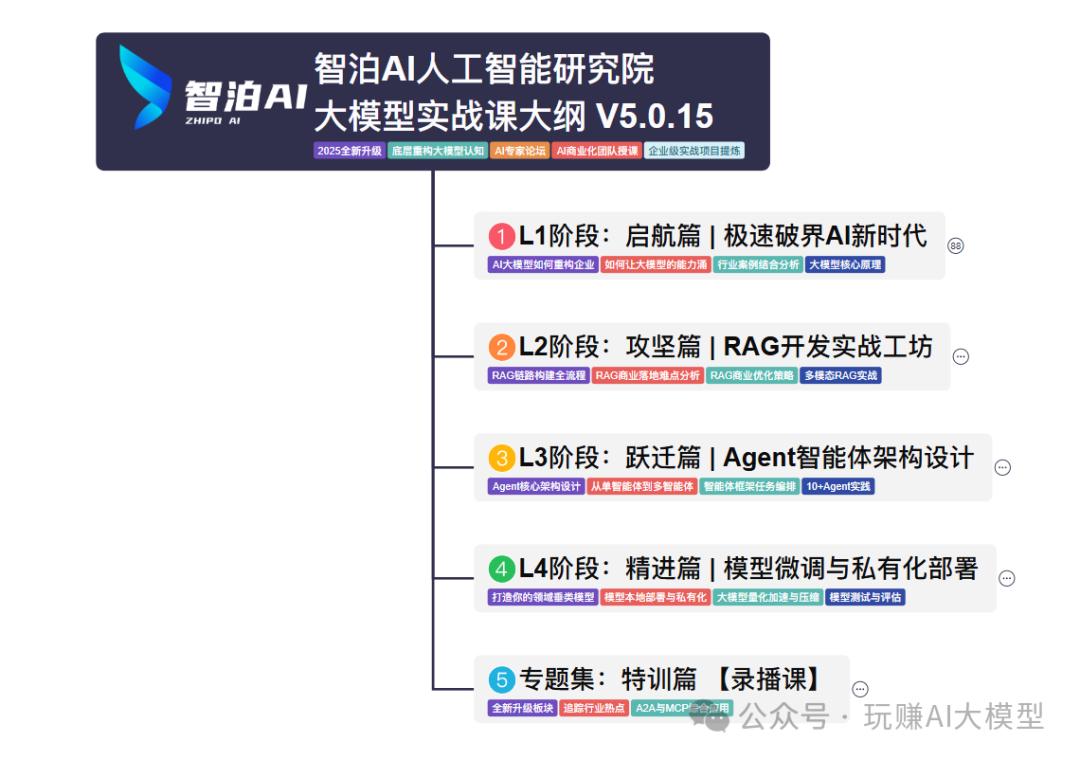
  • 从零到精通完整闭环:【基础理论 →RAG开发 → Agent设计 → 模型微调与私有化部署调→热门技术】5大模块,内容比传统教材更贴近企业实战!

  • 大量真实项目案例: 带你亲自上手搞数据清洗、模型调优这些硬核操作,把课本知识变成真本事‌!

02适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

image.png

vx扫描下方二维码即可
在这里插入图片描述

本教程比较珍贵,仅限大家自行学习,不要传播!更严禁商用!

03 入门到进阶学习路线图

大模型学习路线图,整体分为5个大的阶段:

图片

04 视频和书籍PDF合集

图片

从0到掌握主流大模型技术视频教程(涵盖模型训练、微调、RAG、LangChain、Agent开发等实战方向)

图片

新手必备的大模型学习PDF书单来了!全是硬核知识,帮你少走弯路(不吹牛,真有用)

图片

05 行业报告+白皮书合集

收集70+报告与白皮书,了解行业最新动态!
图片

06 90+份面试题/经验

AI大模型岗位面试经验总结(谁学技术不是为了赚$呢,找个好的岗位很重要)图片

在这里插入图片描述

07 deepseek部署包+技巧大全

在这里插入图片描述

由于篇幅有限

只展示部分资料

并且还在持续更新中…

真诚无偿分享!!!
vx扫描下方二维码即可
加上后会一个个给大家发

在这里插入图片描述

ArcMap 10.7/10.8启动加载界面后闪退?可能是这个隐藏的Normal.mxt模板文件在搞鬼 本文深入分析了ArcMap 10.7/10.8启动加载界面后闪退的问题,指出Normal.mxt模板文件损坏是常见原因。提供了从定位、删除模板文件到系统级修复的完整解决方案,帮助GIS工程师快速恢复工作流程。 阅读详情

相关推荐

自制非接触式静电探测仪:从振动电容原理到微弱信号检测实践

微弱信号检测是电子测量领域的核心挑战之一,尤其在需要避免物理接触或防止干扰的场景中。其基本原理在于将难以直接获取的微小物理量(如电流、电压)通过传感器转换为电信号,再经过放大、滤波等处理进行提取。锁相放大技术是解决这一问题的关键手段,它利用参考信号与目标信号的同步性,从强噪声背景中恢复出有效信息,极大提升了信噪比和测量灵敏度。这项技术的工程价值在于实现了对纳安级电流、微伏级电压等高难度参数的可靠测量。在静电防护、材料表面电位分析、生物电信号采集等应用场景中,非接触式测量需求广泛。本文聚焦的基于振动电容原理的

weixin_32349093的博客 276

【必藏】大模型SFT全解析:一文搞懂监督微调及其7大核心区别技术,从入门到实战应用

SFT(监督微调)是连接通用大模型与行业应用的关键技术,通过特定领域标注数据提升模型在特定任务上的表现。本文详细分析了SFT与预训练、RLHF、RAG等七大技术的核心区别,强调数据质量是SFT成功的关键,并提供大模型学习路径和资源,帮助开发者从零入门到实战应用。

2401_84815887的博客 1580

UE5导入MetaHuman虚拟头像后,连接live link face,面部表情捕捉出错修正

UE5 利用live link face 驱动meta human面部表情捕捉

m0_53122690的博客 6596

大模型必备技能:SFT技术详解及与其他技术的7大区别,建议收藏学习

文章深入解析了大模型训练中的核心技术SFT(监督微调),详细阐述了SFT与预训练、RLHF、RAG等七大技术的区别。强调数据质量是SFT成功的关键,提出格式统一、质量优先和多样性三大数据构建要点。同时为AI学习者提供系统学习路径,从基础理论到模型微调、私有化部署等实战内容,帮助读者掌握AI大模型技术,抓住AI时代机遇。

2401_84815887的博客 820

RTL8306交换机芯片与FPGA联调实战:5个网口+1个MAC的配置避坑指南

本文详细解析了RTL8306交换机芯片与FPGA联调中的关键技术难点,特别是MAC5寄存器的配置陷阱和PHY页切换机制。通过实战案例和优化策略,帮助开发者高效配置5个网口+1个MAC的工业级网络设备,提升系统稳定性和实时性。

vodka的博客 1102

OpenHarmony v4.1 Release设置应用随系统自动启动

OpenHarmony 4.1 版本中的 Ability Manager Service (AMS) 提供了应用自启动管理功能,允许系统控制哪些应用可以在系统启动时自动运行。这需要以下两个主要步骤:启用系统的自启动管理支持开发一个系统应用来管理自启动配置。

afufufufu的博客 1905

大模型微调任务全景图:从领域适配到行为对齐的七大实战场景

大模型微调任务已从单一的“领域适配”扩展为涵盖专业化、性能优化、风格定制、指令增强、安全对齐、文化适配和多模态的完整体系。选择何种微调任务,取决于业务的核心痛点:是否需要领域知识?是否需要特定输出风格?是否必须满足安全合规要求?对于大多数场景,SFT是起点——先验证基础效果,再根据任务复杂度决定是否叠加DPO等进阶方法。理解这七大任务,是制定AI落地战略的第一步,也是避免“为了微调而微调”的关键。底部锚点⬆ ⬆ 顶部 ⬆ ⬆⬇ ⬇ 底部 ⬇ ⬇⬆ ⬆ 顶部 ⬆ ⬆。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 689

Flink CDC 中 StartupOptions 模式详解

Flink CDC 的 StartupOptions 模式用于指定作业启动时从源数据读取数据的起始位置,不同的模式适用于不同的业务场景,可满足多样化的数据处理需求,主要有 Initial 模式、Earliest 模式、Latest 模式、SpecificOffset 模式和 Timestamp 模式。

RodJohnsonDoctor的专栏 850

大模型岗位面试核心模块全解析:从Transformer到Agent

大模型技术正加速从研究走向产业落地,围绕其展开的工程化能力已成为技术人才的核心竞争力。理解大模型基础原理,如Transformer的注意力机制与位置编码,是掌握其工作逻辑的起点。在此基础上,模型训练全流程、微调技术(如LoRA)与RAG检索增强生成,共同构成了解决实际业务问题的关键手段。同时,推理部署与性能优化决定了模型能否高效服务,而系统的模型评测体系与Agent应用架构则直接关系到最终落地效果。对于希望进入大模型领域的工程师而言,系统掌握这些模块不仅是应对面试的需要,更是胜任岗位、独立完成任务的必备技能

weixin_33212799的博客 233

Serdes之什么是(CDR)?

光收发器和电收发器使用的是我们所说的串行数据通信。在这种通信方式中,数据位是按顺序一个接一个地传输的。光收发器和电收发器使用的是我们所说的串行数据通信。在这种通信方式中,数据位是按顺序一个接一个地传输的。目前市场上大多数收发器都没有专用的时钟输入,因此时钟恢复和数据重新定时等功能是在收发器外部(即在主板上)进行的。接收端则需要恢复时钟以采样串行线上的数据。为了实现这一点,接收端需要一个与输入数据频率大致相同的时钟。通过使参考时钟与输入数据信号的跳变相位对齐,可以生成一个恢复的时钟。这被称为时钟恢复。

叫好与叫座虽然不是对立面,但想在同一个作品中达到双重效果很难。 2395

外部PLC触发VisionMaster多流程运行

上一讲,介绍了海康VisionMaster与西门子PLC1200进行S7通信。在前一讲的基础上,讲解如何通过PLC触发,实现VisionMaster的多流程运行。

haier123888的博客 4657

大模型岗位面试高频问题全解析:七大类核心考点与实战经验

大模型技术正加速渗透企业级应用,面试考察已从单一算法理论转向工程实践与业务落地能力。Transformer作为基石架构,其注意力机制、位置编码等概念是理解模型原理的第一步;微调环节中,LoRA因其低资源高效适配特性成为主流方案。RAG、Agent等技术解决知识时效性与复杂任务执行问题,而模型评测与推理部署(如vLLM)直接决定项目能否稳定上线。从真实面试经历出发,系统梳理大模型岗面试中模型原理、训练微调、RAG、评测、推理优化、Agent应用及业务落地七大类高频问题,从基础概念到实战踩坑,为准备面试的开发者

weixin_29061465的博客 233

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

大模型实习模拟面试之字节大模型Agent算法一面:从多模态统一到DeepSpeed训练的硬核拷问

在2026年的大模型人才争夺战中,字节跳动凭借其海量数据、极致工程与前沿研究三位一体的优势,成为无数AI学子梦寐以求的舞台。其大模型Agent算法岗一面,不仅考察基础理论深度,更聚焦系统设计、训练优化与工程落地的全栈能力。本文还原了一场高度仿真的“字节大模型Agent算法一面”模拟面试,整场面试约60分钟,问题覆盖多模态统一性、训练数据工程、Attention机制演进、分布式训练、Agent架构设计、幻觉防控及编码实现七大维度。尤其对。

吾为热爱计科,致力于知识分享的践行者,此博客是我在这条道路上留下的足迹。 518

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

【干货】RAG技术yyds!7大模块详解+3大开源项目,小白也能玩转AI增强检索,告别“一本正经地胡说八道“[特殊字符]

文章详细介绍了RAG(检索增强生成)技术的实战应用,包括LLM需要RAG的原因(幻觉、时效性、数据安全)、RAG架构与模块(版面分析、知识库构建、大模型微调、知识问答)、RAG相较于LLM的优势(可扩展性、准确性等)、RAG与SFT的区别,以及各模块的具体实现方法和优化策略。同时推荐了多个RAG开源项目,帮助开发者从零构建企业级RAG应用,解决大模型幻觉问题,提升回答的准确性和可靠性。

Python_cocola的博客 1019

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

Dropwizard 0.8.x 升级实战:Jersey 2 迁移、rootPath 配置化与测试断言改造指南

本文基于 Dropwizard 官方升级文档 [upgrade-notes-0_8_x.rst](https://link.gitcode.com/i/5d704f635bd8f2b0b1c1aa10a8331ace),系统讲解从 0.7.x 升级到 0.8.x 时必须处理的四类变更:Apache Commons Lang 包名迁移、FEST 断言到 AssertJ 的替换、自定义 URL pat

gitblog_00336的博客 729

[特殊字符] RAG保姆级实战:7大核心模块深度解析,从版面分析到开源项目落地

本文深入探讨RAG技术如何解决大语言模型(LLM)存在的幻觉、时效性和数据安全问题。文章系统介绍了RAG的7大核心模块:版面分析、知识库构建、微调、检索、重排序及评测,并推荐RAGFlow、QAnything等开源项目。通过对比RAG与SFT(监督微调)的优缺点,指出RAG在可扩展性、准确性、可控性等方面的优势。详细解析了版面分析中的文件获取、复原等关键技术,以及知识库构建的必要性和方法。最后提供了金融数据集分析任务作为实践练习,为开发者提供全面的RAG实战指南。

m0_59162248的博客 464

Qwen-AgentWorld完整部署指南:免费开源,性能超GPT-5.4,5分钟跑起来

阿里通义千问今日发布首个原生语言世界模型 Qwen-AgentWorld,单一模型覆盖 7 大智能体交互领域,旗舰版 397B 在 AgentWorldBench 评测中超越 GPT-5.4、Claude Opus 4.8,全面开源。本文从背景、技术架构、性能对比、部署实战四个维度深度解析。

创世宇图 宏图天下 3929

7大机器学习范式:有监督/自监督/半监督/主动学习/弱监督/自训练/迁移学习

深度学习与大模型面试中经常混淆各类机器学习学习范式,本文系统梳理**有监督、自监督、半监督、主动学习、弱监督、自训练、迁移学习**7 大核心范式,结合 NLP 任务 SFT、POS 词性标注、NER 命名实体识别讲解定义、特点与落地场景,辨析范式间边界、常见误区,串联完整 LLM 训练链路,适合算法面试复习与工程实践参考。

weixin_44021329的博客 764

2026秋招必备!大模型面试八股文精华(小白程序员必收藏)

请详细解释 ReAct 框架。它是如何将思维链和行动结合起来,以完成复杂任务的?在 Agent 的设计中,“规划能力”至关重要。请谈谈目前有哪些主流方法可以赋予 LLM 规划能力?(例如 CoT, ToT, GoT等)Memory是 Agent 的一个关键模块。请问如何为 Agent 设计短期记忆和长期记忆系统?可以借助哪些外部工具或技术?Tool Use是扩展 Agent 能力的有效途径。请解释 LLM 是如何学会调用外部 API 或工具的?(可以从 Function Calling 的角度解释)

youmaob的博客 987

大模型落地实操:RAG与微调到底怎么选?一文讲透“补课”与“开卷考试”

当工程师问“3101工作面现在的压力是多少”时,模型通过微调学到的专业能力理解问题意图,再通过RAG实时检索最新数据,最后给出精准、专业的回答。第一步用微调“定调子”:从历史文献、操作规程中提取知识,用 LoRA 技术对大模型进行专业培训,只微调不到1%的参数,让模型立刻掌握煤矿领域的专业术语和逻辑体系,从“通才”变成“煤矿专家”。微调的做法,是在一个已经训练好的通用大模型基础上,拿自家整理好的领域数据,再给它做一轮小规模的“加训”。你可以这么理解:模型还是那个模型,知识全在外挂库里,两者完全分离。

2601_96693776的博客 375

医疗问答场景下Qwen3.6监督微调实战指南

大语言模型在临床决策支持中的应用,核心在于将通用语言能力转化为可信赖的医学推理能力。其本质是知识迁移过程:通过监督微调(SFT)对齐权威指南、结构化病历与药品说明书等高质量数据,使模型具备术语精准识别、长上下文逻辑保持和循证答案生成能力。相比RLHF或提示工程,SFT更符合医疗监管对可追溯性、可验证性的刚性要求,也规避了偏好标注成本高、专家分歧难统一等现实瓶颈。本文聚焦Qwen3.6在真实三甲医院场景下的微调实践,涵盖中文医学术语覆盖优化、分层LoRA适配、七层临床安全数据清洗及四维可信度评估体系,为构建可

weixin_30952479的博客 176

具身智能体强化学习:从理论到实践

强化学习(Reinforcement Learning, RL)是机器学习的重要分支,通过智能体与环境的交互学习最优策略。具身智能体(Embodied Agent)将这一技术延伸到物理或虚拟环境中,实现感知、决策与执行的闭环。基于POMDP(部分可观测马尔可夫决策过程)框架,智能体能够在信息不完整的情况下做出序列决策,这为通用人工智能(AGI)的发展提供了新路径。在实际应用中,结合大语言模型(如LLM)的规划能力和工具调用机制,Agentic RL已成功应用于代码生成、机器人控制等场景。关键技术如分层强化学

weixin_34417200的博客 414

7大AI技术架构深度解析:从Function Calling到GRPO,小白到进阶必备指南!

本文详细解析了7项重塑AI应用的技术架构:MCP作为AI工具统一标准、Binary Quantization提升RAG效率30倍、Corrective RAG实现自我修正检索、TrustRAG融合结构化与非结构化数据、Deep Researcher实现多AI专家协作、GRPO简化推理模型训练,以及SFT/RFT微调方法选择指南。这些技术分别针对AI开发中的不同痛点,帮助开发者提高效率、准确性和成本效益,是当前AI应用开发的核心技术栈。

WANGJUNAIJIAO的博客 1046

漫话大模型:AI 解出千禧年难题,但爱因斯坦式创新它做不到

![封面](https://i-blog.csdnimg.cn/direct/777c0c254acf408189e590e89b8e926d.png) 9 月 8 号,OpenAI 发了一篇博客,标题就很炸裂:**On the Navier-Stokes Millennium Prize Problem**。 纳维斯托克斯方程,千禧年七大数学难题之一,悬赏 100 万美元,困扰人类数学家 2

老七聊AI 444

4小时100美元!Andrej Karpathy新开源项目nanochat,人人都能拥有专属ChatGPT

nanochat的推出,不仅是一个开源项目的发布,更是LLM技术“平民化”的重要里程碑。它打破了“大模型训练需要巨额成本”的固有认知,让普通开发者也能以极低的成本实践LLM全流程开发,真正实现了“人人都能拥有专属ChatGPT”。从技术角度看,nanochat并非颠覆性创新,但其“极简、实用、易上手”的设计理念,恰好击中了当前开源LLM领域的痛点——许多开源项目要么过于复杂,要么性能不足,而nanochat在“复杂度”和“实用性”之间找到了完美平衡。

weixin_54447959的博客 1682

Qwen-AgentWorld为智能体打造“脑内沙盘”,AI学会“脑补”了!(小白秒懂)

阿里千问团队重磅发布全球首个“原生语言世界模型”Qwen-AgentWorld。如果以前训练AI是在真实世界“盲目试错”,那它就是给AI装上了“脑内VR模拟器”。它让智能体在行动前,先在脑中“脑补”推演环境变化,做到“先想再做”。该模型从底层原生支持世界建模,单模型即可模拟网页、手机、代码等七大交互领域。本文用大白话带你秒懂这项颠覆性技术,看它如何低成本、高效率地重塑未来AI智能体的训练方式!

创世宇图 宏图天下 1166
上一篇: 零基础也能懂:本地跑通 Dify + Ollama + DeepSeek
下一篇: 提示工程还没搞懂,上下文工程(Context Engineering)已成大模型新战场
不秃头de程序猿
博客等级 码龄5年 4091粉丝 1482原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值