LLM开发者必看|上下文工程详解:让你的模型更“聪明”

大模型处理长上下文方法一览 2023年中开始,各大LLM厂商开始关注到长上下文的问题。2023年5月,Claude把长度支持到100k tokens;6、7月的时候,ChatGPT3.5也已经支持16k,而ChatGLM2-B最大长度已经可以到32k。(插一句,ChatGLM系列做得一直很不错,从基础模型、长窗口、工具调用、Agent都一直保持在比较前沿的水平,个人最近用ChatGLM3、ChatGLM4体验还是很不错的)差不多同时间还有LM-SYS的LongChat,MosaicLM的MPT也支持16k以及更长的上下文。 阅读详情

随着大语言模型(LLM)的快速发展,从GPT-3到ChatGPT,再到Claude、GPT-4等更强大的模型,我们见证了一个重要趋势:上下文窗口的不断扩大。早期的模型可能只能处理几千个token,而现代模型已经能够处理数十万甚至数百万个token的上下文。为解决这些问题,上下文工程(Context Engineering)作为专门优化模型输入信息质量的技术体系应运而生,本文将从以下方面介绍:

  1. 产生背景
  2. 上下文工程概念
  3. 上下文工程 vs 提示工程
  4. 核心技术原理
  5. 应用场景与实践建议

一、产生背景:为何需要上下文工程?

1. 大模型的核心瓶颈

(1)固定上下文窗口限制:

即使支持128K tokens的模型(如GPT-4 Turbo),处理整本书、长期对话或代码库时仍面临信息丢失和理解偏差问题。

(2)长文本性能衰减:

研究表明,当关键信息位于文本中段时,模型召回率下降40%以上(来源:Stanford CRFM)。

(3)成本与效率挑战:

重复输入长上下文会显著增加计算成本。

2. 传统方案的不足

(1)提示工程(Prompt Engineering):

优化指令设计(如Few-shot示例),但无法解决信息过载问题。

(2)简单截断(Truncation):

随机丢弃文本,导致关键信息缺失。

上下文工程的使命:

在有限上下文窗口内,最大化关键信息的密度与可用性。

二、上下文工程概念
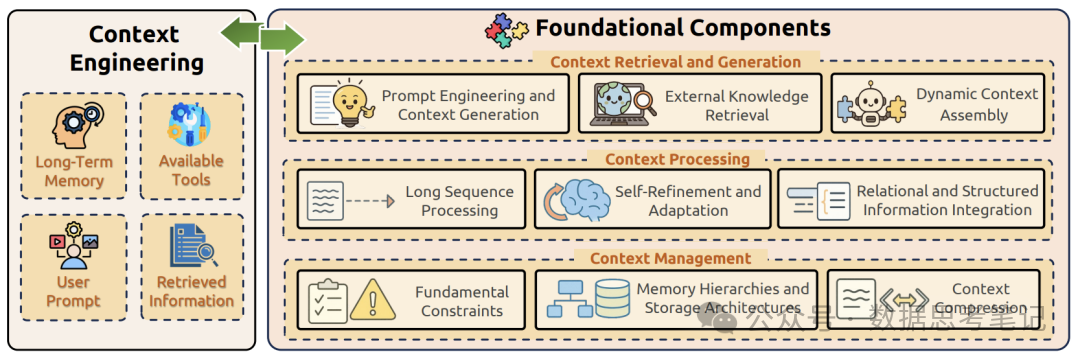
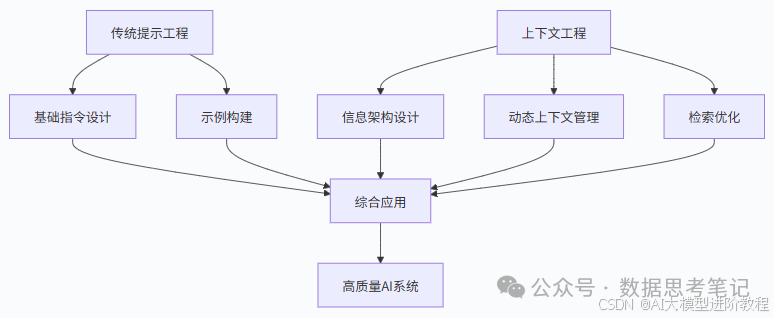
图片

上下文工程(Context Engineering)是一门专注于优化大语言模型上下文窗口使用的技术学科。它涉及如何在扩展的上下文空间中有效地组织、结构化、检索和利用信息,以最大化模型的理解能力和输出质量。包含四个核心要素:

信息组织: 如何结构化地安排上下文中的信息;

动态管理: 如何在对话过程中维护和更新上下文;

信息检索: 如何从大量上下文中快速定位相关信息;

质量优化: 如何确保上下文信息的准确性和相关性。

三、上下文工程vs提示工程

1. 核心差异对比

技术维度提示工程(Prompt Engineering)上下文工程(Context Engineering)
操作对象单一提示词(如 “总结以下文本”)多源异构信息集合(提示词 + 背景数据 + 历史记录)
技术焦点优化指令表达(如使用 “逐步分析” 替代 “分析”)优化信息供给(如筛选最相关的 3 条历史对话)
依赖能力自然语言表达技巧信息检索与结构化能力
典型工具提示词模板库、指令微调数据集向量数据库、上下文压缩算法

2. 协同关系

上下文工程不是提示工程的替代,而是其延伸和补充:

在这里插入图片描述

以“撰写产品评测”任务为例:

提示工程: 设计提示词 “请从性能、价格、外观三个维度评测 [产品名],要求突出与竞品的差异”。

上下文工程: 除提示词外,自动导入该产品参数表、用户差评高频词、竞品评测报告摘要(各取 200 字),并按 “重要性 = 参数匹配度 × 用户关注度” 排序。

两者协同效果:提示工程明确 “怎么写”,上下文工程提供 “写什么”,共同提升评测的专业性和针对性。

四、核心技术原理

核心思想:“不是塞入更多,而是塞入更精确的上下文”。

类比:图书管理员不会搬入整个图书馆,而是抽取最相关的书页并添加索引标签。

1. 信息分层架构:就像整理一个超级书架

基本思想:将上下文信息按重要性和相关性分层组织,就像图书管理员整理图书馆一样。

类比:想象有一个神奇的书架,它会根据需求自动调整书籍的摆放位置:

  • 手边区域:最常用的参考书,伸手就能拿到;
  • 视线范围:重要但不常用的书,扫一眼就能看到;
  • 储藏区域:偶尔需要的资料,需要时可以取出;
  • 仓库区域:很少用但不能丢的书,按需调取。

实际例子:

假设AI要帮您分析一份100页的投资报告:
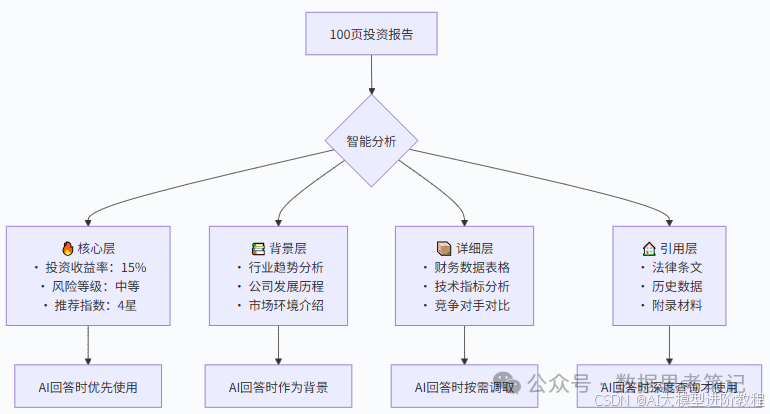
在这里插入图片描述

为什么这样做有效?

  • 就像人类阅读一样,我们总是先看重点,再看细节;
  • AI也需要知道什么信息最重要,避免被细节淹没。

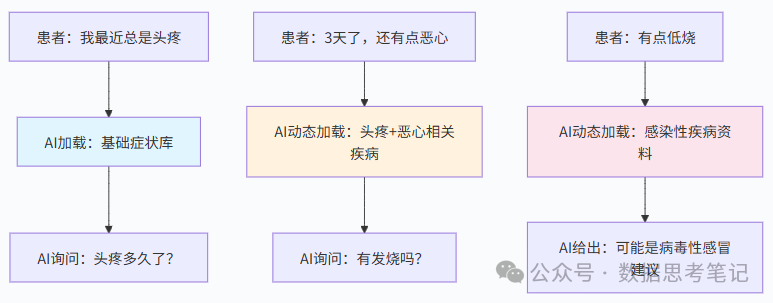
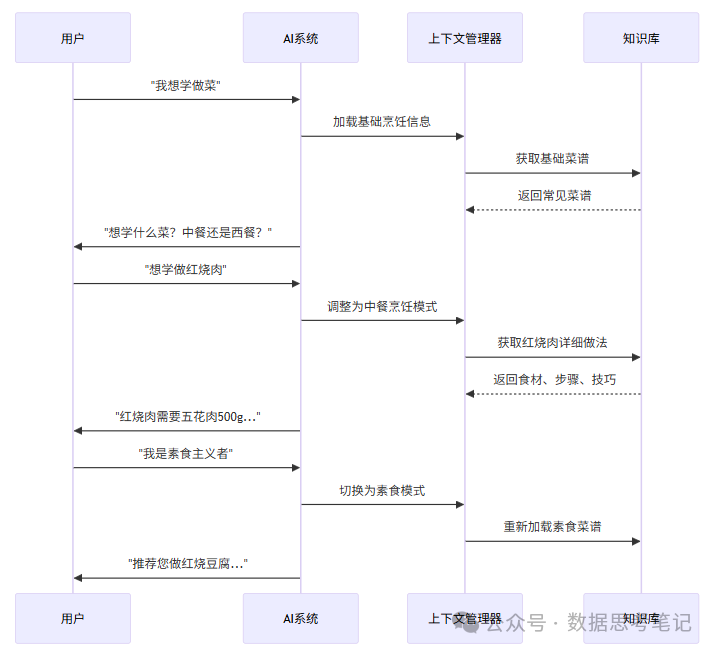
2. 动态上下文管理:像智能助理一样调整桌面

工作原理:根据对话进展动态调整信息,就像一个聪明的助理会根据老板的需求调整桌面文件一样。

类比:想象您有一个超级智能的秘书,ta会根据当前在做什么,自动在桌面上摆放最需要的文件:

  • 早上开会 → 摆放会议资料和日程安排
  • 中午谈合同 → 摆放法律文件和合同模板
  • 下午做预算 → 摆放财务报表和计算工具

实际例子 - 在线医疗咨询:

图片

更详细的动态管理流程:

图片

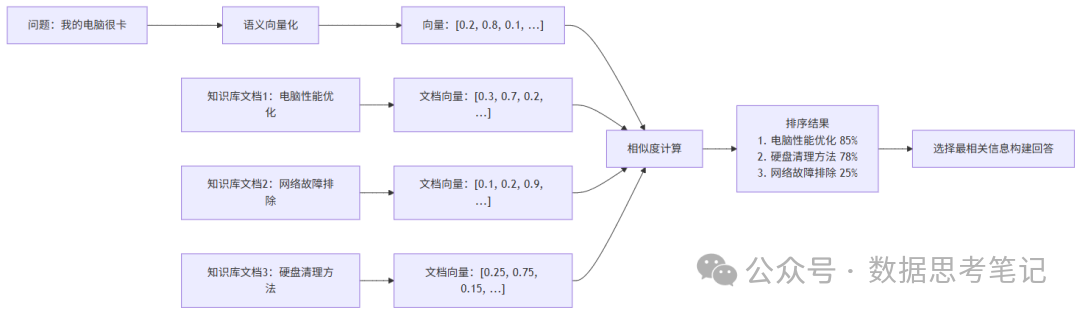
3. 语义检索与匹配:像搜索引擎一样聪明

核心技术:AI能够理解问题的真正含义,然后在海量信息中找到最相关的内容,就像Google搜索一样智能。

类比:想象在一个巨大的图书馆里找资料:

  • 传统方法:只能按书名查找,“Python”只能找到书名带“Python”的书;
  • 语义检索:理解您要学编程,能找到所有编程相关的书,即使书名是“计算机语言入门”。

工作原理图解:
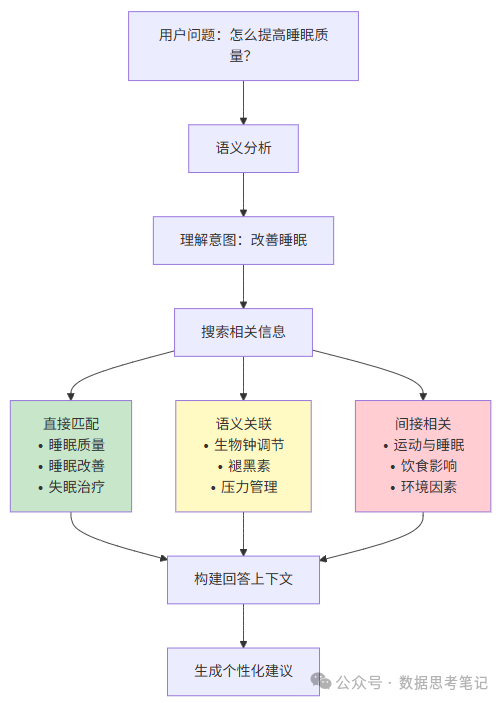
图片

实际检索过程示例:

图片

  • AI把所有信息都转换成“数字指纹”(向量);
  • 相似的内容有相似的“指纹”;
  • 通过计算"指纹"的相似度快速找到相关信息。

4. 上下文架构设计模式

(1)分层存储模式
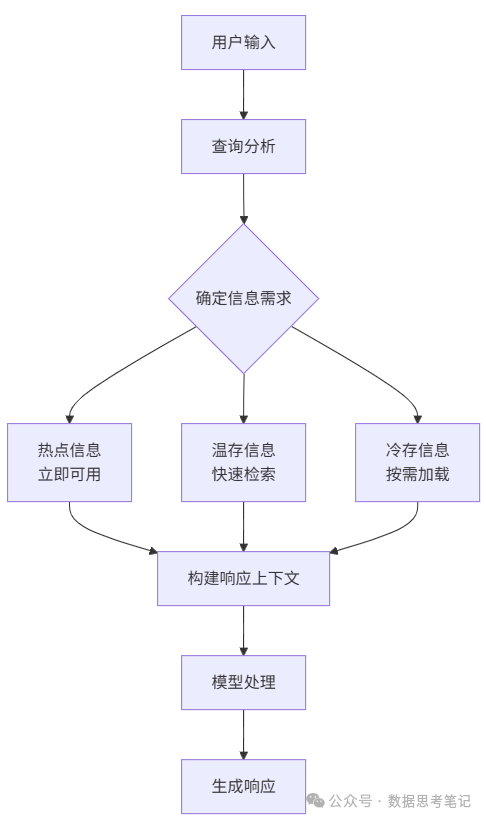
图片

(2)滑动窗口模式

保持固定大小的上下文窗口,但内容会根据对话进展动态更新:

  • 保留最重要的核心信息
  • 维护最近的对话历史
  • 动态加载任务相关信息

五、应用场景与实践建议

1. 典型应用场景

(1)智能客服升级: 电商平台通过上下文工程,提升用户咨询响应准确率。实现方式:

  • 自动关联用户最近 3 次订单信息;
  • 提取历史对话中的核心诉求(如 “退货”“换货”);
  • 动态插入对应商品的售后政策。

(2)代码辅助生成: 在 IDE 插件中,上下文工程会:

  • 导入项目中已有的函数定义;
  • 分析用户当前编辑的代码片段;
  • 检索相似功能的开源代码示例。

(3)医疗辅助诊断: 整合患者电子病历(结构化数据)、过往处方(文本)、检查影像报告(OCR 转化),辅助医生生成诊断建议,减少误诊风险。

(4)法律文档审查: 自动从合同中提取 “付款条件”“违约责任” 等关键条款,关联相关法律条文,生成风险提示,提升审查效率。

2. 实践建议

(1)从小规模开始

  • 先在具体场景中验证效果
  • 逐步扩展到更复杂的应用

(2)动态管理

  • 根据任务需求调整上下文内容
  • 保持信息的时效性和相关性

(3)质量优先

  • 宁缺毋滥,确保信息准确性
  • 建立信息质量评估机制

(4)持续优化

  • 收集用户反馈
  • 不断改进上下文策略

总结

上下文工程是长文本时代的核心基础设施——它让大模型从“短文本专家”蜕变为“复杂知识管家”。与提示工程结合时,可构建完整的输入优化链:提示工程控制“思维方向” + 上下文工程提供“思维素材”。上下文工程作为大模型时代的新兴技术领域,为我们提供了有效利用长上下文能力的系统性方法。它不仅仅是技术的升级,更是思维方式的转变——从关注单一指令的优化转向整个信息空间的管理和利用。

最后

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!

你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

点击领取:2025最新最全AI大模型资料包:学习路线+书籍+视频+实战+案例…

大模型工程三驾马车:Prompt Engineering、Context Engineering 与 Harness Engineering 深度解析 Prompt Engineering(提示词工程)是指通过精心设计输入文本(Prompt),引导大语言模型产生更准确、更有用、更符合预期输出的技术与方法论。同一个模型,面对不同的提问方式,会给出截然不同的答案。提示词工程师的任务,就是找到那个"最优提问方式"。Context Engineering(上下文工程)是指系统性地设计、管理和优化输入给大语言模型的上下文信息,以最大化模型在特定任务中的效能。如果说 Prompt Engineering 关注的是"说什么。 阅读详情

相关推荐

「LLM 训练解析」:从 Pretrain 到 DPO,LLM 是如何一步步变聪明的?

大家好,我是寒草🌿,浮云一别后,宛若流水十年间,而整个社会也已沧海桑田,这次(创作方面)新的开始我也希望为大家提供一些不同往日的内容。从头开始的第一篇文章,我将以「」为开篇:毕竟 AI 在我神隐的这段时间疯狂发展,而以此问题开始便很自然。所以我将尽力以通俗的文字 + 个人的浅薄认知为大家带来一场“不虚此行”的分享。也希望针对存有疑问或内容不实之处,大家可以与我互动交流,寒草定不胜荣幸。

Java_fenxiang的博客 787

一文搞懂:大语言模型的上下文工程(Context Engineering for Large Language Models)是什么?

一文搞懂:大语言模型的上下文工程(Context Engineering for Large Language Models)是什么?

2301_76168381的博客 1114

什么是上下文工程

上下文工程(Context Engineering)就像是人工智能时代的“魔法师之手”,它决定了我们与AI互动时,AI能听懂多少、理解多深、最终表现多好。它不仅仅是关于“提示词”那么简单,更是关于。

形上得其象,形下合于数;阴阳自济,玄理自明。 1560

深入理解上下文工程(Context Engineering):从入门到精通

想象这样一个场景:你正在用ChatGPT帮助分析一份50页的市场调研报告。开始时,AI的回答精准到位,但随着对话深入,你发现它开始"健忘"——忘记了报告中的关键数据,甚至开始给出与前面矛盾的建议。这不是AI模型本身的问题,而是遇到了上下文管理的挑战。

2401_85373691的博客 1834

海洋与地质地理信息数据下载网站汇总集锦

各种海洋与地质地理信息数据集合

qq_36980284的博客 1268

瑞芯微RK809音频驱动

瑞芯微RV1126中的RK809音频驱动开发

m0_61899715的博客 5221

让Cursor跨越上下文限制变的更“聪明”

Cursor会经常遇到代码无法复用,出现幻觉乱改文件,经常忘记前面沟通过的内容导致影响开发效率,本质都是上下文限制问题。提出一些解决思路,让Cursor变的聪明。

heiyeluren的blog(黑夜路人的开源世界) 4688

DIY玩家必备:用SSS1623芯片打造高性价比USB麦克风(附完整电路图)

本文详细介绍了如何利用SSS1623芯片DIY高性价比USB麦克风,包括元件选型、电路设计、PCB布局及调试技巧。通过完整的电路参考设计和实用建议,帮助电子爱好者打造专业级录音设备,实现免驱动即插即用功能。

weixin_29166013的博客 239

提示词工程已 Out!爆火的“上下文工程”究竟是个什么?

随着智能体(Agent)技术的发展,我们越来越意识到,什么信息被放入模型“有限的工作记忆”中,才是决定任务成功与否的关键。相比大模型刚崛起时出现的“提示词工程”这个广为人知的说法,“上下文工程”正逐渐被认为是更准确、更专业的替代词,背后也反映出整个大语言模型(LLM)应用范式的转变。那么,对于普通 AI 从业者而言,该如何理解与运用“上下文工程”,它是否和“提示词工程”一样,只是写几句指令就行。上下文工程,是设计和构建一整套动态系统,让大模型在正确的时间,看到正确的信息和工具,以完成目标任务。

优快云资讯 8303

Doris + Iceberg 实现高效数据湖分层:架构解析与最佳实践

本文深入解析了如何利用Doris与Iceberg构建高效的数据湖冷热分层架构。通过将高频访问的热数据存储在Doris中以实现毫秒级查询,同时将历史冷数据归档至低成本的Iceberg存储,该方案在保障查询性能的同时显著降低了总体拥有成本。文章详细阐述了从架构设计、自动化迁移到统一查询的最佳实践,为应对海量数据下的成本与性能平衡提供了实战指南。

weixin_29207533的博客 135

Squareline Studio + LVGL实战:从Figma设计到MCU屏幕的UI开发一条龙(避坑中文显示)

本文详细介绍了使用Squareline Studio和LVGL实现从Figma设计到MCU屏幕UI开发的全流程,重点解决中文显示等常见问题。通过设计工具链搭建、设计稿转换、LVGL工程集成及性能优化等步骤,帮助开发者高效完成嵌入式GUI开发,提升开发效率。

weixin_29246195的博客 583

Prompt Engineering过时了?现在流行“上下文工程”!学会了“上下文工程”,你的智能体才能真正聪明起来!

我不确定是谁首次提出了“上下文工程”这个词,但我们将以 Dex Horthy 的下图为基础,它简要解释了上下文工程的一些内容。

2301_81888214的博客 806

9、硬件工程师笔试面试知识器件篇——三极管(2025版本)

本文全面介绍了三极管的基础知识与应用,包括其结构、类型、工作原理、工作状态、功能、应用场景及特性参数。详细探讨了三极管在信号放大、无线通信、音频设备及医疗设备中的具体应用,并深入分析了设计放大电路时如何平衡增益与噪声、优化偏置电路以提高稳定性、使用负反馈改善性能等关键问题。此外,文章还涵盖了高频电路设计、温度补偿策略、电磁干扰防护等实用内容,为硬件工程师提供了全面的技术参考和设计指导。

XU157303764的博客 7311

AI科普:全面了解LLM上下文工程(二):为什么要有上下文工程?

在上一篇文章中,我们聊了从提示词工程到上下文工程的发展过程,看到了大语言模型交互方式的逐步演化。

huang9604的博客 699

手把手教你学GPU的KMD专栏--3.1 设备初始化流程深度解析

本文深入解析了KMD(内核模式驱动)设备初始化流程,这是GPU驱动开发最基础且关键的环节。初始化流程包括6个核心阶段:KMD模块加载、PCIe设备探测匹配、GPU硬件初始化、显存分配映射、中断系统配置和设备注册。每个阶段都有详细步骤解析,涉及关键数据结构和错误处理机制。文章还分析了常见问题(驱动加载失败、显存分配失败、中断配置失败)的解决方案,并指出未来趋势将向动态初始化、安全增强和AI优化方向发展。正确高效的初始化流程是确保GPU被操作系统安全使用的前提,也是后续内存管理、任务调度等功能的基础。

MHD0815的博客 262

Microsoft Forms功能深度解析:企业数据收集与协作的智能利器

Microsoft Forms是微软365生态中的在线表单工具,支持问卷调查、测验和投票创建,具备拖拽式界面、多题型设计和实时数据分析功能。其核心价值在于易用性、跨平台兼容性以及与Teams、SharePoint等微软服务的深度集成,满足GDPR/HIPAA等合规要求。提供表单创建、权限管理、自动化流程(通过Power Automate)和审计日志等功能,适用于金融、医疗、教育等多行业场景。虽然存在逻辑分支有限等约束,但通过案例证明能显著提升数据收集效率(达70-85%)。使用时需注意许可证配置(Busin

xueyunshengling的博客 9125

收藏 |小白程序员必看:轻松掌握上下文工程,解锁大模型智能潜能!

文章重点介绍了上下文工程(Context Engineering)在大模型应用中的重要性,它通过动态构建系统,为LLM提供正确、合适格式的信息和工具,使其能有效完成任务。文章指出,Context Engineering比Prompt工程更关键,因为后者仅关注输入而前者关注上下文的完整性、工具对接、信息结构及指令明确性。文章还提供了LangGraph和LangSmith工具的实战应用,帮助开发者实现上下文工程,从而提升大模型的智能表现。掌握Context Engineering对于释放LLM的智能潜能至关重要

m0_71746299的博客 1682

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

【深度好文】解锁大模型真正潜力:上下文工程的全景指南与实践案例,开发者必收藏!

上下文工程是将大模型从"提示者"转变为"架构师"的关键学科,解决了大模型无法访问私有数据和长上下文的问题。文章详细介绍了上下文工程的六大核心组件:智能体、查询增强、检索、提示技术、记忆和工具,并通过实例展示了如何构建高效的AI系统。相比单纯的提示工程,上下文工程通过设计架构,将模型与外部世界连接起来,确保基于事实而非训练数据进行推理,从而提升大模型的实际应用效果。

2401_85373691的博客 989

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

AI智能体上下文工程构建指南:让Agent更强大更可靠的实战策略

"上下文工程是一门设计和构建动态系统的学科,它以正确的格式在正确的时间提供正确的信息和工具,为 LLM 提供完成任务所需的一切。”

2401_85375186的博客 940

建议收藏!上下文工程入门:让LLM更聪明的工作原理与实践技巧

Context Engineer 核心价值,下达清晰正确的指令,收集丰富准确的信息,选择正确的工具,让LLM拿到的上下文“准、全、省(省内存)、清(隔离清晰)”。最终让模型推理更准、效率更高,不管是单智能体完成复杂任务,还是多智能体协作,都能靠优质上下文,才能激发出大语言模型的能力,做出真正落地到实际应用。当然,有个残酷的现实就是如果大模型没有那个能力,你再怎么激发也没有用。

xxue345678的博客 505

大模型上下文工程(Context Engineering)详解

本文探讨大语言模型发展中的关键挑战——上下文窗口优化,并提出"上下文工程"技术解决方案。全文从产生背景、概念定义、技术对比、核心原理到应用场景,系统阐述了如何通过信息分层、动态管理、语义检索等方法,在有限上下文窗口内最大化信息价值。与提示工程形成互补关系,该技术已应用于客服、代码生成、医疗诊断等多个领域。文章最后提供了实践建议和学习资源,强调上下文工程将成为大模型时代的重要基础设施。

2401_84204207的博客 1626

深度好文:上下文工程:大模型应用的内存管理艺术,开发者必读!

文章介绍上下文工程这一系统性学科,专注于为AI智能体动态组装最优上下文组合。上下文分为指导性、信息性和行动性三类,统筹管理这些上下文可解决上下文缺失和退化问题。实践核心在于上下文的写入、选取、压缩和隔离,这是构建可靠AI应用的关键,标志着AI应用开发从"寻找完美提示词"向"设计动态上下文系统"的范式转变。

Android23333的博客 872

Deep Agent 是如何让大模型更“聪明” ?

如果说,我们熟知的大语言模型(LLM)是一位学识渊博、对答如流的“金牌咨询师”,那么传统的 AI Agent,就是我们为这位咨询师配备的第一个“助理”。我们让他学会了使用工具:调用搜索引擎查资料、启动计算器做数学、打开代码解释器写程序……这在处理那些“短平快”的单一任务时,确实表现惊艳,能做出几下漂亮的“花拳绣腿”。然而,当我们试图将它应用于真正复杂的、需要多步骤推理和长期规划的现实世界工作时,这位“助理型” Agent 很快就后劲不足,陷入迷茫。

m0_64363449的博客 1279

提示词工程已死,上下文工程当立

上下文工程代表了我们基于大模型构建应用方式的根本性转变。随着模型能力增强,核心挑战已经不再是"写一个完美的提示词",而是在每一步中精心筛选哪些信息能进入那有限的"注意力预算"。寻找最小的、高信噪比 token 集合,最大化实现预期结果的概率。Anthropic 观察到,更智能的模型需要的"规约式工程"越来越少,Agent 的自主性越来越高。无论模型能力提升到何种程度,将上下文视作一种宝贵且有限的资源,始终是构建高可靠、高效智能体的核心所在。

最短的捷径就是绕远路,绕远路才是我的最短捷径。 4623

从 0 学大模型:一文吃透上下文工程,让 AI 拥有 “持久记忆”

从 0 学大模型:一文吃透上下文工程,让 AI 拥有 “持久记忆”

m0_48891301的博客 1098
上一篇: AI大模型RLHF 实践总结:从原理、代码以及踩坑与解决方案,这篇文章一次性说清楚!
下一篇: 小白也能看懂的RAG与GraphRAG对比:什么时候该用哪种?
AI大模型进阶教程
博客等级 码龄2年 451粉丝 72原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值