大模型代理推理完全指南:从被动预测到主动行动的范式转变

智能Agent从被动响应到主动协作的架构演进 智能代理(Agent)作为人工智能领域的重要技术范式,正在经历从被动响应到主动协作的范式转移。其核心技术原理包括上下文感知、意图预测和安全执行框架,通过Transformer-XL、LSTM等深度学习模型实现环境理解和行为预判。这种技术演进显著提升了系统效率,在金融风控实测中使处理时长缩短47%。典型应用场景涵盖智能客服、健康管理、编程辅助等领域,特别是在需要实时决策的IoT和金融科技场景展现突出价值。现代Agent架构通过多模态融合和动态阈值机制,平衡了主动服务与用户控制权的关系。 阅读详情

如果在 2023 年,我们还在为 ChatGPT 能写出一首打油诗而惊叹,那么到了 2026 年的今天,单纯的“文本生成”已经无法满足我们对 AGI 的胃口了。我们痛苦地发现:即便模型参数大到离谱,它依然是一个“被动”的预言家——它只能根据你给的 Prompt 算概率,却无法像人一样去“试错”、去“查证”、去“反思”。
  • 论文:Agentic Reasoning for Large Language Models
  • 链接:https://arxiv.org/pdf/2601.12538

今天我们要拆解的这篇论文 《Agentic Reasoning for Large Language Models》 ,与其说是一篇综述,不如说是给所有做 Agent 的人发的一张“藏宝图”。它不仅仅总结了过去几年的技术,更重要的是,它正式宣告了 LLM 从“Static Reasoning”(静态推理)向 “Agentic Reasoning”(代理推理)的范式转移。

这不是简单的“加个插件”那么简单,这是一次对智能本质的重新建模。

认知的跃迁:从“大脑缸中之脑”到“具身行动者”

这篇论文最核心的洞察在于:Reasoning(推理)不应该只是发生在 Transformer 内部的矩阵乘法,而应该是一个物理过程。

让我们看一张图:
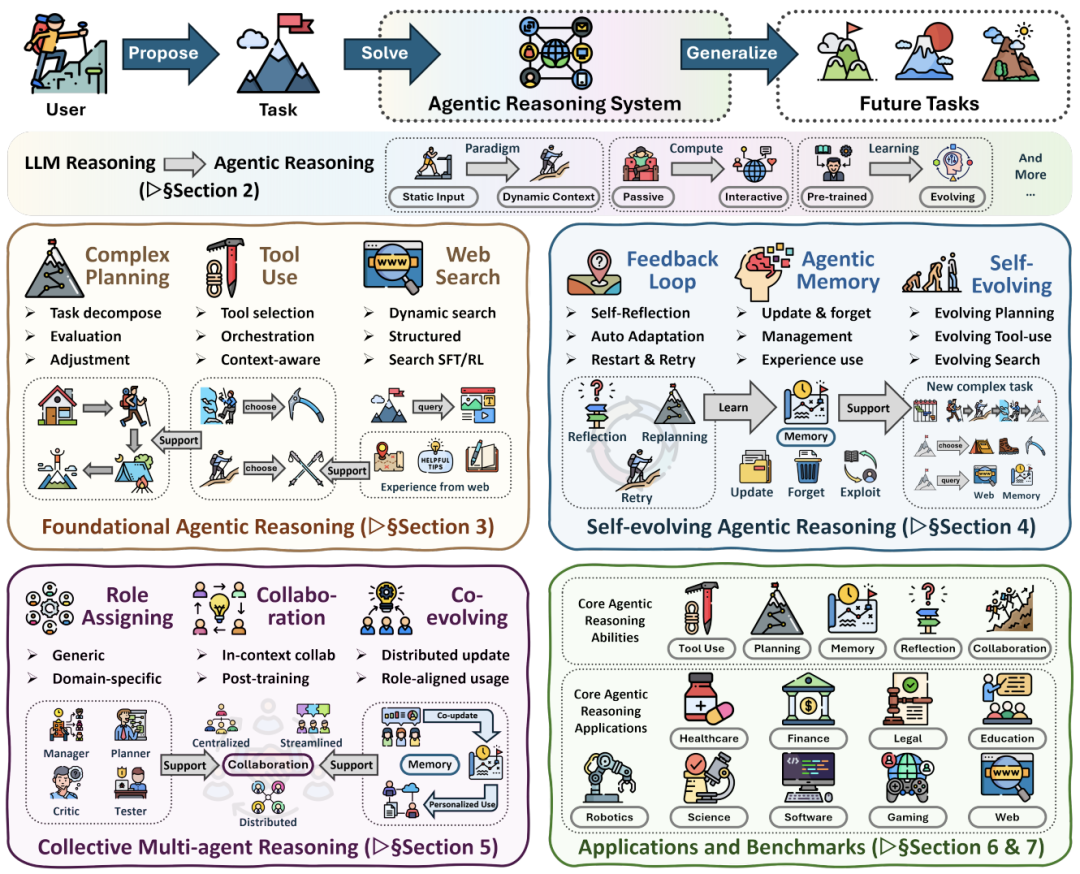
  • 传统 LLM Reasoning:Input -> Internal Compute -> Output。这是一次性的,像是在闭卷考试。
  • Agentic Reasoning:Observation -> Plan -> Act -> Feedback -> Memory -> Refine。这是一个闭环,像是在做科学实验。

作者非常敏锐地指出,这种转变在数学上其实是将 LLM 放入了一个 POMDP(部分可观测马尔可夫决策过程) 中。这不仅是数学游戏,它深刻地改变了我们训练和使用模型的方式。

那个打破僵局的公式

论文中给出了一个非常漂亮的分解公式,将“思考”与“行动”在数学上解耦了:

  • (Internal Thought): 这是模型的“内心戏”,比如 CoT(思维链)或者潜在的规划。这部分是不可见的、纯计算的。
  • (External Action): 这是模型对世界产生的影响,比如调用 API、写文件、移动机器人手臂。
  • : 历史上下文。

Why it matters?以前我们训练模型,是希望它直接输出(比如直接写出代码)。现在我们意识到,必须显式地建模(先想好架构,再写代码)。这种“Think before you Act” 的数学表达,正是最近 DeepSeek-R1 等 Reasoning 模型大火的理论根基。

进化的三重奏:Agentic Reasoning 的完整版图

论文没有堆砌算法,而是构建了一个名为“三维互补”的宏大框架。这非常有意思,它把 Agent 的能力分成了三个层级,像极了生物进化的过程。

1. Foundational(基石):单兵作战的能力

这是 Agent 的基本功,类似于人类学会使用工具。论文将其细分为三个核心要素:

  • Planning(规划): 不是简单的“一步步来”,而是引入了搜索算法。论文特别提到了从简单的 Chain-of-Thought 到复杂的 MCTS (蒙特卡洛树搜索) 的演变 。现在的 Agent 在回答问题前,会在脑子里“模拟”无数种可能,就像下围棋一样。
  • Tool Use(工具): 关键点在于从“模仿”(SFT)到“精通”(RL)。早期的 Toolformer 只是在模仿人类调用 API,而现在的 Agent 通过 RL 学习何时调用工具、如何处理报错 。
  • Search(搜索): 这超越了传统的 RAG。Agentic Search 是动态的——Agent 自己决定“我要不要查资料”、“查到的够不够”、“要不要换个关键词再查一次” 。
2. Self-Evolving(进化):从经验中学习

这一点最让我兴奋。目前的绝大多数 Agent 都是“失忆”的——你在这就聊得火热,换个 Session 它就不认识你了。但 Self-Evolving Agent 引入了两个关键机制:

  • Feedback (反馈循环): 不仅仅是人类给点赞,而是包括 Reflective Feedback(自我反思,如 Reflexion)和 Validator-Driven Feedback(比如代码跑不通报错了,Agent 自动看懂报错并重写) 。
  • Agentic Memory (动态记忆): 记忆不再是简单的 Vector DB 检索。论文提出了 Memory-as-Action 的概念 ——Agent 会主动决定“这句话很重要,我要写进长期记忆”或者“这个策略过时了,我要忘掉它”。这意味着模型在不更新参数的情况下,随着使用变得越来越“聪明”。
3. Collective(协作):群体智能的涌现

当单体智能遇到瓶颈时,大自然给出的答案是“群体”。论文详细探讨了从静态角色扮演(如 CAMEL, AutoGen)到动态共同进化(Multi-Agent Co-Evolution)的跨越 。 最精彩的部分在于**“协作即推理” (Collaboration as Reasoning)** 的观点:一个 Agent 的输出(Action)成为了另一个 Agent 的输入(Prompt),这种通过 Communication 传递的信息流,本质上是一个分布式的推理过程 。

In-context vs. Post-training:两条路线之争

在如何实现上述能力时,论文犀利地指出了当前的两大技术流派:

  • 派系一:In-context Reasoning (推理时编排)
  • 做法: 也就是 Prompt Engineering 的极致。通过复杂的 Prompt 流程(如 ReAct, Plan-and-Solve)来激发模型的潜能。
  • 优点: 灵活,不需要训练,即插即用。
  • 缺点: 受到 Context Window 限制,且推理成本极高(Token 燃烧机) 。
  • 派系二:Post-training Reasoning (训练后内化)
  • 做法: 通过 SFT 和 RL(特别是像 GRPO 这样的算法)将推理模式“烧录”进模型参数里 。
  • 核心洞察: 就像 DeepSeek-R1 做的那样,让模型内化“搜索”和“反思”的过程。论文提到,未来的趋势一定是 System 2 的能力逐渐被蒸馏进 System 1 的直觉中。

实验与应用:不只是纸上谈兵

这篇 Survey 的扎实之处在于它涵盖了大量垂直领域的落地情况。
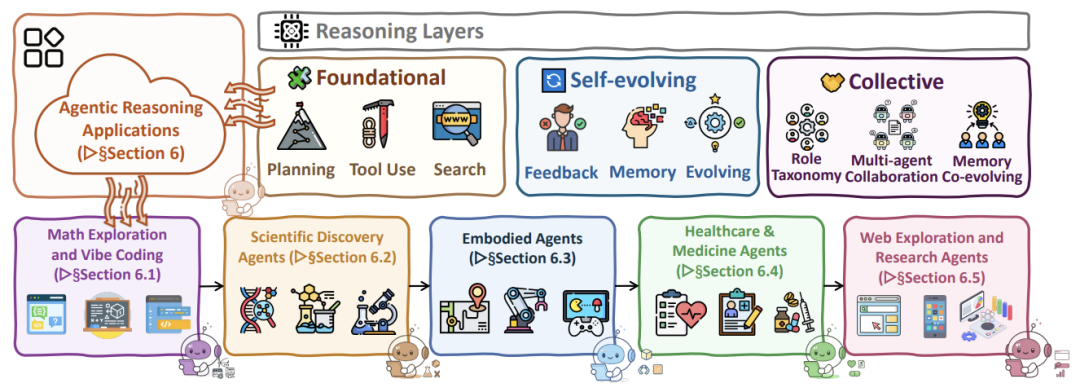
  • 上图展示了应用版图,特别值得关注的是 Scientific Discovery(科学发现) 。
  • 例如 AI Scientist 这样的系统,已经不仅仅是辅助查资料,而是能独立提出假设、设计实验、编写代码验证、甚至撰写论文。在这里,Agent 实际上是在遍历一个巨大的“科学假设空间”。
  • **Math & Coding:**这里的 Agent 已经不仅是做题家,而是探险家。通过 Self-Correction 和 Execution Feedback,Agent 可以在写代码时自己写单元测试来验证自己的逻辑 。

局限与未来:你的 Agent 还缺什么?

文章最后 提出的 Open Problems 非常值得深思,这里挑两个最痛的:

  1. World Models (世界模型) 的缺失: 目前的 Agent 很多时候是在“瞎猜”行动后的结果。如果 Agent 脑子里有一个 World Model,能模拟“如果我删了这个文件会发生什么”,它的规划能力将会有质的飞跃。
  2. Latent Agentic Reasoning (隐式推理): 现在的 CoT 都是自然语言,这其实效率很低。未来,模型可能会在高维向量空间里直接进行“纯思维”的规划,而不需要把每一步都翻译成人类语言。

总结

这篇 Agentic Reasoning 的论文告诉我们,我们正处在 AI 发展的十字路口:我们不再仅仅是在训练“模型”,我们是在设计“系统”。

未来的 AI 护城河,可能不在于你有一个多大的 Base Model,而在于你构建了多强大的 Agentic Loop——你的 Agent 能否在环境中生存、记忆、反思,并与他人协作。

最后唠两句

为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选

很简单,这些岗位缺人且高薪

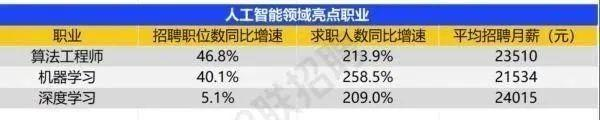
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
在这里插入图片描述

AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。

那0基础普通人如何学习大模型 ?

深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。

我整理出这套 AI 大模型突围资料包【允许白嫖】:

  • ✅从入门到精通的全套视频教程

  • ✅AI大模型学习路线图(0基础到项目实战仅需90天)

  • ✅大模型书籍与技术文档PDF

  • ✅各大厂大模型面试题目详解

  • ✅640套AI大模型报告合集

  • ✅大模型入门实战训练

这份完整版的大模型 AI 学习和面试资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

①从入门到精通的全套视频教程

包含提示词工程、RAG、Agent等技术点

在这里插入图片描述

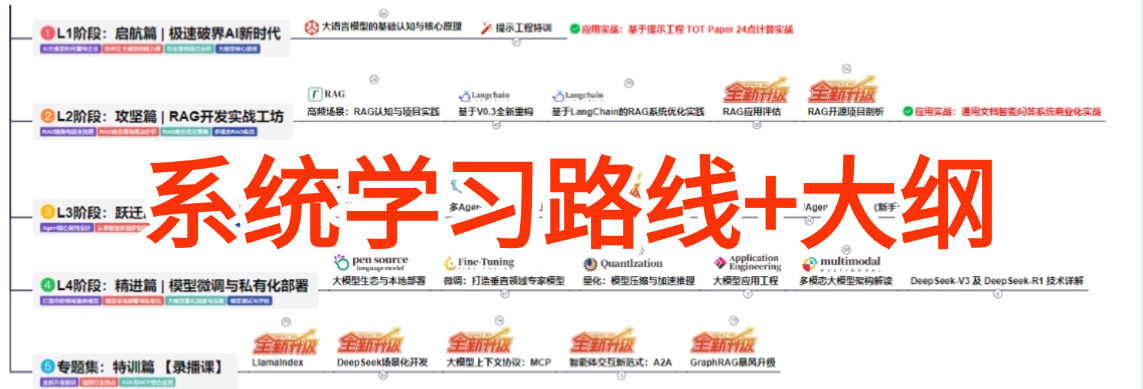
② AI大模型学习路线图(0基础到项目实战仅需90天)

全过程AI大模型学习路线
在这里插入图片描述

③学习电子书籍和技术文档

市面上的大模型书籍确实太多了,这些是我精选出来的
在这里插入图片描述

④各大厂大模型面试题目详解

在这里插入图片描述

⑤640套AI大模型报告合集

在这里插入图片描述

⑥大模型入门实战训练

在这里插入图片描述

如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!

应届毕业生‌:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能 ‌突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。

👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓

在这里插入图片描述

AI智能体时代:从被动响应到主动执行的范式革命 2026年初AI智能体技术的集中爆发,标志着人工智能技术发展的一个重要里程碑。核心技术进步从对话到执行:大语言模型从文本生成升级为目标导向的任务执行能力从单体到协作:单智能体能力提升到多智能体系统协同工作从云端到边缘:AI计算从集中式部署向分布式边缘智能演进从实验到实用:技术从实验室验证走向产业规模化应用中国AI的突破技术实力显现:在智能体编程、多模态生成等领域实现全球领先产业生态成熟:形成了从基础模型到应用开发的全栈能力算力自主可控:国产芯片与AI模型的深度适配取得重要进展开源协同发展。 阅读详情

相关推荐

AI编程代理:从自主执行到主动思考的技术演进与工程实践

在人工智能与软件工程交叉领域,AI编程代理(AI Coding Agent)正成为提升开发效率的关键技术。其核心原理在于将大语言模型(LLM)的代码生成能力与智能体(Agent)框架相结合,通过任务规划、工具调用和环境交互,实现一定程度的自动化编程。这一技术的核心价值在于将开发者从重复性编码任务中解放出来,聚焦于更高层的设计与逻辑。其典型应用场景包括代码自动补全、Bug自动修复、单元测试生成以及根据自然语言描述生成功能模块等。然而,当前多数实现侧重于提升代理的“自主性”(Autonomy),即执行预设任务序

weixin_33834137的博客 328

2026-01-19-论文阅读-Agentic-Reasoning-for-Large-Language-Models

传统 LLM 推理(LLM Reasoning)主要被视为一种对静态输入的单次(One-shot)或少数次(Few-shot)预测任务。传统方法假设上下文是静态的,推理过程发生在模型的内部参数空间中。模型无法在动态环境中采取行动、获取外部信息或根据结果进行自我修正。难以处理需要长期规划(Long-horizon)和持续学习的复杂任务。论文将智能体推理定义为一种以推理为中心机制不再是单纯生成文本序列,而是通过规划(Planning)、行动(Act)和学习(Learn)的闭合回路来解决问题。

ttkqwe的博客 1248

Mythos能力阶跃:大模型的文化语义约束推理范式

大语言模型正从通用文本生成迈向深度文化理解,其核心在于能否在多层语义约束下完成叙事一致性推理。Mythos代表了一种新型推理范式——不依赖参数扩张,而是通过动态路由、多级约束满足与跨文明隐喻知识图谱(CCMKG),实现对隐喻嵌套、文化共识与叙事逻辑的系统性建模。这种能力突破了传统benchmark评估框架,推动AI从概率采样转向约束驱动生成,在内容创作、人文教育与跨文化法律协商等场景中展现出可验证、可问责、可迭代的技术价值。它标志着大模型正成为一种可工程化的‘文化语法解析器’。

weixin_30381317的博客 332

从ChatGPT到AGI:大模型代理推理(Agentic Reasoning)技术全解析,程序员必收藏

这篇论文介绍了大语言模型从"静态推理"到"代理推理"的范式转移,强调推理应是一个物理过程而非仅是内部计算。文章构建了Agent能力的三维框架:基石(规划、工具使用、搜索)、进化(反馈循环、动态记忆)和协作(群体智能)。探讨了两种实现流派:推理时编排和训练后内化,并展示了科学发现、编程等领域的应用。未来AI的竞争力将在于构建强大的代理循环系统,而非仅依赖基础模型大小。

m0_74942241的博客 773

Agentic Reasoning for Large Language Models

推理是推理、问题解决和决策制定的基础认知过程。虽然大型语言模型(LLMs)在封闭世界场景中展现出强大的推理能力(例如数学和代码领域的标准基准测试),但它们在开放式动态环境中仍面临挑战。智能体推理(Agentic Reasoning)的出现标志着一种范式转变,通过将LLMs重构为能够通过持续交互进行规划、行动和学习的自主智能体,架起了思维与行动之间的桥梁。在本综述中,我们通过三个互补维度组织智能体推理,提供了一个系统的研究路线图。

c_cpp_csharp的专栏 225

层层剥开Allegro skill--快速抓取并写入Allegro软件【呕血创作,转载注明】

Allegro skill eda pcb

qq_36492361的博客 1253

【Agent】Agentic Reasoning for Large Language Models

Agentic Reasoning for Large Language Models - 自进化推理机制,演化的核心包含两个基本机制:反馈与记忆。反馈为自我修正与优化提供评估信号,使智能体能够根据结果或环境响应来调整其推理策略。记忆则作为持久的基底,用于存储、组织和综合过往交互,从而实现跨任务的知识积累与复用。 - 其中,反思包括三种。反思性反馈,模型通过自我批判或验证来修正其推理;参数化适应,将反馈整合为更新后的模型参数;以及验证器驱动的反馈,通过二元结果信号引导重采样,无需内部反思。 @[toc

发现问题,并解决问题,批判性思维 1087

x265探索与研究(四):如何编码视频?

如何编码视频?           本文介绍x265中的两种编码视频方法,一是采用命令行的方法;二是GUI的方式。   1、命令行的方法   (1)、第一种方式生成*.265格式的视频文件           第一种方式可以生成*.265格式的视频文件,对应的命令为: x265 --input-res 352x288 --fps 30 hall_cif_352x288_300.y

成长Bar的博客专栏 3936

AGI大模型2025年发展报告:现状分析及未来路径

*图表30:知识图谱通过机器学习和自然语言处理来构建节点、**

2401_84494441的博客 9702

RK3588更新NPU驱动的方法

想要在 RK3588 上跑一下 deepseek 的大模型,发现目前的内核提供的 NPU 驱动比较低,无法支持新的大模型,所以需要更新一下我们的 NPU 驱动本次更新的NPU驱动仅适用于RK3588和RK3676系列。

荻夜的博客 2151

第3版•系统集成项目管理工程师(中级) │ 第6章 数据工程

🥏第3版•系统集成项目管理工程师(中级) │ 第6章 数据工程

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 1万+

代理式AI:突破大模型OOD泛化瓶颈的主动智能体架构

在人工智能领域,分布外泛化(OOD泛化)是衡量模型实用性的核心指标,指模型在训练数据分布之外的真实场景中保持性能的能力。其原理在于传统模型依赖静态数据拟合,而现实世界动态演变导致分布偏移。代理式AI通过构建感知-规划-行动-观察的智能体循环,将大模型从被动应答转变为主动决策引擎,结合工具调用与记忆系统,实现了在未知场景下的动态适应与策略优化。这种范式尤其适用于数据分析、智能客服等需要处理多变输入和复杂逻辑的工程实践场景,为解决大模型落地中的OOD难题提供了系统性架构方案。

weixin_30617737的博客 654

s8654

The official Snapdragon Ride SX 4.0 development board provides standardized hardware support for the secondary development and functional verification of the s8654 platform.

qq_39257814的博客 6830

豆包大模型2.0:从工具到认知代理的范式跃迁

大模型已超越单纯的语言理解与生成,进入以任务泛化、人机协同和工程可落地为标志的‘认知代理’新阶段。其核心在于将AI从被动响应的‘工具’升级为主动分解任务、感知可信度、分层调用记忆的‘数字同事’。这一演进依托动态任务分解引擎、可信度感知机制与场景化精调层(Adapter)等关键技术,显著降低决策摩擦与落地成本。典型应用场景覆盖合同审查、财报分析、教育备课等垂直领域,尤其适合非技术背景业务人员快速构建AI工作流。豆包大模型2.0正是这一范式迁移的代表性实践。

weixin_32380501的博客 311

【Android 教程系列第 30 篇】为什么要为 App 应用加固 ?如何为 App 应用加固 ?

一:为什么要为 App 应用加固 ? 二:如何为 App 应用加固 ? 三:加固后为什么要重新签名 ?

“Allen Su”的博客 7053

图像质量评估和点云质量评估

本文介绍了图像质量评估和点云质量评估的基本概念和常用方法,并提供了相应的源代码示例。图像质量评估关注图像的视觉质量,常用的评估指标包括均方误差(MSE)、结构相似性指标(SSIM)和峰值信噪比(PSNR)。点云质量评估关注点云数据的准确性和完整性,常用的评估方法包括点云配准质量评估、稠密重建质量评估和离群点检测质量评估。在计算机视觉和计算机图形学领域中,图像质量评估和点云质量评估是两个重要的任务。图像质量评估旨在量化图像的视觉质量,而点云质量评估则关注于点云数据的准确性和完整性。

XsupDatabase的博客 990

推理范式的演进

研究发现,通过在提示(Prompt)中显式地加入“让我们一步步思考”的引导,或者提供包含中间推理步骤的少样本示例(Few-shot Demonstrations),模型被强制将单步的直觉预测拆解为线性的逻辑推演链条。神经网络被视为一个巨大的“黑盒”,其推理过程是隐式的、直觉式的(类似于System 1),缺乏显式的因果推演步骤[4]。推理过程重新变得可见且可控,不仅大幅提升了数学求解与符号逻辑任务的准确率,更重要的是,它证明了逻辑推理可以作为大规模概率生成的“副产品”被激发出来,而无须专门的逻辑训练。

夏天又到了的专栏 192

android 14.0 去掉usb授权提示框 默认给予权限

在14.0的系统rom产品开发中,在进行iot关于插入usb设备的开发过程中,在插入usb设备时会弹出usb授权提示框,也带来一些不便, 这个需要默认授予USB权限,插拔usb都不弹出usb弹窗所以这要从usb授权相关管理页默认给与usb权限,接下来分析下 相关的实现功能流程

安卓兼职framework和app工程师的博客 2263

AgenticRS架构解析:从被动推荐到主动智能代理的范式跃迁

在推荐系统领域,协同过滤、矩阵分解和深度学习模型构成了传统推荐的技术基石,其核心原理是通过分析用户历史行为与物品特征,预测用户偏好并生成静态列表。随着大语言模型(LLM)和智能体(Agent)技术的发展,推荐系统正经历从被动响应的信息服务向主动规划的任务执行者演进。这一技术跃迁的核心价值在于,系统能够融合LLM的深度推理与规划能力,以及传统推荐模型的高效检索与排序能力,从而主动理解用户动态、多模态的意图,并调用外部工具执行复杂任务。其典型应用场景包括电商、内容平台等需要深度个性化与场景化服务的领域。本文聚焦

weixin_33843409的博客 338

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

大模型未来已来:从ChatGPT到Agentic AI的收藏级进阶指南

AI正从被动的大语言模型向主动的代理式人工智能(Agentic AI)演进。这类系统通过感知、推理、行动和记忆形成闭环控制,采用ReAct范式解决复杂问题,并逐步实现多智能体协作。尽管面临幻觉、对齐危机和可靠性等挑战,Agentic AI正朝着可信"数字同事"方向发展,未来将通过混合架构、标准化审计和跨学科融合实现技术稳健性与伦理保障的平衡。这一转变不仅是功能升级,更代表着AI架构的革命性突破。

2401_84204207的博客 671

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

基于分层信念状态记忆的代理式推荐系统:从被动响应到主动规划

推荐系统作为信息分发的核心技术,其核心原理是通过算法模型分析用户历史行为与偏好,实现内容的个性化匹配。传统方法主要依赖协同过滤、深度学习等模型优化点击率等短期指标,但存在被动响应、难以理解用户深层意图的局限。随着大模型与强化学习等技术的发展,推荐系统的技术价值正从“猜你喜欢”向“懂你所想”演进,旨在构建具备长期目标导向与深度交互能力的智能服务。其应用场景已从电商、内容平台延伸至在线教育、智能导购等需要多轮规划与认知理解的复杂领域。本文聚焦的【代理式推荐系统】与【分层记忆】技术,正是这一演进的前沿实践,通过引

weixin_33895475的博客 297

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

Mythos技术解析:大模型推理时计算与系统建模驱动的安全范式跃迁

大语言模型正从‘文本生成工具’演进为具备深度系统理解与自主推理能力的智能体。其核心原理在于推理时计算(Reasoning-Time Compute)的动态调度与数字孪生式系统建模,技术价值体现在将漏洞发现升维为状态空间中的危险路径推演,显著提升攻防闭环效率与防御前置能力。典型应用场景覆盖企业渗透测试、开源项目自动化审计、云原生红蓝对抗等真实安全工程环节。Mythos作为该范式的标志性实现,验证了稀疏化MoE架构、分形推理框架(FRF)与轻量级系统仿真引擎(SSE)协同带来的能力断层式突破。

ctk87443的博客 442

从被动镜像到主动代理:合子数字孪生与网络化Physical AI的架构演进

数字孪生技术正经历从被动镜像到主动代理的范式转变,其核心驱动力是Physical AI(物理人工智能)在网络环境中的下沉与融合。传统数字孪生主要实现物理实体的状态映射与可视化监控,而合子数字孪生则借鉴了‘合子’哲学思想,将每个孪生体构建为兼具个体自主性与系统协作性的智能代理。其架构通常包含基于主动推理的自主决策层和基于网络化协议的协作层,使得孪生体能代表物理实体在网络中自主行动、协商并优化整体系统目标。这种转变能有效应对复杂工业物联网场景中的动态性与不确定性,例如在智能工厂中实现设备间的动态任务分配与弹性响

weixin_34342207的博客 383

o1大模型:显式推理链驱动的高确定性AI范式

大语言模型正从黑箱响应走向白盒推理,思维链(Chain-of-Thought)不再依赖提示词工程,而是成为模型原生具备的显式、可观测、可中断的推理能力。其核心在于将问题分解为可验证步骤,动态调度计算资源,并深度融合工具调用与多源证据验证,从而在金融风控、医疗诊断、工业运维等高确定性场景中实现因果归因与合规可审计。这种以‘推理过程即服务’的技术路径,标志着AI从概率输出迈向可追溯决策的关键跃迁——o1正是这一范式的首个商用落地代表。

weixin_30216561的博客 404

AI交互即将颠覆!从“被动问答”到“主动代理”,你还在用旧方式吗?

Agent不是"更聪明的AI",而是一种不同的架构思路——从被动响应,到主动执行;从单轮推理,到循环推进。理解这个差异,不是为了追逐技术概念,而是为了更准确地判断:手里的AI工具,在什么场景下能真正替代人力,在什么场景下还只是"更好的搜索引擎"。AI的黄金十年,真的来了!在行业火爆之下,AI人才争夺战也日趋白热化,其就业前景一片蓝海!我给大家准备了一份全套的《AI大模型零基础入门+进阶学习资源包》,包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

2401_84204413的博客 399

OpenClaw vs 普通 API 调用:从编排者到委托者的根本性范式转变

本文对比了传统API调用与OpenClaw智能代理的核心区别。传统API需要开发者手动编排执行流程,而OpenClaw通过ReAct推理循环,让LLM动态决定API调用顺序和错误处理。两者的本质差异在于确定性vs灵活性:传统API适用于规则明确的场景,OpenClaw则擅长处理模糊、多步骤任务。对开发者而言,重点从编写业务逻辑转向设计清晰安全的接口契约,以适应AI代理的调用方式。这种范式转变将开发角色从"流程编排者"升级为"能力提供者"。

DrLai的博客 610
上一篇: 深度智能体开发实战:基于LangChain与LangGraph的Python实现
下一篇: 多智能体架构完全指南:从单一智能体到提升90.2%性能的架构设计
Agent学习路线
博客等级 码龄6年 1万+粉丝 1904原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值