【AI大模型面试】大模型集成学习:从基础到高级,一篇搞定,值得收藏

机器学习系列笔记十三: 集成学习/模型聚合 机器学习系列笔记十三: 集成学习/模型聚合 文章目录机器学习系列笔记十三: 集成学习/模型聚合什么是集成学习VotingHard Voting模拟实现Hard Voting 集成学习使用Voting ClassifierSoft Voting使用Soft Voting实现集成学习Bagging对Bagging的使用OOB与关于Bagging的更多讨论随机森林与Extra-Trees随机森林使用随机森林Extra-Trees使用Extra-Trees集成学习解决回归问题BoostingAdaBoost使用Ad 阅读详情

大模型集成方法

集成学习是机器学习领域的重要研究方向之一,它是一种通过构建并结合多个学习器来解决单一问题的机器学习范式。这种方法的核心思想是通过组合多个模型的预测结果,以提升整体预测性能。集成学习通常能够显著提升模型的准确性和健壮性。通过组合多个模型,集成学习能够减少过拟合,降低模型的方差,从而在多种数据集上实现更好的泛化能力。

集成方法分类

输出集成

由《Exchange-of-Thought: Enhancing Large Language Model Capabilities through Cross-Model Communication》论文中提出的概念,如下图所示,一个模型可以借鉴其他模型的推理和思考过程,从而更好地解决问题。这可以提升模型的性能和准确性。

概率集成

概率集成与传统的机器学习融合相似,其中一种常见的策略是对模型预测的logits结果进行平均处理。大模型的概率集成可以在Transformer的词表输出概率层次进行融合。然而,需要注意的是,这样的操作要求其融合的多个原始模型的词表保持一致。

可以形式化地表示为:

给定 个模型,其logits输出为 ,且所有(词表一致),则Logits平均集成可表示为:

混合专家模型(MoE)

作为集成学习领域的一种先进方法,MoE凭借其特有的稀疏化处理和分布式路由机制,在大模型时代资源消耗巨大的背景下熠熠生辉。

专家模型(Expert Models)

这种方法与集成学习有相似之处,其核心是为由众多独立专家网络构成的集合体创立一个协调融合机制。在这样的架构下,每个独立的网络(通常被称为"专家")负责处理数据集中的特定子集,并且专注于特定的输入数据区域。这种子集可能偏向于某种话题、某种领域、某种问题分类等,并不是一个显式的概念。

门控网络(Gating Network / Router Network)

面对不同的输入数据,一个关键的问题是系统如何决定由哪个专家来处理。门控网络(Gating network)也叫做路由(Router)就是为解决这一问题而设计的,它通过动态分配权重来确定各个专家的工作职责。在整个训练过程中,这些专家网络和门控网络会同步进行训练,并且这个过程是自动进行的,并不需要显式地手动操控。

MoE嵌入到Transformer中,用稀疏激活的"专家"子网络替代原有Transformer中前馈网络(FFN)层,从而在几乎不增加计算量的前提下,大幅扩展模型容量。用"稀疏激活的多个FFN专家"替换"单个Dense FFN",让模型"看起来很大,实际算得很少"。

DeepSeekMoE创新

2025年初,DeepSeek火出了圈。凭借DeepSeek-V3与DeepSeek-R1的创新技术和卓越表现,DeepSeek迅速成为了行业内外的焦点。并且发表了论文《DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models》,公布了其DeepSeekMoE的架构,如下图所示:

上图展示了DeepSeek在传统混合专家模型(MoE)架构(a)基础上进行的两项关键改进(b)和(c):

**(a) 传统MoE架构:**该模块包含N个前馈网络(FFN)专家,每个专家擅长处理不同类型的数据特征。通过路由机制,系统根据输入特性动态选择K=2个最相关的专家进行处理,而非激活全部专家。模型总参数量由所有专家参数累加而成,而实际计算时仅使用被激活专家的参数。

(b) 专家细粒度化:DeepSeek将原有N个专家进一步细分为m×N个微型专家,每个专家的隐藏层维度相应缩减至原来的1/m。在保持总参数量和激活参数量不变的前提下,通过激活m×K个微型专家,使模型能够以更精细的方式组合专家能力,增强了对复杂特征的适配灵活性。图中m设置为2,K为2。

© 共享专家:该设计将专家划分为共享专家和路由专家两类。共享专家会处理所有输入数据,无需经过路由筛选,负责提取数据的通用特征;而路由专家则通过路由模块计算输入与各专家的匹配度,仅对最相关的数据进行处理。最终将两类专家的输出结果融合,形成模块的最终输出。这种架构使模型既能学习数据的共性特征,又能捕捉特异性模式,从而显著提升模型的泛化能力和场景适应性。

普通人如何抓住AI大模型的风口?

为什么要学AI大模型

当下,⼈⼯智能市场迎来了爆发期,并逐渐进⼊以⼈⼯通⽤智能(AGI)为主导的新时代。企业纷纷官宣“ AI+ ”战略,为新兴技术⼈才创造丰富的就业机会,⼈才缺⼝将达 400 万!

DeepSeek问世以来,生成式AI和大模型技术爆发式增长,让很多岗位重新成了炙手可热的新星,岗位薪资远超很多后端岗位,在程序员中稳居前列。
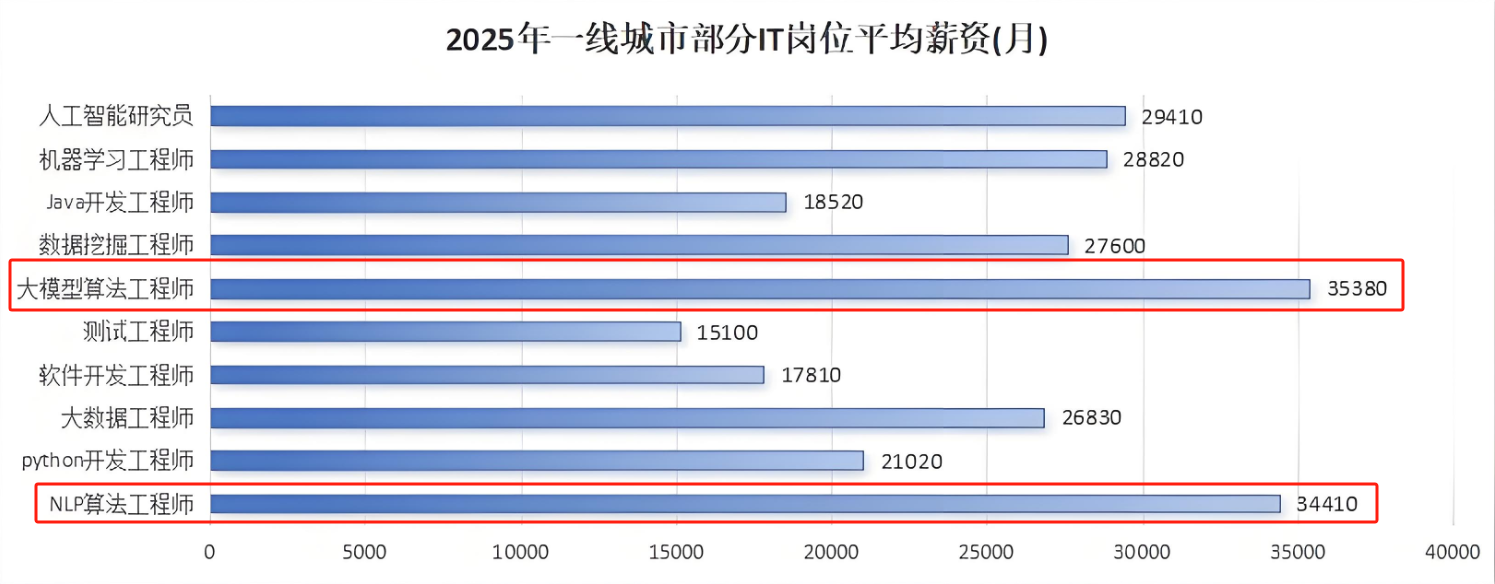
在这里插入图片描述

与此同时AI与各行各业深度融合,飞速发展,成为炙手可热的新风口,企业非常需要了解AI、懂AI、会用AI的员工,纷纷开出高薪招聘AI大模型相关岗位。
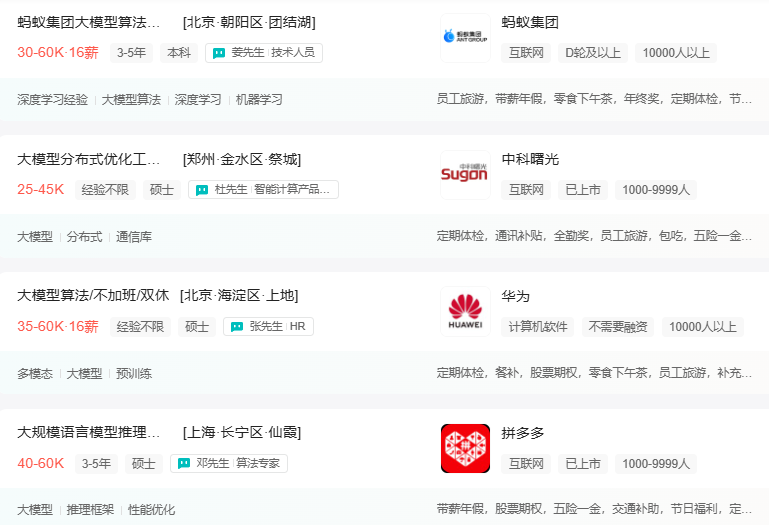
在这里插入图片描述

AI大模型开发工程师对AI大模型需要了解到什么程度呢?我们先看一下招聘需求:

在这里插入图片描述

知道人家要什么能力,一切就好办了!我整理了AI大模型开发工程师需要掌握的知识如下:

大模型基础知识

你得知道市面上的大模型产品生态和产品线;还要了解Llama、Qwen等开源大模型与OpenAI等闭源模型的能力差异;以及了解开源模型的二次开发优势,以及闭源模型的商业化限制,等等。

img

了解这些技术的目的在于建立与算法工程师的共通语言,确保能够沟通项目需求,同时具备管理AI项目进展、合理分配项目资源、把握和控制项目成本的能力。

产品经理还需要有业务sense,这其实就又回到了产品人的看家本领上。我们知道先阶段AI的局限性还非常大,模型生成的内容不理想甚至错误的情况屡见不鲜。因此AI产品经理看技术,更多的是从技术边界、成本等角度出发,选择合适的技术方案来实现需求,甚至用业务来补足技术的短板。

AI Agent

现阶段,AI Agent的发展可谓是百花齐放,甚至有人说,Agent就是未来应用该有的样子,所以这个LLM的重要分支,必须要掌握。

Agent,中文名为“智能体”,由控制端(Brain)、感知端(Perception)和行动端(Action)组成,是一种能够在特定环境中自主行动、感知环境、做出决策并与其他Agent或人类进行交互的计算机程序或实体。简单来说就是给大模型这个大脑装上“记忆”、装上“手”和“脚”,让它自动完成工作。

Agent的核心特性

自主性: 能够独立做出决策,不依赖人类的直接控制。

适应性: 能够根据环境的变化调整其行为。

交互性: 能够与人类或其他系统进行有效沟通和交互。

img

对于大模型开发工程师来说,学习Agent更多的是理解它的设计理念和工作方式。零代码的大模型应用开发平台也有很多,比如dify、coze,拿来做一个小项目,你就会发现,其实并不难。

AI 应用项目开发流程

如果产品形态和开发模式都和过去不一样了,那还画啥原型?怎么排项目周期?这将深刻影响产品经理这个岗位本身的价值构成,所以每个AI产品经理都必须要了解它。

img

看着都是新词,其实接触起来,也不难。

从0到1的大模型系统学习籽料

最近很多程序员朋友都已经学习或者准备学习 AI 大模型,后台也经常会有小伙伴咨询学习路线和学习资料,我特别拜托北京清华大学学士和美国加州理工学院博士学位的鲁为民老师(吴文俊奖得主)
在这里插入图片描述

给大家准备了一份涵盖了AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频 全系列的学习资料,这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。

图片

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
适学人群

应届毕业生‌: 无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。

零基础转型‌: 非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界‌。

业务赋能突破瓶颈: 传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型‌。
在这里插入图片描述

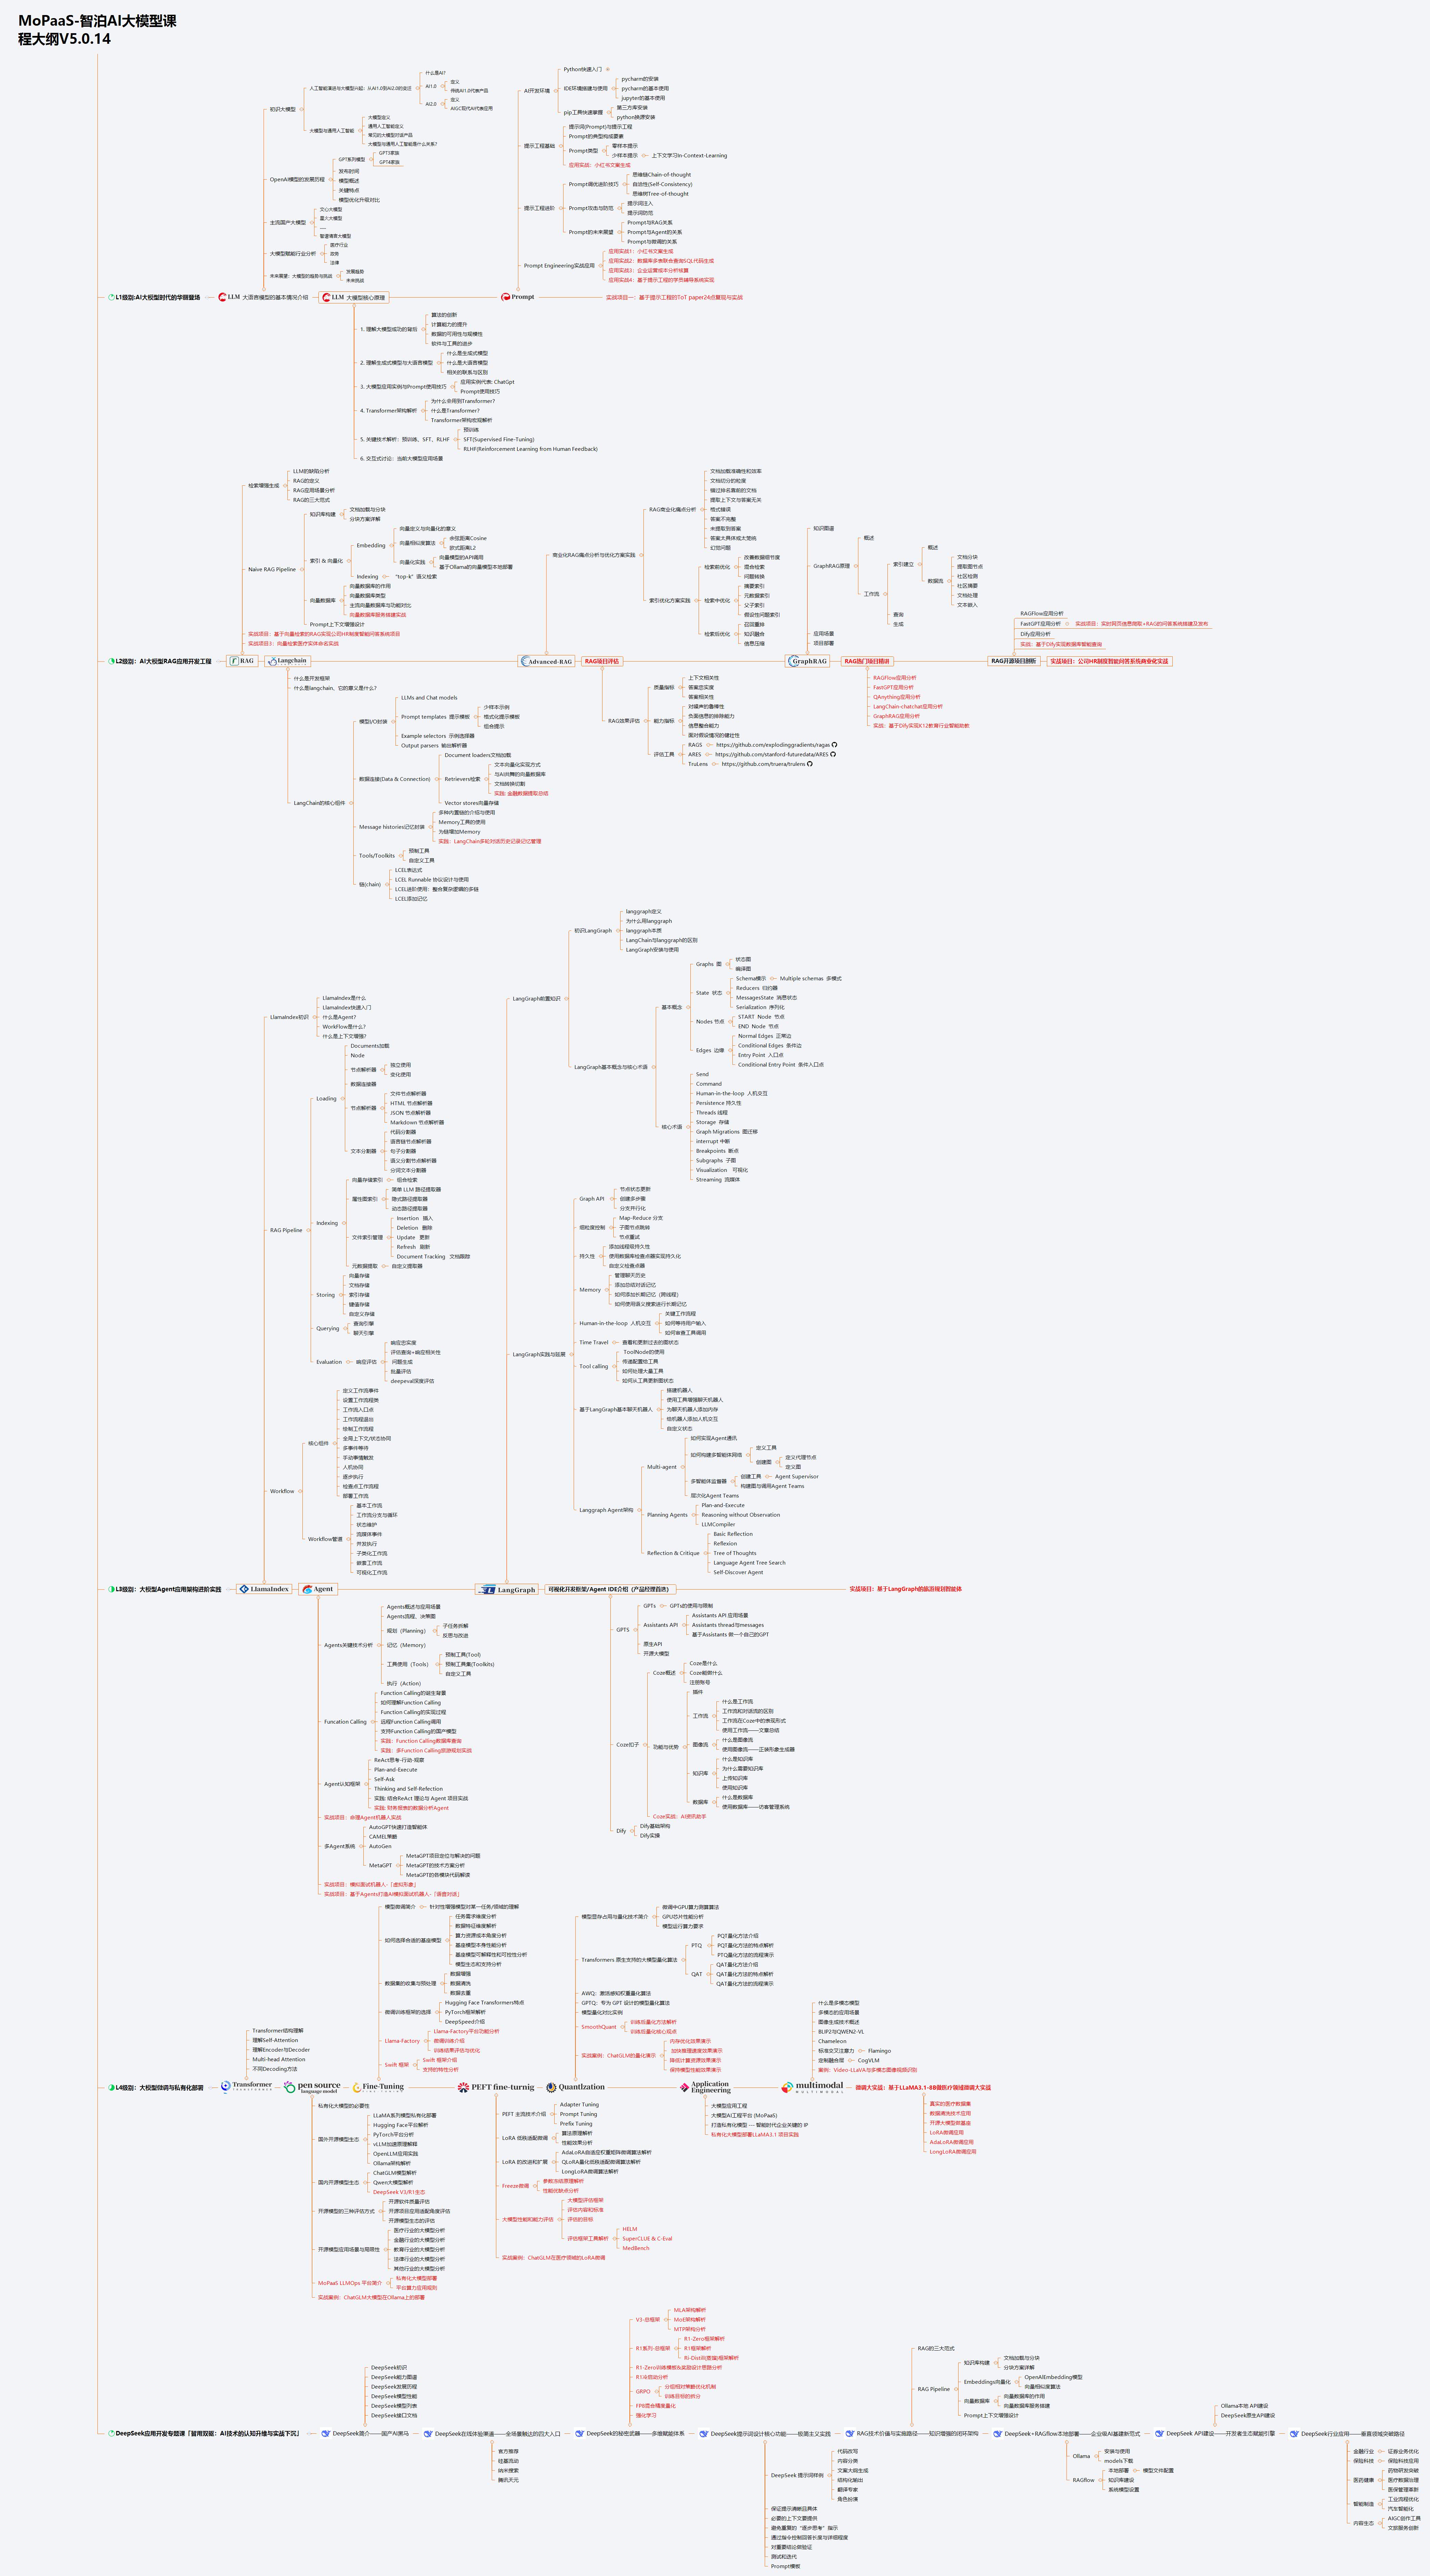
AI大模型系统学习路线

在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。

  • 基础篇,包括了大模型的基本情况,核心原理,带你认识了解大模型提示词,Transformer架构,预训练、SFT、RLHF等一些基础概念,用最易懂的方式带你入门AI大模型
  • 进阶篇,你将掌握RAG,Langchain、Agent的核心原理和应用,学习如何微调大模型,让大模型更适合自己的行业需求,私有化部署大模型,让自己的数据更加安全
  • 项目实战篇,会手把手一步步带着大家练习企业级落地项目,比如电商行业的智能客服、智能销售项目,教育行业的智慧校园、智能辅导项目等等
img

但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。

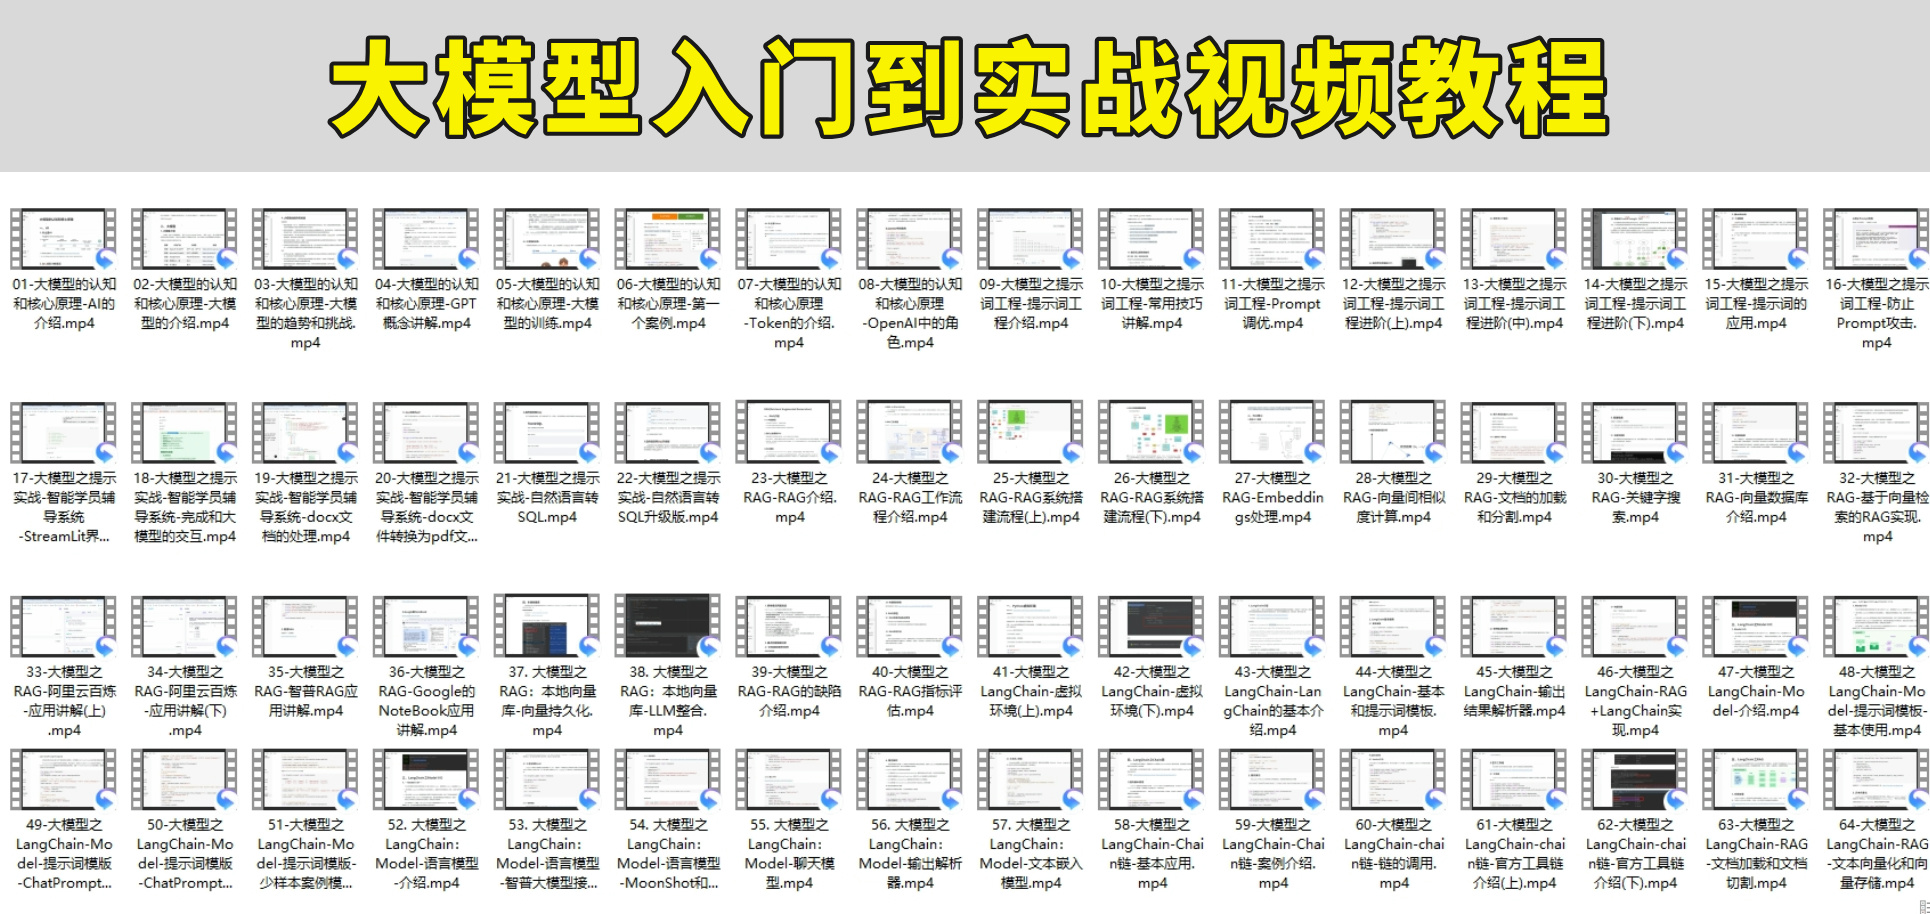
AI大模型入门到实战的视频教程+项目包

看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
在这里插入图片描述
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
在这里插入图片描述

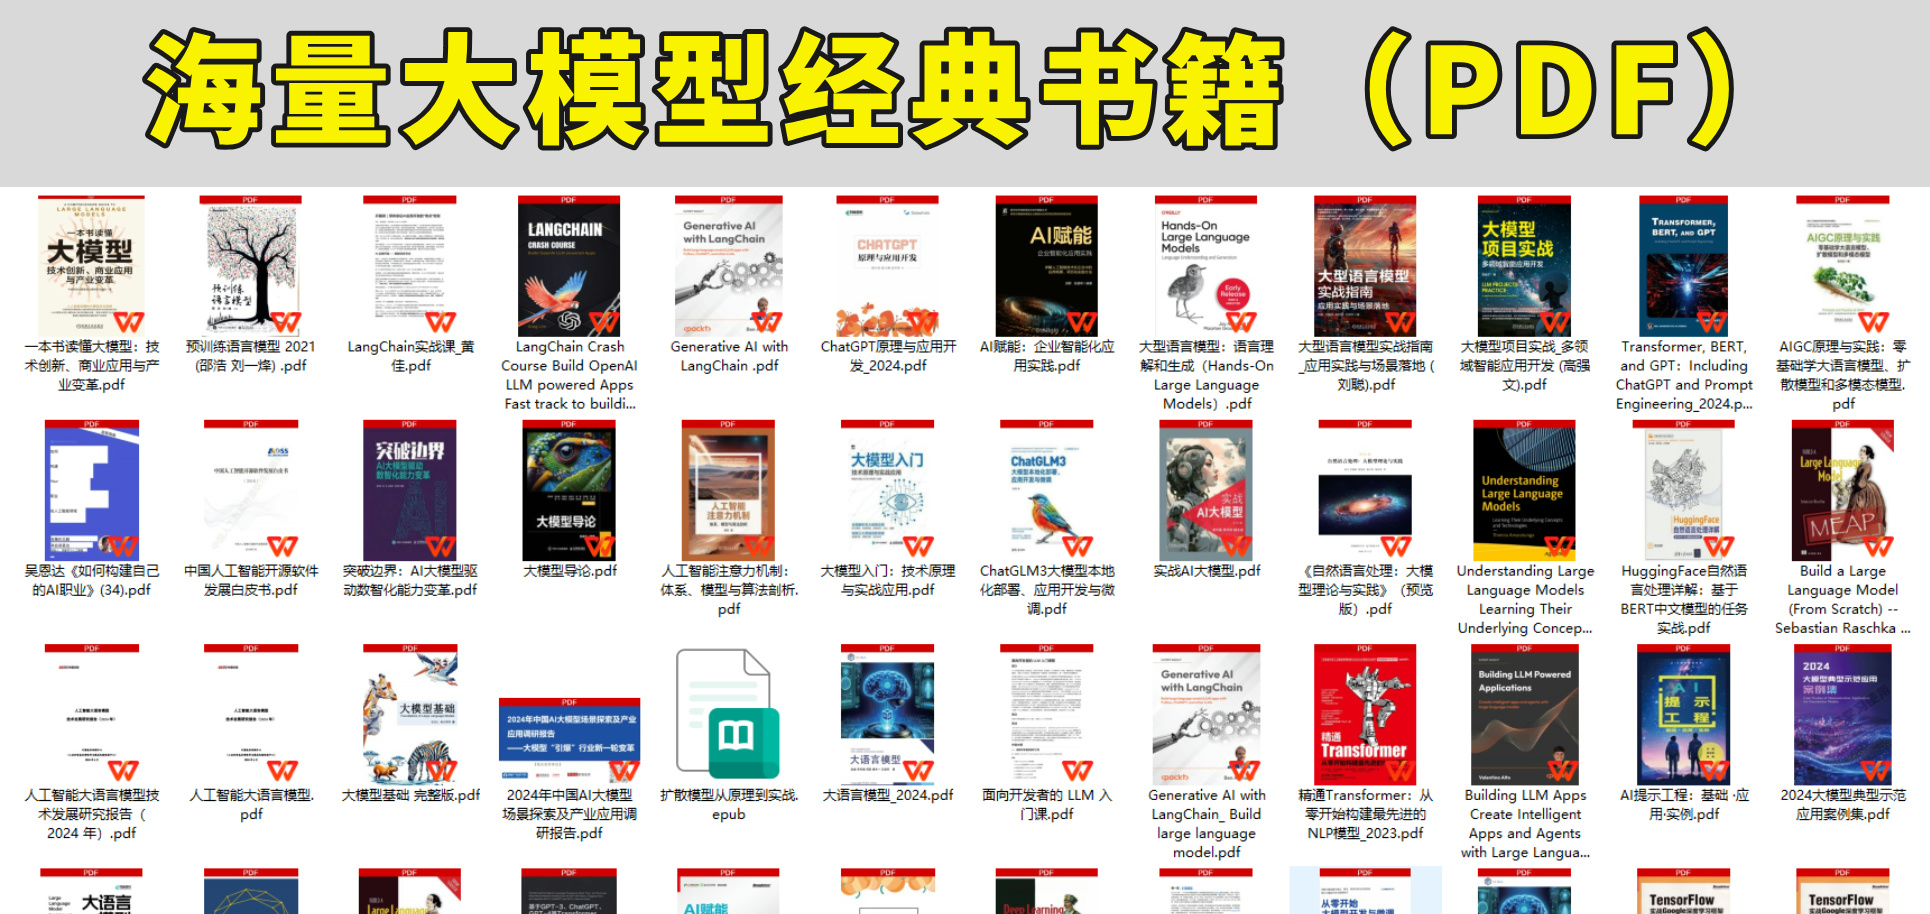
海量AI大模型必读的经典书籍(PDF)

阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
在这里插入图片描述

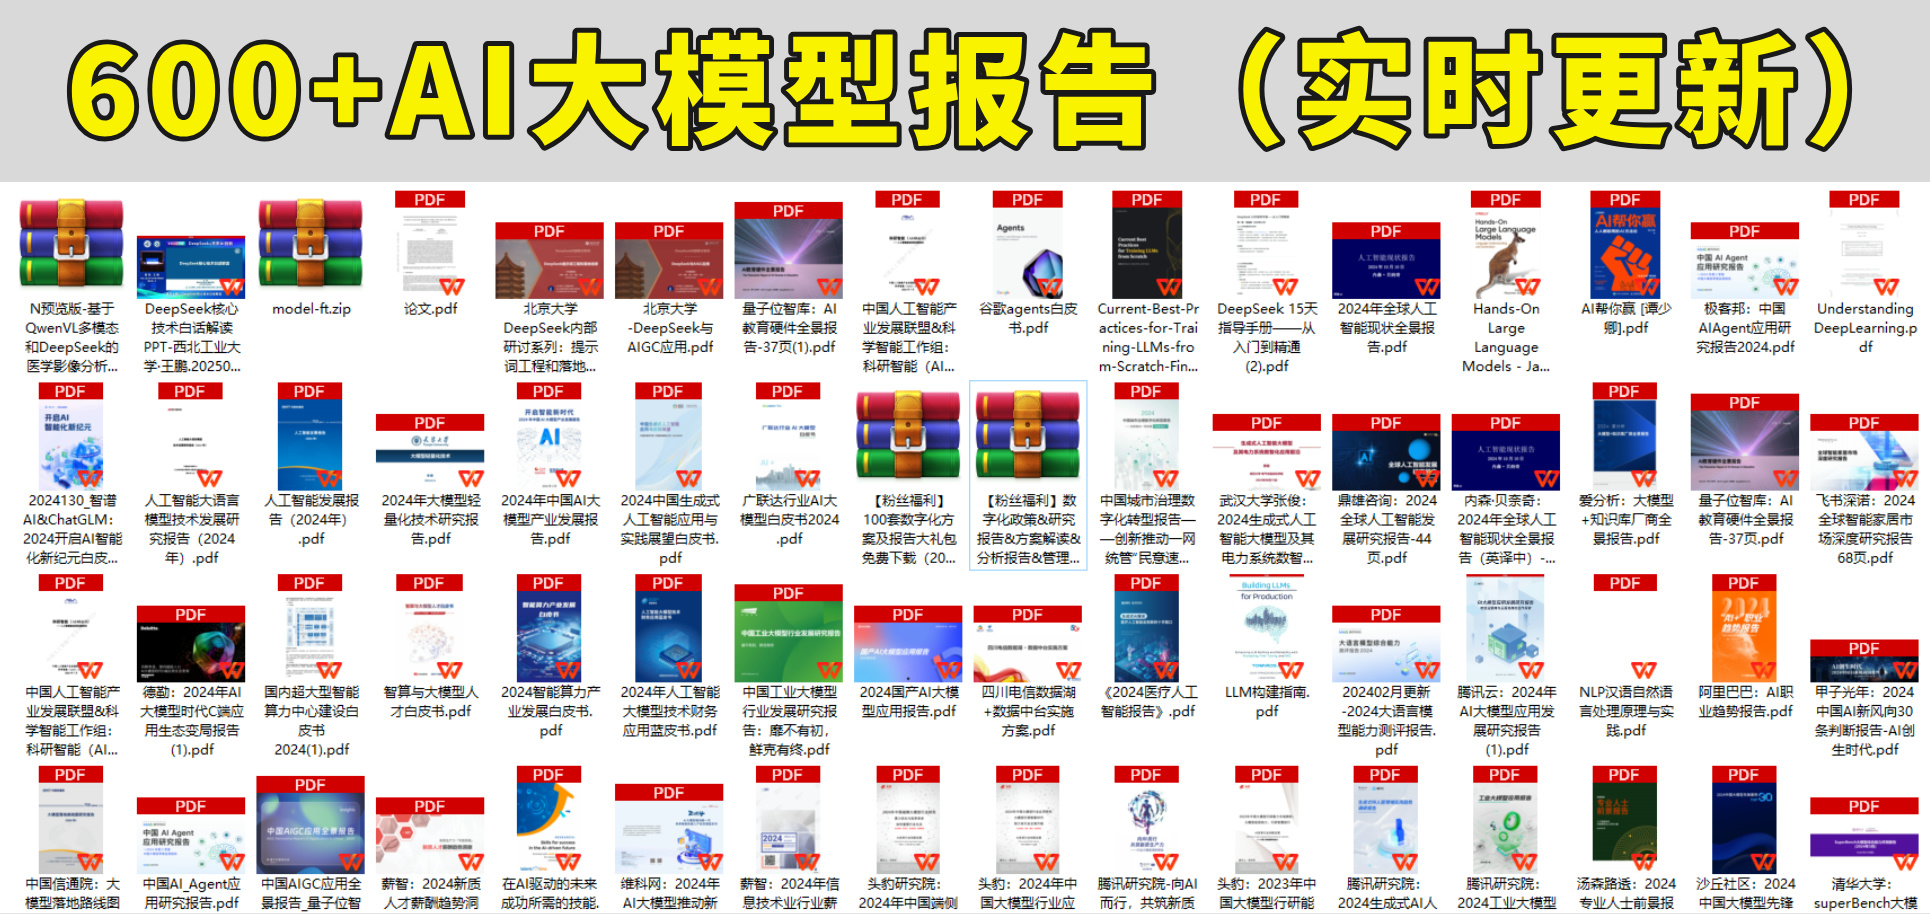
600+AI大模型报告(实时更新)

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
在这里插入图片描述

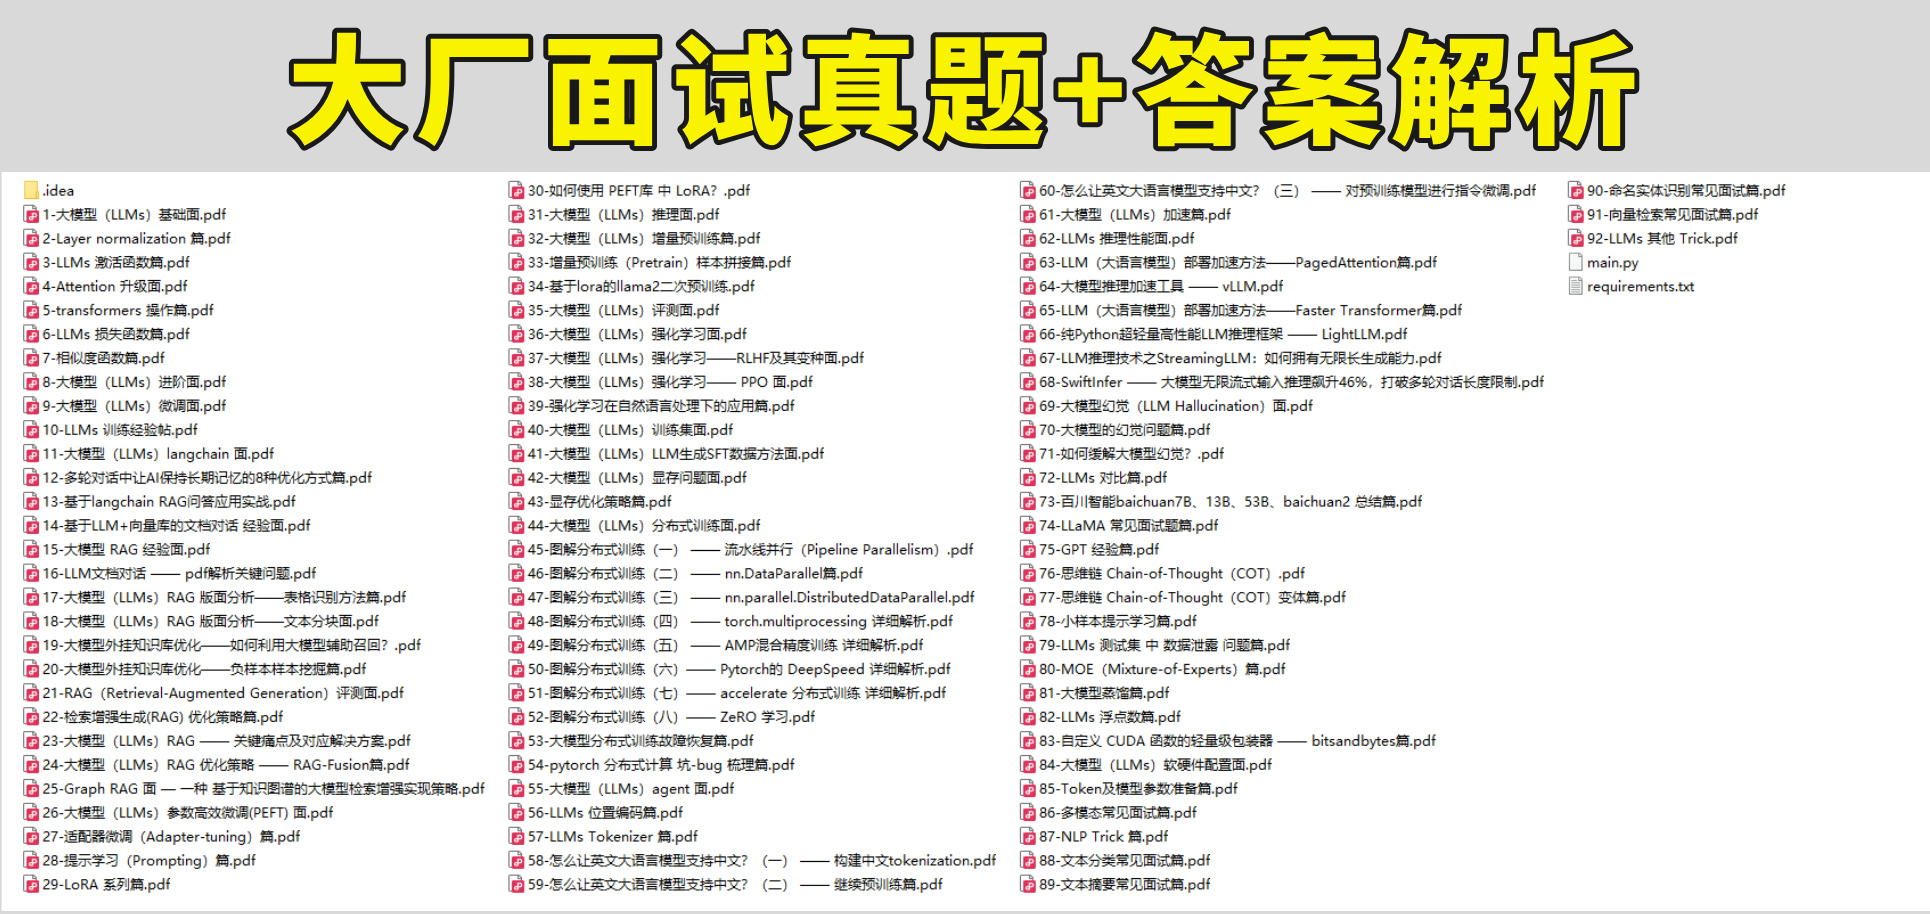
AI大模型面试真题+答案解析

我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
在这里插入图片描述

在这里插入图片描述

AI时代,企业最需要的是既懂技术、又有实战经验的复合型人才,**当前人工智能岗位需求多,薪资高,前景好。**在职场里,选对赛道就能赢在起跑线。抓住AI这个风口,相信下一个人生赢家就是你!机会,永远留给有准备的人。

如何获取?

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

AI大模型最新算法岗常见面试题100道(值得收藏) 大模型无疑是当今最具影响力的AI技术之一,它正在革新包括自然语言处理、机器翻译、内容创作和客户服务等多个行业,并逐渐成为未来商业环境的重要组成部分。截至目前,大模型的数量已超过200个。在这个大模型盛行的时代,大模型技术的竞争愈发激烈,大模型相关的岗位和面试也开始变得越来越卷。本文总结了大模型算法岗位面试题(含答案),内容如下:一、基础篇1、目前主流的开源模型体系有哪些?Transformer体系:由Google提出的Transformer模型及其变体,如BERT、GPT等。 阅读详情

相关推荐

SWIFT报文实战指南:从MT700到MT799的信用证操作全解析

本文深入解析了国际贸易中信用证操作的核心SWIFT报文流程,从开证的MT700到各类通知、修改及结算报文(如MT707、MT730、MT754、MT732/734等)。通过实战案例与关键字段拆解,指导外贸与银行从业者精准处理报文,规避风险,并探讨了利用自动化工具提升处理效率的方法,助力保障跨境交易顺畅。

weixin_29015801的博客 879

大模型 | 快速学会集成学习算法(Ensemble Methods)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

老皮的博客 1476

Ansys Lumerical实战:5步搞定Mach-Zehnder调制器多物理场仿真(附眼图分析技巧)

本文详细介绍了使用Ansys Lumerical进行行波马赫-曾德尔调制器多物理场仿真的完整流程。通过CHARGE、MODE和INTERCONNECT三大模块的协同工作,从电学参数提取、光学射频特性分析到系统级眼图评估,分步解析了高效仿真与性能优化的核心技巧,为硅光调制器设计提供了实战指南。

weixin_29056781的博客 542

AI智能体入门必学:从概念到实战,一篇搞定大模型应用指南,值得收藏

智能体(AI Agents或Agents)是指能够自主感知环境、做出决策并执行行动的系统或程序。IBM:智能体是能够通过设计其工作流和利用可用工具,代表用户或其他系统自主执行任务的系统或程序。Google谷歌:从最基本的层面来看,生成式人工智能代理可以被定义为这样一种应用程序:它通过观察周围环境并利用自身所拥有的工具来采取行动,从而试图达成某个目标。

qq_46094651的博客 1062

C++ bitset总结

数据结构bitset 术语:某1位置位是置1,某一位复位是某一位清零。 文章目录数据结构bitset一、3种初始化方式二、位访问三、位操作四、 位集操作总结实战练习 一、3种初始化方式 bitset<32> tmp; //默认构造函数,默认全0。 bitset<32> tmp(-1); //从整形数构造 bitset<32> tmp("101"); //从包含1和0的字符串构造 二、位访问 bitset<32> tmp(256)

qq_43807092的博客 721

电路研究9.4——合宙Air780EP的LuatOS、CSDK跟标准AT

 C-SDK、AT指令、LuatOS

esmember的博客 1116

终于有人总结了人工智能知识!(非常详细)零基础入门到精通,收藏这一篇就够了

首先,我们定义了人工智能的基本概念,这是理解整个领域的基础。随后,通过对人工智能发展历程的梳理,我们展示了其从诞生到如今的演变轨迹,凸显了其在科技进步中的重要地位。接下来,我们深入探讨了机器学习与深度学习这两项核心技术。它们作为人工智能领域的两大支柱,不仅推动了技术边界的不断拓展,也为实现更高级别的智能应用提供了可能。此外,我们还特别关注了大模型与AIGC(Artificial Intelligence Generated Content,人工智能生成内容)的兴起。

xx16755498979的博客 5999

SAP WMS开发实战:用BAPI_L_TO_CREATE_MULTIPLE搞定LT01转储单(附完整代码)

本文详细解析了SAP WMS开发中如何利用BAPI_L_TO_CREATE_MULTIPLE函数模块批量创建LT01转储单。文章深入剖析了核心参数、常见错误及实战代码框架,重点强调了源/目标存储类型等关键字段的获取方法,为系统集成与自动化流程开发提供了可靠的解决方案。

view3的博客 561

AI大模型面试八股文【附答案】,非常详细收藏我这一篇就够了

层归一化 Layer Norm 在 大语言模型 LLMs 中的不同位置 有什么区别么?如果有,能介绍一下区别么?在大语言模型(Large Language Models)中,Layer Norm(层归一化)可以应用在不同位置,包括输入层、输出层和中间隐藏层。这些位置的归一化有一些区别:输入层归一化:在输入层应用 Layer Norm 可以将输入的特征进行归一化,使得输入数据的分布更加稳定。这有助于减少不同样本之间的分布差异,提高模型的泛化能力。

m0_63171455的博客 1910

Android开发者必看:5分钟搞定MQTT客户端连接EMQX服务器(附完整代码)

本文为Android开发者提供了一份快速实现MQTT客户端连接EMQX服务器的实战指南。通过引入Eclipse Paho SDK,详细讲解了从项目配置、权限申请到核心连接、主题订阅与消息发布的完整流程,并附有即拿即用的Kotlin代码,帮助开发者在物联网应用中高效集成轻量级实时通信功能。

weixin_29228781的博客 271

WorkBuddy 连接百度网盘:能查能上传,但别指望 AI 帮你下载

本文介绍了如何通过WorkBuddy连接百度网盘实现文件管理功能。首先需要在百度开放平台创建应用并获取AppKey等凭证,然后通过拼接授权URL获取Access Token并填入WorkBuddy。实际测试表明,该连接器支持查看目录结构、搜索文件及上传文档,但无法实现文件下载和创建分享链接,原因是百度网盘MCP Server未提供相关接口。使用前需明确功能限制,该方案适合需要远程查阅网盘内容但不涉及下载的场景。

u011186532的专栏 1929

【LLM大模型】2025年最新:阿里内部流传的大模型面试真题,存下吧很难找齐的,非常详细收藏我这一篇就够了!

随着人工智能技术的迅猛发展,等领域的岗位越来越受欢迎,而_对于大型模型技术的掌握成为了这些岗位的标配_。但目前公开的大模型资源还是很少很少,面试真题就更不用多说了。为了让大家能够应对大模型面试,整理了这份大模型面试真题及答案,对新手如何入门算法岗位、备战面试以及面试常见考点的详尽指导。内容太多不一一列举。

2401_85390073的博客 1516

HotSpot G1 GC 的分区记账、SATB 并发标记与停顿目标调优解析

线上GC毛刺该调停顿目标、加大新生代还是换收集器?本文从HotSpot G1的设计出发,梳理分区与巨型对象、卡表与记忆集、写屏障与细化线程、停顿预测、SATB并发标记、自适应IHOP、混合回收规则及Full GC兜底,并注明JDK8至JDK27的版本差异。文中在JDK8与JDK17上实测:停顿目标从200ms降到20ms,伊甸区缩小四成、P99下降但仍超目标;巨型对象会反复触发又撤销并发标记;JDK17并行Full GC平均停顿约为JDK8的三成。最后给出日志解读、参数清单、调优流程与选型。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 170万+

AI大模型微调产品经理面试必备全攻略,非常详细收藏我这一篇就够了

这两天跟很多做程序员的朋友聊天,怎么看全网火爆的大模型。让我挺意外的是,大家的反馈普遍都很焦虑。在AI大模型微调领域的产品经理面试中,总会遇到一系列与技术细节、项目经验、市场趋势以及职业规划相关的问题。面试题1:请简述你对AI大模型微调的理解,并举例说明其在实际产品中的应用。回答AI大模型微调是一种在预先训练的模型基础上,针对特定任务或数据集进行的有监督训练策略。通过微调,可以显著提高模型在特定任务上的性能,并降低推理成本。在实际产品中,AI大模型微调的应用非常广泛。

2401_84494441的博客 1751

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

大模型入门教程:从零基础到精通,非常详细收藏我这一篇就够了

掌握大模型技术,可应对复杂的数据分析任务,提升研究与工作的解决能力。学习大模型具备处理复杂性、具有泛化能力与灵活性,对求职者有显著提升。本教程从基础概念出发,包括大模型的优势与应用、基础知识学习建议、入门基础教程,以及分布式训练、有监督微调与AGI学习包等内容。通过推荐的学习资源与实战项目资料,引导读者深入学习并实践大模型技术,开启AI大模型之旅。

m0_63171455的博客 3545

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

【AI大模型】从零到精通:完整学习路径,收藏一篇就够了!

作为零基础小白学习AI大模型,可以遵循以下步骤:基础知识学习:数学基础:学习线性代数、概率论、统计学、微积分等,这些是理解AI模型的数学原理的基础。编程基础:至少掌握一门编程语言,如Python,这是实现AI算法的工具。了解AI基本概念:学习机器学习、深度学习的基本概念,了解不同的模型和算法,如线性回归、决策树、神经网络等。选择合适的学习资源:利用在线课程和教程,比如Coursera、edX、Udacity等平台上的相关课程。

2401_85390073的博客 2279

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

【2025大厂AI大模型面试题】一文搞定面试准备!非常详细!收藏我这一篇就够了!

在2025年AI大模型的面试中,常问的问题以及答案可能会涵盖多个方面,包括AI大模型的基础知识、训练过程、应用、挑战和前沿趋势等。由于我无法直接附上174题的完整面试题库及其答案,我将基于提供的信息和当前AI大模型领域的热点,给出一些常见的问题和答案示例。前排提示,文末有大模型AGI-优快云独家资料包哦!

lvaolan的博客 1098

2024年最新大模型面试真题(非常详细)收藏这一篇就够了!

无论你是学生还是在职人员,无论是校招还是社招,刷完这些题目都将为你的求职面试和工作实践带来显著的帮助。从基础知识出发,系统地梳理了大型模型领域的核心技术及其应用,为读者提供了一个全面、深入的学习框架。它旨在帮助读者高效地掌握大型模型技术,节省学习时间,提高通过面试的概率。有了这份面试实战的指导,你将能够更好地理解大型模型技术的核心概念,掌握面试技巧,拿下理想的offer指日可待。

2401_85375298的博客 1488

2025大模型和AI算法岗面试八股【附答案】,非常详细收藏我这一篇就够了

去年的Ai迅速发展的一年,看到很多人的简历上都包含大模型和深度学习相关的工作,各家大厂和初创都很舍得给钱,动辄百万年包也变得不再稀奇。因此在人工智能纵横的这个时代,不仅Ai技术越来越卷,就连大模型和深度学习相关的岗位和面试也开始越来越卷了。我总结了100多道大模型常见的面试题(含答案)

Z4400840的博客 3612

2024最新版:大厂AI大模型面试题集锦及详解,非常详细收藏我这一篇就够了

随着AI市场,人工智能的爆火,在接下来的金九银十招聘高峰期,各大科技巨头和国有企业将会对AGI人才的争夺展开一场大战,为求职市场注入了新的活力。为了助力求职者在面试中展现最佳状态,深入理解行业巨头的选拔标准变得至关重要。尤其是对于AGI(Artificial General Intelligence,通用人工智能)领域的求职者而言,掌握一手的面试真题,不仅能让你洞悉面试官的考察重点,还能帮助你针对性地提升自己的技能和知识储备,让你在众多候选人中独树一帜。

2401_84204207的博客 1595

大模型的经典面试问题及答案,非常详细收藏我这一篇就够了

Transformer架构是Vaswani等人于2017年推出的一种深度学习模型,旨在以比递归神经网络(RNN)和长短期记忆(LSTM)等先前模型更高的效率和性能处理顺序数据。它依赖于自注意力机制(self-attention mechanisms)来并行处理输入数据,使其具有高度的可扩展性,并能够捕获长期依赖关系。在LLM中,Transformer架构构成了骨干,使模型能够高效地处理大量文本数据,并生成上下文相关和连贯的文本输出。

m0_65555479的博客 2211

【2025大厂AI大模型面试题】精编+答案解析,一文搞定面试准备!非常详细收藏我这一篇就够了!

随着AI市场,人工智能的爆火,在接下来的金九银十招聘高峰期,各大科技巨头和国有企业将会对AGI人才的争夺展开一场大战,为求职市场注入了新的活力。为了助力求职者在面试中展现最佳状态,深入理解行业巨头的选拔标准变得至关重要。尤其是对于AGI(ArtificialGeneralIntelligence,通用人工智能)领域的求职者而言,掌握一手的面试真题,不仅能让你洞悉面试官的考察重点,还能帮助你针对性地提升自己的技能和知识储备,让你在众多候选人中独树一帜。

2401_84495872的博客 2655

AI大模型入门超详细教程:基础知识点全覆盖,AI大模型学习路线,非常详细收藏我这一篇就够了!

AI大模型即通过大量文本数据和计算数据训练出来的人工智能模型,具有持续学习和适应的能力,与传统AI模型相比,AI大模型在准确率、泛化能力和应用场景方面具有显著优势。

2401_85375151的博客 1272

2024 AI大模型面试必备:常见问题与答案解析(含最新大厂面试题),非常详细收藏我这一篇就够了!

在2024年AI大模型的面试中,常问的问题以及答案可能会涵盖多个方面,包括AI大模型的基础知识、训练过程、应用、挑战和前沿趋势等。由于我无法直接附上174题的完整面试题库及其答案,我将基于提供的信息和当前AI大模型领域的热点,给出一些常见的问题和答案示例。

2401_85375151的博客 2395

【大模型面经】大模型面试经验总结:一篇文章足够,非常详细收藏这一篇就够!

大模型面试全攻略:从入门到Offer 随着大模型技术爆发,相关岗位需求激增,成为高薪热门选择。本文系统梳理大模型面试全流程: 1️⃣ 面试流程:简历筛选→HR初面→技术面→综合面→Offer,技术面为核心环节 2️⃣ 技术准备: 基础:深度学习/机器学习理论、数学基础、Python编程 重点:Transformer架构、自注意力机制、模型优化技巧 实战:项目经验梳理、LeetCode算法题(含大模型相关题型) 3️⃣ 行为面试:通过STAR法则展现沟通与协作能力,提前准备"Why us"等高频问题 4️

m0_65555479的博客 1228

AI大模型入门很简单,2024最值得收藏的大模型入门教程!

通俗地讲,AI就是让机器或计算机系统能够模仿、延伸和扩展人类的智能,执行一些通常需要人类智能才能完成的任务。

bagell的博客 1339
上一篇: 收藏学习!AI Agent如何彻底革新ITSM:从自动化到自愈系统的终极指南
下一篇: 【干货收藏】LangGraph检查点机制实现:让AI智能体记住一切
Agent学习路线
博客等级 码龄6年 1万+粉丝 1903原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值