保姆级教程 本地部署 deepseek + ollama + open-webui + cuda + cudnn

DeepSeek 本地部署详细教程 通过以上步骤即可完成本地部署。建议将本教程与官方文档结合使用,根据实际硬件环境调整量化参数。部署成功后可通过压力测试工具(如locust)进行性能评估。(此处可插入流程图示意图,文字描述如下) 阅读详情
AI摘要

本文是本地部署deepseek-r1的教程,基于ollama + webui,并开启cuda + cudnn 加速运算。内容包括安装cuda、cudnn,安装ollama,下载模型(对比了DeepSeek不同模型),还介绍了常见AI客户端,最后详细说明了open-webui的安装步骤。

前言
本地部署deepseek-r1,基于ollama + webui,并开启cuda + cudnn 加速运算,我电脑显卡是3060 12G,没显卡的可以跳过cuda + cudnn的安装。

一、安装cuda、cudnn

  • CUDA(Compute Unified Device Architecture)是 NVIDIA 的并行计算平台和编程模型,允许开发者利用 GPU 进行通用计算。
  • cuDNN(CUDA Deep Neural Network library)是基于 CUDA 的深度学习加速库,专为神经网络操作优化。
    总结,CUDA 提供 GPU 计算基础,cuDNN 在此基础上优化深度学习任务,两者共同提升深度学习应用的性能。
  1. 安装cuda
    查看当前显卡所支持的cuda版本,打开cmd,执行nvidia-smi
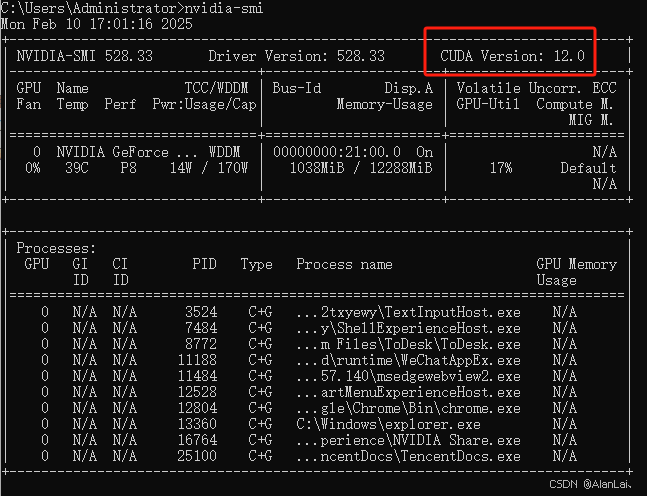
    在这里插入图片描述
    如图所示,我的cuda版本是12.0,然后去官网下载对应的cuda。地址:https://developer.nvidia.com/cuda-toolkit-archive,然后根据自己操作系统进行选择下载。
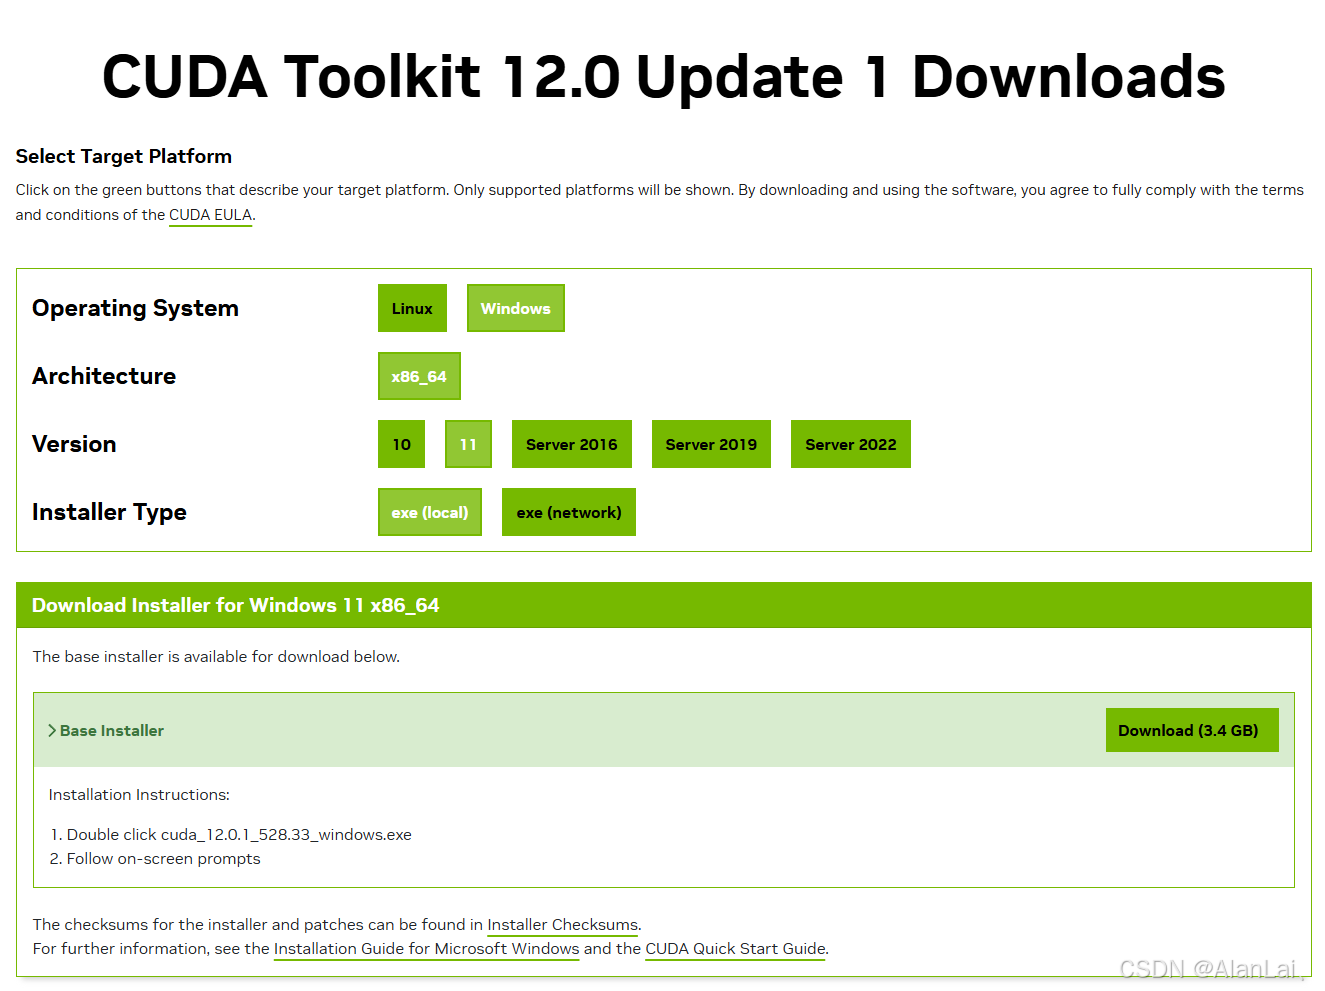
    在这里插入图片描述
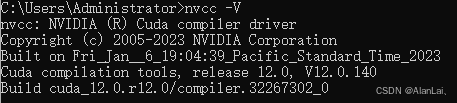
    下载好后直接安装,全部按默认的就行,更改路径容易导致安装失败,安装完成后,打开cmd,执行nvcc -V,可以查看cuda信息。
    在这里插入图片描述
  2. 安装cudnn
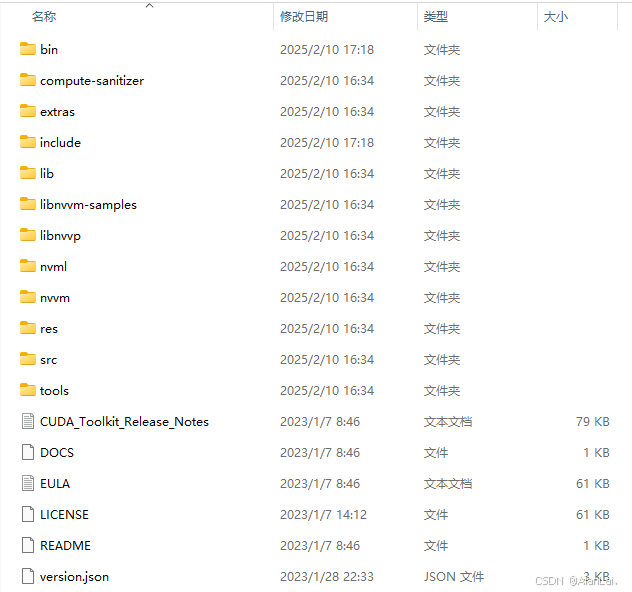
    根据自己cuda版本选择下载,地址:https://developer.nvidia.com/rdp/cudnn-archive,下载完成后,将里面的文件,全部拷贝至cuda根目录(C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.0)。
    cudnn目录结构
    在这里插入图片描述
    cuda目录结构
    在这里插入图片描述
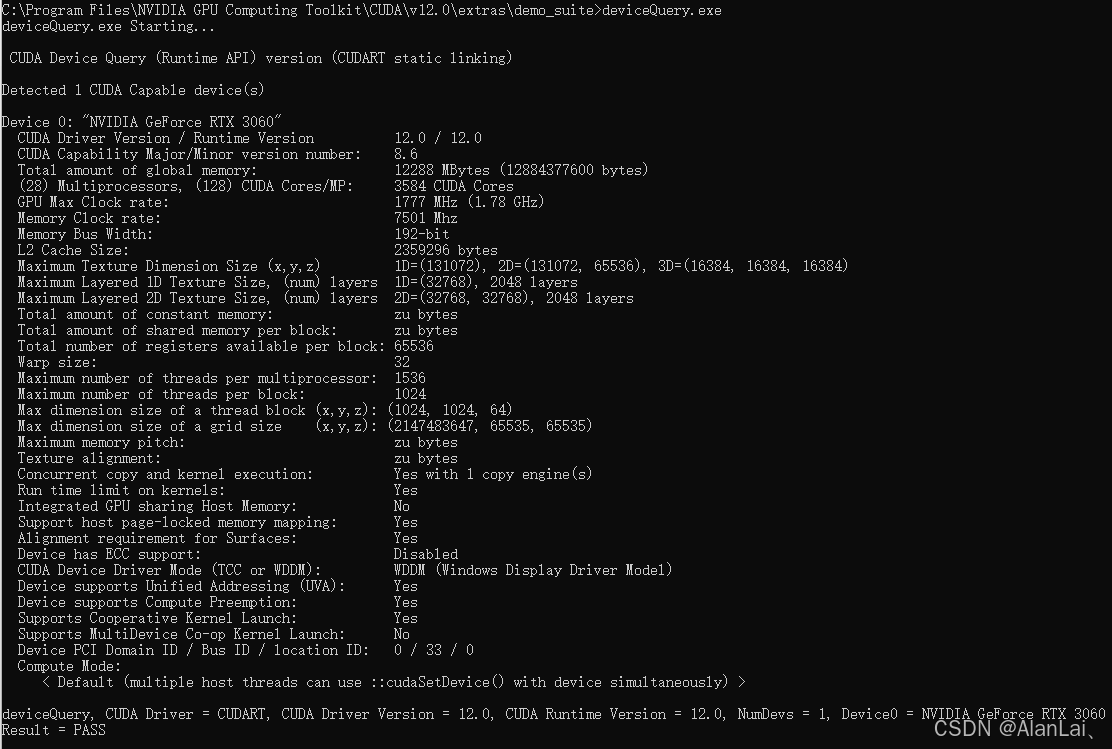
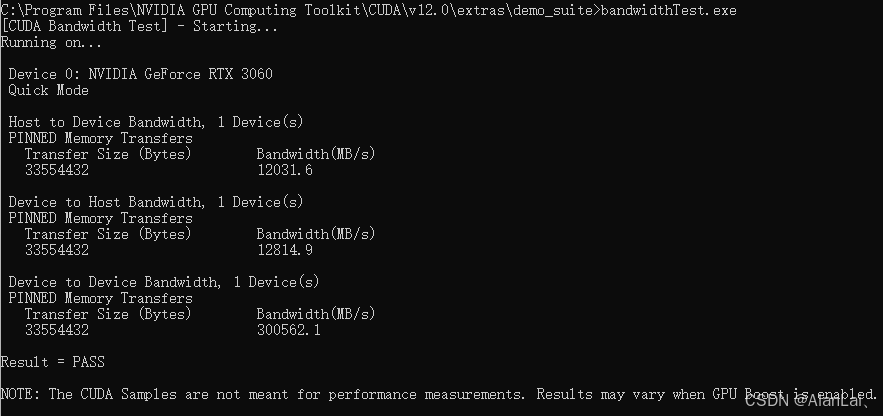
    打开cmd,执行C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.0\extras\demo_suite目录下的 bandwidthTest.exe 和 deviceQuery.exe,输出一下信息说明安装成功。
    在这里插入图片描述
    在这里插入图片描述

二、安装ollama

下载ollama,地址:https://ollama.com/,默认安装在C盘,如果想换目录,打开cmd,输入以下命令:

OllamaSetup.exe /DIR="D:\ollama"

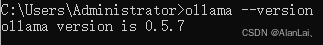
打开cmd,输入以下命令验证安装是否成功:

ollama --version
在这里插入图片描述
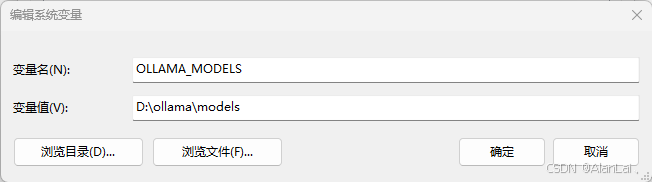
修改模型下载目录,配置系统环境变量OLLAMA_MODELS,并设置目录。
在这里插入图片描述

三、下载模型

deepseek各个模型之间的对比

  1. DeepSeek V3
  • 定位:通用型大语言模型,专注于自然语言处理(NLP)、知识问答和内容生成等任务。
  • 核心能力:高效的多模态处理能力(文本、图像、音频、视频),适用于大规模文档处理、搜索引擎优化和高并发查询任务。
  • 优势:低成本、高通用性,适合广泛的应用场景,如智能客服、内容创作、知识问答等。
  1. DeepSeek R1
  • 定位:专为复杂推理任务设计,强化在数学、代码生成和逻辑推理领域的性能。
  • 核心能力:通过强化学习(RL)和动态门控机制,优化推理能力,适用于科研、算法交易、代码生成等复杂任务。
  • 优势:在推理任务中表现卓越,支持模型蒸馏,可将推理能力迁移至更小的模型,适合本地化部署。
  1. DeepSeekLLM
  • 定位:专为大规模语言生成任务设计,适用于对话系统和生成任务。
  • 核心能力:强大的语言生成能力,支持对话生成、文本生成、情感分析等任务。
  • 优势:适应复杂对话场景,具备强大的上下文理解能力。

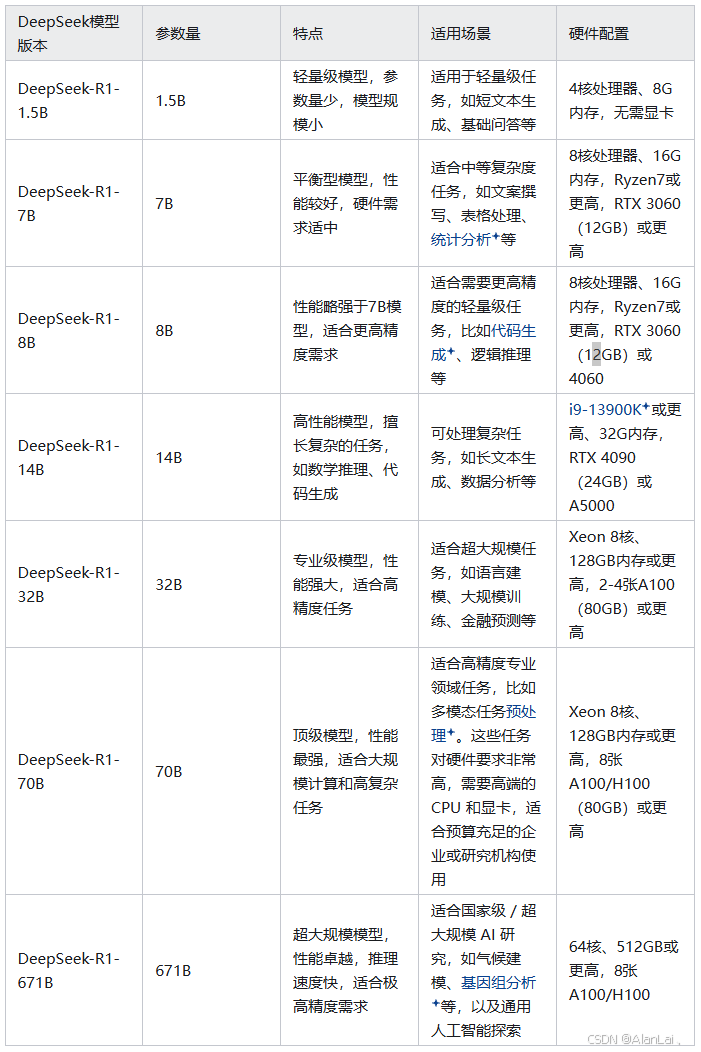
大家依据自己情况选择模型,这里我选DeepSeek R1,各个参数量的对比如下:
在这里插入图片描述
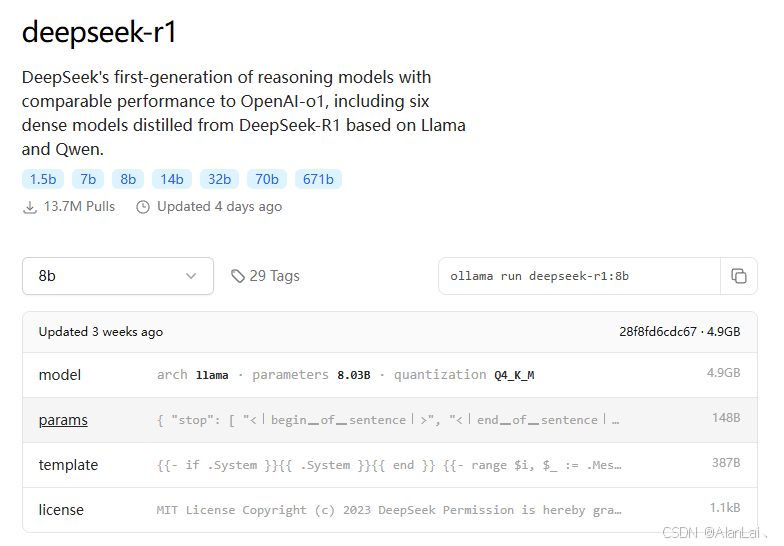
我的显卡只有12G,所以选择DeepSeek-R1-8B,在cmd中执行下载:

ollama run deepseek-r1:8b

模型地址:https://ollama.com/library/deepseek-r1:8b
在这里插入图片描述

四、安装客户端OpenWebUI

市面上常见的AI客户端有好多,常见的如下:

  1. CherryStudio,官网(https://cherry-ai.com/),支持市面上绝大多数服务商的集成,并且支持多服务商的模型统一调度。
    在这里插入图片描述

  2. chatbox,官网(https://chatboxai.app/zh),一款 AI 客户端应用和智能助手,支持众多先进的 AI 模型和 API,可在 Windows、MacOS、Android、iOS、Linux 和网页版上使用。
    在这里插入图片描述

  3. open-webui,官网(https://openwebui.com/),一个功能丰富且用户友好的自托管 Web 用户界面(WebUI),它被设计用于与大型语言模型(LLMs)进行交互,特别是那些由 Ollama 或与 OpenAI API 兼容的服务所支持的模型。Open WebUI 提供了完全离线运行的能力,这意味着用户可以在没有互联网连接的情况下与模型进行对话,这对于数据隐私和安全敏感的应用场景尤为重要。

大家可以根据自己情况去选择下载,下面讲解open-webui安装教程。
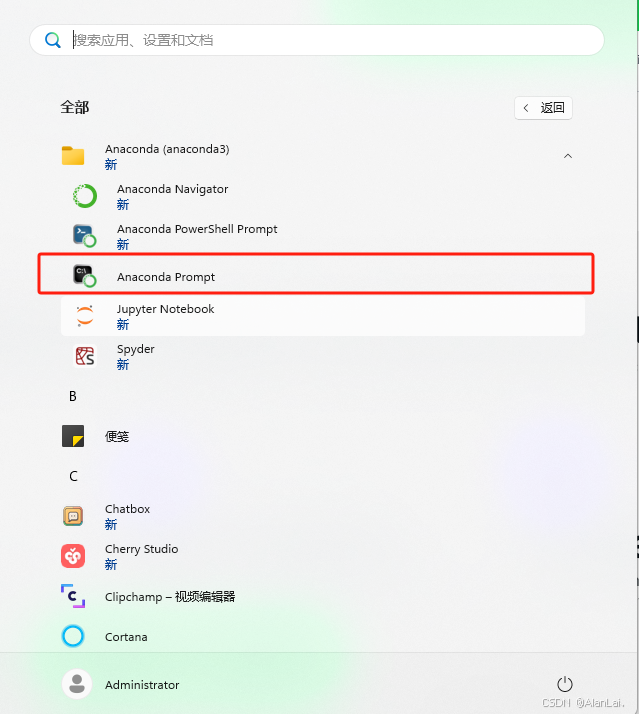
首先,下载Anaconda,python多环境管理工具,官网(https://www.anaconda.com/download),然后打开Anaconda控制台,如图所示:
在这里插入图片描述
执行命令创建一个python 3.11

conda create -n open-webui python=3.11

查看虚拟机环境列表

conda  env  list

使用open-webui虚拟环境

activate open-webui

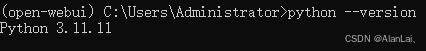
查看当前python版本

python --version
在这里插入图片描述
切换pip镜像源

pip config set global.index-url https://mirrors.aliyun.com/pypi/simple

安装open-webui

pip install open-webui

升级open-webui

pip install open-webui --upgrade

启动open-webui

open-webui serve

访问open-webui( http://localhost:8080/)
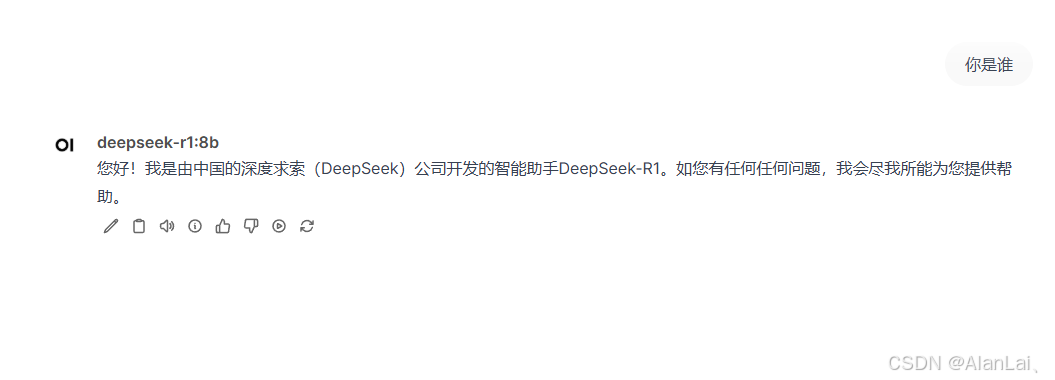
在这里插入图片描述

这里就基本完成了本地部署,在使用中可以观察显卡和cpu使用情况,就可以知道有没有走显卡运算。
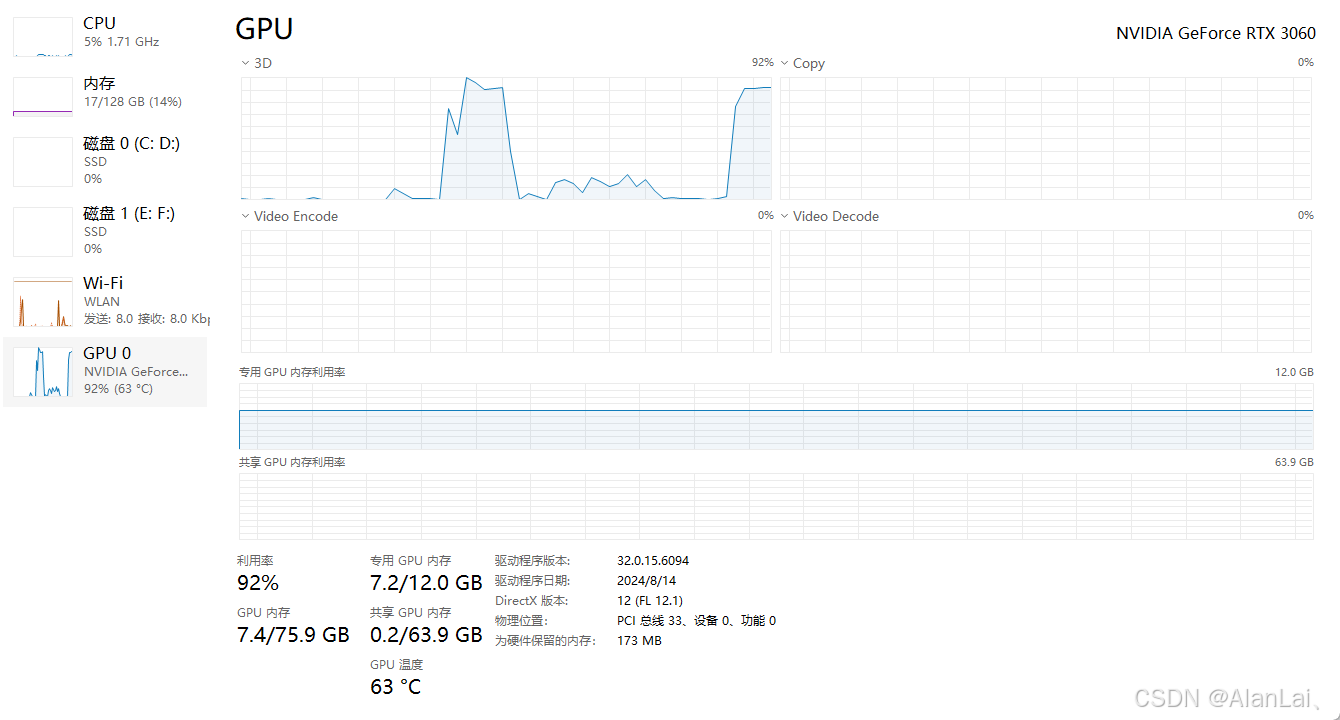
在这里插入图片描述

最全面部署指南:轻松在Ollama上安装与配置DeepSeek R1-32B! 最全面部署指南,轻松在Ollama上安装与配置DeepSeek R1-32B! 阅读详情

相关推荐

DeepSeek 本地部署全攻略:保姆级教程

因为你之前已经下载过,这次无需下载,可以直接和模型聊天。Open-WebUI 可以为 Ollama 提供一个更友好的图形界面,但安装过程较为复杂,适合有一定技术基础的用户 (只是让交互界面更好看,可以不必安装)在命令行输入,ollama rm + 模型名称,例如:ollama rm deepseek-r1:1.5b,就会自动删除对应模型。重新启动后,如果你的桌面上出现了docker的图标,就表示安装成功了。安装完成后,打开浏览器,访问 xxx://localhost:3000,注册一个账号并登录。

m0_51777213的博客 2921

笔记本电脑本地部署ollama大模型(显存不足调用CUDA Unified Memory方法)

ollama个人部署

m0_67228616的博客 4万+

[特殊字符] ‌2025最新版DeepSeek保姆级安装教程:本地部署+避坑指南[特殊字符]

本文旨在提供一个全面且详细的DeepSeek本地部署指南,帮助大家在自己的设备上成功运行DeepSeek模型。无论你是AI领域的初学者还是经验丰富的开发者,都能通过本文的指导,轻松完成DeepSeek的本地部署。

冰河的专栏 1409

ollama教程(window系统)

介绍在window操作系统下安装和使用ollama。

老王的博客 1万+

零基础本地部署AI大模型:从硬件检查到Ollama一键运行全指南

人工智能大模型已成为当前技术发展的核心驱动力,其背后依赖深度学习框架与GPU加速计算。理解大模型本地部署的原理,关键在于掌握模型量化、显存管理与计算图优化等技术,这些技术能显著降低资源消耗并提升推理效率。对于开发者、研究人员及隐私敏感型用户而言,本地部署的价值在于实现数据完全私有化、摆脱网络与API限制,并能进行深度定制与持续学习。在实际应用场景中,无论是个人知识库问答、代码辅助生成还是内部文档分析,本地化AI都能提供稳定、可控的服务。本文聚焦于通过Ollama这一现代化工具链,结合CUDA环境配置与模型拉

weixin_30614109的博客 329

Ollama本地大模型部署实战:零配置运行、镜像加速与生产集成

Ollama是一种面向终端用户的轻量级大模型运行时,它通过模型即服务(Model-as-a-Service)封装、零依赖二进制分发和CLI统一接口,将复杂的大模型本地推理抽象为`ollama run`等简单命令。其核心原理是基于llama.cpp与Metal/DirectML/CUDA后端的自动适配,屏蔽硬件差异与环境冲突,显著降低AI本地化门槛。技术价值在于释放开发者认知带宽,使焦点从‘如何跑通’回归‘如何用好’。典型应用场景包括RAG语义重排、离线代码生成、多模态图像理解及Agent智能体推理引擎。本文

weixin_34274029的博客 477

Windows下从零开始基于Ollama与Open-WebUI本地部署deepseek R1详细指南(包含软件包和模型网盘下载)

最近国产大模型DeepSeek很火,但有时因为访问人数过多导致反应慢甚至宕机。但好在DeepSeek是开源的,可以本地部署,这样就不用联网也能用了。但本地部署需要考虑硬件需求,比如是否有足够的GPU资源,存储空间,以及是否熟悉相关的技术步骤。本地部署的优势,比如离线使用、数据隐私、响应速度。是于本地部署,对硬件有一定的要求,特别是GPU,显然,GPU显存越大,就能部署参数更多的模型,通俗的讲,显存越大,模型越聪明。

知来者逆的博客 3644

Ollama本地大模型部署指南:从零搭建私有AI助手

大语言模型(LLM)通过模拟人类语言模式,基于Transformer架构实现文本生成与理解。其核心原理在于海量参数对语言规律的分布式表征,通过自注意力机制捕捉长距离依赖关系。这一技术突破的价值在于将通用语言能力封装为可调用的基础服务,为个性化、低延迟、高隐私的应用场景提供了可能。在模型部署实践中,本地化运行成为关键需求,以规避云端服务的网络延迟、API限制与数据安全风险。Ollama作为轻量级工具,通过封装模型管理与推理环境,实现了大模型的**一键部署**与**开箱即用**,显著降低了技术门槛。结合量化技术

weixin_34378969的博客 361

‌最新版DeepSeek保姆级安装教程:本地部署+避坑指南

本文旨在提供一个全面且详细的DeepSeek本地部署指南,帮助大家在自己的设备上成功运行DeepSeek模型。无论你是AI领域的初学者还是经验丰富的开发者,都能通过本文的指导,轻松完成DeepSeek的本地部署。

冰河的专栏 1万+

Ollama本地大模型部署指南:从核心原理到实战避坑

大语言模型(LLM)作为人工智能领域的核心技术,通过海量数据训练获得强大的语言理解和生成能力。其工作原理基于Transformer架构,通过自注意力机制处理序列数据,在文本生成、代码编写和对话系统等场景展现出巨大价值。随着开源模型的普及,本地部署成为关注焦点,它解决了数据隐私和定制化需求,但面临环境配置和资源管理的挑战。Ollama作为开源工具,通过封装模型格式和统一API,简化了本地部署流程,支持GPU加速和性能调优,让开发者能够快速集成到IDE和自动化脚本中,实现高效的本地AI应用部署。

weixin_30915951的博客 452

DeepSeek代码大模型架构解析与生产级部署实战指南

代码大模型是当前AI工程化落地的核心技术之一,其本质是将编程语言理解、执行逻辑建模与上下文感知能力深度融合的专用智能体。DeepSeek系列通过混合位置编码(RoPE+ALiBi)、跨模态语义对齐、量化感知训练等关键技术,在函数级代码理解、多文件依赖推理和低资源推理效率上实现突破。相比通用大模型,它更强调可验证性、可嵌入性和部署确定性,适用于IDE插件、CI/CD审查、低代码平台及企业知识库等场景。本文聚焦DeepSeek-Coder与V4-Pro两大主力模型,系统拆解其架构设计原理、vLLM高效部署方法、

564

DeepSeek-R1国产化系统gpu驱动+cuda+ollama+webui可视化离线私有化部署

网上大部分教程都是在线部署,完全离线私有化部署的文章不多,本文介绍从GPU驱动离线安装、cuda离线安装、ollama离线安装、deepseek离线部署、open webui离线安装几个方面,让小白0基础也可以私有化部署大模型deepseek-R1。我使用的设备是银河麒麟V10操作系统,海光CPU,内存128G,三张英伟达T4显卡(每张显存16G)。这里说一下国产化海光芯片c86架构就是源自于x86架构,与intel和amd等x86架构cpu使用并没有区别。

u014073556的博客 3622

AI Agent开发第77课-DeepSeek r1本地安装全指南

本文详细介绍了如何在本地安装deep seek r1。

打造全国最全的AI Agent开发知识领域的博客 1万+

Ollama本地AI部署指南:从零搭建大模型开发环境与API集成

大语言模型(LLM)作为当前人工智能领域的核心技术,通过海量数据训练获得强大的自然语言理解和生成能力。其工作原理基于Transformer架构,通过自注意力机制捕捉文本中的长距离依赖关系。这项技术的核心价值在于大幅降低了AI应用开发门槛,使开发者能够快速构建智能对话、内容生成等应用。在实际工程实践中,本地部署大模型常面临环境配置复杂、资源要求高等挑战。Ollama作为开源工具,通过容器化封装和GGUF量化技术,将模型、运行时和优化库打包为统一可执行单元,实现了极简的安装与模型管理流程。结合OpenAI兼容的

405

DeepSeek 本地化部署与 WebUI 配置的方法

注册登录后选择对应的 DeepSeek 模型即可开始对话。

关注博文底部公众号,发送标题关键字获取文档。 736

保姆级教程:用WorkVisual 6.0给你的KUKA机器人硬件做一次‘全身体检’与配置检查

本文详细介绍了如何使用WorkVisual 6.0对KUKA机器人进行全面的硬件诊断与配置检查。从环境准备到核心硬件模块检查,再到安全系统合规性验证,提供了保姆级教程,帮助技术团队快速掌握数字化诊断方案,提升工业机器人的健康管理效率。

weixin_27298377的博客 277

部署本地deepseek/Qwen模型并在局域网中多人交互

本文介绍了在局域网中离线部署DeepSeek模型的完整流程,旨在构建行业专用的AI业务专家系统。主要内容包括:1) 硬件配置要求(3070Ti显卡、32G内存等);2) 开源组件选择(Ollama并发管理、Open-WebUI前端等);3) 环境搭建指南(CUDA、PyTorch、Anaconda等);4) DeepSeek-7B模型的本地部署方法,提供4-bit量化实现代码;5) 模型训练数据准备建议(ShareGPT格式)。重点解决了在有限硬件条件下运行大模型的技术难点,并实现了多用户网页交互功能。

sinat_30065705的博客 382

链接文件及功能安全:英飞凌官方文档摘录 - 基于Tasking与AURIX TC3xx MCAL中Link文件解析以及代码变量定位方法详解

Data区域是用来存放带初始化值的全局变量,在link文件中,这个区域有两种类型,预先定义的区域和默认区域。预先定义的Data区域,例如.data.Ifx_Ssw_Tc1和.data.Cpu1_Main.*,在cpu1_main.c中如果定义了一个带初始化值的变量,则它会放在DSRAM1中的.data.Cpu1_Main.*段中。

梦想技术家 539

windows安装wsl+cuda+dify+ollama+wan等 记录

查看当前可用版本:wsl --list --online安装版本:wsl --install -d Ubuntu-22.04根据提示建立管理员账号,后输入logout命令:logout,提示请求操作成功。导出Ubuntu-22.04为tar文件:wsl --export Ubuntu-22.04 D:\WSL\Ubuntu-22.04\Ubuntu-22.04.tar注销原来系统:wsl --unregister Ubuntu-22.04。

qq_37959246的博客 736

C# 零基础入门知识点汇总

本文属于C#零基础入门之百识百例系列目录文章。此系列文章已经完结,欢迎大家点击文中文章链接查看详情进行学习。

陈言必行 -- Unity游戏开发领域优质博主 5350

PyTorch实战(21)——扩散模型(Diffusion Model)

扩散模型通过简单的噪声扩散过程,就能创造出高质量的超现实图像。在本节中,我们首先学习了扩散如何用于图像生成,了解了扩散模型的内部运作机制。随后基于动漫图像数据集,使用 PyTorch 和 Hugging Face 框架训练和运行自定义扩散模型,生成逼真动漫图像。

盼小辉丶的博客 3387
上一篇: 大白话理解AI,AIGC,AGI以及其它AI相关概念和AI火爆的原因
下一篇: ollama + deepseek + open-webui 并使用博查联网搜索能力
AlanLai、
博客等级 码龄11年 255粉丝 19原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值