【模型篇】370-M8运行 Qwen3

DeepSeek 和 Qwen 模型快速部署指南 详细介绍了如何使用VLLM部署和运行DeepSeek-R1-Distill-Llama-8B模型,并推荐与open-webui配合使用,以提高用户体验。Qwen 模型主要分为三种类型:Qwen-7B-Chat、Qwen-14B-Chat 和 Qwen2.5-32B-Instruct。Anything LLM是一个开源平台,旨在简化LLM的部署和使用,提供了一个统一的界面来管理和调用不同的LLM模型。是一种将模型参数压缩到 4-bit 的技术,可以大幅减少模型体积和显存占用,但可能会损失一定的精度。 阅读详情


前言

Qwen 系列大型语言模型的最新成员。我们的旗舰模型 Qwen3-235B-A22B 在代码、数学、通用能力等基准测试中,与 DeepSeek-R1、o1、o3-mini、Grok-3 和 Gemini-2.5-Pro 等顶级模型相比,表现出极具竞争力的结果。此外,小型 MoE 模型 Qwen3-30B-A3B 的激活参数数量是 QwQ-32B 的 10%,表现更胜一筹,甚至像 Qwen3-4B 这样的小模型也能匹敌 Qwen2.5-72B-Instruct 的性能。
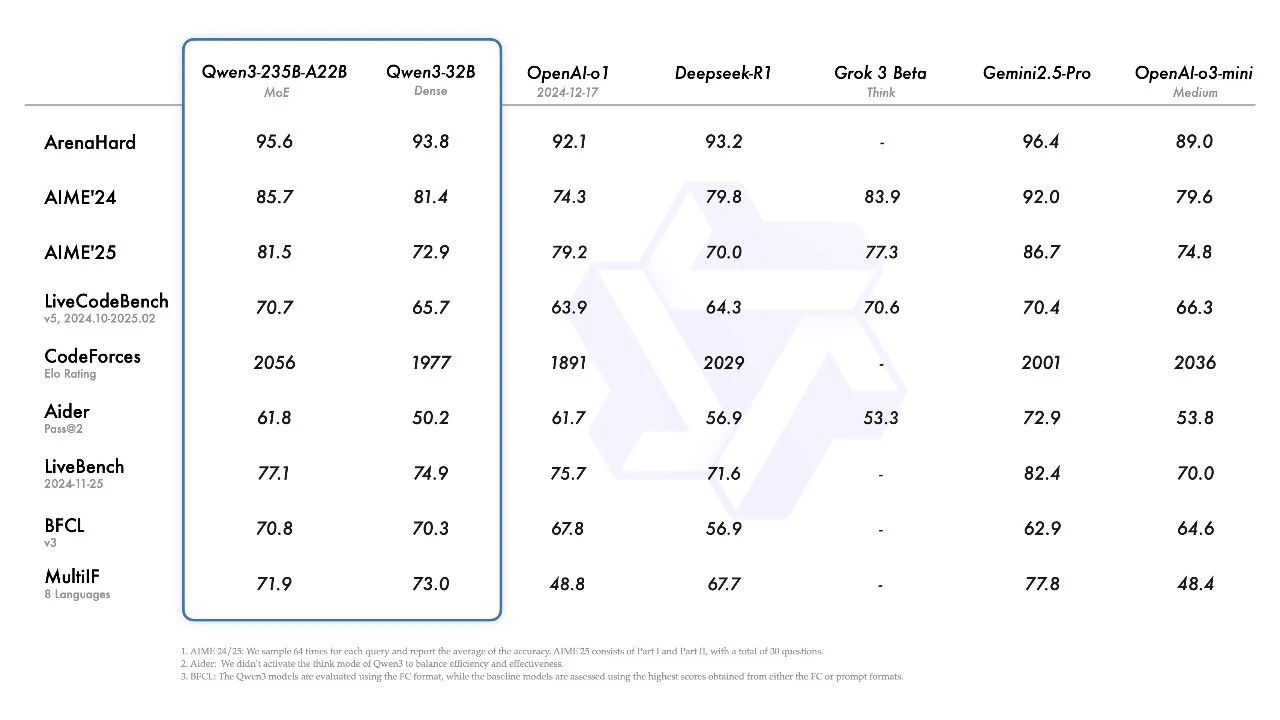
在这里插入图片描述
在这里插入图片描述


一、平台环境准备

镜像选择:pytorch:v24.12-torch2.5.0-torchmlu1.24.0-ubuntu22.04-py310
卡选择:任意一款MLU3系列及以上卡

二、模型下载

apt install git-lfs
git-lfs clone https://www.modelscope.cn/deepseek-ai/DeepSeek-R1-Distill-Qwen-14B.git

三、环境安装

pip install accelerate transformers==4.51.2

四、代码修改

from transformers import AutoModelForCausalLM, AutoTokenizer
import torch###+
import torch_mlu###+
import torch_mlu.utils.gpu_migration###+
model_name = "/workspace/volume/guojunceshi2/Qwen3-4B"

model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype=torch.float16,###+
    device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(model_name)

prompt = "给我写一份南京周边游攻略清单,玩2天"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=2048
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print(response)

五、效果展示

<think>
好的,用户让我写一份南京周边两天的游攻略清单。首先,我需要确定用户的需求是什么。他们可能是在南京附近,想要在两天内游玩,所以需要推荐一些距离南京不远但有特色的景点。接下来,我得考虑南京周边有哪些值得一游的地方。

首先想到的是南京的周边城市,比如溧水、江宁、浦口、六合这些区,可能还有句容、常州这些城市。不过两天时间,可能需要选择几个主要的景点,每个景点之间交通要方便,时间安排合理。

用户可能希望行程不要太赶,所以每个地方停留时间不宜过长。比如第一天可以安排溧水和江宁,第二天去句容或者浦口。或者可能考虑江宁的汤山温泉,或者溧水的白马寺,还有句容的华山或者宝华山。

另外,交通方面,南京到这些地方的交通方式,比如高铁、汽车或者自驾。用户可能没有说明是否自驾,但通常周边游可能以公共交通为主,所以需要推荐公交、地铁或者高铁的路线。

然后,每个景点的特色需要突出,比如溧水的白马寺是佛教文化,汤山温泉是温泉度假,江宁的秦淮河或者汤山温泉,句容的华山是徒步胜地,宝华山有佛教文化,浦口的江畔风景。

还要考虑景点的开放时间和门票价格,是否需要提前预约,比如有些景点可能需要提前购票。另外,饮食方面,南京周边的特色美食,比如溧水的汤包,句容的蟹粉汤包,或者江宁的美食。

用户可能希望行程安排合理,不要太累,所以每个景点之间的时间安排要合适,比如早上出发,下午回来,或者晚上回来。比如第一天上午溧水,下午江宁,第二天句容或者浦口。

另外,可能需要考虑季节因素,比如现在如果是秋天,可能适合去汤山温泉,或者句容的华山徒步。但用户没有说明季节,所以可能需要保持通用性。

可能还需要考虑交通时间,比如从南京到溧水大约1小时,江宁可能更近,半小时左右,句容可能需要1.5小时,浦口可能更近。所以第一天可能安排溧水和江宁,第二天句容或者浦口。

然后,每个景点的活动建议,比如白马寺参观,汤山温泉泡池,华山徒步,或者宝华山的寺庙。另外,可能需要推荐一些餐厅,或者小吃,比如溧水的汤包,或者江宁的美食。

最后,总结行程,确保两天的安排合理,每个地方都有特色,交通方便,时间安排紧凑但不过于紧张。可能需要分两天,每天两个景点,或者一个景点加一个周边活动。
</think>

以下是南京周边2日游攻略清单,结合自然风光、文化古迹和特色美食,兼顾行程紧凑与体验丰富:

---

### **Day 1:溧水 + 江宁**
**上午:溧水白马寺**
- **亮点**:江南第一古刹,佛教文化圣地,可参观大雄宝殿、藏经阁。
- **交通**:南京南站乘地铁至溧水站,或自驾约1小时。
- **建议**:提前预约门票(约80元),避开周末人潮。

**下午:江宁汤山温泉**
- **亮点**:南京温泉之都,可体验温泉池、水疗按摩,感受温泉疗愈。
- **交通**:南京南站乘地铁至汤山站,或自驾约40分钟。
- **建议**:选择含温泉+酒店套餐,享受私密性(约200-300元/人)。

**晚上:南京秦淮河夜游**
- **亮点**:夜游秦淮河,欣赏夫子庙夜景,品尝鸭血粉丝汤、盐水鸭。
- **交通**:地铁1号线至中华门站,步行约15分钟。

---

### **Day 2:句容 + 江北新区**
**上午:句容华山**
- **亮点**:江南第一峰,徒步登山(约2小时),登顶俯瞰句容全景。
- **交通**:南京南站乘高铁至句容站,或自驾约1.5小时。
- **建议**:携带登山杖,提前1小时到达,体验“华山论剑”传说。

**下午:江北新区滨江公园**
- **亮点**:南京新地标,江景步道、音乐喷泉、江畔咖啡馆。
- **交通**:南京北站乘地铁至江北新区站,或自驾。
- **建议**:傍晚时分欣赏江景日落,拍摄城市天际线。

---

### **美食推荐**
- **溧水**:溧水汤包(汤汁鲜美)、溧水香醋。
- **江宁**:汤山温泉酒店自助餐、江宁小排。
- **句容**:句容蟹粉汤包、华山豆腐干。
- **南京**:鸭血粉丝汤、盐水鸭、晓庄小笼包。

---

### **注意事项**
1. **交通**:建议提前购买高铁票,溧水、句容等地段可选择自驾或高铁。
2. **门票**:部分景点需提前预约,如白马寺、华山。
3. **天气**:根据季节携带合适衣物,秋季注意保暖。
4. **时间安排**:每天行程控制在6-8小时,避免过度疲劳。

---

**备选方案**:若时间紧张,可替换为浦口江畔(江心洲)或六合大别山风景区,体验不同风光。

国产AI芯片实战:寒武纪MLU370跑DeepSeek-R1蒸馏模型全流程 大模型推理部署正从云端走向本地,私有化部署成为数据敏感场景的核心诉求。国产AI芯片寒武纪MLU370凭借24GB大显存与75W低功耗,为15B级模型的本地化运行提供了高性价比硬件基础。通过llama.cpp的MLU后端与GGUF量化方案,可将DeepSeek-R1蒸馏模型压缩至10GB内,在推理卡上实现10~13 token/s的可用速度。本文从驱动安装、模型量化到双卡并发,系统梳理了在国产AI芯片上搭建大模型服务的完整链路,并对比了云GPU与N卡方案的成本账本,为评估国产化推理落地的开发者提供可复现的工程 阅读详情

相关推荐

AMD 395纯CPU跑通Qwen3.8-Flash-Next:端侧大模型本地部署全攻略

随着大模型技术的普及,越来越多的开发者开始关注端侧AI部署,希望在不依赖云端的情况下获得智能交互能力。本地部署并非NVIDIA显卡的专利,通过合理利用CPU内存带宽与量化模型,普通硬件也能流畅运行中等参数规模的模型。Ollama等推理框架的出现大幅降低了部署门槛,让个人设备成为轻量级AI应用的载体。本地部署的核心价值在于数据隐私、离线可用和长期成本优势,尤其适合企业知识库、个人助手、自动化脚本等场景。本文以AMD Ryzen AI 9 HX 370处理器为例,详细解析纯CPU环境下的内存带宽优化、模型选型与

weixin_27419879的博客 313

Qwen3快速部署 Qwen3-0.6B、Qwen3-8B、Qwen3-14B,Think Deeper

今天,通义千问Qwen团队正式开源推出 Qwen3,这是 Qwen 系列大型语言模型的最新成员。最新的Qwen3系列模型具备双模推理能力(深入思考/快速响应)、支持119种语言及方言,并强化了Agent功能与代码执行能力,全面满足复杂问题处理与全球化应用需求。安装transformers。

CSPhD-winston的博客 6751

开发了名为torch-npu的Ascend Extension for PyTorch插件

开发了名为torch_npu的Ascend Extension for PyTorch插件,使昇腾NPU可以适配PyTorch框架,为使用PyTorch框架的开发者提供昇腾AI处理器的超强算力。.zip

Qwen3系列大模型全版本下载指南:MoE架构与Dense模型全覆盖

Qwen3系列大模型作为阿里云通义千问团队的最新力作,现已开放全版本下载通道。用户可通过HuggingFace、Ollama及ModelScope三大平台获取包括MoE(混合专家)架构、Dense(稠密型)架构在内的全尺寸模型,以及GGUF、AWQ等多种量化版本,满足从科研实验到工业部署的多样化需求。 ## 多平台下载渠道解析 ### HuggingFace Hub官方仓库 作为最主流的模型分

gitblog_01157的博客 7758

Qt快速读取Excel文件

网上很多读取方式都是如下形式,太慢了,打开文件+读取文件要6s以上,实在是受不了! QAxObject excel("Excel.Application"); excel.setProperty("Visible", false); QAxObject *work_books = excel.querySubObject("WorkBooks"); work_boo...

c+c++的博客 2万+

深入解析ISO12233标准:SFR算法从理论到代码实现

本文深入解析ISO12233标准中的SFR算法,从理论到代码实现全面介绍如何量化成像系统的解析力。通过e-SFR算法测量边缘扩散函数(ESF)和空间频率响应(SFR),结合光学原理和实际代码示例,帮助开发者准确评估影像质量。文章包含关键步骤的Python实现和工程优化技巧,适用于相机测试、镜头评估等应用场景。

weixin_29200485的博客 156

简单的Qwen3的本地部署、分析与常见报错

Qwen3是阿里云开发的新一代大型语言模型系列,它是Qwen系列的一个重要迭代版本,继承了之前Qwen和Qwen2.5的经验和技术。Qwen3于2025年4月发布,并迅速因其卓越的性能、成本效益以及开源特性而受到关注。

2401_84870184的博客 5483

使用CubeMX生成的项目在Keil下添加DSP库并包含arm_math头文件后报错的解决办法

问题描述: 最近使用Cube生成工程后,在Keil中使用Manage Runtime Environment即绿色小饼干按钮添加CMSIS的DSP库后编译报错。很有意思的是,STM32论坛上有外国朋友报告的同样的错误,都是30个Errors,5个Warning。 问题分析: 参考国内论坛某帖子(具体想不起来了),认为因该是Cube复制了库后,Keil从原始Packs目录下引用DSP库导致和Cub...

qq_32256951的博客 7001

qwen.cpp和模型下载方式

139行assert中的!=应改为==,否则在debug模式下无法正常运行。将CMakeLists.txt的Release改成Debug。

qq_44576434的博客 2225

最全卷积总结篇(分组、深度可分离、空洞、转置等)

分组卷积(Group Convolution)是一种卷积操作方式,它最早在AlexNet中引入,并在深度学习中被广泛使用,尤其是在高效模型设计(如MobileNet和ResNeXt)中。分组卷积通过将输入特征通道分为若干组,并在每组内单独进行卷积操作,可以减少计算复杂度和参数量,同时有效利用模型的结构特性。分组卷积的工作原理通道分组:输入特征图的通道图为C_in,输出特征图的通道数为C_out,将每组的C_in和C_out分为G组,每组的通道数为C_in/G和C_out/G。组内卷积。

qq_44815135的博客 4219

FairyGUI深度解析:Unity复杂UI开发的高效解决方案与性能优化

在Unity游戏和应用开发中,UI系统的性能与开发效率是核心挑战。原生UGUI的组件化模型在应对复杂、动态界面时,常面临Draw Call过高、层级管理臃肿的问题。其原理在于,每个UI元素对应一个GameObject,渲染合批受限于Transform层级与材质状态,易导致性能瓶颈。FairyGUI(FGUI)作为一种专业的第三方UI解决方案,其技术价值在于采用了截然不同的“舞台-显示对象”渲染模型。该模型通过内部轻量级对象管理与自主合批系统,实现了极高的运行时效率与Draw Call优化。在应用场景上,FG

weixin_31315567的博客 342

RAG与MCP技术对比分析:深入探讨两者差异与优势!

通过增强生成结果的准确性和专业性通过协调 LLM 与外部工具/数据源的交互,支持复杂操作流程检索模块(如向量数据库)获取外部信息 → 生成模块(LLM)融合检索结果生成内容 [1] [9]定义标准协议规范 LLM 的输入输出上下文,实现多工具调用、动态数据路由和状态管理 [13] [21]依赖外部结构化/非结构化知识库(如文档、数据库)依赖预定义的工具集(API、函数)及上下文路由规则医疗问答(检索最新论文+患者病历生成诊断建议)[15] [34]

2401_84204207的博客 2205

【WRF-Chem工具】anthro_emiss 详解:生成人为排放数据

anthro_emiss 详解:生成人为排放数据

WW、forever的博客 2056

MLU370-M8轻轻松松跑通Qwen-7B-chat

通义千问-7B(Qwen-7B) 是阿里云研发的通义千问大模型系列的70亿参数规模的模型。Qwen-7B是基于Transformer的大语言模型, 在超大规模的预训练数据上进行训练得到。预训练数据类型多样,覆盖广泛,包括大量网络文本、专业书籍、代码等。同时,在Qwen-7B的基础上,我们使用对齐机制打造了基于大语言模型的AI助手Qwen-7B-Chat。Qwen-7B系列模型的特点包括:1 大规模高质量预训练数据:我们使用了超过2.2万亿token的自建大规模预训练数据集进行语言模型的预训练。

xiaojunjun200211的博客 1368

17、扩展景深成像的瞳孔函数工程技术解析

本文详细解析了扩展景深成像的关键技术,包括基于焦距堆栈的数字处理方法、立方相位掩模的光学设计、对数非球面透镜的应用以及旋转点扩散函数的深度编码功能。通过实验验证和实际应用分析,展示了这些技术在显微镜成像、工业检测和医疗影像中的广泛用途及优势。同时探讨了未来发展方向,如智能算法优化、新型光学材料和多模态成像技术,为相关领域的技术创新提供了参考。

y2z3a4b5c的博客 168

十九、帧间预测编码_2、解码、显示顺序与图像管理、参考帧管理

一、基本概念 1.1H.264的解码顺序和显示顺序: 解码过程中,每一帧的数据按照相应的NAL Unit在码流中的顺序传入解码器进行解码 由于B帧的存在,视频帧在输出时会进行顺序重排 1.2frame_num与POC frame_num:表示解码顺序 POC:表示显示顺序(picture_order_count) 在H.264的码流中,表示解码顺序和显示顺序分别有相应的语法元素表示。这两个值都会在码流中保存,并在读取slice信息时解析(SliceHeader中) 1.3参考帧列表 某一帧图像在解

叮咚的博客 1330

【模型篇】370-M8运行Qwen2.5-Omni-7B

OpenAI 发布 GPT-4V 与 Gemini 1.5-Pro,Google DeepMind 推出 Flamingo 和 Gemini 系列,多模态技术逐渐成为 AI 实用化的关键路径。但多模态大模型往往意味着参数暴增、推理开销剧增、无法实时响应等现实问题。如何构建“轻量化、全模态、强泛化、可部署”的 AI 系统。在这样的背景下,阿里通义团队开源发布的 Qwen2.5-Omni-7B,无疑是一次重量级突破。

xiaojunjun200211的博客 1066

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

MLU370-M8跑大大大规模模型!!!Qwen-72b-chat

MLU370-M8跑通大大规模模型

xiaojunjun200211的博客 2755

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

MLU370-M8运行Qwen2-vl手册

Qwen2-VL-Chat 是由阿里巴巴开发的多模态大语言模型,它是 Qwen2-VL 系列的一部分,专门设计用于处理图像和文本的联合输入与输出。这个模型能够在视觉与语言任务中表现出色,比如图像描述、视觉问答、图像中的文字识别等。它的多模态能力使其能够理解并生成与图片和文本相关的复杂回答,甚至支持多轮对话和多图像比较​(Qwen2-VL-Chat 的特点包括:多图像输入:支持同时处理多张图片,并能够根据用户的提示进行比对和回答。

xiaojunjun200211的博客 1021

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【训练篇】MLU370-M8 完成 qwen1.5-7b-chat-lora训练及推理

本期我们采用魔塔的swift来完成qwen1.5-7b-chat的训练,除一些环境安装需要转换,其他的与N卡训练操作一致。

xiaojunjun200211的博客 1453

biliTickerBuy B站会员购票工具:安装、配置与首抢完整指南

biliTickerBuy 是一款用 Python 编写的开源 B 站会员购抢票辅助工具,提供浏览器 Web 界面,把登录、配置生成、定时抢票串成一条流程。这篇安装指南带你把环境装好、关键配置看懂,并跑通第一次抢票任务。 ## 🎯 它解决什么问题 在 B 站会员购下单,流程本来就长:登录、填购票人、选票档场次,还得在开售瞬间点中按钮,手慢一步就没了。biliTickerBuy 把这些步骤搬进

gitblog_00957的博客 685

Qwen3Guard-Gen-8B能否运行在国产化硬件平台上?正在适配中

Qwen3Guard-Gen-8B作为新一代生成式内容安全模型,正稳步推进在国产硬件平台的部署。依托寒武纪、壁仞等国产加速卡和鲲鹏、飞腾CPU,结合UOS、麒麟系统,已在部分信创环境中实现技术验证。模型将审核转化为生成任务,具备高可解释性与上下文推理能力,未来有望在政务、金融等领域构建自主可控的安全防线。

weixin_36212459的博客 1002

AMD AI9 HX370 小主机跑 Qwen3.6-27B:8.5 t/s 的“养慢虾“哲学

本文介绍了一种基于1升体积小主机的本地AI部署方案,搭载AMDAI9HX370处理器和Radeon890M集成显卡,通过优化配置在96GB内存中流畅运行27B参数的稠密大模型Qwen3.6-27B-MTP(Q4量化)。关键创新在于:1)利用推测解码技术(76.7%接受率)将生成速度提升至8.5t/s;2)采用KV缓存量化等内存优化手段;3)实现65W超低功耗与静音运行。作者通过实际日志分析证明,该方案虽速度不及高端显卡,但凭借稳定的75t/s上下文处理能力和智能的推测解码机制,完全满足日常对话、代码生成等场

laot007的博客 1041

开源模型迎来颠覆性突破:DeepSeek-V3与Qwen2.5如何重塑AI格局?

DeepSeek-V3和Qwen 2.5系列的发布,无疑是开源模型发展史上的重要里程碑。它们以其卓越的性能、高效的训练方法和开放透明的技术细节,为开源社区注入了新的活力,也为AI技术的未来发展指明了方向。

m0_66917422的博客 5223

LM Studio本地部署Qwen3

LM Studio 是一款桌面应用程序,用于在您的计算机本地开发和实验 LLM。

weixin_40513993的博客 103

AMD 395核显部署Qwen3.8-Flash-Next:Ollama实测

本地大模型部署逐渐成为AI应用落地的重要方向,而实际推理速度不仅取决于算力峰值,内存带宽与软件栈适配往往更具决定性。通过GGUF量化(如Q4_K_M)压缩模型体积,并借助Ollama调用核显的Vulkan后端,可以在纯离线环境中获得流畅的生成体验。无论是文档总结、代码补全还是私有知识库问答,端侧推理在数据安全与响应延迟上都有不可替代的价值。本文基于AMD Ryzen AI 9 HX 370(俗称395)平台的Radeon 890M核显,完整实测Qwen3.8-Flash-Next模型的部署过程,涵盖驱动配置

weixin_29041195的博客 167
上一篇: 【应用篇】MLU实现comfyui加速推理 or comfyui-api调用
下一篇: MLU实现 comfyui+wan2.1 完成图生视频创作
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

