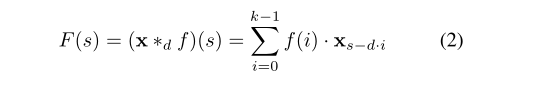论文阅读(通用CNN和RNN建模的经验评估)

【论文阅读】An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling 1.摘要 一般而言,序列模型与循环网络(recurrent networks)关系紧密(由于RNN的循环自回归结构能较好地表达出时间序列)。而传统的卷积网络(convolutional networks)由于卷积核大小的限制,对于长时间的依赖信息不能较好地抓取。 但是,研究发现,一些特殊的卷积神经网络模型在音频合成、机器翻译等任务上效果比递归神经网络更好。那么,对于一个新的任务,怎么选取网络结构呢? 本文使用大量数据集对模型进行评估,发现简单的卷积结构在数据集的表现优于典型的循环网络(如LSTMs), 阅读详情

论文

          An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling

摘要

最近的一些研究表明卷积神经网络在像语音合成以及机器翻译的任务上超过了循环神经网络。给定一个新的序列建模任务或者数据集,应该选用哪种架构,简单的卷积体系结构在各种任务和数据集上的表现优于常规递归网络(如LSTM),同时表现出更长的有效内存。我们得出结论,应该重新考虑序列建模与递归网络之间的常见关联,并且应将卷积网络视为序列建模任务的自然起点。

引言

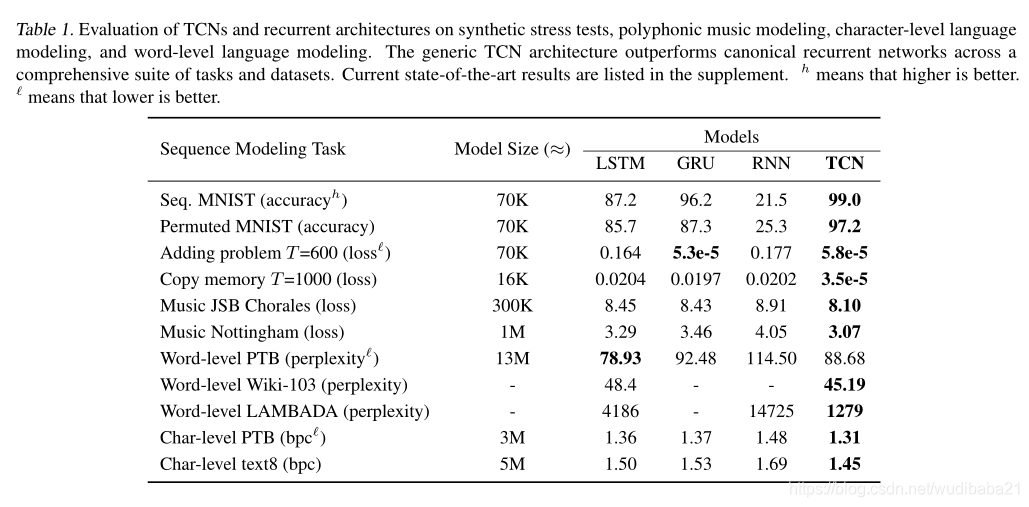
最近的研究表明,某些卷积架构可以在音频合成,词级语言建模和机器翻译方面达到最先进的准确性。这就提出了一个问题,即卷积序列建模的这些成功是否仅限于特定的应用领域,还是必须对序列处理和循环网络之间的关联进行更广泛的重新考虑。为了表示卷积网络,我们描述了适用于所有任务的通用时间卷积网络(TCN)体系结构。该架构是根据最近的研究得出的,但是故意结合了现代卷积架构的一些最佳实践,使其保持简单。将其与规范的递归体系结构(例如LSTM和GRU)进行了比较。结果表明,在广泛的序列建模任务中,TCN令人信服地胜过基线循环架构。

TCN体系结构不仅比标准的递归网络(如LSTM和GRU)更准确,而且更简单明了。

TCN

我们将提出的体系结构称为时间卷积网络(TCN),强调我们采用此术语不是作为真正新体系结构的标签,而是作为一系列体系结构的简单描述性术语。

TCN的显着特征是:1)体系结构中的卷积是因果关系的,这意味着从将来到过去都没有信息“泄漏”;

2)架构可以采用任意长度的序列并将其映射到相同长度的输出序列

通过如何结合非常深的网络(使用残差层增强),以及扩张卷积(dilated convolutions)来构建非常长的有效历史信息记录。

序列模型 Sequence Modeling

给出一段输入序列x0 ... xT,预测一些相关输出y0...yT。

因果卷积

TCN基于两个原则:网络产生的输出长度与输入长度相同,以及从将来到过去不会泄漏的事实。TCN使用一维全卷积网络(FCN)[1]其中每个隐藏层的长度与输入层的长度相同,并且填充长度为0(内核大小--1)被添加以使后续层的长度与先前的层相同。为了达到第二点,TCN使用因果卷积,即在卷积中时间t的输出仅与时间t或更早的上一层中的元素卷积。

TCN = 1D FCN +causal convolutions

此基本设计的主要缺点在于,为了获得较长的有效历史记录大小,我们需要一个非常深的网络或非常大的过滤器,这两种方法在首次引入时都不是特别可行。因此,在以下各节中,我们描述如何将现代卷积体系结构中的技术集成到TCN中,以允许非常深的网络和非常长的有效历史。

Dilated Convolution
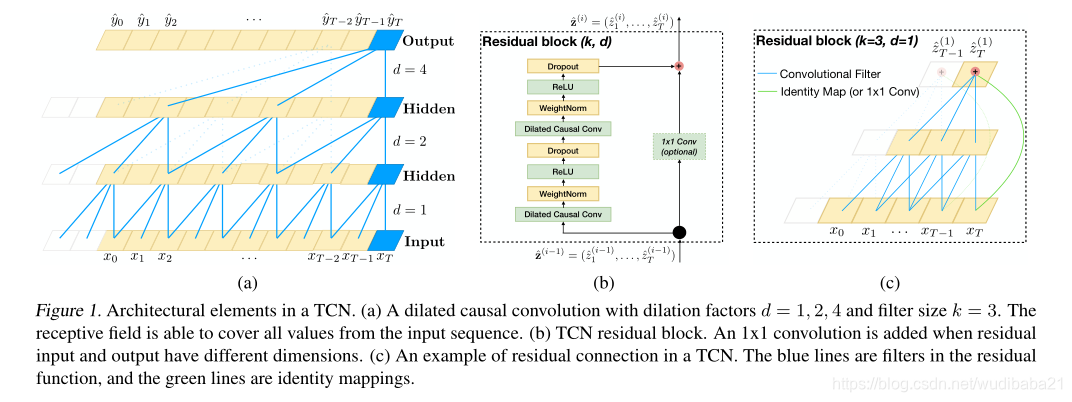
 

其中d是扩张因子,k是滤波器大小,s-d·i表示过去的方向。因此,膨胀等效于在每两个相邻的滤波器抽头之间引入一个固定的阶跃。当d = 1时,膨胀卷积减小为规则卷积。使用较大的膨胀可使顶层的输出代表更大范围的输入,从而有效地扩展了ConvNet的接收范围。 

优势

可变长度输入。就像RNN以循环方式对可变长度的输入进行建模一样,TCN也可以通过滑动一维卷积内核来接受任意长度的输入。这意味着,对于任意长度的顺序数据,可以将TCN用作RNN的直接替代。

更低的内存需要(模型更小)

更稳定的梯度

灵活的接受域大小

更好的并行化

缺点

评估期间的数据存储:在评估/测试中,RNN仅需保持隐藏状态并采用当前输入xt即可生成预测。换句话说,通过固定长度的向量ht提供整个历史的“摘要”,并且可以丢弃实际观察到的序列。相反,TCN需要采用原始序列,直到有效的历史记录长度为止,因此在评估期间可能需要更多的存储空间。

迁移学习时超参数更改:不同领域对模型进行预测所需的历史记录数量可能有不同的要求。因此,当将模型从仅需要很少内存(即,较小的k和d)的域转移至需要更长内存(即,较大的k和d)的域时,TCN可能会因为没有足够大的接收场。

实验
 

参考文献

  1. Long, Jonathan, Shelhamer, Evan, and Darrell, Trevor. Fully convolutional networks for semantic segmentation. In CVPR,2015.


[论文总结]An Empirical Evaluation of Generic Convolution and Recurrent Networks For Sequence Modeling 1. 提出的 Causal Dilated Conv + Residual Block 比基本的 LSTM、GRU 和 Vanilla RNN 的性能要好得多。 2.确认TCN比RNN家族表现出更长的记忆保留,确认RNN的“无限记忆”几乎没有实验结果。 阅读详情

相关推荐

An Empirical Evaluation of Generic Convolutional and Recurrent Networksfor Sequence Modeling

对于大多数 深度学习研究者而言,序列建模任务等价于RNN。但是最近的研究表明,在音频合成以及机器翻译等任务上,CNN的表现胜过RNN。对于新的序列建模任务,RNN还是CNN,该如何选择?作者通过对用于RNN性能的标准任务来评估CNN的性能。结果证实,简单的CNN结构在不同的任务以及数据集上的性能优于LSTM这类典型的RNN模型。作者认为,应该重新考虑序列任务与RNN、CNN之间的联系,甚至是将CNN作为序列建模任务的起点。(作者在文中将其记做TCN)

qq_59482564的博客 1637

【深度学习论文阅读】TCN:An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence

2018年人工智能十佳论文之一:TCN 论文地址:An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling 项目地址:TCN的github链接 ABSTRACT 对于大多数 深度学习研究者而言,序列建模任务等价于RNN。但是最近的研究表明,在音频合成以及机器翻译等任务...

Ray 1万+

阅读论文——A cnn-rnn framework for crop yield prediction

论文阅读

DJDLJRCJ的博客 1220

An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling

An Empirical Evaluation of Generic Convolutional and Recurrent Networksfor Sequence ModelingOriginal time: 2018-05-1616:09:15 Updated on2019-09-2710:26:42 Paper:https://arxiv.org/pd...

a1424262219的博客 1499

An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling--论文阅读

An Empirical Evaluation of Generic Convolutional and Recurrent Networks for Sequence Modeling–论文阅读笔记 论文地址:https://arxiv.org/pdf/1803.01271.pdf TCN详解:TCN详解 尽管循环神经网络具有长期记忆的能力,但是CNN架构(文中的TCN)表现出更加长期的记忆能力. 1.1. Temporal Convolutional Networks 首先描述卷积序列预测的一般架构。

熊熊小姐的博客 1918

深度学习模型选型指南:CNN、RNN、Transformer、GAN核心原理与应用场景

深度学习作为人工智能的核心技术,通过神经网络模拟人脑学习机制,在计算机视觉、自然语言处理等领域展现出强大能力。其核心原理在于通过多层次非线性变换从数据中自动提取特征,实现端到端的智能决策。从技术价值看,深度学习突破了传统机器学习对特征工程的依赖,大幅提升了模型的表达能力和泛化性能。在实际应用场景中,针对不同问题类型需要选择合适的模型架构:卷积神经网络(CNN)擅长处理图像等网格数据,利用局部连接和权重共享高效提取空间特征;循环神经网络(RNN)及其变体LSTM专攻序列建模,通过门控机制解决长距离依赖问题;T

weixin_34326558的博客 335

论文阅读 | Polygon-RNN:Annotating Object Instances with a Polygon-RNN

论文地址:https://arxiv.org/abs/1704.05548 项目地址:http://www.cs.toronto.edu/polyrnn 概述 Polygon-RNN是一篇收录于CVPR2017的论文,文中作者基于CNN+RNN提出了一种半自动目标实例标注的算法。当前大多方法都将目标分割视为像素级分类问题,而本文则将其看做多边形预测任务,以裁剪的目标图像作为输入,预...

diaokuangjin0620的博客 570

关于深度学习方向学习的一些建议

以下是关于深度学习方向学习的一些建议:nn.Moduletf.kerastf.kerasautogradautograd。

QQ_778132974的博客 1447

Deepfake Video Detection Using Recurrent Neural Networks论文阅读笔记

Deepfake Video Detection Using Recurrent Neural Networks论文阅读 David Güera Edward J. Delp Video and Image Processing Laboratory (VIPER), Purdue University Introduction ses a convolu-tional neural network (CNN) to extract frame-level features 使用CNN卷积神经网络提取帧级

qq_45631882的博客 1642

避坑指南:Win10安装Docker Desktop时Hyper-V报错的7种解决方案(2024最新版)

本文提供了2024年最新、最全面的Windows 10系统下Docker Desktop安装时Hyper-V报错的解决方案指南。文章深入剖析了Hyper-V与Docker的共生关系,并系统性地给出了从BIOS/UEFI设置、Windows功能启用、bcdedit命令修复到处理多虚拟化环境共存等7种核心解决方案,帮助开发者彻底解决安装困局,顺利部署容器化开发环境。

weixin_28840143的博客 530

在安装之后使用labelme出现qtpy.PythonQtError:No Qt bindings could be found错误

我在base环境(python3.7)可成功安装和使用labelme,而在同py37版本和py36的虚拟环境中可安装labelme包,但在使用的时候出现报错,如下: 我尝试着去解决第一个错误提示,错误提示为:moduleNotFoundError:No module named ‘PySide’,结果掉入了一个无止无尽的坑,看到网上有朋友说这个只能在py27-py35才能安装,还有说需要VC+ 140等,他们说的这个解决方案只针对于这个缺包的描述,而我们仅仅只需要一个labelme,因此我直接对后面的错误

qq_33538651的博客 9816

【论文阅读】D18-1274——GEC模型优化的一种方法:使用质量评估模型

GEC的效果依然很差,所以有些人开始思考避免盲目调参地如何提升模型效果。 一个很直观的方法是观察模型输出与真人标注的区别,因此引出Quality Estimation(质量评估)。 本文同样来自https://nlpprogress.com/english/grammatical_error_correction.html当前第五名的报告。 Neural Quality Estima...

梦想破三的奔三狗 1万+

spdk + fio测试nvme 设备的性能

fio的测试对象可以是块设备、文件等,在spdk的使用过程中会unbind默认的nvme driver,所以在系统中是看不到nvme块设备的,在spdk中可以通过fio_plugin的方式,将spdk的用户态driver部分的io功能打包成一个ioengine提供给fio使用,可以综合spdk的高性能和fio提供的复杂场景。更多DPDK相关学习资料有需要的可以自行报名学习,免费订阅,永久学习,或点击这里加。这个jobfile是spdk中提供的例子。领取,关注我持续更新哦!2.7 jobfile的例子。

lingshengxiyou的博客 1089

ResNet 和 Transformer 的论文阅读笔记

本文对比分析了计算机视觉和自然语言处理领域的两大里程碑模型:ResNet和Transformer。ResNet通过残差连接解决了深层网络退化问题,使训练超深度网络成为可能,在ImageNet等任务上取得突破性成果。Transformer则完全基于自注意力机制,摒弃了RNN/CNN结构,实现了高度并行化处理,为NLP任务带来革命性进步。两种架构虽针对不同领域,但都通过创新设计解决了各自领域的关键瓶颈:ResNet处理深度网络的优化难题,Transformer克服序列处理的并行限制。它们共同推动了深度学习模型的

2501_94232062的博客 407

Windows 10/11一键搞定HDF5文件查看:HDFView 3.4.1免配置安装指南(附中文路径避坑技巧)

本文详细介绍了HDFView 3.4.1在Windows 10/11上的免配置安装方法及中文路径优化技巧。作为HDF5文件查看的专业工具,HDFView 3.4.1简化了安装流程,提升了科研数据处理效率,特别适合遥感、气象等领域的研究人员使用。

qsc9012345的博客 1146

AI算力瓶颈与系统优化实战指南

AI算力瓶颈已成为制约人工智能发展的关键因素,特别是在处理transformer类模型时,传统的冯·诺依曼架构面临严重的'内存墙'问题。通过硬件加速、系统优化和算法改进的三级策略,可以有效提升资源利用率。在嵌入式AI领域,结合量化、剪枝和专用指令集扩展等技术,能在资源受限设备上实现高效推理。这些优化方法在自动驾驶、工业视觉等场景中已展现出显著价值,推动AI应用从云端向边缘迁移。随着AI算力需求的持续增长,掌握系统优化技能将成为开发者的核心竞争力。

weixin_32597009的博客 342

《Recent Progresses in Deep Learning Based Acoustic Models》论文阅读总结

发表于IEEE/CAA JOURNAL OF AUTOMATICA SINICA, VOL. 4, NO. 3, JULY 2017 摘要部分: 这篇论文总结了基于深度学习的声学模型的最新进展以及技术见解,讨论了RNN和CNN等模型,以及它们与其它模型的各种组合。 然后,描述了CTC模型和基于attention技术的seq2seq模型。 讨论了语音识别系统中的鲁棒性问题,以及声学模型自适应,语...

wgc7998的博客 405

QCPColorMap实现瀑布图

QCPColorMap实现真正的瀑布图

pf1873252141的博客 5272

股票价格预测 - Attention-based CNN-LSTM and XGBoost hybrid model for stock prediction 论文阅读

自留使用,如有错误欢迎交流。

2301_79601111的博客 893

无迹卡尔曼滤波 (UKF, Unscented Kalman Filter) 算法详解及案例分析

无迹卡尔曼滤波是一种用于估计非线性系统状态的递归算法。其目标是通过结合系统模型和观测数据,估计系统的最优状态。

闲人编程的博客 2629

第15章 AI 产品原型设计 —— 让 AI 成为你的产品经理

理解产品需求- 将模糊的想法转化为具体的原型方案生成高质量原型- 输出符合设计规范的 HTML 原型提供设计建议- 基于 UX 最佳实践给出优化建议维护原型文档- 自动更新原型说明和变更记录。

快乐的修补匠的专栏 506

【引用转载】TCN论文白话解读

引用转载白少杰博士(Jerry Bai. Carnegie Mellon University)等2018年论文“在序列建模问题上对通用卷积网络和循环网络的经验评估” 论文原地址: 如有侵权请留言联系,秒删 论文摘要,介绍,最后结论部分: 白少杰博士等人问题灵感启发来源:现有的卷积神经网络在机器翻译,音频合成序列处理任务上较循环网络有着出色的表现。 那么问题推广到其他序列处理任务场景或者其他数据集上呢? 通过实验,该论文的作者们发现采用自己提出的时间卷积网络(TCN)使用控制变量法,基于同一性能评判指标下,

kukudeProgramer的博客 1226

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

ResNet 和 Transformer 的原始论文阅读——Attention Is All You Need笔记

《Transformer:基于注意力机制的序列建模新范式》 摘要: 本文解析了2017年提出的Transformer模型,该模型彻底摒弃了传统RNN/CNN架构,完全基于注意力机制构建。核心创新包括:1)采用多头自注意力机制实现任意位置间的直接关联,以恒定计算复杂度(O(1))解决长距离依赖问题;2)通过位置编码注入序列顺序信息;3)模块化设计(编码器-解码器结构、残差连接、层归一化)实现高效并行计算。实验表明,Transformer在WMT2014英德/英法翻译任务中分别提升2+BLEU和41.8BLEU

2501_94232062的博客 537

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

NLP论文阅读记录 - 01 | 2021 神经抽象摘要方法及摘要事实一致性综述

自动摘要是通过计算缩短一组文本数据的过程,以创建代表原始文本中最重要信息的子集(摘要)。现有的摘要方法大致可以分为两种:抽取式和抽象式。提取摘要器显式地从源文档中选择文本片段(单词、短语、句子等),而抽象摘要器则生成新颖的文本片段以传达源文档中最常见的最显着的概念。本次综述的目的是对最先进的抽象概括方法进行彻底的调查,并讨论这些方法面临的一些挑战。我们专注于抽象摘要任务,因为它在计算上比提取方法更具挑战性,并且更接近人类编写摘要的方式。本次调查分为两个部分。

yuyuyu_xxx的博客 1395

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

【论文阅读13】- Attention Is All You Need

这篇论文介绍了 **Transformer** 模型,它是第一个完全基于 **自注意力机制(self-attention)** 的序列转换模型,旨在替代传统的 **循环神经网络(RNN)** 或 **卷积神经网络(CNN)** 用于序列到序列的任务,如机器翻译。

wangshangshang09的博客 2518

论文阅读笔记——Systematic Analysis of Deep Learning Model for Vulnerable Code Detection

这篇文章不难,主要就是总结了当下的一些相关技术以及相关数据集,也算是之前学习的一个总结。下面就是本篇论文的全部阅读笔记!

IronmanJay 623
上一篇: 语音论文阅读(基于Transformer的在线CTC/Attention 端到端语音识别架构)
下一篇: NLP论文阅读(通过义元信息增强的Transformer)
尚歌
博客等级 码龄9年 8284粉丝 60原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值