PDF转markdown,AI知识库绝配,科研文献整理必备,MinerU将PDF转化为机器可读格式的工具

六个开源的PDF转Markdown项目 无论是文档、表格、图像、视频、音频文件,还是网页,OmniParse 都能对其进行处理,使其变得干净、结构化,并为诸如 RAG(Retrieval-Augmented Generation)和细调等AI应用做好准备。它主要用于高效地解析 PDF 文档中的排版、数学公式、表格、图片、图表等内容,并将这些内容转换为结构化的 Markdown 格式。gptpdf 是一个利用VLLM解析PDF为Markdown的工具,几乎完美支持数学公式、表格等。将每个图像传给 GPT,让其生成 Markdown 格式的文本。 阅读详情
AI摘要

MinerU是开源免费的PDF解析神器,可将PDF转为Markdown和JSON格式。其处理PDF有分类预处理、内容提取、处理管线、结果质检四个环节。介绍了在线使用问题及本地部署方法,包括Conda安装、MinerU安装、模型文件安装、测试等,还提及表格识别功能开启。

视频版:

PDF转markdown,AI知识库绝配,科研文献整理必备,MinerU将PDF转化为机器可读格式的工具

这是一个开源免费的PDF解析神器,MinerU。它可以把PDF转换成可以编辑的Markdown格式,其中的图片、表格、数学公式等都可以精确提取。它还可以转化提取扫描类的PDF文档。MinerU可以把PDF图片等转换成AI大模型容易理解的数据,所以它跟AI知识库(RAG)是绝配。我们先来简单看一下MinerU的技术原理,还有如何免费在官网使用。最后来演示下如何在自己的电脑上部署这个工具。

项目地址: GitHub - opendatalab/MinerU: A high-quality tool for convert PDF to Markdown and JSON.一站式开源高质量数据提取工具,将PDF转换成Markdown和JSON格式。

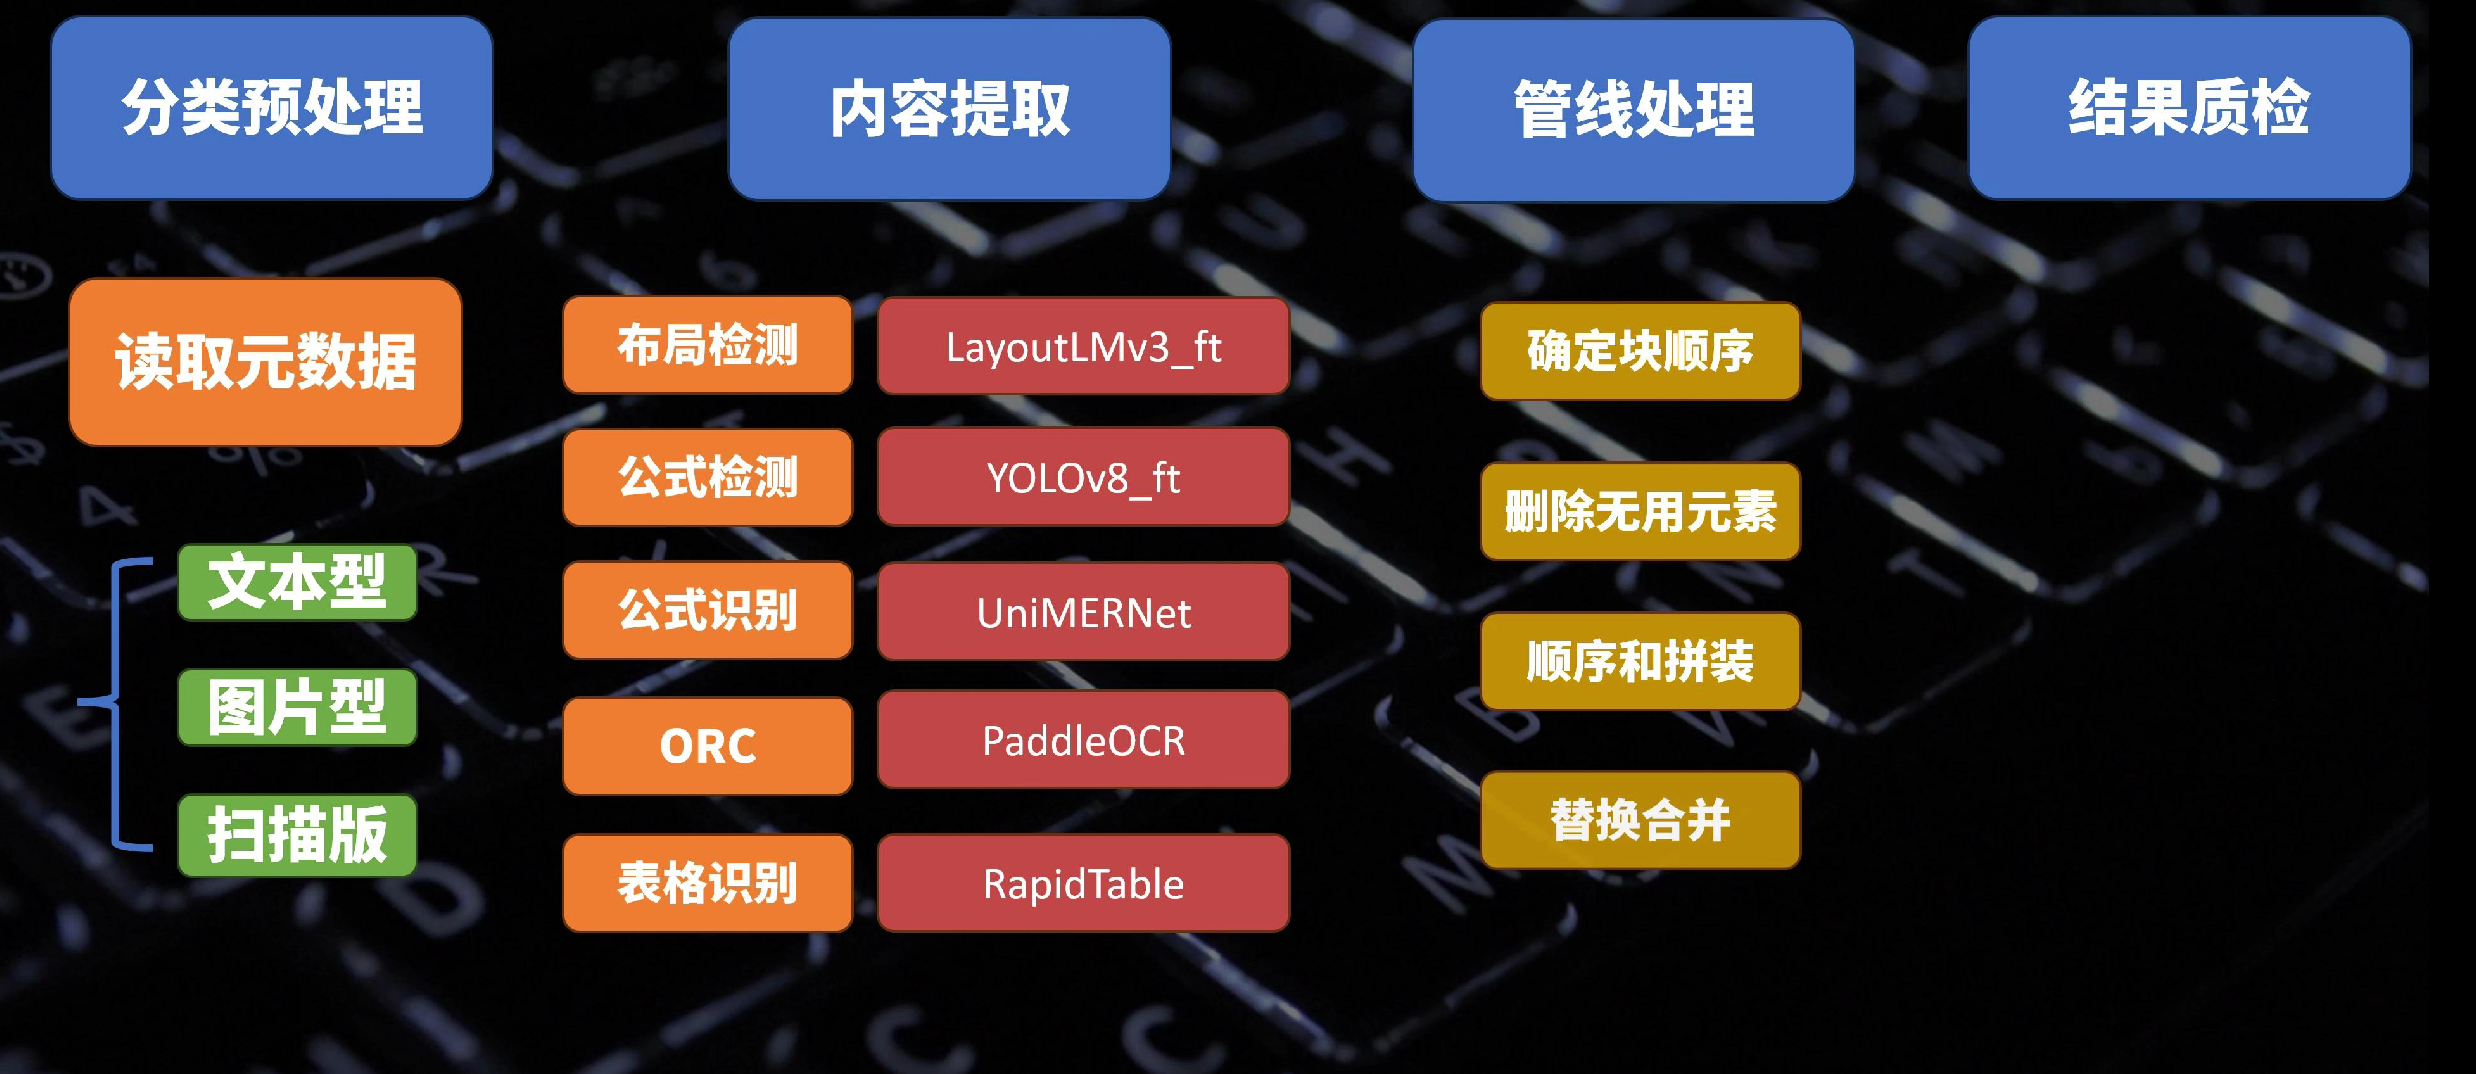
MinerU处理PDF主要有以下四个环节:

分类预处理:主要读取PDF的元数据信息,从而区分PDF类型。
内容提取:则可以看作是许多个AI大模型组成的流水线。
  • 布局检测:主要任务是定位文档中不同元素的位置。这里使用的模型主要是微调过的LayoutLMv3模型。
  • 公式检测:用来定位文档中的公式位置。这里使用的是基于YOLOv8的自研模型。
  • 公式识别,主要任务是识别公式图像,并且把它转换成了Latex的源码。这里使用的是项目自研的公式识别模型。
  • OCR,也就是对于扫描版的PDF,提取图像中的文本内容。这里使用的是百度飞桨OCR。
  • 表格识别,这里使用的开源项目是RapidTable
处理管线: 将模型解析得到的数据输入到处理管线中,然后进行处理。
结果质检:可以使用可视化的质检工具与人工的标注进行对比
如何快速使用MinerU

MinerU

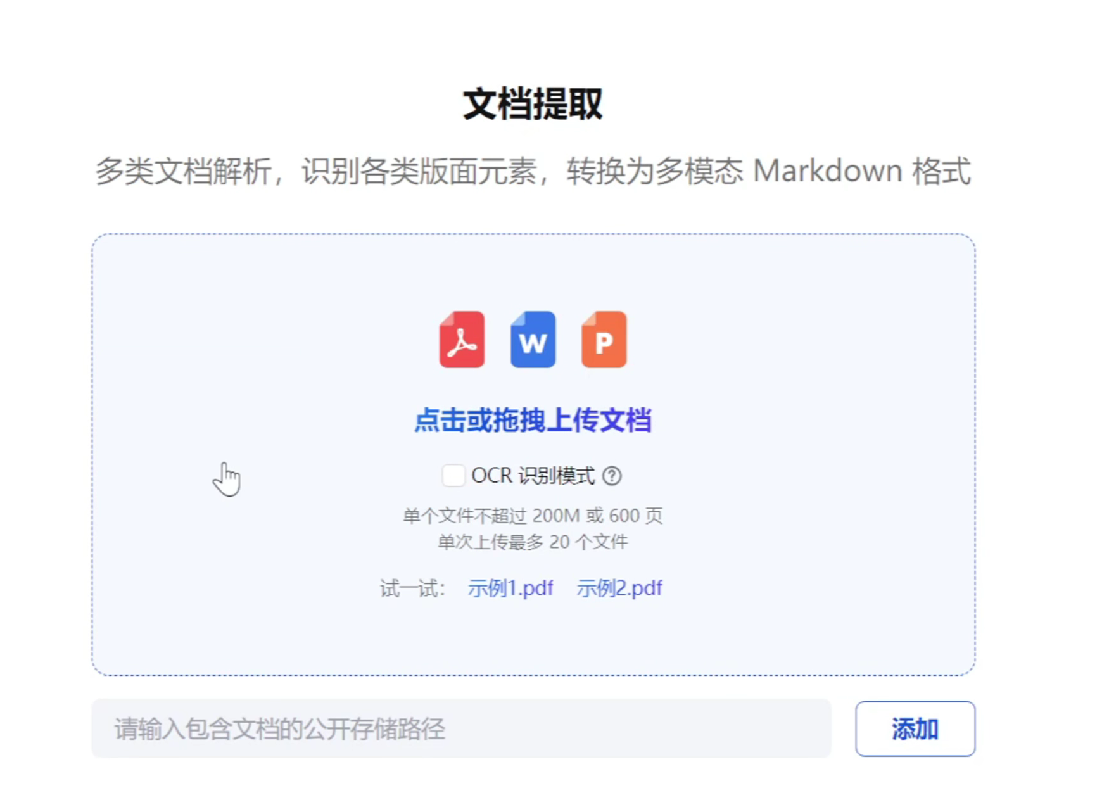
这里可以上传一个PDF文件,或者是Word还有PPT文件。如果PDF文件是扫描版的,我们需要把这个OCR识别勾上,然后上传一个文件。
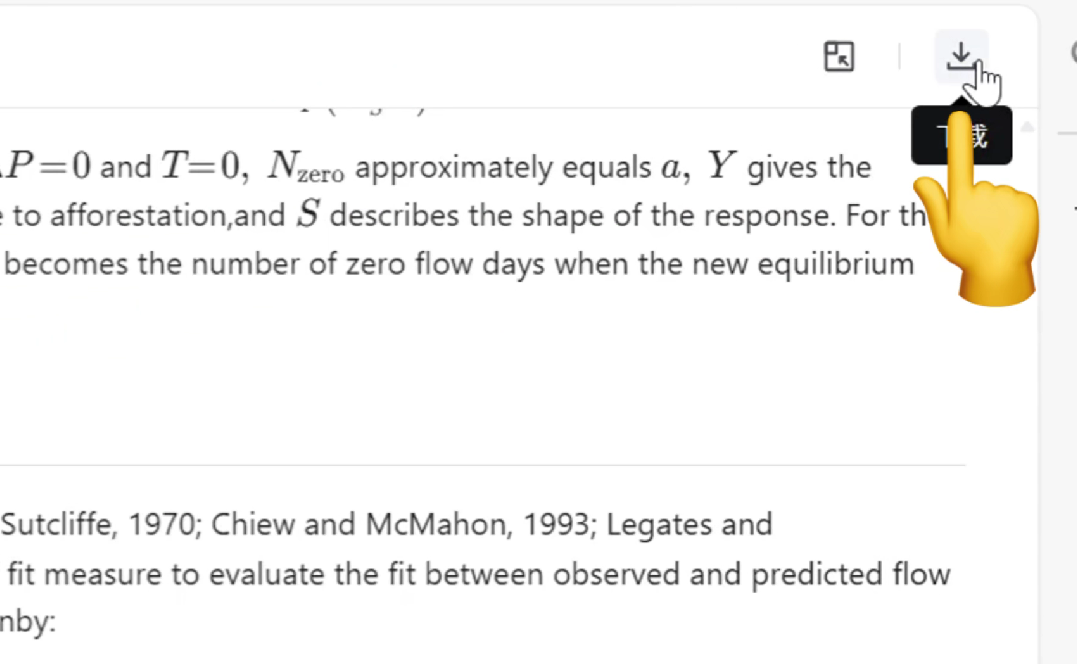
我们可以点击右上角的下载,把对应的Markdown文件下载下来。
我们使用在线工具转换有几个问题。首先是Markdown里面的图片,它是一个网络图片,并没有真正的下载下来。第二个问题是表格,并没有真正识别出来,而是把它变成了一张图片。第三个问题是使用网页版,这里有一定的限制,最多200兆或者600页。如果想解决这些问题的话,我们可以本地部署。

本地部署

视频的后半段,我会详细介绍如何本地部署这么一个项目。这里我想补充一下,如果是简单的PDF操作的话,我们可以使用这个在线工具PDF24,大部分工作都可以在线直接完成。不过他的ORC肯定要差一些,毕竟MinerU是专业的。

Conda安装

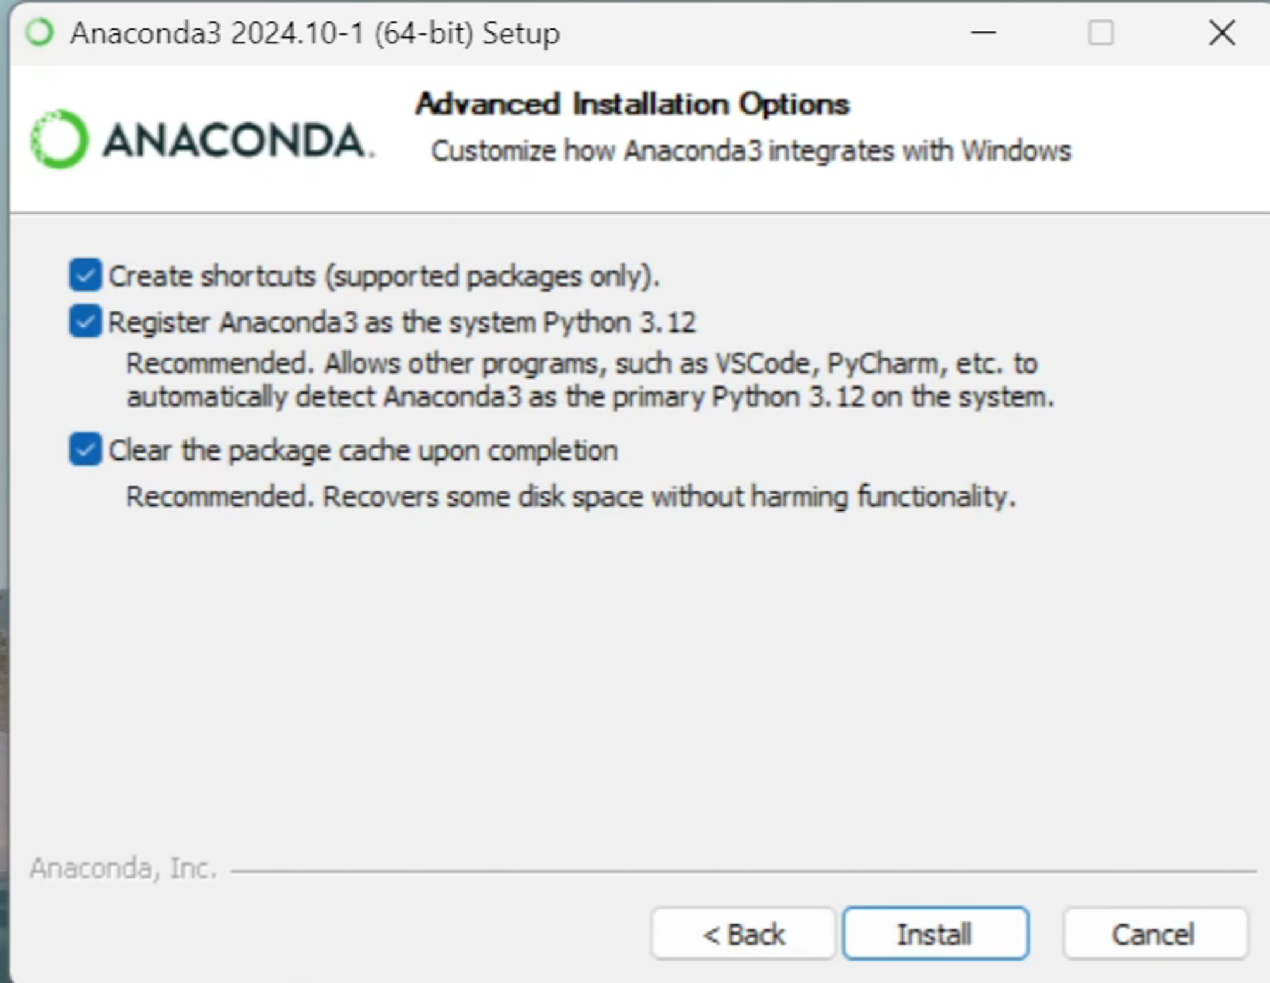
这是一个Python项目,它的部署前提是电脑上需要先安装一个Conda,然后使用Conda创建Python的虚拟环境。我们进入这个地址repo.anaconda.com,这里有一个installer,我们点击一下,找到自己操作系统的最新版本,把它下载下来。我是Windows系统,我下载这个X86_64的。下载完成以后,我们把它安装一下,这里一直点击下一步,到这一步,把这三个勾都选上,然后点击安装。
安装MinerU

在搜索栏搜索 Anaconda Prompt 打开, conda的命令行
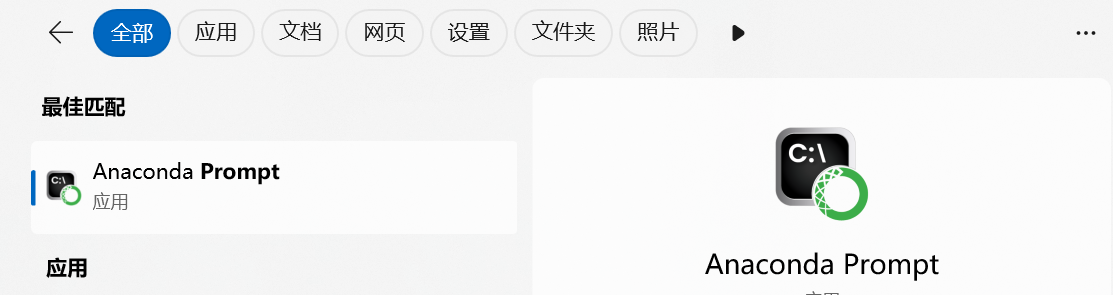
这里我们先执行,先创建一个Python 3.10的名字叫MinerU的Conda的虚拟环境。然后切换到这个虚拟环境,安装Python依赖。

conda create -n MinerU python=3.10
conda activate MinerU
pip install -U magic-pdf[full] --extra-index-url https://wheels.myhloli.com -i https://mirrors.aliyun.com/pypi/simple

安装模型文件

pip install modelscope
curl -o download_models.py https://gitee.com/myhloli/MinerU/raw/master/scripts/download_models.py
python download_models.py

我大约花了十几分钟,总共下载了两个模型,加起来有2.5个GB左右。模型放到了这个目录下面。

C:\Users\xxxxx\.cache\modelscope\hub\xxxxxxxxxxx

如果我们不想使用这模型了,直接把它删掉就可以了。

测试MinerU

好,我们来测试一下。我把测试文件放到了桌面上,然后我把目录切换到桌面。我们使用这个命令magic-pdf -p 参数输入PDF的路径,这里我复制文件地址粘贴过来。接下来是-o指定一个输出文件夹,这里我叫做output。最后是-m指定一个方法,这里我使用auto就是自动。

magic-pdf -p "C:\\Users\xxxx\Desktop\demo.pdf" -o output -m auto

然后我们回车,大约用了5分钟,处理完成了一个13页的PDF文档。如果开启了GPU加速的话,速度会快很多。处理完成以后,我的桌面就多了一个output文件夹。本地部署的话,它会把图片都放到一个相邻的目录里面。

表格识别

我们可以通过修改配置,开启它的表格识别功能,把表格也变成Markdown格式的表格。

这里我们进入这个地址C:\\Users\xxxx\magic-pdf.json 。进来以后,主要修改这个table-config这一行,把这里的enable改成true。
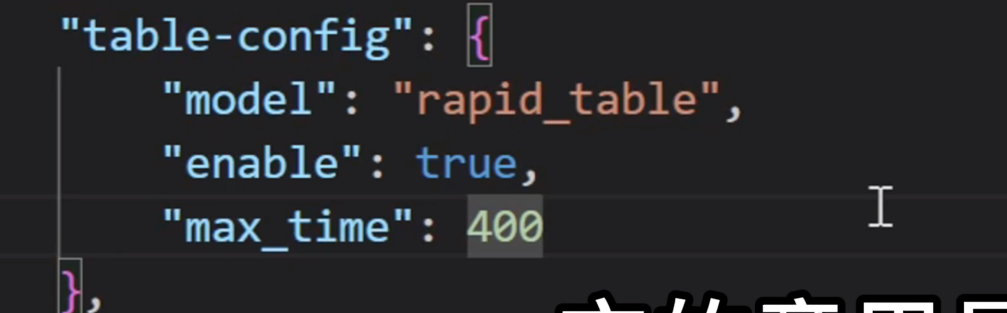
它的意思是开启表格的识别,把表格也转成Markdown格式的。开启完表格转换以后,重新跑一次。表格就转换成了markdown格式。

基于Python给出的PDF文档转Markdown文档的方法 注:网上有很多将Markdown文档转为PDF文档的方法,但是却很少有将PDF文档转为Markdown文档的方法。就算有,比如某些网站声称可以将PDF文档转为Markdown文档,尝试过,不太符合自己的要求,而且无法保证文档没有泄露风险。于是本人为了解决这个问题,借助(能使用GPT镜像或者有条件直接使用GPT的,反正能调用GPT接口就行)生成Python代码来完成这个功能。,若有错误,欢迎指出。本次笔记记录于24.1.21。(中途运行时,发现代码中存在bug从而对代码进行了更新,比如。 阅读详情

相关推荐

PDF转Markdown:6种常用开源工具深度对比-实战案例

本文对比了6款主流开源PDF转Markdown工具,重点介绍了Marker和MinerU两款代表性工具。Marker是一款轻量级高性能解决方案,基于PyMuPDF和Tesseract OCR技术,处理速度快4倍,适合科研文献等基础格式转换。MinerU则是企业级高精度解析器,集成LayoutLMv3和YOLOv8深度学习模型,支持84种语言OCR,适用于学术文献管理和财务报表解析等高精度场景。文章详细提供了两款工具的安装配置指南、核心代码示例和批量处理脚本,帮助开发者根据实际需求选择合适工具。

4888

PDF转Markdown文件

PDF文件直接转Markdown也可以使用Obsidian加Markdown插件直接转,但是弊端是,图片资源都没有了,需要自己截图或者获取pdf图片源文件。这里建议从pdf转docx。

倾锋落颖花 1万+

不写代码,Cursor 10分钟开发1个APP!保姆级教程喂饭来了

做出第一个能运行的app,那种成就感真的很棒。虽然过程可能有点折腾,但只要耐心一点,问题都能解决。记住,遇到问题不要慌,现在有AI帮忙,大部分问题都能快速解决。重要的是迈出第一步,开始动手实践。你的第一个app可能很简单,但这是一个很好的开始。随着经验积累,你能做出的东西会越来越酷。现在就开始行动吧,说不定下个月你就能向朋友炫耀你自己做的app了!

chenhong007的博客 1551

一个好用的小工具 | 将PDF转换为Markdown格式

点击下方卡片,关注“小白玩转Python”公众号我使用过多种在线工具将PDF文档转换为Markdown格式,我觉得最好用的是Marker(可以通过链接访问:https://github.com/VikParuchuri/marker)。除了基本的Markdown转换,它还可以格式化表格,将大多数方程式转换为LaTeX格式,提取并存储图片。以下是我如何使用Marker提取PDF内容并将其转换为有效的...

Warmer_Sweeter 5666

Win11系统重装全记录:从备份Office激活到搞定RAID阵列,我的微星笔记本复活记

本文详细记录了Win11系统重装的完整过程,从数据备份到RAID阵列配置,特别针对微星笔记本的特殊硬件驱动问题提供了解决方案。文章涵盖了Office激活状态备份、BIOS设置、驱动安装顺序等关键步骤,帮助用户顺利完成系统重装并优化性能。

weixin_31421613的博客 309

MiniMax H3本地部署与ComfyUI集成实战:从环境配置到提示词优化

文本到视频生成是AI内容创作领域的关键技术,它基于扩散模型等深度学习原理,将自然语言描述转化为连贯的动态视觉序列。这项技术的核心价值在于大幅降低了视频制作的门槛,为短视频创作、概念可视化、教育内容生成等场景提供了高效工具。在实际工程实践中,成功部署和运行此类模型,如近期备受关注的MiniMax H3,需要精准处理环境配置、显存优化和提示词工程等环节。其中,解决“CUDA error: no kernel image is available”等版本兼容性问题,以及针对“8G显存”等有限资源进行参数调优,是确

weixin_33674976的博客 479

PDF 如何高效的转换成 markdown

它特别适合处理书籍和科学论文,支持多语言的转换,并且可以去除页眉、页脚等干扰元素,格式化表格和代码块。例如,合合旗下的智能文字识别品牌提供的在线服务,支持多种文件格式(如pdf、jpg、jpeg、png、bmp)的转换,上传单个文件大小不超过20M。:虽然Markdown不是所见即所得的编辑工具,但它通过简单的标记语法实现了精准的格式控制,生成的文档保持原来的排版和格式。另一个推荐的在线工具是Aspose,它提供了一个简单的界面,您只需上传PDF文件,它就会自动将其转换为Markdown格式。

大数据杂货铺的博客 4262

骚操作,尝试使用Xilinx XVC协议,通过Jlink来下载调试Xilink zynq FPGA芯片

最近一直在玩zynq芯片,手头使用的Xilinx Platform USB Cable 下载线真是辣鸡,速度慢如蜗牛,每次下载bit文件或者烧写flash文件都要大半天,实在是难以忍受。逻辑分析仪看了下xilinx的下载线,速度只有6.25M,并且数据间隔非常大,不懂这线的开发者咋想的,这总线利用率真是低到爆了 上图为xilinx DLC 10下载线波形,惨不忍睹! 为了不浪费生命在下载等待时间上,我打算找找看有没有别的仿真调试选择。经过一番查找后发现Xilinx的仿真器好像选择不是很多,要么贵死要

听我瞎扯淡的博客 1万+

一个免费好用的PDF转Markdown网站

免费,快速,简洁的PDF转Markdown网站。

weixin_64123373的博客 1万+

【拯救C盘】一文搞懂Windows修改Anaconda默认的虚拟环境存放路径及其原理

Anaconda创建的虚拟环境可能会默认保存在C盘,但C盘的存储空间很宝贵,由于每个虚拟环境的大小可能达到n个GB,稍不注意就会遇到C盘红色警告。因此有必要做点什么来拯救被虚拟环境占用的大部分空间!!!

Roach007的博客 3万+

麒麟V10系统下微信PC版安装全攻略:从源配置到一键安装(附常见问题解决)

本文详细介绍了在麒麟V10系统下安装和优化微信PC版的完整流程,包括系统环境准备、软件源配置、多途径安装方案以及性能优化技巧。特别针对国产操作系统用户,提供了从基础安装到高级配置的一站式解决方案,并附有常见问题排查方法,帮助用户快速实现微信PC版的高效运行。

weixin_30500105的博客 719

[1308]pdf转markdown

无论是文档、表格、图像、视频、音频文件,还是网页,OmniParse 都能对其进行处理,使其变得干净、结构化,并为诸如 RAG(Retrieval-Augmented Generation)和细调等AI应用做好准备。它主要用于高效地解析 PDF 文档中的排版、数学公式、表格、图片、图表等内容,并将这些内容转换为结构化的 Markdown 格式。参考:https://blog.youkuaiyun.com/weixin_40425640/article/details/140765933。

周小董 3162

CircuitBreaker Resilience4J 介绍

在分布式环境中,我们的应用可能会面临着各种各样的可恢复的异常(比如超时,网络环境异常),此时我们可以利用不断重试的方式来从异常中恢复(Retry Pattern),使整个集群正常运行。然而,也有一些异常比较顽固,突然发生,无法预测,而且很难恢复,并且还会导致级联失败(举个例子,假设一个服务集群的负载非常高,如果这时候集群的一部分挂掉了,还占了很大一部分资源,整个集群都有可能遭殃)。如果我们这时还是不断进行重试的话,结果大多都是失败的。

zzhongcy的专栏 3541

一键搞定!用代码轻松将PDF转为Markdown,高效又便捷!

在日常工作和学习中,PDF文件是我们经常接触的文档格式,但编辑和修改PDF却并不方便。如果你需要将PDF转换为更易编辑的Markdown格式,这篇文章将为你提供一个简单高效的解决方案!

2502_91125984的博客 1834

高速电路设计必看:同步开关噪声问题解析

数字电路中的同步开关噪声(SSN)问题日益突出,尤其是随着高速器件应用增多。本文分析了地弹和电压弹的产生机理,指出其与电源网络电感、输出驱动电流变化率密切相关。文章详细阐述了地弹参数特征,包括峰值电压、脉冲宽度等关键指标,并探讨了负载电容、信号压摆率等因素对地弹的影响。最后提出系统化的解决方案,涵盖芯片选型、电路设计、PCB布局和后期调试等多个环节,强调通过降低回路电感和控制电流变化率来有效抑制SSN。这些措施需要在性能、成本和复杂度之间取得平衡,为高速数字电路设计提供了重要参考。

一只豌豆象的博客 299

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

PDF文档完整转换为Markdown文档

如需进一步优化转换效果,可结合正则表达式清理冗余标签,或使用Markdown语法增强工具(如Typora)调整排版。• 操作流程:访问Aspose官网 → 选择PDF转MD → 上传文件 → 下载结果。• 操作流程:访问官网 → 上传PDF → 自动转换 → 下载Markdown文件。• 适用场景:简历、技术文档等简单内容转换,支持中文排版。• 特点:无需注册,支持50+格式转换,自动清除数据。• 特点:保留基础表格和列表,适合企业级快速处理。• 特点:速度快,但无法解析表格和图片。

百态·数智思维 | 聚焦大数据、量化与未来AI 3729

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

pdf转markdown-Marker工具的使用

注意:必须使用python3.10及以上的版本,搜先需要安装CUDA,CUDA须按照以下图片中的几个版本,再安装pytorch,安装pytorch的命令须根据如以下图片中的“pip3 install torch torchvision torchaudio”,具体安装命令根据系统和CUDA版本而定,默认情况下是可选的,如果您使用 tesseract,则为必需。某些 PDF,甚至是数字 PDF,其中的文本质量不佳。支持的任何语言(如果设置为 .如果您不需要 OCR,marker 可以使用任何语言。

weixin_51702542的博客 3046

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

freemarker 导出html格式word_PDF文件如何转成markdown格式

百度上根据pdf转makrdown为关键字进行搜索,结果大多数是反过来的转换,即markdown文本转PDF格式。但是PDF转markdown的解决方案很少。正好我工作上有这个需求,所以自己实现了一个解决方案。下图是一个用PDF XChange Editor打开的PDF文件,我想将其内容通过markdown格式导出。(1) 首先将该PDF导出成word格式,后缀.docx(2) 使用typora获...

weixin_39860260的博客 608

MinerU部署

重新使用 modelscope 命令下载 OpenDataLab/PDF-Extract-Kit 模型。可以看出不带版本号的模型,其目录里有这个缺失的 weights.pt 模型文件。修改配置文件/root/magic-pdf.json。.md 中即为解析的文本内容。

Dennisming的博客 1495

MinerU-pdf识别-本地部署

项目介绍:这是一款支持PDF、网页、电子书提取的一站式、开源、高质量数据提取工具。

人工智能(AI)技术,大模型技术,深度学习,机器学习,计算机视觉,AI工具实践应用等分享 1万+

Python PDF 转 Markdown 工具库对比与推荐

根据最新评测及开源社区实践,以下为综合性能与适用场景的推荐方案:

zhukui66的专栏 2282

教程:使用PDF转markdown工具marker

pdf转md工具:marker的使用教程

2302_79787639的博客 1745

最新开源的解析效果非常好的PDF解析工具MinerU (pdf2md pdf2json)

毫不夸张的说PDF解析工具MinerU是照进RAG黑暗中的一道光——这是我对它的评价。我测过太多了文档解析工具! 最近在做文档解析的工作。看了很多的开源的文档解析的工具,版面分析的工具,其中包括paddelpaddel这样30k+star的明星工具。但是效果都觉得不好。 MinerU是一个最近开源的文档解析工具,可以把PDF转成json结构,还可以转成md格式。可以解析得到其中的图片,表格,可以得到段落,可以得到标题,这是很哇塞的事情。因为最近RAG特别火热,这些都是RAG非常需要的。

Angus 3万+

免费将PDF格式转换成Markdown,html格式,看这篇就够了!!!

PDF转Markdown 如上图所示,将文件放进去即可进行转换。 PDF转html 只需要两步,就可以将PDF 转换成 HTML。 如果这篇文章能够帮助到你,希望您不要吝惜点赞 ,您的支持是我继续努力的动力 !!! ...

帅帅邬同学的博客 1981

Typora使用pandoc实现文档格式转换:Pdf转Word转md(markdown)

完成之后打开软件,将需要转换的pdf文件拖拽到软件内,点击转换,到MS-WORD,确认即可导出为word格式文件。安装完成,点击finish之后将(pojie文件)这个文件夹的两个文件复制到安装目录下的PDF Editor文件夹下,替换文件。但是该种方式,word中的图片丢失,无法加载,目前我也没有找到解决方法,所以还是建议使用第一种命令行的方式。打开cmd命令窗口,输入pandoc --version,可以确认是否安装成功。直接使用这个网站即可,上传pdf文件,会自动生成markdown格式的。...

江一铭 6193
上一篇: 安装包体积减少91%!Tauri基础入门,下一代全平台开发框架,Tauri对比Electron有什么优势?
下一篇: 三行命令,免费申请https加密证书,一次配置,永久生效
技术爬爬虾
博客等级 码龄3年 640粉丝 39原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值