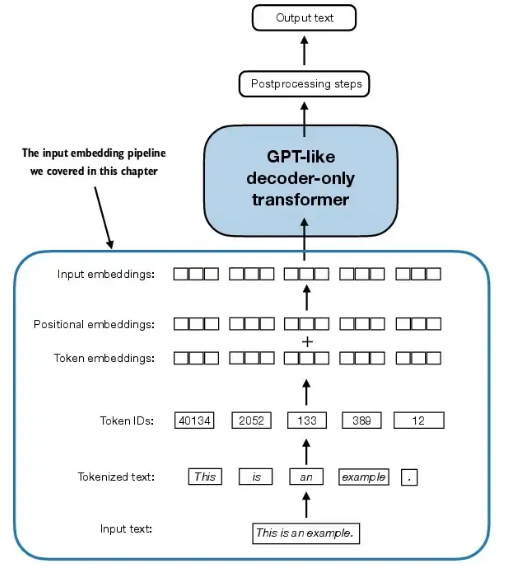
【从零构建大模型】第二章,embeddbing构建思路总结

CTP接口入门 该文章主要讲什么 这篇文章的面向对象是有一些C++基础,并且想用C++来做程式化交易的同学。 这篇文章可以算是我的程式化学习笔记中的一篇。其中介绍了CTP的简单的使用方式,并且附上了一些代码以及我在试用的时候遇到的一些小坑。 什么是CTP CTP是上海期货推出的一套可供程序调用的交易接口。就好比官方给程序化交易提供了的一个专门的业务窗口。 接口相关文件下载 CTP接口可以在上期... 阅读详情

1. 概述

本文,作为笔者,学习《从零构建LLM》书籍的笔记,总结章节核心内容,方便理解与回顾。

作者写了做个文章在下面公众号(驾驭AI美未来、大模型生产力指南),目的是提升大模型、智能体的理解,提高大家生产力,欢迎关注、点赞。

录了个视频课程,欢迎学习。

【从零构建大模型】 视频课程讲解,一步步带你理解大模型底层原理

2. 理解embeddng

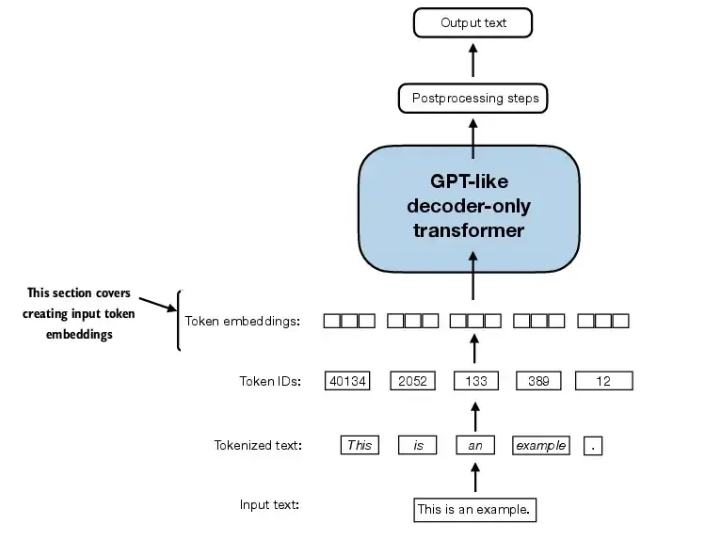
本文从零构建LLM,分为三个阶段,第一阶段,构建一个LLM, 第二阶段训练模型,第三阶段进行微调,从第一阶段embedding
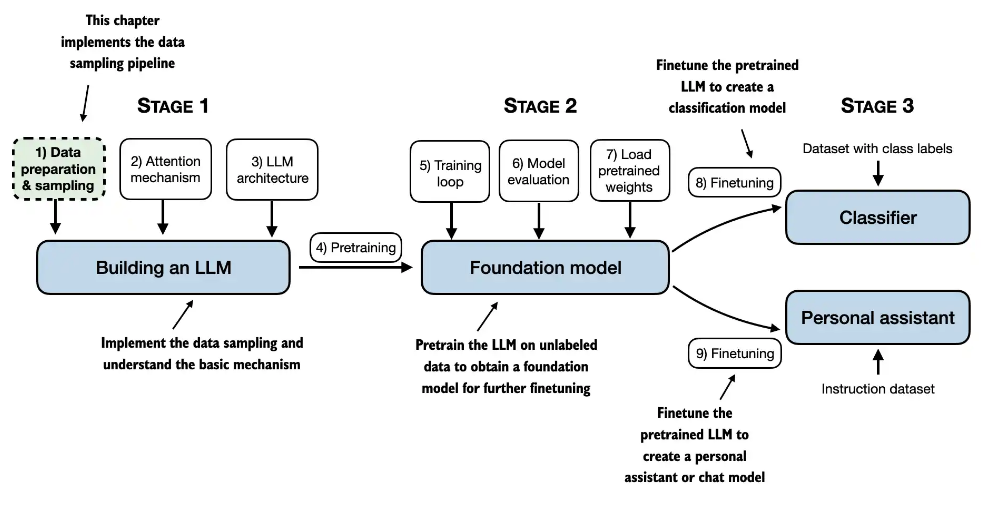
在这里插入图片描述

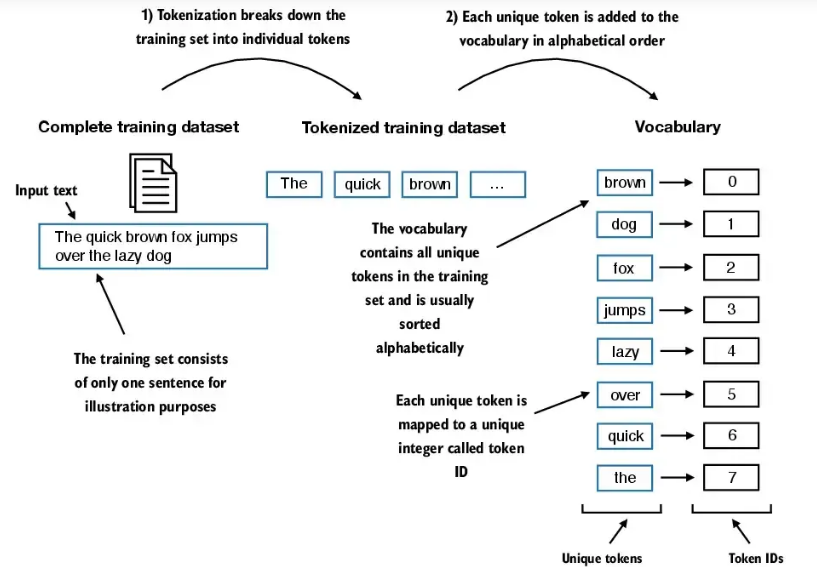
2.1 文本词元化

核心思想: 将连续的文本序列转化为离散的基本单元(即 token)”,中文固定译为 “分词” 或 “标记化”,在处理中文时可能表现为 “将句子拆分为单个汉字或词语”,处理英文时则常拆分为单词、标点等
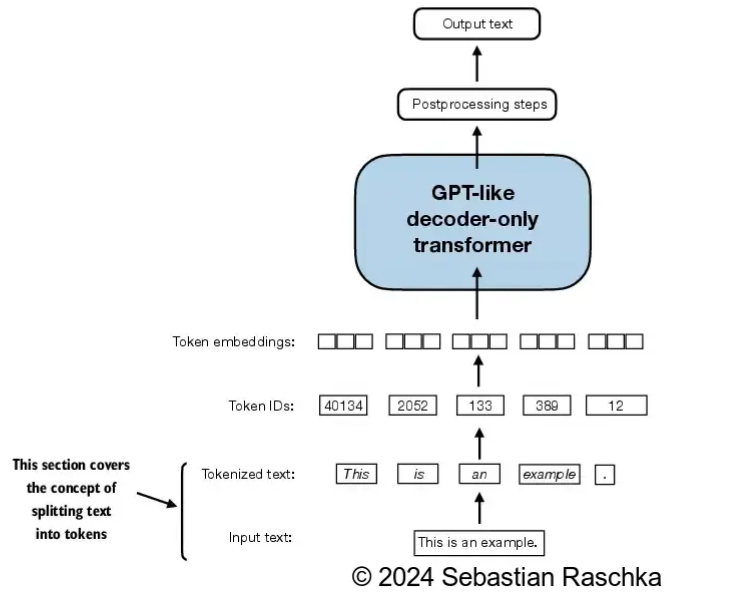
在这里插入图片描述

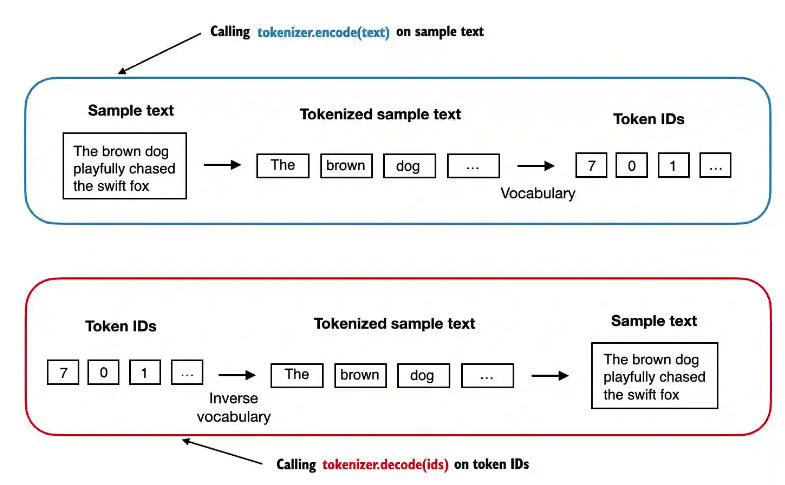
2.2 token转为tokenId

在这里插入图片描述

2.3 tokenId转为token

在这里插入图片描述

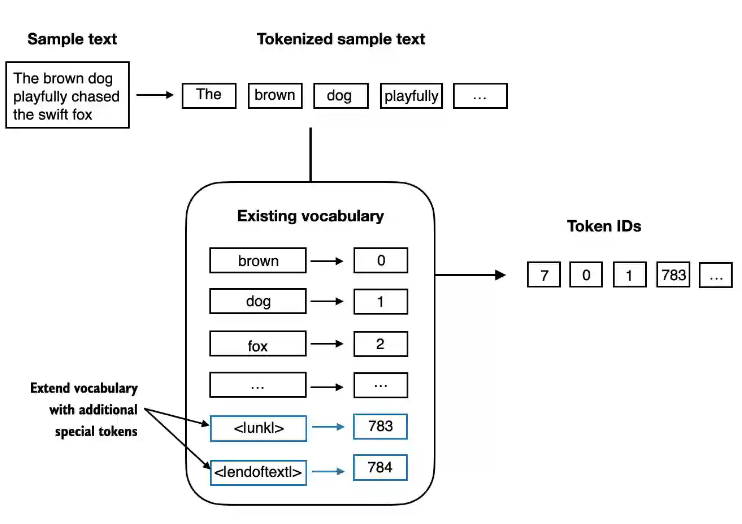
2.4 增加特殊的token代表所有未见过的词汇

在这里插入图片描述

2.5 openai 采用 tiktoken作为 BPE

tiktoken 是 OpenAI 开发的一个快速 BPE(Byte Pair Encoding)分词器
BPE原理参考: https://mp.weixin.qq.com/s/YAtyHZ6IVECq39esigkfTg

tiktoken 是 OpenAI 开发的一个快速 BPE(Byte Pair Encoding)分词器,用于将文本转换为模型可以处理的 token(标记)序列。在处理大型语言模型(如 GPT 系列)时,准确计算 token 数量非常重要,因为:
计费基于 token 数:OpenAI API 的使用费用根据输入和输出的 token 数量计算。 上下文窗口限制:模型有最大 token 限制(如 GPT-4 为 8K/32K tokens),超过会导致错误。
性能优化:合理拆分文本可以提高处理效率。 核心功能
文本转 token:将文本转换为模型使用的 token 列表。
token 计数:精确计算文本的 token 数量,避免超出模型限制。
高效性能:用 Rust 实现,速度比纯 Python 库快得多

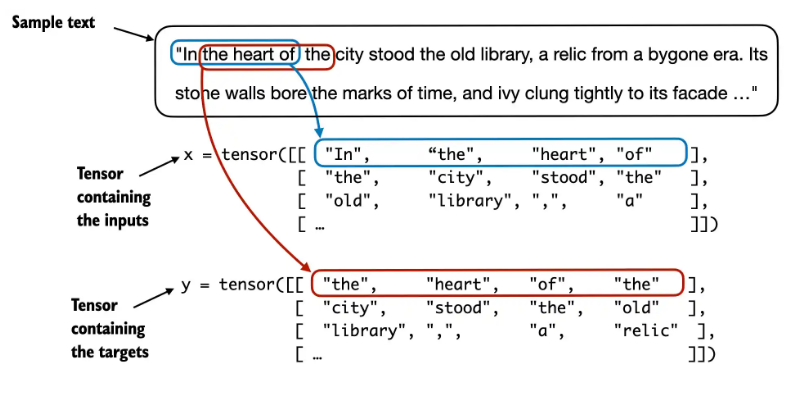
2.6 使用sliding window进行采样
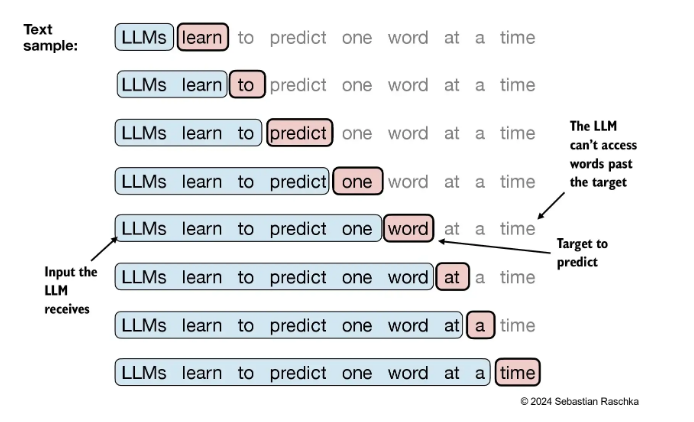
在这里插入图片描述

在这里插入图片描述

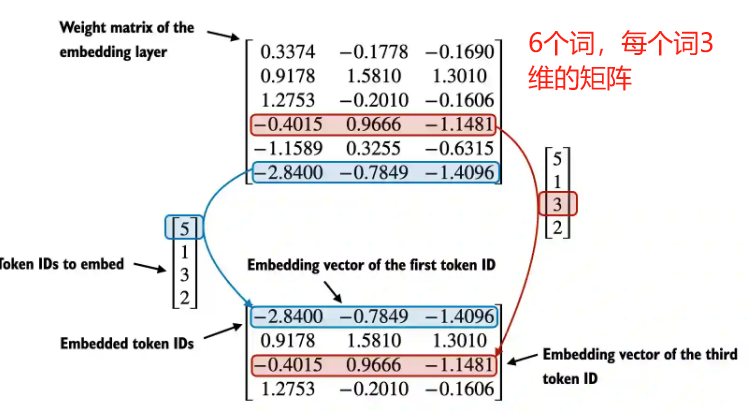
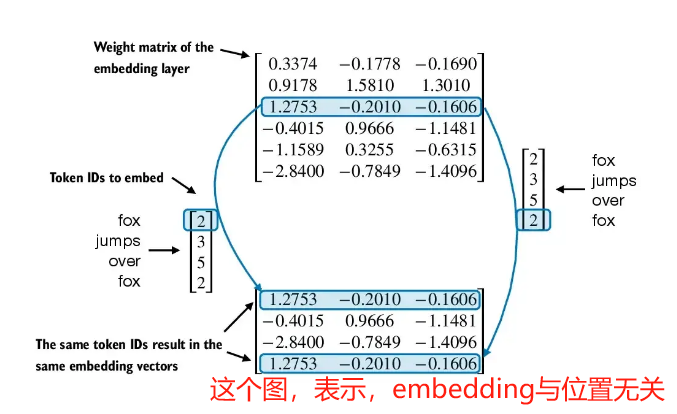
2.7 token转embedding

在这里插入图片描述
在这里插入图片描述

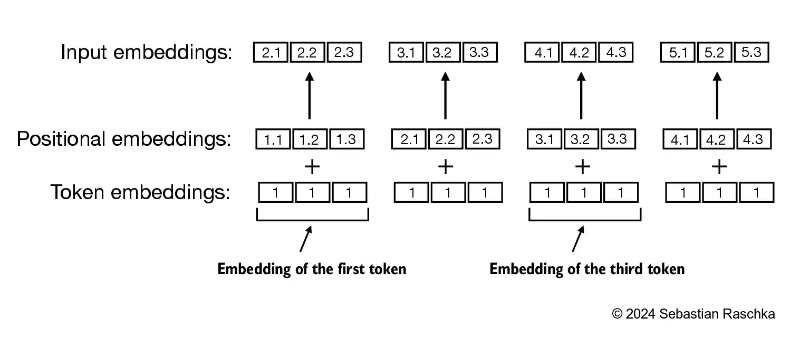
2.8 添加位置向量作为给transformer的输入

在这里插入图片描述
添加位置向量,目的是捕捉同一个词汇在不同位置的影响
在这里插入图片描述

在这里插入图片描述

基于XGBoost的混凝土力学性能预测系统 本文介绍了一个基于XGBoost算法的混凝土力学性能预测系统。该系统通过模拟生成3000组混凝土配合比数据(包含水灰比、水泥用量和龄期三个关键特征),利用XGBoost强大的非线性建模能力预测混凝土抗压强度。研究背景源于传统混凝土性能测试方法耗时耗力的痛点,该系统可显著减少实验次数,优化配合比设计。系统实现包括:数据生成与特征工程(模拟真实工程数据并添加噪声和异常值)、XGBoost模型构建、以及预测性能评估。XGBoost算法因其处理非线性关系能力强、鲁棒性好等优势被选用,可为智能建造和数字化施工提供技术 阅读详情

相关推荐

【Rcode】生存分析: KM & COX回归& 随机森林& nomogram

本文使用了R——survival包下的lung数据进行方法测试: 1)KM 2) Cox回归:多因素 3)随机森林因子(根据cox回归结果) 4)nomogram ( 根据cox回归结果,建立了中位生存时间,1年5年生存率的概率计算) -------------------????????‍♀️本文只有干货,非常干!????----------------------------- 一、数据加载 #生存分析 library("survival") library("survminer") data("

weixin_43172152的博客 9273

Spring AI + GPT-5.5 + Ollama 配置教程:Base URL、超时与流式调用

由于不同 Spring AI、Spring Boot 小版本之间仍可能存在差异,创建项目时应检查 Spring Initializr、Spring AI BOM 和官方兼容矩阵,不要直接复制旧教程中的 Starter 名称和版本号。多人项目最好隔离不同客户端,并在脱敏前提下记录最终 URL、状态码、请求耗时、请求 ID 和模型 ID。Spring AI 接入模型 API,至少要同时确认 Starter、Base URL、请求路径、API Key、模型 ID、连接超时、读取超时和流式客户端这 8 项。

2601_95893075的博客 230

鼎捷T100—二次开发:客制化联络对象维护作业 aooi350

鼎捷T100二次开发,客制化

weixin_52342654的博客 1132

RAG-FastGPT安装

今天开始学习RAG安装,选择FastGPT,环境是Windows 11。

w8827130的博客 89

PostgreSQL高可用之主备复制

多个PostgreSQL可协同工作,如果主库发生宕机备库将迅速进行接管并对外提供服务以实现高可用。本文将从主备复制、主备切换、故障转移等角度进行实际测试演练。第一章主备复制是基础,通过主备复制可以得到一个或多个相同的实例。在主备复制的基础上通过第二章主备切换介绍了如何手工将主库与备库互换角色。在第三章中,采用了Keepalived进行实时监测,在主库宕机后,使用主备切换中提到的命令使备库升级为主库并对外提供服务,以达到PostgreSQL高可用的目标。

asdasdsaff的博客 1348

嵌入式Linux网络调试踩坑记:YT8531/YT8521 PHY驱动移植与设备树配置实战

本文深入解析嵌入式Linux系统中YT8531/YT8521 PHY驱动移植与设备树配置的实战经验。从网络不通的常见现象入手,详细介绍了驱动移植关键点、设备树配置详解及常见问题排查技巧,帮助开发者快速解决RGMII接口调试难题,提升嵌入式网络开发效率。

weixin_42525328的博客 444

GPT Image 2.6 的 Flare 与 Sunburst:双版本怎么分工,附一套迁移回归测试

GPT Image 2.6 在 11 月 4 日上线,API 里多了 Flare 和 Sunburst 两个变体。Flare 走速度与布局,Sunburst 走画质与多轮编辑一致性。这篇讲清三个新参数的用法边界,并附一套两三个小时能跑完的迁移回归测试:四类 case、五项打分、5 次里 4 次过前三项才算可用。

weixin_47592901的博客 364

GD32单片机开发环境搭建(Keil5安装)

1.安装MDK5 由于GD32 Keil 版本例程的工程是基于Keil MDK-ARM 5.25 uVision5 创建的,所以我在此也安装MDK5.25版本。 下载链接:https://pan.baidu.com/s/1E4tcDQvsVl0xezU3pEyJTA 提取码:s1fr 其他版本下载链接:https://cloud.tencent.com/developer/article/1605195 选择安装路径(不要装到中文路径下,避免不必要的麻烦): 用户信息随便...

fangye945a的博客 3万+

GPT-6.2 灰度的 3D 演示火了

在 GitHub 社区有部分 Claude Opus 5.5 用户抱怨复杂任务变慢、质量波动或更快耗尽额度。并展示了单个提示词生成的 Three.js 场景:浮空岛、瀑布、光照和昼夜变化,全塞进一个 HTML 文件里,没有外部素材。此前多用户反馈现在 GPT-6 降智了,如果本次消息属实,那 ChatGPT 用户的体验将会有很大的改善。为了不错过 GPT、Claude、Gemini、Grok 和 Apple 的重要更新与实用教程,请关注👆。欢迎在评论区留言你的想法,给他人启发。

hello99yum的博客 202

RK3588上跑通Zipformer语音识别的3个坑与填坑实录(附完整编译命令)

本文详细记录了在RK3588开发板上部署Zipformer语音识别模型时遇到的三个典型问题及其解决方案,包括静态库版本冲突、编译脚本配置错误以及模型转换精度调优。文章提供了完整的编译命令和实战步骤,帮助开发者快速在边缘设备上实现高效的语音识别应用。

l6m7n8的博客 714

Windows11上pip安装IsaacSim5.1.0与IsaacLab

本文详细介绍了CUDA Toolkit 12.8.0、IsaacSim和IsaacLab的安装过程。首先从NVIDIA官网下载并安装CUDA Toolkit 12.8.0,然后通过miniforge创建conda环境(env_isaacsim)安装IsaacSim相关Python包,解决了Windows长路径问题。成功运行IsaacSim后,克隆IsaacLab仓库并完成安装验证,最后通过创建空场景测试环境配置。整个安装过程包含详细的命令行操作和问题解决方法,为机器人仿真开发环境搭建提供了完整指导。

拥抱具身智能,昇腾Ascend C 378

GPT Image 2.6 编辑验收实战:保留项清单、接口骨架与排错流程

> 本文由 AceDataCloud 来源文章改编并经 AI 辅助整理。示例使用占位凭据;具体参数、计费、权限和区域可用性以当前模型目录与接口文档为准。 “接口返回了一张图”不等于编辑成功。对商品图和内容素材来说,真正困难的是判断:模型是否只改了该改的部分,原来已经正确的商品结构、文字和光影有没有被破坏。 ![纸面标注需要修改的位置](https://i-blog.csdnimg.cn/dir

jakeycis123的博客 238

解密Whisper模型与Speaker Diarization的结合

本文介绍了如何将Whisper语音识别模型与Speaker Diarization(说话人分割)技术相结合,实现多人对话场景下的语音转录和说话人识别。文章详细讲解了技术背景、环境配置和代码实现方法,通过Pyannote进行说话人分割,结合Whisper进行语音转文本,最终输出包含说话人信息的完整转录结果。该解决方案适用于会议记录、访谈分析等场景,显著提升了语音处理的应用价值。

2501_90323865的博客 152

OpenAI 公开物理工程加速:Astra/GPT‑6 一周设计 Codex 对话设备,BenchCAD 内部模型 0.875 vs Astra 0.594

OpenAI 官方博文(2026-11-03)《Accelerating engineering for the physical world》分享模型如何帮助工程师设计、仿真与制造物理产品。重点:用 Astra(多模态+computer use)与 GPT‑6 端到端设计可对话 Codex 的测试设备,两人侧项目约一周、合同制造商约一个月内小批量原型;量产就绪仍需多轮人工审阅。自 February 起硬件团队 token 用量增 23-fold。

weixin_49016065的博客 154

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

OpenAI 11月4日发布 GPT Image 2.6:原生直出 SVG/GIF、涂鸦精准修图

OpenAI 于11月4日正式推出 GPT Image 2.6(ChatGPT Images 2.6),带来 sunburst 和 flare 双模型矩阵。本次更新不仅彻底打通了原生 SVG 矢量图 与 GIF 动图 生成,还上线了颠覆性的 Markup(标记引导)修图功能 和 complexity 规划深度控制。

蓝星空的专栏 180

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

GPT-6 Cyber 正式发布——以子之矛,攻子之盾

已经被AI攻破,人脸识别可能要“失业”了给WorkBuddy接上LibTV,直接解锁专业AI视频创作!还能搭建自动化视频工厂GPT-Image-2.6全量上线!直出GIF和SVG,6.2 Astra也即将现身等等各种AI消息层出不穷,已经追不上AI了。学不完,根本学不完…今天我们要讲一点不一样的,有关AI安全,强大的矛盾关系。大家好!我是天府云创.直接开讲!

Enweitech Software Works 181

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

GPT-6.1 Terra是什么?gpt-6.1-terra API实测:视觉理解、电脑操作、写作与JSON输出

GPT-6.1 Terra把视觉理解、界面操作、写作和结构化输出放在同一个快速模型中。它能读懂截图里的文字与控件位置,能把界面任务拆成带校验的动作序列,也能按要求生成文案并输出固定格式的数据。对于内容、运营和自动化类应用,它是值得优先评估的一档;复杂编程和高风险的端到端执行,则应与GPT-6.1 Sol或GPT-6 Astra对照后再决定。

2601_96207100的博客 395

zeekeai怎么用GPT-6.1 Sol做教学大纲?

本文介绍如何通过ZEEKEAI平台整合GPT-6.1 Sol等多模型,实现教学大纲的高效生成。采用“文献提炼—结构化输出—配图生成”的工程化工作流,结合五段式专家Prompt与三大场景模板,可快速产出逻辑严密、格式规范、符合学情的高质量大纲。强调格式层级、学时校验、知识点适切性及配图建议,避免常见翻车点。最终实现从“手工排版”到“智能提效”的教研跃迁,显著提升备课专业度与效率。

Xiaofeng3693的博客 472

zeekeai上GPT-6.1 Sol生成政务公文怎么样

在体制内公文写作中,GPT-6.1 Sol 依托 zeekeai 多模型协同平台,实现格式规范、语言克制、逻辑严密的高效输出。实测显示,其在通知、讲话稿、调研报告等场景下表现卓越,配合 Claude 审核与 Gemini 提炼,构建“初稿生成—合规审查—重点提取”闭环流程。关键避坑指南包括禁用绝对化词汇、杜绝政策编造、严格层级格式,并强调“AI辅助,人工把关”的核心原则。成本低、效率高,真正实现政务公文从“苦差”到“利器”的转变。

Xiaofeng3693的博客 328

挖出948个内核漏洞、自动写补丁:GPT-6 Cyber把AI推进“实战岗“,内容行业还卡在哪一关?

上周安全圈刷屏的一条消息,来自OpenAI:面向获批安全团队开放的网络安全模型GPT-6 Cyber正式亮相。在早期测试中,这个模型对最新版本的Linux内核做了自主扫描,一共找出948个提权漏洞,并自动生成了修复补丁——人类研究员的分工,变成了复核与确认。官方表述里有一个关键措辞值得注意:这不再是"演示",而是"实战"。安全行业向来是技术圈里验收标准最苛刻的领域之一。一个误报会浪费工程师几天时间,一个漏报则可能酿成真实事故。让AI进入这个领域,从来不是"跑个分数"那么简单。

weixin_42926482的博客 130

2026 两款开发会议转写模型评测:gpt-transcribe + scribe_v2 的术语、说话人与时间轴

11 月 3 号晚上,我在整理一场开发会议的录音。三个人来回抢话,夹着useMemoPostgreSQL和,中间还静音了十几秒。跑完才发现,纯文本“看着挺准”没什么用。说话人和时间轴一乱,人工修订照样坐牢。

weixin_46591161的博客 143

GPT Image 2.6 接入指南:Flare、Sunburst 怎么选,编辑失败如何排查

> 本文基于 AceDataCloud 原文改编,并由 AI 辅助整理,重点补充面向开发者的模型选择、接入流程与编辑排错思路。原文:[《GPT Image 2.6 正式发布:更快生成、更准编辑,AI 图像进入生产力时代》](https://platform.acedata.cloud/blog/gpt-image-2-6-launch-faster-generation-precise-editi

jakeycis123的博客 237

AI4S首个开源大模型Hydrogen-1.0发布:跑赢GPT-6-Astra,让AI自己做科研

写到这儿,我也想聊一聊最近AI4S的感受。AI证明了Navier–Stokes方程会爆掉、把挂谷猜想推到所有维度,在噬菌体里翻出类CRISPR的酶。刷到这些新闻的时候,实在是非常振奋人心~但是,兴奋完是有点空的,这些事,跟我、跟绝大多数做科研的人,关系不大,我们就是围观的群众。AlphaFold当年没有让大家围观:蛋白质结构预测,科学家折腾了五十年。AlphaFold做出来以后,DeepMind把2亿多个预测结构全放进了公开数据库。到现在,190个国家、300多万研究者都在用它。

夕小瑶科技说 213

OpenAI 发布 GPT-6 Cyber,专攻网络安全

OpenAI 的网络安全能力又又又升级了。今天,OpenAI 正式发布。它是基于 GPT-6 Astra 打造的网络安全专用版,也是上一代 GPT-5.6 Cyber 的继任者。这次升级,模型找漏洞、验证漏洞的能力更强了。与此同时,OpenAI 也花了不少力气训练它遵守任务边界。新模型公布的第一个成果来自 Firefox。Firefox 是全世界被审查得最严格的代码库之一。

Tokenge的博客 261

gpt-transcribe 报 HTTP 415 怎么办?音频能播放也没用,Content-Type 和 file 字段必须对上

以 OpenRouter、ofox.io 这类聚合网关/中转为例,应从其控制台或当前接口文档中取得 Base URL、转录端点和 API Key,不要照搬可能过期的地址。字段名错误时,更常见的响应可能是 400 或 422,但有些网关会在 multipart 解析阶段直接返回 415。即使把文件转成 Base64,外层仍是 JSON,不符合该端点要求的 multipart 结构。10 月 29 日晚上,我碰到过一次:文件在本地播放完全正常,最后查出来却是音频被塞进了 JSON,服务端压根没走到转录阶段。

2601_95892788的博客 251

智能体“自适应慢思考”的算力黑洞:当 Claude 5.5 与 GPT-6.1 Sol 陷入推理自旋,为什么高并发架构必须重构“认知预算熔断与快慢推测执行”?

一缕82年的清风:【前沿极客情报局】:大模型慢思考带来的推理自旋正在引爆生产级高并发系统的尾延迟灾难。本文深入剖析智能体无休止反思与队列饥饿根因,拆解自适应认知预算熔断与异构快慢推测执行架构,用确定性工程防线守住企业系统 SLA。进入 2026 年,大模型厂商与学术界正在合谋构筑一个全新的神话叙事:“不要给模型设限!只要开启或。

lsqingfeng的博客 183
上一篇: 【GPT入门】第71课 autogen介绍与代码实现股票分析汇报多智能体
下一篇: 【从零构建大模型】第三章,从零构建简单transformer与带权重transformer、多头注意力
*星星之火*
博客等级 码龄12年 3799粉丝 222原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值