Python爬虫:一个爬取豆瓣电影人像的小案例

【Python】Scrapy爬虫实战(豆瓣电影 Top 250) 今天一天都在弄Scrapy,虽然爬虫起来真的很快,很有效率,但是......捣鼓了一天 豆瓣电影 Top 250:https://movie.douban.com/top250 安装好的scrapy 在你想要的文件夹的目录下输入命令: scrapy startproject douban_moive 在spiders目录下: scrapy genspider myspider  ... 阅读详情

从谷歌浏览器的开发工具进入
选择图片右键点击检查在这里插入图片描述

![在这里插入图片描述](https://img-blog.csdnimg.cn/1b38c2a942c441fb8cb545a28bb35015.png在这里插入图片描述

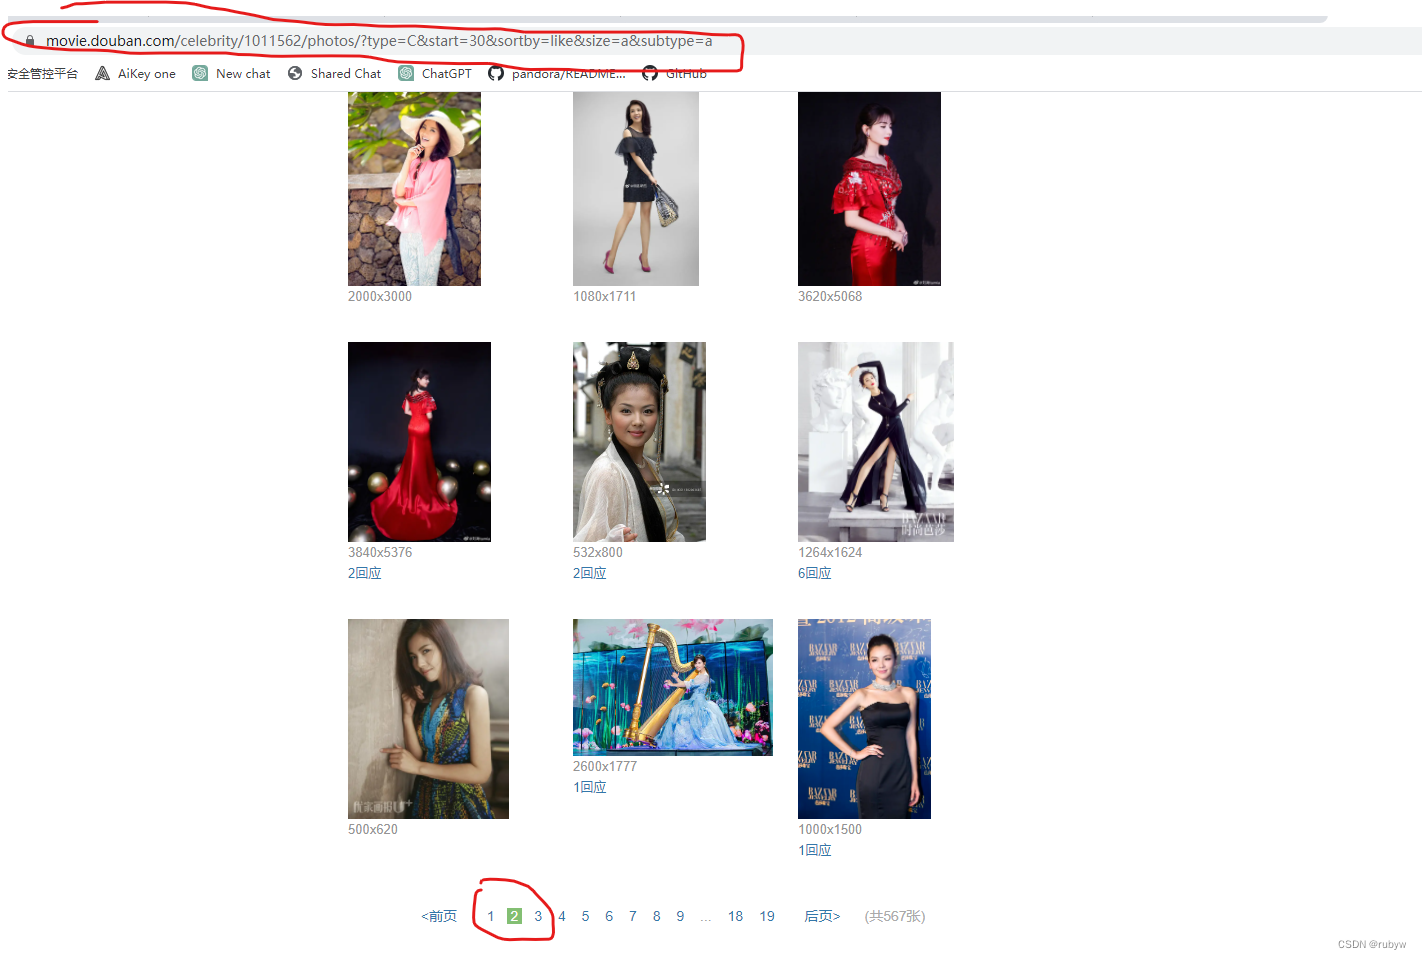
翻页之后发现网址变化的只有start数值,每次变化值为30

Python代码

import requests
from bs4 import BeautifulSoup
import time
import os


# 豆瓣影人图片
url = 'https://movie.douban.com/celebrity/1011562/photos/'
res = requests.get(url=url, headers="").text
content = BeautifulSoup(res, "html.parser")
data = content.find_all('div', attrs={'class': 'cover'})
picture_list = []
for d in data:
    plist = d.find('img')['src']
    picture_list.append(plist)
print(picture_list)


# https://movie.douban.com/celebrity/1011562/photos/?type=C&start=30&sortby=like&size=a&subtype=a
def get_poster_url(res):
    content = BeautifulSoup(res, "html.parser")
    data = content.find_all('div', attrs={'class': 'cover'})
    picture_list = []
    for d in data:
        plist = d.find('img')['src']
        picture_list.append(plist)
    return picture_list

# XPath://*[@id="content"]/div/div[1]/ul/li[1]/div[1]/a/img
def download_picture(pic_l):
    if not os.path.exists(r'picture'):
        os.mkdir(r'picture')
    for i in pic_l:
        pic = requests.get(i)
        p_name = i.split('/')[7]
        with open('picture\\' + p_name, 'wb') as f:
            f.write(pic.content)

def fire():
    page = 0
    for i in range(0, 450, 30):
        print("开始爬取第 %s 页" % page)
        url = 'https://movie.douban.com/celebrity/1011562/photos/?type=C&start={}&sortby=like&size=a&subtype=a'.format(i)
        res = requests.get(url=url, headers="").text
        data = get_poster_url(res)
        download_picture(data)
        page += 1
        time.sleep(1)


fire()
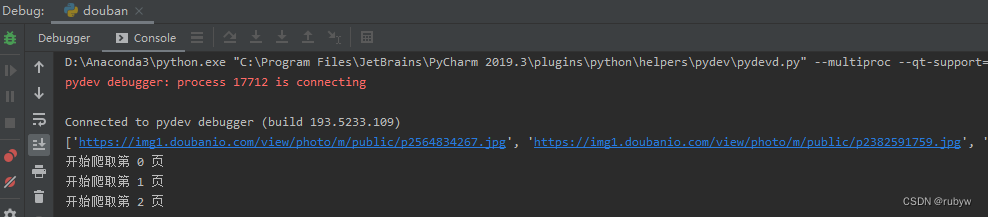
在这里插入图片描述

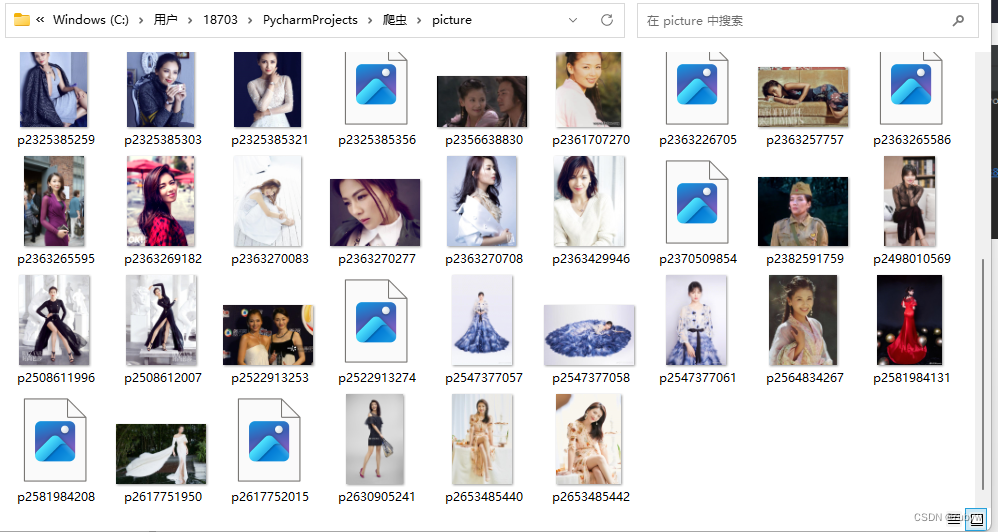
把爬取的图片全部放到新建的文件夹中存放
在这里插入图片描述

python用正则抓取豆瓣电影图片----爬虫 正则爬取豆瓣电影的图片 一、知识点 正则,文件操作 import requests import re import os url = "https://movie.douban.com/" headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:73.0) Gecko/20100101 Firefox... 阅读详情

相关推荐

Python3爬取大量电影信息及源代码

豆瓣电影是一个很好的电影信息来源,我们将使用它来获取电影的标题、评分和简介等信息。本文将介绍如何使用Python3编写一个简单的网络爬虫,来获取大量电影信息,并提供相应的源代码。通过分析豆瓣电影页面的结构,我们发现每个电影的信息都包含在class为"item"的div元素中。通过以上步骤,我们可以使用Python3编写一个简单的网络爬虫,来获取大量电影信息。然后,我们可以循环遍历每个电影元素,提取出电影的标题、评分和简介等信息。当然,我们也可以将获取到的电影信息保存到文件中,以便后续处理或分析。

CyberLancer的博客 488

python爬虫笔记一:爬取豆瓣中指定的明星所有图片

https://movie.douban.com/celebrity/1011562/photos/ 打开页面F12进入开发者工具,查看 下载的页数,以及每页最多显示30张 countlist = content.find_all('span', attrs={'class', 'count'})

bestyellow的专栏 2521

python爬取豆瓣电影(requests模块)

python使用requests模块请求网址,使用lxml模块中etree抓取数据,并使用time模块延时 爬取的页面为: 运行结果如下图所示: python代码如下: 在这里插入代码片 # _*_ coding:utf _*_ # 邮箱:3195841740@qq.com # 人员:21292 # 日期:2020/3/8 11:05 # 工具:PyCharm import requests from lxml import etree import re import time headers = { 'Cookie': 'll="118375"; bid=LweMDRu6xy0; __

Python爬虫实战—探索某网站电影排名

在本文中,我们介绍了如何使用Python编写一个简单的网络爬虫,并以某网电影网站为例进行了详细说明。通过对某网电影Top250页面的爬取,我们学习了发送HTTP请求、解析HTML文档、提取所需信息以及保存数据到CSV文件的基本操作。我们还对代码进行了进一步的优化,包括异常处理、数据去重、使用生成器优化内存占用、添加用户代理池等,以提高爬虫的稳定性、效率和可维护性。除此之外,我们还讨论了一些提高爬虫功能和可用性的方法,如改进用户交互、添加定时任务、编写单元测试等。

一键难忘的博客 5681

Vue项目实战:用DataV的dv-scroll-board打造高颜值滚动表格(附完整代码)

本文详细介绍了如何在Vue项目中使用DataV的dv-scroll-board组件打造高颜值滚动表格。从基础集成到高级配置,包括动态数据处理、深度样式定制、性能优化策略以及交互增强方案,帮助开发者快速实现企业级数据展示需求。特别针对样式优化和滚动表格的常见问题提供了实用解决方案。

weixin_30892037的博客 499

当传统CFD遇上AI:PINN如何帮我们省下90%的仿真计算时间?

本文探讨了物理信息神经网络(PINN)在计算流体力学(CFD)中的应用,如何通过无网格方法节省90%的仿真计算时间。PINN将物理定律编码到神经网络中,显著减少传统CFD中的网格生成和计算时间,同时保持高精度。文章还对比了PINN与传统方法的性能,并讨论了其独特优势和当前局限。

weixin_32678995的博客 321

Python3网络爬虫--爬取海外视频(附源码)

本次分析了一个海外视频网站,着重在于爬虫的分析思路,因为这会直接影响代码的撰写。发表本篇记录一下分析过程,也为其他的道友踩踩坑。思路、代码方面有什么不足欢迎各位大佬指正、批评!

懷淰メ的博客 8128

蓝牙6.0的‘新雷达’:Channel Sounding信道探测,真能比UWB更香吗?

本文探讨了蓝牙6.0的Channel Sounding信道探测技术在室内定位领域的应用潜力。通过与UWB技术的对比分析,揭示了其在成本、功耗和兼容性方面的优势,特别是在智能门锁、物品追踪等场景中的商业价值。Channel Sounding技术不仅具备亚米级精度,还能通过现有蓝牙设备实现零边际成本部署,为物联网应用提供了新的解决方案。

weixin_29288313的博客 334

Python爬虫实战-批量爬取豆瓣电影排行信息

近日锋哥又卷了一波Python实战课程-批量爬取豆瓣电影排行信息,主要是巩固下Python爬虫基础

java1234的博客 1675

DeerFlow 在 Windows 上的安装与启动详细步骤

DeerFlow Windows安装与启动指南 DeerFlow是基于LangGraph的AI Agent系统,包含后端服务和前端界面。后端安装需Python 3.12+,创建虚拟环境后安装依赖,需注意解决langgraph版本冲突问题(推荐1.0.8版本)。配置文件中需设置模型参数(如本地Qwen3-32B-AWQ模型)和sandbox配置。启动分为两步:LangGraph Server(端口2024)和Backend Gateway(端口8001)。前端要求Node.js 22+和pnpm,配置.env

笨小孩 584

告别全局搜索!7种SRP-PHAT快速算法实战对比:哪个更适合你的麦克风阵列?

本文深入探讨了7种SRP-PHAT改进算法在声源定位领域的实战表现,包括SRC、CFRC、SPF等方案。通过对比计算效率、定位精度和环境鲁棒性等核心指标,为不同场景(如会议室、智能家居、工业机器人)提供算法选型建议,帮助工程师优化麦克风阵列性能。

weixin_42546392的博客 399

再见了, 达叔!我用Python回顾一代喜剧大师203部作品,太经典了!

公众号“菜鸟学Python”,设为 “星标”第447篇原创,和30w+一起学Python!今天早上看到新闻,一代喜剧大师,著名的喜剧演员达叔离开了,心情还是非常沉重的。小编是看过达叔演...

cainiao_python的博客 698

C# 开发 WPS 插件实战:从环境搭建到功能实现(附完整代码)

本文提供了一份详尽的C#开发WPS插件实战指南,涵盖从环境搭建到功能实现的完整流程。通过COM技术,开发者可以创建自定义插件,为WPS Office扩展自动化功能,如文档处理与格式转换。文章包含核心概念解析、Ribbon界面集成、调试部署方法及完整代码示例,帮助开发者快速上手。

rust6ferris的博客 929

Python3多线程爬虫实例讲解

接下来,定义一个继承自的爬虫线程类。线程类将负责从任务队列中获取URL,发送网络请求,并解析响应内容。try:url } : {e } ") finally : self . queue . task_done() @staticmethod def parse_page(html) : soup = BeautifulSoup(html , 'html.parser') # 此处根据实际网页结构进行解析 # ... print(f"Page parsed: {url } : {

qalangtao的博客-qalangtao.com 1476

量化 insider 爆料! 散户打板必亏?(打板必看!量化资金如何“隔日砸盘”收割散户)

量化开发 insider 爆料💥 散户追的涨停板📉,可能是机构故意做的陷阱!本文从技术视角拆解“涨停陷阱”,帮你看清市场真实逻辑🧠。

XiaoqiangClub的博客 460

【WRF-Urban】Registry.EM_COMMON文件概述及urban有关变量

Registry.EM_COMMON文件概述及urban有关变量

WW、forever的博客 1596

python3 爬虫—爬取豆瓣电影图片(一)

内容: 爬取豆瓣电影首页 https://movie.douban.com/  显示出来的图片,并将其保存于本地路径中。 网页部分截图: 原理: 1.使用内置库:urllib.request 获取请求得到网页数据 ; 2.利用header 进行伪装浏览器; 3.再使用正则表达式 r'(https:[^s]*?(jpg|png|gif))' 取出照片地址 4.创

heshushun的博客 4056

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

用python从豆瓣爬取王祖贤的照片

发现实战真的是最好的学习方法! 语言:python IDE:PyCharm 前期准备: 安装好python、chromedriver、浏览器XPath Helper插件 这次演示爬取json格式的和html格式分别的处理方法 首先先看json格式的 先打开豆瓣,搜索“王祖贤”->选择图片->找到请求的url 我们访问这个url,发现返回的数据是json格式的 然...

dam454450872的博客 648

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Python爬虫-爬取豆瓣高分电影封面

本文是本人最近学习Python爬虫所做的小练习。如有侵权,请联系删除。

不是七七子的博客 1105

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

Python爬虫实战:爬取豆瓣电影

网络爬虫是一种自动化程序,能够从互联网上抓取数据。它通过模拟浏览器请求,访问网页并提取所需的信息。发送HTTP请求:向目标网站发送请求,获取网页内容。解析HTML:从网页中提取有用的数据。存储数据:将提取的数据保存到本地或数据库中。本文通过一个简单的豆瓣电影Top250爬虫实例,介绍了Python爬虫的基本流程。我们从发送HTTP请求、解析HTML到存储数据,逐步实现了一个完整的爬虫程序。此外,我们还探讨了如何处理分页和动态内容,以及应对常见的反爬虫策略。

weixin_45145684的博客 2400

简单的图片爬取,爬取豆瓣电影图片并保存到本地

最近刚刚学习了网络爬虫这门课程,那么自然而然地爬取了豆瓣电影Top这个经典案例

不温卜火 8133

Python 爬虫-豆瓣影星图片下载

该功能实现了通过输入姓名下载对应的图片 import os import re from selenium import webdriver import requests import urllib.request from bs4 import BeautifulSoup def getIDBeyound(name): url = "https://search.douban.com/movie/subject_search?search_text=%s&cat=1002"

AdigaAdele的博客 343

python爬虫之豆瓣首页图片爬取

【代码】python爬虫之豆瓣首页图片爬取。

jolinoy的博客 1266

教会你用Python爬虫爬取网页数据!!保姆级教程

爬虫就是自动获取网页内容的程序,例如搜索引擎,Google,Baidu 等,每天都运行着庞大的爬虫系统,从全世界的网站中爬虫数据,供用户检索时使用。爬虫流程其实把网络爬虫抽象开来看,它无外乎包含如下几个步骤模拟请求网页。模拟浏览器,打开目标网站。获取数据。打开网站之后,就可以自动化的获取我们所需要的网站数据。保存数据。拿到数据之后,需要持久化到本地文件或者数据库等存储设备中。那么我们该如何使用 Python 来编写自己的爬虫程序呢,在这里我要重点介绍一个 Python 库:Requests。

2301_78095812的博客 5683

Python爬虫入门教程!手把手教会你爬取网页数据

其实在当今社会,网络上充斥着大量有用的数据,我们只需要耐心的观察,再加上一些技术手段,就可以获取到大量的有价值数据。这里的“技术手段”就是网络爬虫。今天就给大家分享一篇爬虫基础知识和入门教程:

weixin_55154866的博客 4769

如何用python爬取网站数据,python爬取网页数据步骤

爬虫就是自动获取网页内容的程序,例如搜索引擎,Google,Baidu 等,每天都运行着庞大的爬虫系统,从全世界的网站中爬虫数据,供用户检索时使用。

chatgpt001的博客 1948
上一篇: 一个简单的Python网络爬虫教程
下一篇: Python正则表达式简单教程
rubyw
博客等级 码龄7年 1528粉丝 234原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

rubyw

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值