财政收入预测分析:时间序列分析

数据挖掘实战—财政收入影响因素分析及预测 文章目录引言一、数据探索1.数据质量分析1.1 缺失值分析1.2 异常点分析—箱型图分析1.3 重复数据分析2.数据特征分析2.1 描述性统计分析2.2 分布分析2.3 相关性分析二、数据预处理 引言   本文运用数据挖掘技术对市财政收入进行分析,挖掘其中的隐藏的运行模式,并对未来两年的财政收入进行预测,希望能够帮助政府合理地控制财政收支,优化财政建设,为制定相关决策提供依据。定义数据挖掘目标如下: 分析、识别影响地方财政收入的关键属性 预测2014年和2015年的财政收入 本文数据挖掘主要包括以下步骤 阅读详情
#导入相关的库
import pandas as pd
import numpy as np
from matplotlib import pyplot
import matplotlib.pyplot as plt
from matplotlib.pyplot import rcParams
#rcParams设定画布大小
rcParams['figure.figsize'] = 15, 6
#导入时序数据
data = pd.read_excel(r"C:\Users\18703\Desktop\天津市财政收支1996-2017.xlsx")
data.head()

在这里插入图片描述

tf = data[['税收收入']]
tf.index = data['年份']
tf.head()

在这里插入图片描述
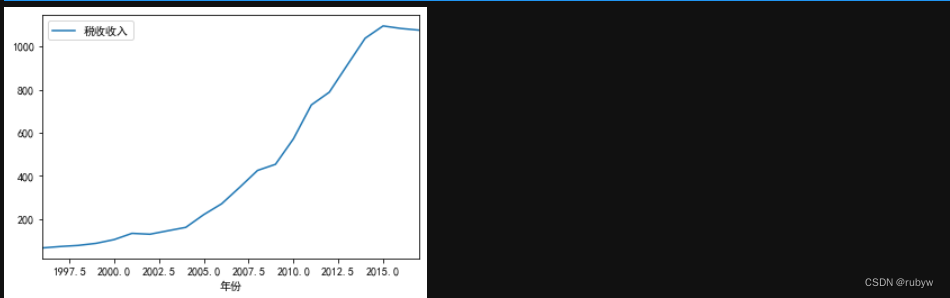
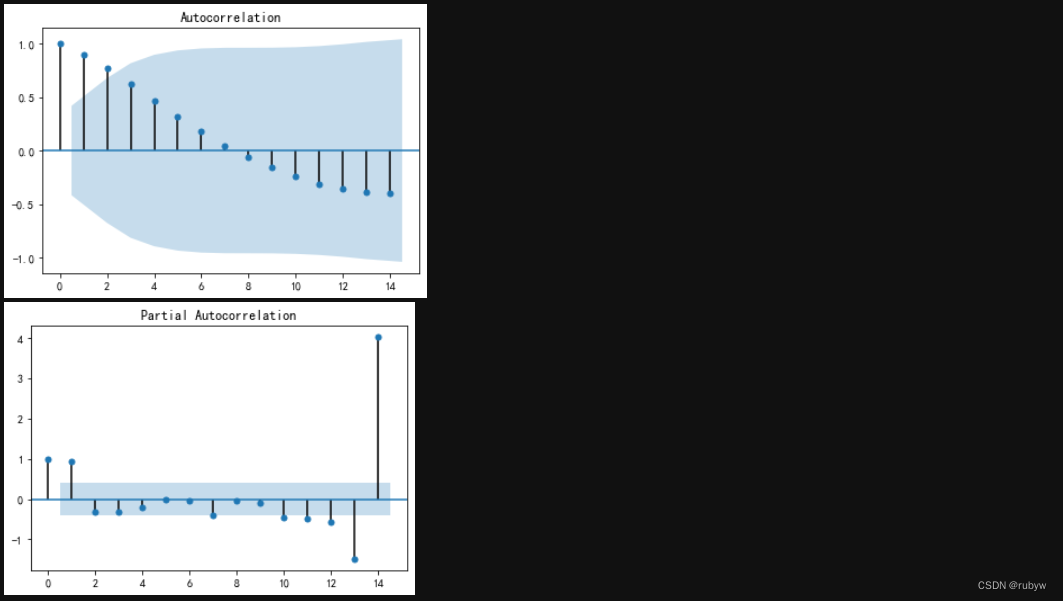
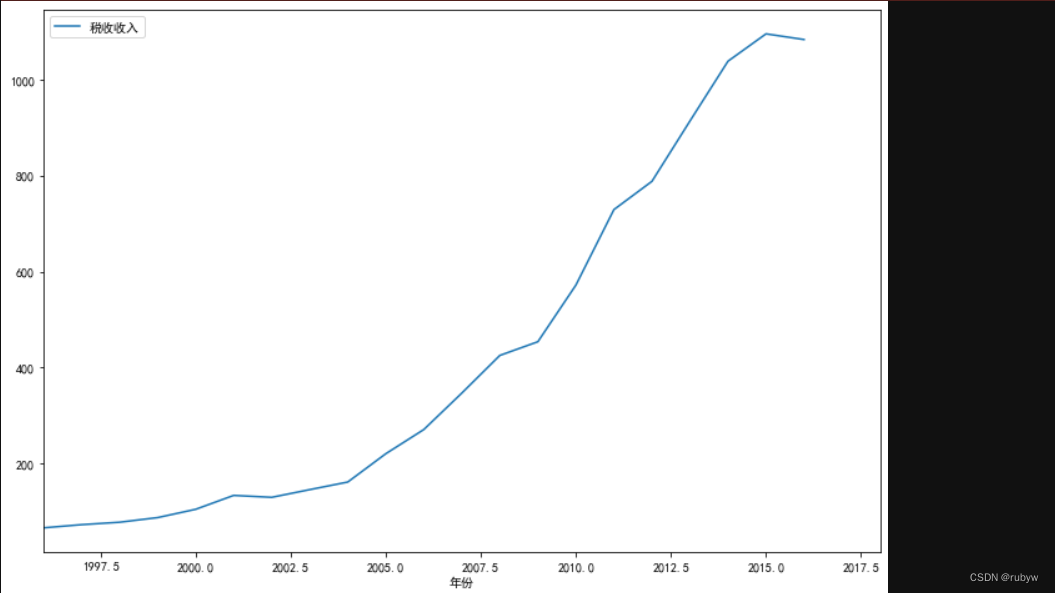
检查数据是否为平稳序列

from statsmodels.graphics.tsaplots import plot_acf, plot_pacf

#解决中文显示问题
plt.rcParams['font.sans-serif']=['SimHei']
plt.rcParams['axes.unicode_minus'] = False
#绘制时序图
tf.plot()
plt.show()
#绘制自相关图
plot_acf(tf).show
#绘制偏自相关图
plot_pacf(tf).show
在这里插入图片描述
在这里插入图片描述

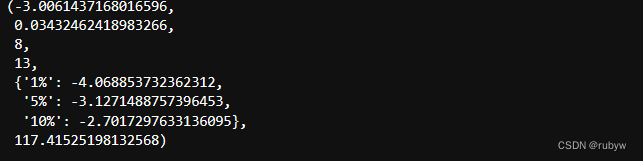
#单位根检验
from statsmodels.tsa.stattools import adfuller as ADF
ADF(tf['税收收入'])#第二个值为p值,p<0.05,拒绝原假设,不存在单位根
在这里插入图片描述
差分-转化为平稳序列

#1阶差分
tf_diff1 = tf.diff(1).dropna()
tf_diff1.columns = ['一阶差分']
tf_diff1.plot()
plt.show()

在这里插入图片描述

ADF(tf_diff1['一阶差分'])

在这里插入图片描述

#随机性检验(白噪声检验)
from statsmodels.stats.diagnostic import acorr_ljungbox
acorr_ljungbox(tf_diff1,lags=1) #p=0.00751547<0.05,拒绝原假设,所以一阶差分后的序列不是随机的

在这里插入图片描述

#由acf,pacf判断模型参数
plot_acf(tf_diff1).show()
plot_pacf(tf_diff1).show()

在这里插入图片描述
模型训练

#ARIMA(1,1,1)

from statsmodels.tsa.arima_model import ARIMA
from statsmodels.api import tsa

arima = ARIMA(tf, order=(1,1,1))
result = arima.fit(disp=False)
print(result.aic,result.bic,result.hqic)

在这里插入图片描述

plt.plot(tf_diff1)
plt.plot(result.fittedvalues, color='red')
plt.title('ARIMA RSS:%.4f' % sum(result.fittedvalues - tf_diff1['一阶差分']) ** 2)
plt.show() #RSS:累计平方误差
#根据bic遍历p,q值,取bic最小时对应的p,q

from statsmodels.tsa.arima_model import ARIMA


tmp = []

for p in range(4):

    for q in range(4):

        try:

            tmp.append([ARIMA(tf,(p,1,q)).fit().bic,p,q])

        except:

            tmp.append([None,p,q])


tmp = pd.DataFrame(tmp,columns = ['bic','p','q'])

tmp[tmp['bic'] ==tmp['bic'].min()]

模型检验

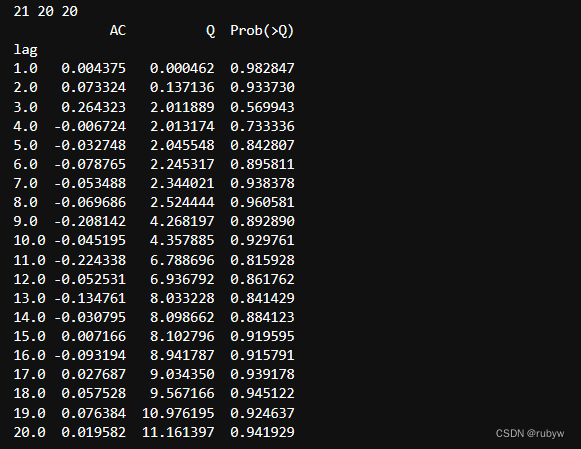
# ARIMA   Ljung-Box检验 -----模型显著性检验,Prod> 0.05,说明该模型适合样本
resid = result.resid
r, q, p = tsa.acf(resid.values.squeeze(), qstat=True)
print(len(r), len(q), len(p))
test_data = np.c_[range(1, 21), r[1:], q, p]
table = pd.DataFrame(test_data, columns=['lag', 'AC', 'Q', 'Prob(>Q)'])
print(table.set_index('lag'))
#原假设是相关系数为0
在这里插入图片描述
模型预测

tf.loc[2017]=None
tf.loc[2018]=None

predict = result.predict(22,23,dynamic=True)
print(predict)
fig,ax = plt.subplots(figsize=(12,8))
ax = tf.ix[1996:2018].plot(ax=ax)
# predict.plot(ax=ax)

在这里插入图片描述
在这里插入图片描述

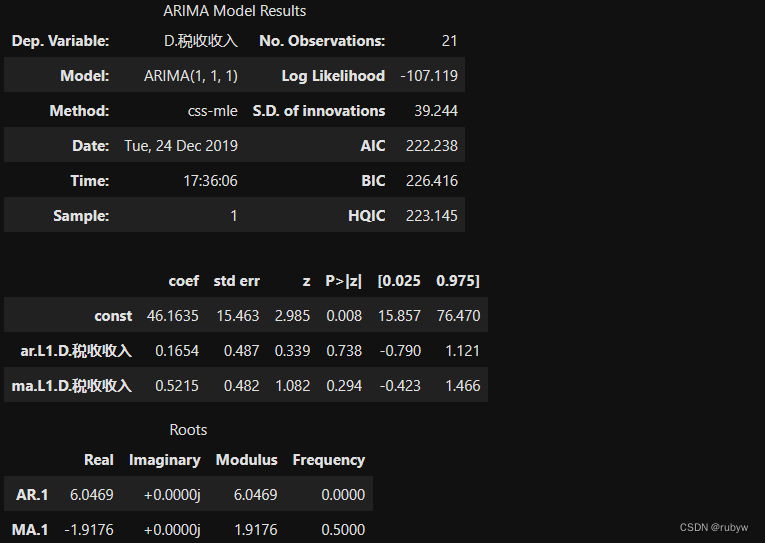
model = ARIMA(tf,(1,1,1)).fit()
model.summary()
在这里插入图片描述

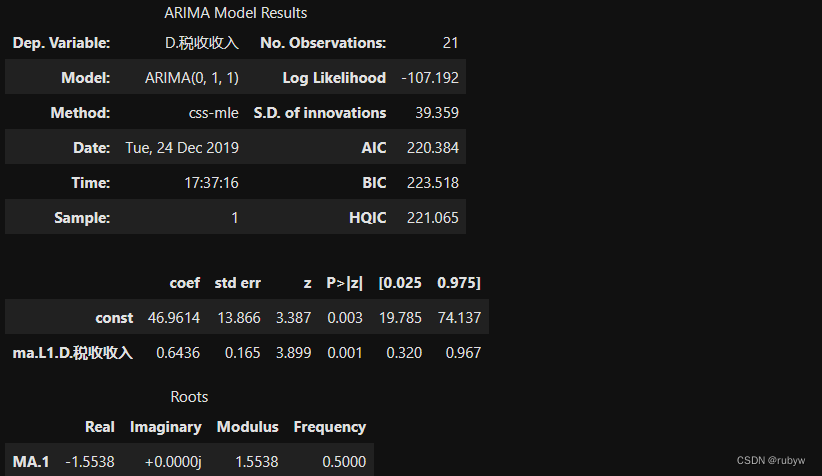
ARIMA(tf,(0,1,1)).fit().summary()

在这里插入图片描述

#预测未来5年
yp = model.forecast(5)
yp[0]

在这里插入图片描述

ARIMA(tf,(0,1,1)).fit().forecast(5)[0]

在这里插入图片描述

模型效果不好,时间序列分析方法不适用样本数据

泰迪—财政收入预测 import pandas as pd import numpy as np data = pd.read_csv('C:/Users/Lenovo/Desktop/data.csv',sep = ',') data #相关系数 data.corr() import matplotlib.pyplot as plt import seaborn as sns plt.rcParams['font.sans-serif'] = 'SimHei' heat = sns.heatmap(data.corr()) 阅读详情

相关推荐

TimesFM:面向真实业务的通用时间序列预测基础模型

时间序列预测是工业界核心AI能力之一,其本质在于从历史数据中建模动态模式与因果依赖。传统方法如ARIMA、LSTM或Encoder-Decoder Transformer受限于上下文长度、任务特化强、误差累积严重等问题,难以支撑多场景、小样本、高噪声的真实业务需求。TimesFM通过Patch-based建模、Decoder-only因果架构与输出块预测等创新设计,实现了对时间模式的语义化抽象与泛化能力解耦,显著提升长周期预测稳定性与零样本迁移能力。该模型已在电商销量、设备故障预警、财政收入预估等典型场景验

weixin_29631169的博客 279

RSNNS神经网络

library("RSNNS") data <- read.table('/Users/xufly/Project/RProject/YearPredictionMSD.txt',header=FALSE,sep=",",fileEncoding = 'UTF-8') #将数据顺序打乱 data = data[sample(1:nrow(data),length(1:nrow(data))),1:n

Yaphat的博客 1958

多元线性回归和时间序列模型预测中国国民总收入

多元线性回归和时间序列模型预测中国国民总收入。

weixin_54707168的博客 4119

python财政收入预测分析_python 数据分析-- 实战1(收入预测分析)

说明:本文用途只做学习记录:参考书籍:从零开始学Python数据分析与挖掘/刘顺祥著.—北京:清华大学出版社,2018首先看一下刘老师介绍的数据分析和数据挖掘的区别:1. 预览数据集,明确分析目的通过Excel工具打开income文件,可发现该数据集一共有 32 561条样本数据,共有15个数据变量,其中9个离散型变量,6个数值型变量。数据项主要包括:年龄,工作类型,受教育程度,收入等,具体可见下...

weixin_39572152的博客 3011

财政收入影响因素分析及预测模型Python源码.rar

财政收入影响因素分析及预测模型Python源码 数据挖掘算法是根据数据创建数据挖掘模型的一组试探法和计算。 为了创建模型,算法将首先分析您提供的数据,并查找特定类型的模式和趋势。概念描述算法使用此分析的结果来定义用于创建挖掘模型的最佳参数。然后,这些参数应用于整个数据集,以便提取可行模式和详细统计信息。

用Multisim仿真石英晶体振荡电路:从等效模型到频响曲线实战

本文通过Multisim软件,从构建石英晶体等效电路模型入手,详细演示了如何仿真分析其电抗频率特性曲线,并实战搭建与调试皮尔斯振荡电路。文章深入探讨了振荡必须工作在串联与并联谐振点之间感性区的原因,为电子设计者提供了从理论到仿真的完整可视化学习路径。

ik67890123的博客 504

【数据挖掘案例】财政收入影响因素分析及预测模型

分析方法与过程(选择的原则) 以往对财政收入的分析会使用 多元线性回归模型和最小二乘估计方法来估计回归模型的系数,通过系数能否通过检验来检验它们之间的关系,但这样的结果对数据依赖程度很大,并且求得的往往只是局部最优解,后续的检验可能会失去应有的意义。因此本案例运用Adaptive-Lasso变量选择方法来研究。 Lasso Adaptive-Lasso变量选择方法 Adaptive_lasso算法是近些年来被广泛应用于参数估计于变量选择的方法之一。Adaptive_Lasso算法能够解决最小二乘法和逐步回归

积一时之步,臻千里之遥程 1万+

Flink CDC 实战:5分钟搞定PostgreSQL数据实时同步(附避坑指南)

本文详细介绍了如何使用Flink CDC实现PostgreSQL数据的实时同步,包括环境配置、逻辑复制槽创建、Flink环境搭建及实战验证。通过5分钟快速指南,帮助开发者高效搭建实时数据管道,并提供了常见问题排查和生产环境优化建议。

red88的博客 820

【项目实战】Python基于Lasso特征选择、GM算法和SVR回归算法进行财政收入影响因素分析及预测

Python基于Lasso特征选择、GM算法和SVR回归算法进行财政收入影响因素分析及预测

张陈亚的博客 1万+

U8+ 新建账套

一、登录 账套主管:demo 对账套有修改权限,有账套库权限 系统管理员:admin 其他所有权限 二、新建账套 admin登录–>点击系统管理–>账套–>建立 选择了参照已有账套结转期初:就是上一个的期末数据作为这一次新表的期初数据 启用会计期一旦选择更改不了。 ...

茶茶很困i 3695

Mellanox ASAP2技术揭秘:如何通过硬件卸载提升OVS性能?

本文深入解析Mellanox ASAP2技术如何通过硬件卸载显著提升Open vSwitch(OVS)性能。通过将数据平面操作转移到ConnectX智能网卡处理,ASAP2实现了10倍吞吐量提升和90%延迟降低,同时大幅减少CPU占用。文章包含技术原理剖析、实战配置指南及性能对比数据,为网络虚拟化优化提供关键解决方案。

weixin_30335575的博客 376

《统计学》第八版贾俊平第十三章时间序列分析和预测知识点总结及课后习题答案

贾俊平《统计学》第十三章时间序列分析和预测知识点总结及课后习题答案

WHNWZY的博客 1万+

Orale EBS R12 AP应付模块 发票导入接口(Interface)

ap_interface_groups_s.nextval; ap_invoices_interface_s.nextval; ap_invoice_lines_interface_s.nextval; SELECT * FROM ap_invoices_interface ih; SELECT * FROM ap_invoice_lines_interface il; SELECT * FROM...

qq_41206741的博客 3321

数据挖掘实战分享:财政收入影响因素分析及预测(三)

灰色预测法是一种对含有不确定因素的系统进行预测的方法。

tipdm0526的博客 4341

MicroCap声学仿真介绍(四)-扬声器仿真

将“障板”模块放置到工作区,“Param:AREAm2=”是指的是障板孔的面积,一般可以输入喇叭的面积Sb;“Param:DISTm=”指的是测试麦克风与障板的距离,这里我们可以填入1米,小喇叭可以填入0.1m;此时工作区的电阻是竖直的,为了方便,我们需要将其变成水平的。其中,频率范围为20~20KHz,仿真点数为500个点,先仿真频响曲线和相位曲线,点击左上角的run,界面如下。鼠标单击工作区,弹出如下界面:在弹出的界面中输入“.define Re 3.82 “,点击”确定“按钮。

山无忧的博客 3008

【大语言模型 14】Transformer权重初始化策略:从Xavier到GPT的参数初始化演进之路

权重初始化是深度学习训练成功的隐秘基石,特别是在Transformer这样的深层架构中,合适的初始化策略能够决定模型的训练稳定性和收敛速度。本文从经典的Xavier和He初始化出发,深入解析Transformer特有的初始化策略,通过数学推导、代码实现和实验分析,揭示不同初始化方法对大语言模型训练的深层影响。我们将探讨为什么GPT系列模型采用特定的初始化方案,以及如何针对不同层设计最优的初始化策略。

熵数实验室 1688

数学建模常用模型06 :时间序列预测

时间序列预测与马尔科夫链预测互补,至少有2个点需要信息的传递,ARMA模型,周期模型,季节模型等 ARMA模型的全称是自回归移动平均(auto regression moving average)模型,它是目前最常用的拟合平稳序列的模型,它又可细分为AR模型(auto regression model)、MA模型(moving average model)和ARMA模型(auto regress...

HaLosec_Wei 3万+

番外篇第3集:多模态运维!让 AI 看懂 Grafana 图表并自动生成巡检报告

文章摘要 《多模态运维:让AI看懂Grafana图表并自动生成巡检报告》介绍了如何利用Qwen2.5-VL多模态模型解决传统运维巡检的痛点。文章指出人工查看Grafana监控图表存在效率低、易漏判、报告编写耗时等问题,提出通过Grafana Render API和多模态AI技术实现自动化巡检方案。 主要内容包括: 环境准备:配置Qwen2.5-VL多模态模型和Grafana访问权限 测试验证:展示模型准确识别图表类型、指标数值和异常趋势的能力 技术实现:封装Grafana截图API客户端,支持面板截图和数据

qq_2937655951的博客 111

灰色预测模型代码_财政收入影响因素分析及预测模型(三)

本文为泰迪学院最新推出的数据挖掘实战专栏第三篇,本专栏将数据挖掘理论与项目案例实践相结合,可以让大家获得真实的数据挖掘学习与实践环境,更快、更好的学习数据挖掘知识与积累职业经验。 专栏中每四篇文章为一个完整的数据挖掘案例。案例介绍顺序为:先由数据案例背景提出挖掘目标,再阐述分析方法与过程,最后完成模型构建,在介绍建模过程中同时穿插操作训练,把相关的知识点嵌入相应的操作过程中。 ...

weixin_39952190的博客 2742

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

matlab对经济指标分析,财政收入预测与分析MATLAB

内容介绍财政收入分析与预测问题【摘要】国家的财政收入与国民收入、工业总产值、农业总产值、总人口、就业人口、固定资产投资等因素有关。首先,我们根据所给数据,对数据进行描述性分析。之后,我们对数据进行了回归分析,构造了多元线性回归模型,并获得了模型的回归系数估计值及其置信区间。然后,考虑到每个回归系数置信区间包含零点与否的情况和变量之间存在多重共线性,我们用逐步回归法剔除了工业总产值、就业人口因素变量...

weixin_29958797的博客 1888

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

时间序列预测

与马尔科夫链预测互补,至少有2个点需要信息的传递,ARMA模型,周期模型,季节模型等 ARMA模型的全称是自回归移动平均(auto regression moving average)模型,它是目前最常用的拟合平稳序列的模型,它又可细分为AR模型(auto regression model)、MA模型(moving average model)和ARMA模型(auto regression movi

sk18192449347的博客 3294

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

arima 公式_小白快速上手数据分析1 | 时间序列ARIMA分析

ARIMA时间序列分析作用:ARIMA时间序列分析通常用于对单列具有时间序列的数据进行预测,例如销售量预测,股票收盘价预测等等○输入:单列数据序列的数据,例如每个月销售额,每天股票的价格,通常数据量为15-50条;○输出:对未来5-15天进行预测ARIMA模型的全称叫做自回归移动平均模型,也记作ARIMA(p,d,q),是统计模型中最常见的一种用来进行时间序列预测的模型。ARIM...

weixin_39614528的博客 3886

《Python数据分析与数据挖掘实战》第十三章学习——预测

这一章内容是对财政收入的影响因素进行分析,并构建预测模型。 本章数据比较清楚,几乎不用做清洗工作,主要工作都在模型构建上,中间涉及到的算法有Lasso算法的改进算法——Adaptive-Lasso、书中自己编写的灰色预测、神经网络。 书中对财政地方收入、增值税、营业税、政府基金收入等都做了预测,但每一个预测所用模型和构建过程都类似,因此本文只选择财政地方收入作为例子进行整理。 本文主要分为以

sinat_33519513的博客 4358

Python数据挖掘之时序模型预测

Python数据挖掘之时序模型预测 一、单变量序列预测 # 对数据直接进行ARIMA自回归综合移动平均线预测 from statsmodels.tsa.arima.model import ARIMA import pandas as pd import numpy as np data = pd.read_excel('C:/Users/86188/Desktop/Python数据挖掘与数据分析/My work/第六章/财政收入影响因素分析及预测/tmp/new_reg_data_GM11.xls')

LSH1628340121的博客 4625

数据挖掘实战(6):实战篇

内容分为三个部分:第一部分:**第13章:财政收入影响因素分析及预测模型** 的内容;第二部分:**第14章:基于基站定位数据的商圈分析** 的内容;第三部分:**第15章:电商产品评论数据情感分析** 的内容;

ZhuNian的学习乐园 2700

回归分析预测模型搭建_经济预测模型中一般包含有时间序列分析模型和回归分析模型两大类...

关注我啦研究方法主要包含文献研究法和实证研究法,在实证研究中又包含定量分析法和定性分析法。文献研究法是根据一定的研究目的,通过查找文献来获得相应的资料,得到前面学者的相关研究结论,从而准确地、全面地了解和掌握所要研究问题的一种方法;而实证研究法是研究者收集观察资料,依据现有的科学理论,根据实验的需要,提出设计思路,再通过有目的的步骤进行实验,为提出理论假设或检验理论假设而展开研究。本文采...

weixin_33837516的博客 714
上一篇: 某市财政收入预测分析:GM模型+神经网络
下一篇: 灰色预测GM模型
rubyw
博客等级 码龄7年 1528粉丝 234原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

rubyw

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值