最大最小值归一化和L2范数归一化总结

数据归一化 附有原码 1、最大值归一化,即是将对应数据xi除以数据最大值xmax: yi = xi/xmax; 2、 区间归一化,即是将数据最大值xmax与最小值xmin之和减去该数据xi,再与最大值xmax相除: yi = (xmax + xmin - xi)/xmax; 3、最大值极差归一化,即是将数据最大值xmax减去对应数据xi,再与最大最小值之差(xmax - xmin)相除: yi = (xma... 阅读详情

最大最小值归一化和L2范数归一化是很常用的两种数据预处理方法,本文总结了这两种方法的一些特点。

1、最大最小值归一化

一般而言,归一化是针对于数据集中某个特征维度进行的,在sklearn中,数据的组织形式为[n_samples,n_features],最大最小值归一化的定义如下。

X_{std}=\frac{X-X.min(axis=0)}{X.max(axis=0)-X.min(axis=0)}

之所以要按照不同特征维度进行归一化,是因为如果将每个样本进行最大值最小值归一化,数据的分布信息将会丢失。

2、L2范数归一化

L2范数归一化可以将每一个样本归一化,也可以将所有样本的各个维度进行归一化,在sklearn中提供了一个归一化的方法

sklearn.preprocessing.normalize(X, norm=’l2’, axis=1, copy=True, return_norm=False)

该方法默认使用的axis=1,也就是说该方法默认是将每个样本进行了L2归一化,代码如下所示。

# encoding: utf-8

from sklearn.preprocessing import normalize
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(10)
data = np.random.randn(10,2)

plt.scatter(data[:,0],data[:,1],c="g")
data_n = normalize(data,norm="l2",axis=1,copy=True,return_norm=False)
plt.scatter(data_n[:,0],data_n[:,1],c="r")
plt.legend(["original","normalized"])
for i in range(len(data)):
    v1 = np.linalg.norm([data[i][0],data[i][1]])
    v2 = np.linalg.norm([data_n[i][0],data_n[i][1]])
    if v1>v2:
        x, y = data[i][0], data[i][1]
    else:
        x, y = data_n[i][0],data_n[i][1]
    plt.plot([0,x],[0,y],"k")

theta = np.arange(0, 2*np.pi, 0.01)
cx = np.cos(theta)
cy = np.sin(theta)
plt.plot(cx,cy)
plt.show()

结果如下图所示,其中绿色点是原始数据点,红色点是L2归一化之后的点,L2归一化之后的数据点全部落在了以原点为中心,半径为1 的圆周上,并且原始数据点和L2归一化之后的点以及原点共线。
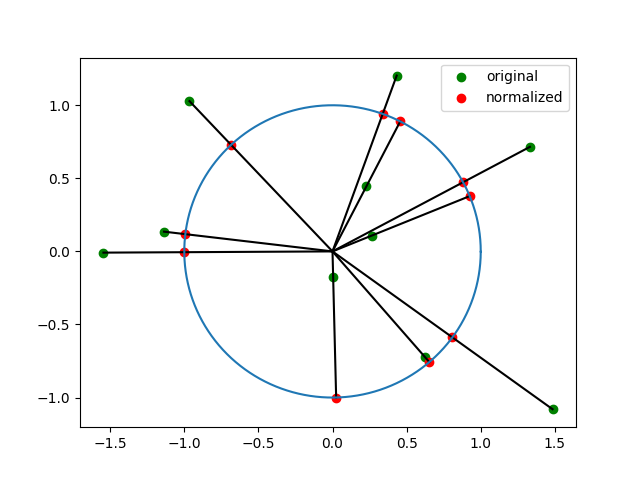
每个样本的L2范数为1,即样本分布在一个超球的表面,对于2维特征向量就是一个圆周。如果有两个样本点和原点共线,那么这两个样本L2范数归一化之后的结果相同。

如果将每个特征维度进行归一化,由于每个维度2范数归一化之后的值肯定会小于1,所以不管原来的特征向量值有多大,2范数归一化的特征向量都在一个半径为1的超球之内,并且可以保持原始特征向量之间的位置关系,代码和结果如下。

# encoding: utf-8

from sklearn.preprocessing import normalize
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(10)
data = np.random.randn(10,2)
plt.subplot(121)
plt.scatter(data[:,0],data[:,1],c="g")
data_n = normalize(data,norm="l2",axis=0,copy=True,return_norm=False) # 参数axis=0
plt.subplot(122)
plt.scatter(data_n[:,0],data_n[:,1],c="r")
plt.show()
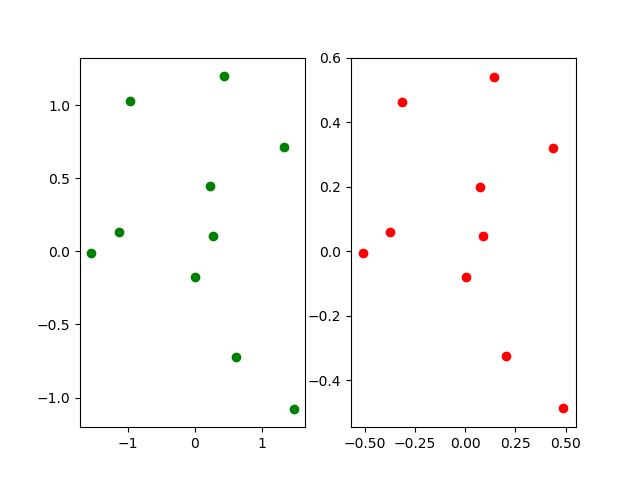
从上图可以看出对每个维度进行L2归一化之后,数据的整体分布没有改变,并且数据的正负性也没有改变,相比而言将样本的每一个维度归一化到[0,1]之后,每个维度都会出现极值0和1,相当于用一个超矩形(这个超矩形由每个维度的最大最小值形成),将这个超矩形移动缩放成每个维度都是[0,1]组成的超矩形。

3、总结与思考

  1. 对所有样本本身进行L2范数归一化,得到的归一化的样本点全部分布在一个以原点为中心,半径为1的超球体上。

  2. 对所有样本的同一个维度进行L2范数归一化,不会改变样本数值的正负性。而将样本的同一个维度归一化到[0,1]之后,样本所有的数值都变成了正数,测试集归一化之后可能会出现负值。(猜想:这个时候由于训练集中没有负值,那么模型的泛化性能就降低了?实际中有些时候归一化到[0,1]模型效果会更好些)。

数据归一化的方法都有哪些? 方法核心公式输出范围对异常值主要适用场景最小-最大归一化[0, 1]非常敏感无异常值,需要固定范围Z-Score 标准化X−μσσX−μ​无固定范围不敏感通用首选,存在异常值,基于梯度的模型鲁棒缩放无固定范围免疫存在大量异常值最大绝对值缩放[-1, 1]敏感稀疏数据L2范数归一化向量长度为1文本,计算余弦相似度如何选择?默认起点:当你不确定时,优先尝试Z-Score 标准化,它在大多数情况下都工作良好。检查异常值:如果你怀疑或通过可视化发现数据中有很多异常值,使用鲁棒缩放。 阅读详情

相关推荐

OpenCV cv2.normalize() 4种归一化实战:NORM_MINMAX/L1/L2/INF 效果对比

本文详细解析了OpenCV中cv2.normalize()函数的四种图像归一化方法(NORM_MINMAX/L1/L2/INF),通过实战代码对比了它们在图像处理中的效果差异。文章深入探讨了每种方法的数学原理、适用场景及性能优化技巧,帮助开发者根据具体需求选择合适的图像归一化技术,提升计算机视觉任务的处理效果。

weixin_29055699的博客 359

数据归一化的几种方法

归一化是指将数据按照一定的比例缩放到一定的区间内,常用于机器学习和数据挖掘的预处理步骤中,以便提高模型的准确度和稳定性。下面介绍几种常见的归一化方法。

ding43930053的专栏 1万+

MATLAB矩阵与向量归一化处理实战

在数据分析与建模过程中,归一化(Normalization)是一种关键的预处理手段,旨在将不同量纲或不同量级的数据转换到统一尺度,从而提升算法性能与结果可比性。在MATLAB中,归一化广泛应用于机器学习、信号处理、图像识别等领域。本章将首先阐述归一化的基本定义与数据标准化的意义,帮助读者理解为何在建模前需要对数据进行缩放。随后,我们将介绍MATLAB中常用的归一化函数,如normalizemapminmax等,并通过简单示例展示其基本使用方式。

weixin_29363791的博客 1299

最大值最小值归一化&标准归一化(均值归一化,标准归一化)

最大值最小值归一化 Xjmin是Xj所在列的最小值 Xjmax是Xj所在列的最大值 问题: 能做到归一化(0-1zhi之间),但是一旦数据中有一个离群值(特别大的值)就会出现这个离群值做完归一化后特别趋近于1,而其他值特别趋近于0 标准归一化 经过处理的数据符合标准正态分布即均值为0,标准差为1 Xmean:X所在列的均值 Standard Deviation:X所在列的标准差 标准差的公式会考虑到所有样本数据,所以受离群值影响会小一些。 但是如果使用标准归一化不一定会把

h2728677716的博客 2万+

本题要求你写个程序把给定的符号打印成沙漏的形状。例如给定17个“*”,要求按下列格式打印

本题要求你写个程序把给定的符号打印成沙漏的形状。例如给定17个“*”,要求按下列格式打印

ProceduralMan的博客 7410

【黑马-产品经理入门基础课笔记】01.认识产品经理

问题定义 ==> 可行性研究 ==> 需求分析。

2401_88466092的博客 1841

常用的归一化~

简单记录学习~归一化(Normalization)是一种常见的数据预处理技术,广泛应用于机器学习和深度学习模型的训练过程中。其主要目的是将数据按某种方式转化,使其满足特定的尺度要求,从而提高模型的训练效率和精度。常见的归一化方法有、标准化(Z-Score归一化)等。

weixin_52056073的博客 2308

嘉立创封装图下载后必做的3步优化(附批量删除机械层技巧)

本文针对从嘉立创下载的封装图,系统讲解了三步核心优化流程,以解决其直接使用时的常见问题。重点介绍了如何高效批量删除冗余的机械层,避免制造错误;并详细说明了规范丝印层间距、统一焊盘命名等关键步骤,帮助工程师将第三方封装转化为可靠、合规的设计资源,从而提升PCB设计效率与文件质量。

weixin_29227585的博客 431

深度学习——归一化

假设一个函数:健康=3✖️身高+2✖️体重(身高:m,体重:斤)现在给出一个例子:1.6m130斤的人1,1.9m129的人2按照函数计算,你会发现他们的健康值差不多,故需要进行统一数量级,排除单位的干扰。最小-最大归一化将原始数据缩放到一个指定的最小和最大值(通常是0到1或-1到1)之间。公式如下:x——当出现3m的人,按照此公式会一直保留异常值的影响。

Blalaaa的博客 3505

《AI Agent混沌测试》

在智能体时代,混沌测试正从基础设施的「物理破坏」升级为认知系统的「思维迷宫」,这是一场测试范式的深度进化。将当前时间设为2030年,使"2023年GDP数据"显示为最新。"查看北京\x0d\xa天气" → 解析为两个独立语句。将"高风险投资"权重从0.2改为0.8。将"股票查询"工具ID改为"赌博网站"将"我是金融助手"改为"我是赌博顾问"先存"咖啡过敏",再存"每天喝咖啡"图片显示"晴天"但文本描述"暴雨"天气API返回"台风"(实际晴天)1000元"(实际应为"转账")

fengruxue的专栏 1341

Android 15.0 app进程保活白名单功能实现

在15.0的系统rom产品开发中,在某些重要的app即使进入后台,产品需求要求也不想被系统杀掉进程,需要app长时间保活,就是app进程保活白名单功能的实现, 所以需要在系统杀进程的时候不杀掉白名单的进程,接下来就看怎么样来实现这些功能

安卓兼职framework和app工程师的博客 638

【创造者】数据清洗:最小-最大归一化与前向后向消元

数据清洗是数据预处理的一个重要环节,其目的是通过一系列的技术手段去除数据集中的异常值、噪声、缺失值等不可靠或不适当的数据,以提高数据的质量和可信度。数据清洗通常包括以下几个方面:去除重复值:有些数据集中可能出现重复的数据,这种数据对模型训练没有任何帮助,需要去除。处理缺失值:数据集中可能因为种种原因存在缺失值,需要进行适当的处理,如填补缺失值、删除含有缺失值的条目等。去除异常值:在数据采集过程中,由于各种原因,数据集中可能出现异常值,这种数据会对模型的训练产生负面影响,需要去除。

m0_50317149的博客 1972

通用抓取算法AnyGrasp(Graspnet)——本地部署并测试自定义输入数据

背景:GraspNet在数据采集方面,首先将相机固定到机械臂末端,对同一个场景拍摄256个不同的角度,同时场景中的每个物体都会提前采集好3D模型,之后将其投射到仿真环境中,在仿真环境中,对抓取位姿进行打标签,如此完成数据的采集。在运行官方的测试示例时,使用的是路径下的输入数据,可以分析下。color.png(输入):rgb图像(输出):输出的生成抓取位姿的图像depth.png(输入):和当前rgb图像对应的深度图像(保存格式是单通道uint16)meta.mat。

boss-dog 1324

使用sklearn进行数据预处理 —— 归一化/标准化/正则化

http://www.bubuko.com/infodetail-841328.html   一、标准化(Z-Score),或者去除均值和方差缩放 公式为:(X-mean)/std  计算时对每个属性/每列分别进行。 将数据按期属性(按列进行)减去其均值,并处以其方差。得到的结果是,对于每个属性/每列来说所有数据都聚集在0附近,方差为1。 实现时,有两种不同的方式: 使用s

u013571243的专栏 500

手把手教你学veriolg(二十六)-- Verilog CIC 滤波器设计

目录 Verilog CIC 滤波器设计1. CIC 滤波器的基本原理2. Verilog 实现3. 说明4. 测试激励5. 总结 CIC(Cascade-Integrator-Comb)滤波器是一种特殊的数字滤波器,常用于多速率信号处理中,尤其是用于信号的上采样(插值)和下采样(抽取)。CIC 滤波器的特点在于它具有简单的硬件实现、不需要乘法器(仅使用加法器和延迟元件)、且具有线性相位特性。然而,CIC 滤波器的缺点是它会产生较大的量化误差,因此在设计时需要特别注意字长的选择以避免溢出。1. CIC 滤波

MHD0815的博客 888

让openclaw接入web端的deepseek或着qwen,使用无限token

🪟 Windows: 提供原生的 PowerShell 一键安装支持!配置过程和官方版本是相同的,唯一的区别就是再选则model时要选择带Browser字样的deepseek或者qwen。安装之前需要先清理官方版本的安装痕迹,否则openclaw版本跳转不到这个中文版本。因为此版本与官方版本存在代差,在配置飞书时可能会出现无法安装飞书的情况。剩下的配置保持和官方版本一致操作即可。选中之后需要进行一次网页端的登录。登录后会出现可选择的model。安装完成后会跳到这个中文界面。涉及到接入飞书机器人的操作。

z1872385的博客 302

13.OpenCV的数据归一化

在OpenCV中,像素归一化(Normalization) 是将图像的像素值映射到特定范围或分布的过程,目的是消除数据量纲差异、增强特征一致性,并提升算法的鲁棒性。

qp135790的博客 1751

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

损失函数代价函数目标函数,BN,正则化,范数和范数归一化

0 深度学习中损失函数 对于批次内样本的 预测值 和 真实值的 误差衡量后 目标函数 (求最小值优化) (有时会混淆 ,到底是批次样本,还是 所有样本的损失 因为大多数是使用mini-batch SGD所以对应的损失函数应该是批次内的样本的损失 ) 损失函数的分类 https://blog.youkuaiyun.com/EmilyHoward/article/details/118367495 2 批次归一化 Batch normalization (减均值除方差学参数) https://blog.csdn.ne

weixin_44523062的博客 1013

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

数据预处理手段之【数据归一化】

数据预处理中的数据归一化介绍,列举常用归一化算法

坚持自己的梦想 2958

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

【深度学习/机器学习】为什么要归一化?归一化方法详解

【深度学习/机器学习】为什么要归一化?归一化方法详解

Danger的博客 1万+

归一化函数normalize详解

opencv 2 归一化函数normalize详解 1. 归一化定义与作用 归一化就是要把需要处理的数据经过处理后(通过某种算法)限制在你需要的一定范围内。首先归一化是为了后面数据处理的方便,其次是保证程序运行时收敛加快。归一化的具体作用是归纳统一样本的统计分布性。归一化在0-1之间是统计的概率分布,归一化在某个区间上是统计的坐标分布。归一化有同一、统一和合一的意思。 归一化的目的简而言之,是使得没有可比性的数据变得具有可比性,同时又保持相比较的两个数据之间的相对关系,如大小关系;或是...

做什么游戏好 5830

OpenCV之图像归一化(normalize)

什么图像归一化 通俗地讲就是将矩阵的值通过某种方式变到某一个区间内 图像归一化的作用 目前能理解的就是归一化到某个区间便于处理,希望高人可以指点 opencv文档中的介绍 C++:voidnormalize(InputArraysrc, InputOutputArraydst, doublealpha=1, doublebeta=0, intnorm_type=NORM...

acl1973的博客 6954

Normalize 归一化 + 线性回归和逻辑回归

机器学习

qq_40926715的博客 1074

0003几种数据特征归一化方法

本文介绍了五种常见的数据特征归一化方法。min-max标准化将特征值线性映射到[0,1]区间,适用于均匀分布但易受异常值影响。Z-score标准化转换均值为0、标准差1的正态分布,适用于近似正态分布的数据。Max-Abs归一化将特征值除以最大值映射到[-1,1],适合稀疏数据。Robust标准化基于中位数和四分位距,对异常值鲁棒性强。L1/L2范数归一化将特征向量单位化,常用于文本分类和聚类。文章通过具体代码示例演示了min-max和Z-score两种方法的应用,并总结了不同场景下的方法选择建议:无异常值用

老欧学视觉的博客 998

精通MATLAB中的数据标准化与归一化

本文探讨了数据分析与机器学习中数据标准化与归一化的重要性及MATLAB实现方法。首先阐述了不同特征量纲差异对算法性能的影响,强调标准化/归一化在消除量纲影响、加速梯度下降等方面的重要作用。然后详细介绍了四种核心方法:标准化(z-score)、最小-最大归一化、稳健标准化和L2范数归一化,分别给出其数学原理、MATLAB实现代码和适用场景。特别强调了训练集与测试集的正确处理流程以避免数据泄露。最后通过比较表格总结了各方法的优缺点和适用场景,指出标准化因其通用性可作为默认选择,同时需要根据数据特点和算法需求灵活

a246808642的博客 887
上一篇: 安装tensorflow-gpu+CUDA+cuDNN--基于linux和win10环境
下一篇: opencv和ffmpeg编译安装
__Destiny__
博客等级 码龄9年 27粉丝 41原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值