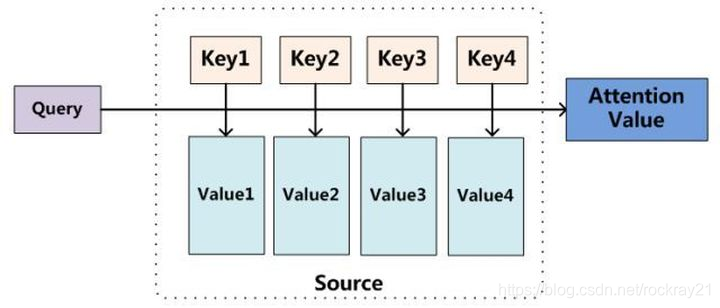
transformer

视觉Transformer综述 前几日,华为诺亚,北京大学,悉尼大学共同发表了论文《A Survey on Visual Transformer》,本文针对其重点内容进行翻译概括如下。文末附论文原文和本文完整版下载方式。 导言: Transformer是一种主要基于自注意力机制的深度神经网络,最初是在自然语言处理领域中应用的。受到Transformer强大的表示能力的启发,研究人员提议将Transformer扩展到计算机视觉任务。与其他网络类型(例如卷积网络和循环网络)相比,基于Transformer的模型在各种视觉... 阅读详情


参考资料:

1 模型原理详解:https://zhuanlan.zhihu.com/p/44121378
2 attention机制:https://zhuanlan.zhihu.com/p/43493999
3 详解transformer子结构的计算方式:https://zhuanlan.zhihu.com/p/59629215
4 算法流程:https://baijiahao.baidu.com/s?id=1651219987457222196&wfr=spider&for=pc
5 李宏毅课程PPT:https://blog.youkuaiyun.com/frank_ljiang/article/details/104382282
课程:https://www.bilibili.com/video/BV1J441137V6?from=search&seid=16273963478069518947
6 transformer在计算机视觉的应用:http://www.360doc.com/content/21/0116/16/32196507_957302113.shtml

前景:https://www.thepaper.cn/newsDetail_forward_10820015

文章:《Attention is all you need》

学习过程:
先学ref5李宏毅的课程,了解基础
通过ref2简单了解attention和rcnn的机制
ref1对模型(网络结构)进行了简介
ref3对子结构有详细的描述,偏学术
ref4详细地说明了算法流程,易懂

transformer模型结构:
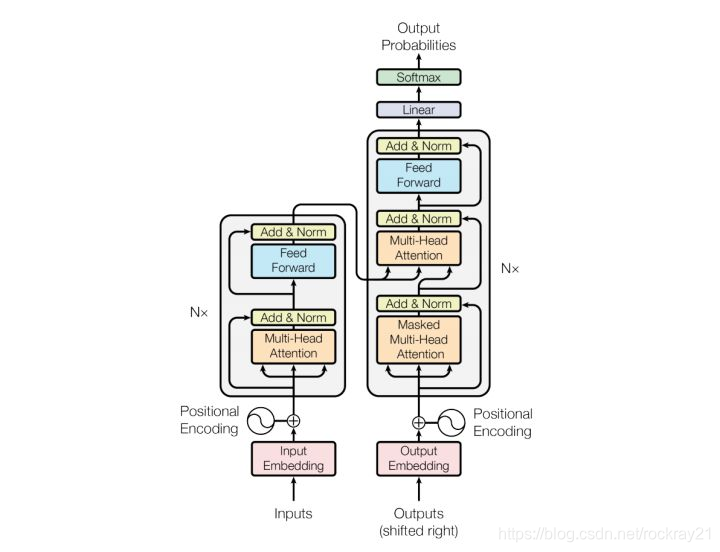
在这里插入图片描述

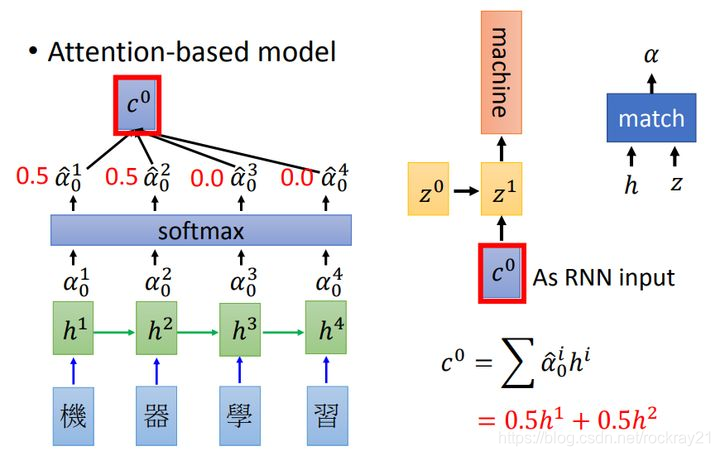
attention机制

在这里插入图片描述

在这里插入图片描述
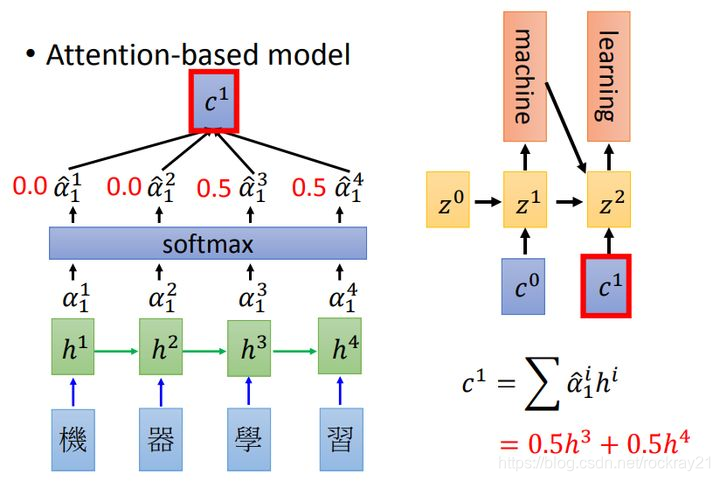
其中h 是编码器每个step的输出,z是解码器每个step的输出,计算步骤是这样的:
先对输入进行编码,得到h
开始解码了,先用固定的start token也就是 z最为Q,去和每个h (同时作为K和V)去计算attention,得到加权的c
用c作为解码的RNN输入(同时还有上一步的z),得到 z并预测出第一个词是machine
再继续预测的话,就是用 z作为Q去求attention:
在这里插入图片描述

ref3

selfattention计算过程
多头注意力机制
使用位置编码表示序列顺序
残差连接
解码器
linear层和softmax层

transformer总结

Transformer 与 RNN 不同,可以比较好地并行训练。

Transformer 本身是不能利用单词的顺序信息的,因此需要在输入中添加位置 Embedding,否则 Transformer 就是一个词袋模型了。

Transformer 的重点是 Self-Attention 结构,其中用到的 Q, K, V矩阵通过输出进行线性变换得到。

Transformer 中 Multi-Head Attention 中有多个 Self-Attention,可以捕获单词之间多种维度上的相关系数 attention score。

transformer在计算机视觉中是靠CNN提取特征,它完成目标检测和分割的任务

李宏毅课程

RNN无法被平行化,而CNN的视野有限
self_attention 通过q,k,v习得相互关系、语序等,得到预测结果
self_attention主要解决平行化和加速的问题
不同head关注点不同
注意区分layer norm和batch norm的区别

目前存在的疑问:
qkb怎算出来?

前景:
CNN用于提取特征,transformer完成推理并生成预测
目前主要是将用于NLP的transformer结构套在视觉任务上

Swin-transformer详解 swin transformer详解 阅读详情

相关推荐

Transformer入门Transformer和CNN之间的区别

跟风,听说最近Transformer很热,那肯定有其过人之处,今天大概看了一下最基础版的Transformer,简单说说体会和理解吧,不一定对,希望路过的大神指点。 要说是革命性的变革,那显然不是,Transformer和CNN以及RNN等都是机器学习的范畴,要说一点没变,那也不是,Transformer最大的特点,个人理解,是其Self-Attention机制,至于说这个机制是从哪儿得到的启发,暂不多说,搞过CNN的都知道。搞CNN的都习惯一个图片矩阵,那接下来的见解,我就以二维矩阵来说。 还是原文的

maum61的专栏 3万+

Transformer 模型详解

本内容主要介绍 Transformer 模型的具体实现。

weixin_46668960的博客 1194

Transformer 的可视化解释

Transformer 首次出现在 2017 年的开创性论文 《Attention is All You Need》 中,此后已成为深度学习模型的首选架构,为 OpenAI 的 GPT、Meta 的 Llama 和 Google 的 Gemini 等文本生成模型提供支持。除了文本之外,Transformer 还应用于 音频生成、 图像识别、 蛋白质结构预测,甚至 游戏中,展示了其在众多领域的多功能性。

言京的博客 2161

图解Transformer就这30页PPT,你们真不看啊

主要介绍了Seq2Seq模型,慢慢引出了transformer的整体模型架构,比较具体的介绍了编码器部分的数据处理过程,包括了位置编码、多头注意力机制、残差连接、Layer Norm以及前馈网络等基本结构。

Z4400840的博客 3512

Transformer详解

transformer详解

一去不复返的通信er 1721

transformer详解:transformer/ universal transformer/ transformer-XL

首发自彼得攀的小站 特别鸣谢刘陆琛@Mayouji在本文写作过程中的帮助 Attention机制在NLP领域的应用最早可以追朔到2014年,Bengio团队将Attention引入NMT(神经机器翻译)任务 [1]。之后更是在深度学习的各个领域得到了广泛应用:如CV中用于捕捉图像上的感受野;NLP中定位关键token/feature. 作为某种程度上可以称为当下NLP领域最强的特征抽取器的tran...

彼得.攀的blog 2448

Transformer——理论篇

序 在看这一篇之前,我希望你有一定的基础知识: 1. CNN,RNN,Transformer比较 2. Attention机制 3. self-attention机制 本文将紧接着前文的内容,对Transformer再进行一次探索 (本人之前很浅的看过一遍,当初没有写点理论的笔记,现在忘了还得重新翻资料) Transformer没有你想的那么难,我们开篇。 Who is it? 姓名:Tra...

qq_40240102的博客 2039

[Pytorch] Transformer+Siamese进行文本相似度分析

摘要 使用Transformer 代替RNN进行sentence-level context的encode Requirements Pytorch >= 0.4.1 Python >= 3.5 General Usage Transformer 用于进行encode的transformer我已经写好放在Git上了,小伙伴随意取用,别忘记点星星哟~ https://githu...

LeYOUNGER的博客 7288

【Transformer系列】深入浅出理解ViT(Vision Transformer)模型

【Transformer系列】深入浅出理解ViT(Vision Transformer)网络模型

IT菜鸟 6万+

Transformer实战(38)——视觉Transformer (Vision Transformer, ViT)

Transformer 在自然语言处理 (NLP) 领域取得了显著成就,在许多不同的任务中都表现出色。在本节中,我们将探索视觉 Transformer (Vision Transformer, ViT) 模型。正如 NLP 领域创建了多种模型一样,视觉领域也开发了多种模型,每种模型都为计算机视觉提供了新的视角。通过本节,将学习如何使用 ViT 等模型进行计算机视觉任务,了解基于 Transformer 的预训练计算机视觉模型的工作原理,以及如何针对特定任务进行微调。

盼小辉丶的博客 2890

Transformer 与 Vision Transformer

Transformer 最初提出是针对NLP领域的,并且在NLP领域大获成功。这篇论文也是受到其启发,尝试将Transformer应用到CV领域,研究发现Transformer应用于计算机视觉CV方面有着不输于卷积神经网络的强劲性能,一定程度上甚至比卷积神经网络更强。于是,初代Vision Transformer诞生了, 简称Vit。

1496

深入理解 Transformer:为什么我们需要 Transformer?

这几年,Transformer 几乎已经成为人工智能领域绕不开的一个名字。无论是我们熟悉的大语言模型,还是文本生成、机器翻译、图像理解、多模态模型,背后都能看到 Transformer 的影子。AttentionQ、K、VEncoderDecoderTransformer 好像就是由一堆复杂的矩阵运算拼起来的。如果只是停留在这个层面,我们确实可以把 Transformer 的公式背下来,甚至把代码实现出来。但是,这样并不能真正理解 Transformer。

htw250056的博客 2474

Transformer详解.pptx

本课件是对论文 Attention is all you need 的导读与NLP领域经典模型 Transformer 的详解,通过介绍传统Seq2Seq 模型及 Attention ,引入 Transformer 模型,并对其架构进行宏观微观的解读,然后详细介绍Transformer每一步的工作流程,最后给出 Transformer 在训练阶段的细节提要,以及推理阶段的解码策略等内容。

TNT:Transformer in Transformer

TNT:TransformerinTransformer

Together_CZ的博客 2009

Transformer深度讲解,进一步给出其在NLP和CV下的发展,共95页ppt,全网最好的讲解,没有之一

1.Transformer背景介绍 2.Transfromer整体架构 3.Transformer输入部分 4.Transfromer的编码器 5.Transfromer的解码器 6.Transformer输出部分 7.Transfromer其他部分 1.GPT-1 和 Bert 2.GPT-2 3.GPT-3 Transformer在深度学习环境下背景: 17年自Attention is all you need提出后,开始在NLP(自然语言处理)领域大放异彩 20年后,开始在CV领域发光,到现在基本一统天下了 其在NLP和CV领域下的许多分类、分割、检测等任务下均刷榜 总结一下Transformer模型。 从论文本身来看,其最大的创新在于提出的注意力机制,即多头注意力层,并嵌入到一个模块化可堆叠的模型结构中。一开始Transformer被用于机器翻译,但它也能够用在几乎所有的NLP任务上。自它之后,整个深度学习重心开始转向NLP方面。 4..InstructGPT和ChatGPT 1.VIT 2.Clip与DallE-1 3.DiffusionModel和DallE-2

Qualcomm工具的使用

简介   由于我们公司主要是以高通平台为主,所以工具的使用是必不可少的,包括QPST、QRCT3、QXDM、QDART等。   高通工具顾名思义就是,对于高通平台的软件开发进行软件的烧录,软件的调试,软件的Log的抓取和分析过程,像我们平常用的大致就是烧版本、改NV、制作QCN、然后校准、强发强收等操作。 QPST   QPST主要是用来做一些参数的配置,包括EFS文件的编辑,QCN的导入和备份与...

Jimmy 2万+

Transformer和swin-transformer

首先将图片输入到Patch Partition模块(它的作用就是将一张图像,拿着刀切成一块块的小图像中进行分块,即每4x4相邻的像素为一个Patch,然后在channel方向展平。假设输入的是RGB三通道图片,那么每个patch就有4x4=16个像素,然后每个像素有R、G、B三个值所以展平后是16x3=48,所以通过Patch Partition后图像shape由[H, W, 3]变为[H/4, W/4, 48]。然后在通过层对每个像素的channel数据做线性变换,由48变成C,即图像shape再由。

2301_77102499的博客 2972

离线安装 nvidia-docker2(nvidia-container-toolkit)

很多时候大家都有用docker使用gpu的需求,但是因为网络等原因不是那么好用,这里留了一个给ubuntu的安装包,网络好的话也提供了在线安装方式。

father_yingying的博客 1181

Transformer端侧模型压缩——Mobile Transformer

随着Transformer模型在NLP、ASR等序列建模中的普及应用,其在端侧等资源受限场景的部署需求日益增加。经典的mobile-transformer结构包括evolved tansformer、lite-transformer、mobile-bert、miniLM等模型,借助结构改进、知识蒸馏等策略实现了transformer模型的小型化、并确保精度鲁棒性。 The Evolved Transformer Paper Link:https://arxiv.org/abs/1901.1111.

AI Flash 6942

SOPHGO SG2000/SG2002 AI SoC异构架构解析与应用

异构计算架构通过整合不同指令集核心(如RISC-V、Arm和8051)实现性能与功耗的平衡,是现代嵌入式系统和AIoT设备的关键技术。其原理是根据任务特性分配至最适合的计算单元,例如通用计算使用高性能核心,实时任务交由专用核心处理。这种架构在智能视觉、工业检测等场景具有显著优势,能高效处理AI推理、多媒体编解码等任务。SOPHGO SG2000系列SoC采用创新的三核异构设计,集成了0.5-1TOPS的NPU加速器,支持Linux/Android/FreeRTOS多系统并行运行。开发中需注意核心间的IPC通

weixin_30684743的博客 355

基于JAVA的GB28181实现之SIP服务核心组件解析

本文深入解析了基于JAVA的GB28181标准中SIP服务的核心组件实现,包括协议栈选择、消息处理引擎、事务管理器等关键技术点。通过实战案例分享海康威视、大华设备的特殊处理技巧,并提供性能优化和常见问题排查指南,帮助开发者高效构建稳定的视频监控系统。

weixin_30892037的博客 264
上一篇: MADRL(多智能体深度强化学习)
rockray21
博客等级 码龄9年 28粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值