NLP 数据不平衡问题

处理不平衡数据的五种方法 大家好,我是小寒。 原文链接 你是否曾经遇到过这样的问题:你的数据集中的正类样本非常小,以至于模型无法学习? 「在这种情况下,仅通过预测多数类就可以获得相当高的准确度,但无法捕获少数类。」 这样的数据集很常见,被称为「不平衡数据集。」 不平衡数据集是分类问题的一种特殊情况,其中类之间分布不均匀。通常,它们由两个类组成:多数(负)类和少数(正)类。 在不同的领域都会有这样的数据集,例如: 「金融」:欺诈检测数据集的欺诈率通常约为 1%-2%「广告服务」:点击预测数据集的点击率也不高。「运输」/「航空 阅读详情

数据不平衡

指的是不同类别的样本差异非常大,或者少数样本代表了业务的关键数据,需要对少量样本的模式有很好的下也许。
其中分布不均衡分为两种:

  1. 大数据分布不均衡:数据规模较大,某类别样本占比较小。
  2. 小数据分布不均衡:整体数据规模较小,某类别的样本数量也少。

三种解决方式

1.欠采样

在少量样本数量不影响模型训练的情况下,可以通过对多数样本欠采样,实现少数样本和多数样本的平衡。(减少多数样本的样本量)

1.1 随即删除

1.2 原型生成(PG算法)

2.过采样

在少量样本数量不支撑模型训练的情况下,可以通过对少量样本过采样,实现少数样本和多数样本的均衡。(增加少数样本的样本量)

2.1 随即复制

2.2 样本构建(SMOTE算法)

3. 模型算法

3.1 Cost Sensitive算法

通过引入有倚重的模型算法,针对少量样本着重拟合,来提升对少量样本的特征学习。

3.2 Focal Loss算法(重点)

通过减少易分类样本的权重,是的模型在训练时更专注于难分类的样本。

NLP中数据增强

UDA

一种半监督学习方法,减少对标注数据的需求,增加对未标注数据的利用

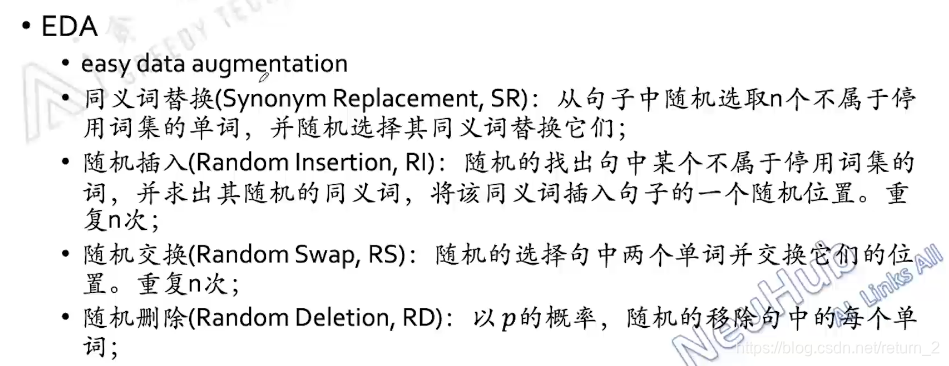
EDA
在这里插入图片描述

NLP—6.数据不平衡处理 文章目录一、数据不平衡问题二、常见处理方法1.数据相关处理1.1 欠采样1.2 过采样2.模型相关处理2.1 模型算法 – Cost Sensitive算法2.2 模型算法 – MetaCost算法2.3 模型算法 – Focal Loss3.评价指标相关处理三、自然语言处理中的数据增强 一、数据不平衡问题   所谓的数据不平衡指的是不同类别的样本量差异非常大,或者少数样本代表了业务的关键数据(少量样本更重要),需要对少量样本的模式进行很好的学习。样本类别分布不平衡主要出现在分类相关的建模问题上。 样本类别 阅读详情

相关推荐

NLP中长尾、数据不均衡问题可落地解决方案

在真实的工业场景中,通常都会遇到长尾问题(部分类别数据很多,部分类别数据量极少,如下图所示)。例如比较典型的风控场景,负样本通常都是极少的,甚至有些负样本需要人工造。对于这样的场景,模型对于样本较少的类别拟合能力是不足的,甚至无法满足上线的要求。 目前比较通用的解决方案即采样和加权,但是如何采样,是欠采样还是过采样,如何加权权重怎么设置,这些都包含了较多的方法。本文将会先从这两个方案出发,再扩展到一些其它比较通用、有效的nlp长尾问题解决方案 采样 采样的方法主要是两种,过采样和欠采样。欠采样是指从过多的

u012526436的博客 5674

数据不平衡的常用处理方法

数据不平衡处理 常见处理方法 1. 欠采样(下采样、Under-sampling、US) 减少分类中多数类样本的样本数量实现样本均衡。 随机删除 随机删除一些多量样本。 PG算法(Prototype Generation) 在原有样本的基础上生成新的样本来实现样本均衡。 2. 过采样(上采样、over-sampling ) 增加分类中少数样本的数量来现样本均衡。 随机复制 简单复制少数类样本形成多条记录。缺点:可能导致过拟合问题。 样本构建 SMOTE(Synthetic minori

u012744245的博客 1万+

dice系数 交叉熵_数据不平衡问题成“千年”难题,看ACL新方法Dice Loss如何有效解决!...

文章来源于微信公众号:AI科技评论原文链接:请点击文章仅用于学习交流,如有侵权请联系删除本文介绍的是 ACL 2020 论文《Dice Loss for Data-imbalanced NLP Tasks》,论文作者来自香侬科技、浙江大学。作者 | 香侬科技编辑 | 丛 末在本文中,我们提出用Dice Loss缓解大量NLP任务中的数据不平衡问题,从而能够提高基于F1评分的表现。Dice Los...

weixin_39765796的博客 1232

数据不平衡问题都怎么解?

作者|Chilia整理|NewBeeNLP本文主要讨论两种不平衡问题。一是数据的类别本来就不平衡,比如在广告CTR预估中,可能90%的广告都不会被点击,只有一少部分被点击;...

Kaiyuan_sjtu的博客 6219

零基础入门nlp--数据读取与数据分析

1、通过pandas的read_csv读取数据 #读取数据 import pandas as pd train_df = pd.read_csv(r'Data/nlp/train_set.csv', sep='\t', nrows=100) 显示前5条数据 2、数据分析的三个目标: 赛题数据中,新闻文本的长度是多少? 赛题数据的类别分布是怎么样的,哪些类别比较多? 赛题数据中,字符分布是怎么样的? 句子长度分析 在赛题数据中每行句子的字符使用空格进行隔开,所以可以直接统计单词的个数来得到

beautiful_well的博客 482

自然语言处理之情感分析:Naive Bayes:情感分析中的数据不平衡问题处理

Naive Bayes算法是一种基于贝叶斯定理的分类算法,其“朴素”之处在于它假设特征之间相互独立。在情感分析中,Naive Bayes算法通常用于文本分类,将文本分类为正面、负面或中立情感。该算法的计算效率高,对小数据集表现良好,且能够处理高维特征空间,因此在NLP领域有着广泛的应用。在自然语言处理(NLP)领域,尤其是在情感分析中,数据集的不平衡性是一个常见的问题。不平衡数据集指的是数据集中不同类别的样本数量存在显著差异的情况。

zhubeibei168的博客 875

Dice Loss for Data-imbalanced NLP Tasks (Dice Loss,替代cross entropy(CE)处理数据不平衡问题)

https://github.com/ShannonAI/dice_loss_for_NLP 通过定义Dice Loss,替代cross entropy(CE)处理数据不平衡问题。 问题 在样本不平衡的情况中,主要有以下两种难以克服的难点 the training-test discrepancy: 如果不能很好的平衡样本标签,那么模型学习过程通常会朝着有更多标签的类别收敛。 the overwhelming effect of easy-negative examples: 如果容易判...

weixin_48185819的博客 946

自然语言处理NLP星空智能对话机器人系列:NLP on Transformers 101

11,Bert的CLS能够有效的表达Sentence Embeddings吗? 12,使用BPE (Byte-Pair Encoding) 进行Tokenization对于Cross-lingual语言模型的意义是什么?是否会有问题及如何改进? 13,如果使用Transformer对不同类别的数据进行训练,数据集有些类别的数据量很大(例如有10亿条),而大多数类别的数据量特别小(例如可能只有100条),此时如何训练出一个相对理想的Transformer模型来对处理不同类别的任务? 14,如何使用使用多种类小

大模型与Agent智能体 651

推荐文章:探索自适应骰子损失(Self-Adjusting Dice Loss)——不平衡数据NLP任务的利器

推荐文章:探索自适应骰子损失(Self-Adjusting Dice Loss)——不平衡数据NLP任务的利器 在深度学习尤其是自然语言处理(NLP)领域,面对数据不平衡问题时,传统的损失函数往往显得力不从心。今天,我们将一起揭开一个创新解决方案的面纱——Self-Adjusting Dice Loss,这是对论文《Dice Loss for Data-imbalanced NLP Tasks》的...

gitblog_00059的博客 1193

Shopee前端反爬三要素:x-sap-Ri、x-sap-Sec与af-ac-enc-dat深度解析

电商前端反爬机制本质是运行时环境可信验证,其核心在于动态生成的请求指纹、会话签名与行为加密载荷。这类机制不依赖静态Token,而是基于浏览器真实交互(如鼠标轨迹、页面可见性、时间精度)实时计算,体现JS运行时环境不可模拟性。技术价值在于将风控前移至客户端,大幅提升自动化绕过成本;典型应用场景包括商品价格监控、竞品数据采集与合规爬虫开发。本文聚焦Shopee实战案例,深入拆解x-sap-Ri(设备+行为哈希指纹)、x-sap-Sec(动态密钥签名)及af-ac-enc-dat(AES加密行为载荷)三大字段的生

weixin_29015127的博客 406

MuJoCo新手必看:5分钟搞定你的第一个机器人仿真(附Python代码)

本文为零基础新手提供了一份详尽的MuJoCo物理仿真引擎入门指南。从环境搭建、MJCF模型文件解析,到编写Python控制代码,手把手教你5分钟内创建并运行第一个机器人仿真。内容涵盖双摆模型控制与自定义四轮小车构建,帮助你快速掌握这一高性能开源工具,迈出机器人学与强化学习仿真的第一步。

weixin_29032489的博客 656

入门NLP-task2-数据探索

title: 入门NLP-task2-数据探索 date: 2020-07-22 20:31:57 tags: [‘NLP’, ‘自然语言处理’] categories: ‘自然语言处理’ –真的没有图片– 非结构化数据的数据探索不像结构化数据,结构化数据可以通过数据探索得到很多有用的信息,非结构化数据的数据探索得到的信息有限。 仅仅能够得到字符出现的频率、次数,新闻的长度等等 先观察新闻长度 train_df['text_len'] = train_df['text'].apply(lambda x:.

Cherish_x的博客 386

STM32驱动HC-SR04超声波模块:两种精准测距方案详解

本文详解STM32驱动HC-SR04超声波模块的两种精准测距方案:定时器中断计数法和外部中断边沿检测法。涵盖硬件连接、代码实现与优化技巧,帮助开发者根据精度和复杂度需求选择合适方案,提升超声波测距在嵌入式项目中的稳定性和准确性。

g5h6i的博客 684

推荐开源项目:不平衡损失函数实现库——unbalanced_loss

推荐开源项目:不平衡损失函数实现库——unbalanced_loss 在这个充满挑战的自然语言处理(NLP)领域中,数据不平衡问题一直是一个棘手的障碍。为了帮助开发者更好地应对这类问题,我们为您推荐一个非常实用的开源项目:unbalanced_loss,它集成了多种适用于NLP任务的不平衡损失函数实现,包括focal_loss、dice_loss、DSC Loss和GHM Loss等。 1、项目介...

gitblog_00030的博客 425

EtherCAT用TwinCAT 3跑DC报0x2C或者0x1A错误码

EtherCAT用TwinCAT 3跑DC报0x2C或者0x1A DC报错 ///////////////////////////////////////////////////////////////////////////////////////// /** \brief Checks communication and synchronisation variables and update AL status / AL status code if an error has occurr

PI_sunyang的博客 5307

基于Xilinx K7-410T的高速DAC之AD9129开发笔记(一)

引言:从本文开始,我们介绍下项目中设计的并行LVDS高速DAC接口设计,包括DAC与FPGA硬件接口设计、软件设计等。项目设计高速DAC采用了ADI公司的AD9129,该芯片最大更新速率5.7Gsps,该芯片在宽带通信应用、LTE、雷达信号产生、干扰机等领域有广泛应用。

FPGA_Designer 2535

数据不平衡问题——SMOTE算法赏析

春节前后好久没有总结问题了,这一段时间一直在做NLP的文本分类(二分类)问题,遇到了各种问题 。分别如下: 1、数据打标问题。运营人手不够可把兄弟们累坏了,是我给兄弟们分的任务,别打我嘿嘿。      打标问题主要是业务不熟悉,主观上分类很容易分错,在分类的时候一定要让运营方来确定分类标准。 2、数据不平衡问题。T:F为1:10,重新筛选样本以后达到了T:F为1:17。      实在是数...

家有代码初写成 的博客 2万+

工商银行软件开发中心数据安全监测溯源防护体系建设成果及展望

结合业界先进溯源理念和我行管理要求,依托大数据、分布式搜索分析引擎等技术,构建PB级海量数据加工分析和小时级快速核验、检索、溯源手段(如图6所示),支撑6种客户敏感信息关键要素的单一或组合溯源,形成行之有效的数据安全溯源流程,配套落地自动化快速泄露样本真实性核验和灵活高效的溯源能力,通过数据相关属性的自动化分析,实现追踪泄露源头、明确泄露路径的目标,为有效应对数据安全事件,降低和消除风险与不良影响,开展事后追责处置工作提供体系化解决方案。提高数据排查的自动化程度和排查效率,降低人工成本。

银行信息系统应用架构详解 226

msra数据集_ACL2020 | 香侬科技提出使用Dice Loss缓解数据集数据不平衡问题

论文标题:Dice Loss for Data-imbalanced NLP Tasks论文作者:Xiaofei Sun, Xiaoya Li, Yuxian Meng, Junjun Liang, Fei Wu, Jiwei Li论文链接:https://arxiv.org/pdf/1911.02855.pdf今天,我们将给大家介绍香侬科技收录于ACL2020的第二篇文章, 题目为Dice Lo...

weixin_39990401的博客 348

【深度学习|Transformer模型学习】什么是前馈神经网络(Feed-Forward Neural Network)?将前馈神经网络中的全连接层变成1*1卷积层会有什么样的效果?

【深度学习|Transformer模型学习】什么是前馈神经网络(Feed-Forward Neural Network)?将前馈神经网络中的全连接层变成1*1卷积层会有什么样的效果?

985小水博的摸鱼日常 1376

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

如何解决NLP分类任务的11个关键问题:类别不平衡&低耗时计算&小样本&鲁棒性&测试检验&长文本分类 JayLou娄杰

原文链接:https://zhuanlan.zhihu.com/p/183852900 欢迎关注《高能AI》公众号~声明:文中观点谨代表笔者个人立场,盲目搬运有风险~在2020这个时间节点,对于NLP分类任务,我们的关注重点早已不再是如何构造模型、拘泥于分类模型长什么样子了。如同CV领域当前的重点一样,我们更应该关注如何利用机器学习思想,更好地去解决NLP分类任务中的低耗时、小样本、鲁棒性、不平衡、测试检验、增量学习、长文本等问题。本文以QA形式探讨了以下问题:Q1: 如何科学地构建分类标签体系?Q2: 标

古月哲亭 1677

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

ICML 2021 (Long Oral) | 深入研究不平衡回归问题

点击上方“视学算法”,选择加"星标"或“置顶”重磅干货,第一时间送达作者丨Yuzhe Yang@知乎(已授权)来源丨https://zhuanlan.zhihu.com/p...

zandaoguang的博客 754

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

NLP任务样本数据不均衡问题解决方案的总结和数据增强回译的实战展示

目录 一、数据层面 1、欠采样(under-sampling) 2、过采样 二、算法层面 1、权重设置 2、新的损失函数——Focal Loss 三、评价方式 四、数据增强实战——回译(back translate) 1、Translator 2、TextBlob 3、百度翻译API 在做NLP分类标注等任务的时候,避免不了会遇到样本不均衡的情况,那么我们就...

HUSTHY的博客 7017

文本数据分析:标签数量分布

在自然语言处理(NLP)和机器学习项目中,文本数据分析是一个关键步骤。了解数据集中标签的数量分布对于评估数据集的平衡性和模型训练的有效性至关重要。本文将介绍如何使用Python进行标签数量分布的分析,并解释其重要性。

weixin_47012180的博客 565
上一篇: NLP 模型验证
下一篇: NLP 神经网络初步
内蒙金刚狼
博客等级 码龄6年 4粉丝 28原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
