gcc利用likely()优化分支跳转结构

GCC likely和unlikely(__builtin_expect)的作用 在Linux2.6内核中,看到一对奇怪的函数,likely(), unlikely()。 追踪回去,发现其实是一对宏,如下实现: #define likely(x) __builtin_expect((x), 1) #define unlikely(x) __builtin_expect((x), 0) 查了一下是这样说的: 例如: if( likely(val)) if( unlikely (val)) 他们都等于if(val),也就是在理解上来说,是等价的。 那么为什么要这样用呢? __ 阅读详情

在linux编程中,有可能会在条件判断中见到likely(expr)和unlikely(expr)的用法,它们实际上是宏定义:

#define likely(x)  __builtin_expect((x), 1)
#define unlikely(x)  __builtin_expect((x), 0)

是在告诉编译器,这个表达式为true的概率是大还是小,这样能指导编译器在处理分支判断的跳转时,更好地利用程序的空间局部性(CPU对指令的cache)。

下面举个例子来说明编译器具体是怎么优化likely和unlikely的:
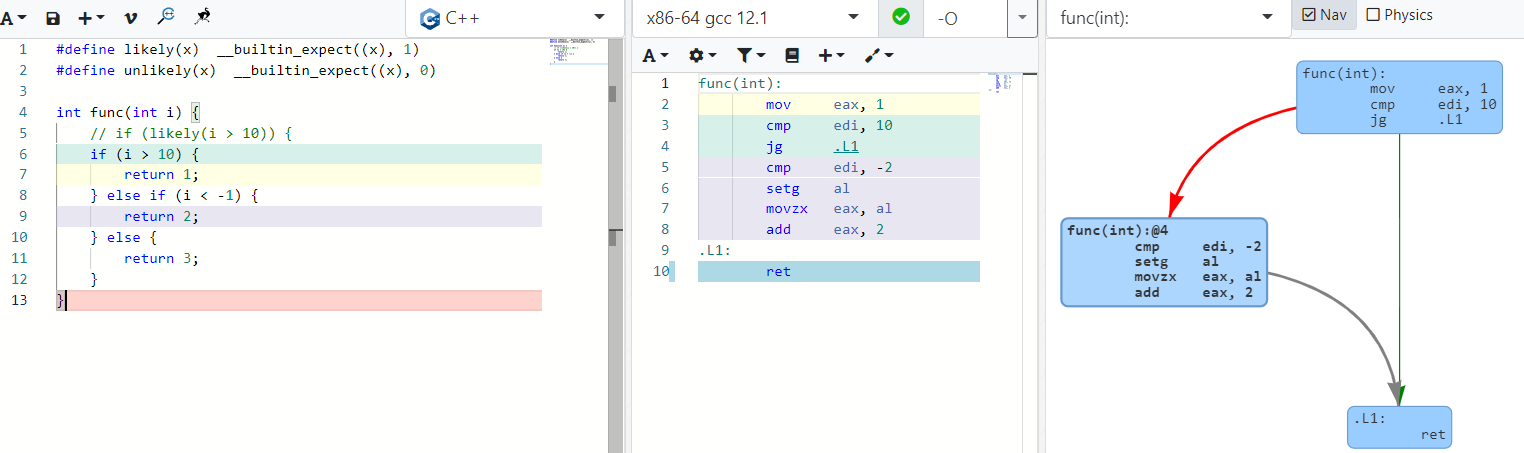
image-20220515163125028

如果没有加likely,对于第一个判断,如果i > 10成立,会跳转到.L1这个离当前代码块较远的位置(本测试程序的例子还好,实际的程序中可能会比较远),可能.L1的代码并没有在cache中。

如果给i > 10加上likely,
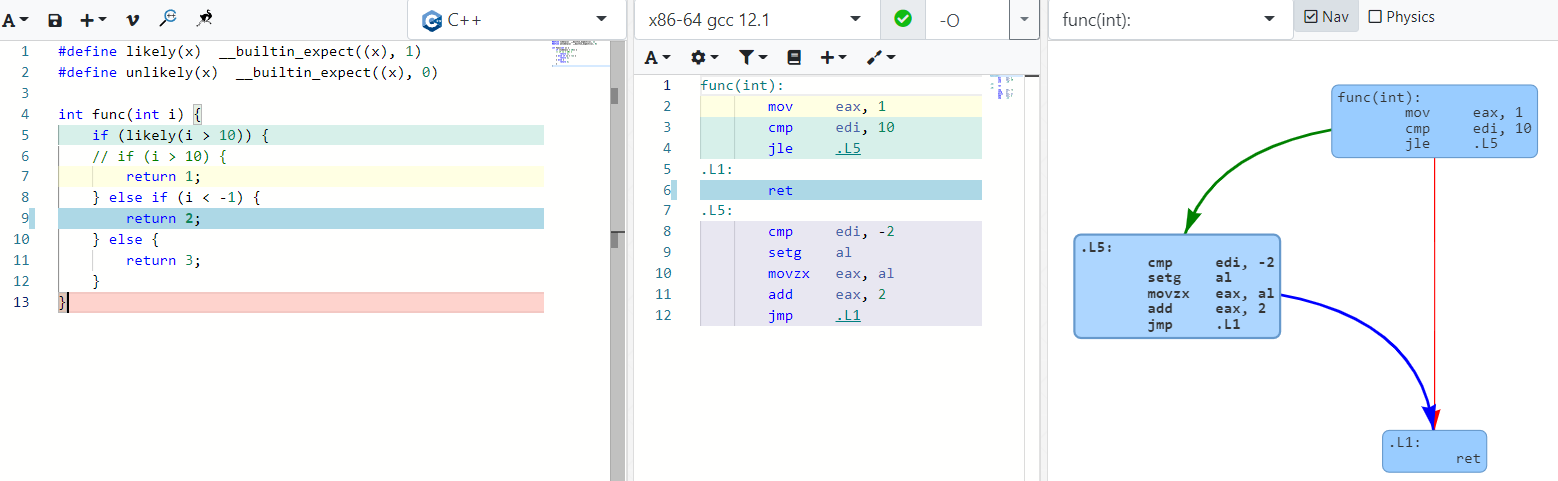
image-20220515163457873

由于认为i > 10的概率较大,因此若表达式为true,则顺序执行到.L1,不会跳转到其他代码块,.L1的代码很可能在cache内,充分利用了指令cache。

如果大家对文章内容有疑问或建议,欢迎评论区留言,我们可以一起讨论,共同提高
转载请标明原作者:https://blog.youkuaiyun.com/qq_36622751

关于gcc的__builtin_expect分支预测优化 在阅读 sylar框架源代码上看到了使用 __builtin_expect 的宏定义,一时有所不解,于是查找了很多资料,对并其做整理。 Linux 下的很多代码我们经常看到 likey() 和 unlikely() 这两个宏,通常这两个宏定义是如下这样的形式: #define likely(x) __builtin_expect(!!(x), 1) #define unlikely(x) __builtin_expect(!!(x), 0) 可以看出这两个宏都是使用了函数 __builti 阅读详情

相关推荐

C++(20):通过[[likely]]和[[unlikely]]优化编译switch

【代码】C++(20):通过[[likely]]和[[unlikely]]优化编译switch。

风静如云的博客 1155

[C++] 分支优化

主要介绍unlikely和likely的使用,用于提高分支预测的概率,提高执行效率

头狼博客 1058

医药行业新零售项目数据分析报告——基于Excel的分析与可视化

不同平台客户支付金额用数字+百分比展示更直观。各大区支付金额分析较为粗浅,后续可加入不同大区人数、配送费等进行细分分析。图表略微单一,可采用组合图,运用两个及以上维度对数据进行分析。数据来源本项目数据来源于某机构的项目案例,以上分析内容均为本人原创,不涉嫌抄袭。原做项目,新平台首发。

2401_84213513的博客 1495

【ARM 嵌入式 编译系列 4.1 -- GCC 编译属性 likely与unlikely 学习】

likely和unlikely是GCC编译器提供的一种代码优化特性,这两个宏用于告诉编译器某个条件判断的结果是真还是假的可能性更大。在编写代码时,如果我们已经知道某个条件判断的结果大部分情况下都是真或者假,就可以使用likely和unlikely宏来进行标记,编译器会根据这个提示进行优化,使得代码运行更高效。10这里的是GCC的内建函数,用于提供编译器关于表达式结果的预期值。// 大部分情况下,x都大于0} else {// 一般情况下,这里的代码不会执行= 0)) {

CodingCos的博客 1709

半导体硅制造工艺

抛光液和硅片的反应速度很快,只要稍一停留,立刻便会腐蚀,因此取片时,不能在表面上留下抛光液,必须紧接着水抛,直至抛光液被全部冲去,再将片子取下。由于晶圆制造过程有各种各样的晶圆固定器和自动设备,需要严格的直径控制以减少晶圆翘曲和破碎,而单晶硅棒的外径表面并不平整且直径也比最终抛光晶片所规定的直径规格大,因此需要通过外径滚磨获得较为精确的直径。胶体的颗粒直径比磨料的颗粒直径小一个数量级,且硬度与硅相当,因此它比用磨料的机械抛光表面损伤更小,抛光出的硅片表面具有高度的镜面光洁。不受材料导电类型和电阻率的影响。

pgpaojiao的博客 2240

京东技术产品经理面试全记录:从简历投递到一面45分钟实战复盘

本文深度复盘京东技术产品经理面试全流程,从策略准备、思维题拆解、项目阐述到反问谈判,提供了一套可演练的求职策略体系。文章强调该岗位需具备横跨技术与商业的枢纽能力,并通过“QQ分组vs微信标签”等案例,剖析了产品思维与结构化表达在面试中的关键作用,助力候选人将紧张转化为掌控感。

weixin_29275257的博客 629

GCC——分支预测(likely和unlikey)

最近在拜读一个项目源代码的过程中,发现了一个有意思的GCC特性,现将这个特性总结如下: 开发人员在开发服务的过程中,可以根据业务逻辑的特性来判断当前的条件语句被执行的概率情况,经常被执行到的代码片段可以紧邻顺序执行的代码片段后边,偶尔被执行到的条件代码片段被放到其他代码片段,从而减少代码在顺序执行过程中的代码上下文的跳转次数,达到提高程序执行效率的目的。这种方式的优化,需要严重的依赖...

xidajiancun 479

学习STM32的无人机控制

下面是一个基于STM32的无人机控制的简单示例代码,包括四旋翼的PID控制、遥控器信号解析和电机控制。本示例以STM32F103系列为例,使用Keil C编译器进行开发。

qq_67153941的博客 706

Linux C/C++编程:likely和unlikely(__builtin_expect)

Linux C/C++编程:likely和unlikely(__builtin_expect) 看linux源码或者一些优秀组件的源码,经常碰到likely和unlikely, 其实很简单,无非就是显式告诉编译器怎么去优化。 #define likely(x) __builtin_expect((x), 1) #define unlikely(x) __builtin_expect((x), 0) 使用 if( likely(val)) if( unlikely (val)) 那么为什么要这样

sinat_35945236的博客 706

Ansys HFSS 中的同轴电缆仿真

准确模拟它们的行为对于确保 RF 系统的最佳性能至关重要。在本博客中,我们将介绍在 HFSS 中设置同轴电缆仿真并绘制插入损耗、回波损耗和电场分布的过程。将波端口分配给同轴线的两端以激励模型,并定义了从 1 GHz 到 20 GHz 的频率扫描以评估其宽带性能。铜分配给内部导体,铝分配给外部导体。介电区域使用 PTFE 定义,其相对介电常数为 2.1,损耗角正切为 0.00022。仿真完成后,结果用于绘制整个频率范围内的回波损耗和插入损耗。此外,电介质内的电场分布也被绘制和动画化。

jkh920184196的博客 1907

CANoe LIN一致性测试之干扰测试Test moudle_LIN Disturbance Block

注意:相邻两个显隐性不同的bit不允许干扰,例如我同时选择bit6和bit7,相邻两个同显隐性的bit允许干扰,例如当我选择bit3和bit4,项,这里我选择ID:为0x2F(PID:0x6F)的frame。需按照具体测试规范实施干扰项,帧头和数据段都可以实现干扰。最近发现一个干扰测试模块,下面是一些具体使用方法。选择干扰项:PID的奇偶校验位(一致性测试干扰测试之手动测试。一个待测试frameD。

yuanyikangkang的博客 3410

linux内核中的likely()和unlikely()宏的作用

在看linux内核代码的时候,经常会看到likely(x)和unlikely(x)宏的使用。那这两个宏有什么作用呢? 这两个宏在内核中的定义如下: # define likely(x) __builtin_expect(!!(x), 1) # define unlikely(x) __builtin_expect(!!(x), 0) 可见这里使用了gcc的内建函数__builtin_exp

落尘纷扰的专栏 2万+

Python 爬虫实战:在房天下抓取房产信息,分析房价走势

通过本次 Python 爬虫实战,我们成功地从房天下爬取了房产信息,并进行了存储、处理、分析和可视化展示。在这个过程中,我们不仅掌握了爬虫技术的基本应用,还学会了如何对动态加载的数据进行处理和分析。然而,本次爬虫任务也存在一些局限性,例如仅爬取了部分区域的房产数据,且未对房产的图片和视频内容进行分析。在未来的工作中,我们可以进一步优化爬虫程序,爬取更多区域的房产数据,并深入分析房产的多媒体内容、用户行为模式等,为购房者和房地产从业者提供更有价值的数据支持。

u014481728的博客 1367

内核中的 likely() 与 unlikely()

<br />内核中的 likely() 与 unlikely()<br />在 2.6 内核中,随处可以见到 likely() 和 unlikely() 的身影,那么为什么要用它们?它们之间有什么区别?<br />首先要明确:<br />            if(likely(value)) 等价于 if(value)<br />            if(unlikely(value)) 也等价于 if(value)<br />也就是说 likely() 和 unlikely() 从阅读和理解代码的

kikikind的专栏 2926

路径规划 | 图解粒子群(PSO)算法(附ROS C++仿真)

粒子群算法(PSO)的基本思想是模拟鸟群觅食机制,将鸟类的觅食方向分为自我认知部分和社会部分,个体自主探索群体周围空间的同时,也随着群体的主流方向前进,不断逼近最优目标。本文详解PSO算法基本概念,并给出ROS C++实现加深理解

FRIGIDWINTER的博客 2616

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

C语言进阶——likely和unlikely

写C语言程序还没用过likely和unlikely? 那你就out了,跟我一起玩转起来吧!

穿越临界点的博客 1万+

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

linux内核中likely与unlikely

前言   内核版本:linux 4.13   在linux内核中,经常可以看见if( likely(x))或if( unlikely(x))语句,那么likely和unlikely是什么意思呢?本文将对likely和unlikely进行一些讨论。 likely和unlikely 参考/include/linux/compiler.h */ # define likely(x) __bu...

夜风的博客 2万+

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

供编译器进行分支预测,是的编译器对代码进行优化,减少指令跳转代

GCC提供内建函数之 __builtin_expect 分支预测,目的是将“分支转移”的信息提供给编译器,这样编译器可以对代码进行优化,以减少指令跳转带来的性能下降。 这个指令是gcc引入的,作用是允许程序员将最有可能执行的分支告诉编译器。这个指令的写法为:__builtin_expect(EXP, N)。 意思是:EXP==N 的概率很大。 一般的使用方法是将 __builtin_expec...

Bluce的博客 1239

现代高性能计算环境下的 Q_LIKELY 与 Q_UNLIKELY 分支预测优化深度研究报告

摘要: Q_LIKELY与Q_UNLIKELY宏通过静态分支预测优化提升现代处理器流水线效率。其底层原理基于减少分支预测失败(10-30周期惩罚)和优化指令缓存布局,利用编译器内建函数(如GCC的__builtin_expect)或C++20标准属性实现。Qt 6.9引入的Q_LIKELY_BRANCH进一步细化代码块优化策略。实际应用中(如QtCore模块),正确使用可提升关键路径性能12%,但错误提示会干扰硬件预测。该技术需权衡概率准确性(建议>90%置信度)与维护成本,是高性能C++开发的重要优

greenspan的专栏 784

likely和unlikely宏

    首先,无论在何处,当我们遇到宏likely和宏unlikely时,都要明确一点:  if(likely(value)) 等价于 if(value)  if(unlikely(value)) 也等价于 if(value)    也就是说 ,当value值为真时执行if分支,为假时执行else分支,从阅读和理解代码的角度来看,是一样的!!!以下为这两个宏的一般定义:#define likely(x)       __builtin_expect(!!(x), 1)#define unlikely(x) 

David_Henry的专栏 3107

likely unlikely()详解

先理清一个概念:从作用上看   if(like(v)) == if(unlikely(v))==if(v)  那么我们为什么要用likely unlikely 命令呢,我们来看下面的详解 本文转自:http://www.cnblogs.com/PyshCliem/archive/2012/09/07/2674714.html 在include/linux/compiler.

zhaowenchaofang的专栏 1142

Linux内核入门-- likely和unlikely

编译器优化时,根据条件跳转的预期值,按正确地顺序生成汇编代码,把“很有可能发生”的条件分支放在顺序执行指令段,而不是jmp指令段(jmp指令会打乱CPU的指令执行顺序,大大影响CPU指令执行效率)。我们知道目前的CPU无一例外的都引入了流水线技术,用于加快指令的执行,提高CPU的性能。在一个条件判断语句中,当这个条件被认为是非常非常有可能满足时,则使用likely()宏,否则,条件非常非常不可能或很难满足时,则使用unlikely()宏。可见,编译器利用程序员作出的判断,生成了高效的汇编码。

m0_74282605的博客 2679
上一篇: [Python] [Linux] 统计进程组中所有的进程号
下一篇: 【C++11】多线程并行化快速排序的实现
Liever18
博客等级 码龄10年 55粉丝 13原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值