RAG存在的问题及解决方案

【AI大模型应用开发】【RAG优化 / 前沿】0. 综述:盘点当前传统RAG流程中存在的问题及优化方法、研究前沿 10个痛点问题,20+优化方法,8个前沿RAG研究。本文我们从RAG的流水线开始,全面梳理了当前传统RAG存在的问题,同时针对每个问题,总结了优化方法。并且,整理了当前前沿的RAG研究。 阅读详情

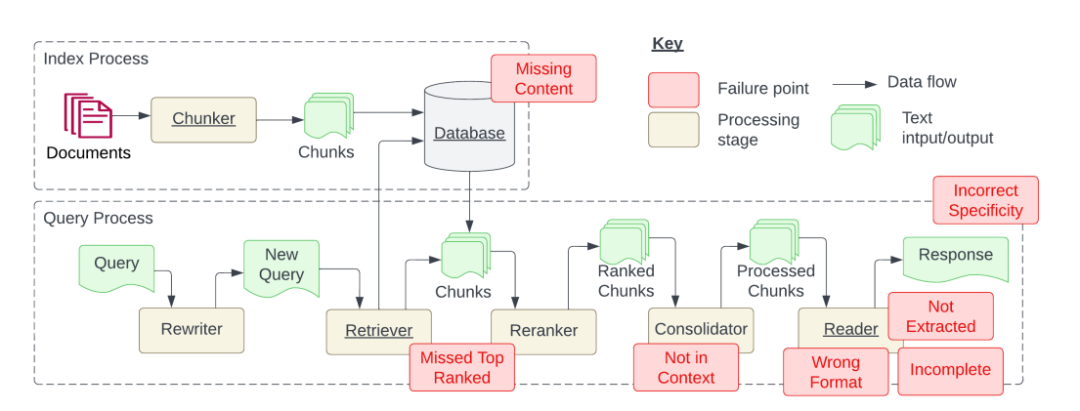
今天给大家梳理一篇核心论文📝《Seven Failure Points When Engineering a Retrieval Augmented Generation System》中提到的RAG七大核心痛点,搭配对应解决方案,干货满满✨,建议收藏!🔖

论文地址:🔗 https://arxiv.org/pdf/2401.05856
图片

基于这篇论文提出的7个RAG痛点(FP1-FP7),我们逐一拆解应对策略🔧,不管是日常使用还是工程落地,都能直接参考~✅

✅ 1:缺失内容(Missing Content)❌

核心问题:📌 原本的文本中就没有问题的答案(最基础的信息缺口)

解决方案:🔍

扩展知识源 📊:确保索引的数据集尽可能全面,覆盖相关领域权威资料,定期更新数据源保持时效性。

增强检索能力 🔎:采用更强大的检索器(如多模态检索、混合检索),或结合BM25+向量检索等多种策略。

引入外部知识 🗂️:搭配知识图谱或其他结构化知识库,补充文档中缺失的关键信息。

明确告知未知 🚫:无法从检索内容中找到答案时,直接告知用户“信息不足”,避免输出错误内容。

优化Prompt设计 ✍️:通过Prompt引导大模型,在找不到答案时输出“根据当前知识库,无法回答该问题”,倒逼模型承认局限,提升透明度。

✅ 2:未返回高排名文档(Missed the Top Ranked Documents)🔢

核心问题:📌 检索时错过排名靠前、相关性最高的文档,导致答案偏差

解决方案:🔧

优化检索器 ⚙️:改进检索算法,采用更先进的嵌入模型,或搭配复杂重排序(Re-ranking)模型,提升相关文档召回率。

调整检索参数 🔩:优化K值等核心参数,确保足够数量的相关文档被检索,设置相关性最低阈值,不遗漏高相关低排名文档。

人工反馈迭代 🔄:建立用户反馈机制(点击率、满意度),持续优化检索模型和排序逻辑。

评估与监控 📈:定期用Recall@K、NDCG等指标评估检索效果,实时监控检索质量。

✅ 3:上下文整合策略不当(Not in Context - Consolidation strategy)🧩

核心问题:📌 提取的上下文与用户问题无关,相当于“无效检索”

解决方案:🔍 本质是FP1(内容缺失)或FP2(未返回高排名文档)的具体体现,优先解决前两个痛点即可缓解。

✅ 4:未能提取(Not Extracted)📤

核心问题:📌 检索到的上下文中包含答案,但大模型未能成功提取,白白浪费有效信息

解决方案:🔧

提示压缩技术 🗜️:应对LLM输入长度限制,减少Prompt大小的同时,完整保留核心信息和意图,提升提取效率、降低成本。

✅ 5:格式错误(Wrong Format)📝

核心问题:📌 输出格式不符合需求(如需要JSON却输出字符串),无法直接复用

解决方案:🔧

明确格式要求 📋:在Prompt中清晰指定期望格式(表格、列表、JSON等),使用模板化Prompt提升准确率。

约束生成 🛡️:利用LLM格式控制功能,或在后处理阶段强制转换输出格式。

格式验证修复 🔍:添加简单验证器,输出后检查格式正确性,错误时重新生成或修复。

结构化Prompt 🧩:设计结构化Prompt,引导LLM按指定方式组织信息,减少格式偏差。

✅ 6:不正确的具体性(Incorrect Specificity)📏

核心问题:📌 答案要么过于笼统、缺乏细节,要么过于繁琐、抓不住重点

解决方案:🔧

细化用户意图 🧠:通过用户画像、历史对话,精准把握用户需求和背景,匹配合适的回答粒度。

调整检索粒度 📐:按需调整文档分块大小,细节需求用细粒度文档,概览需求用宏观总结。

定制化生成 🎨:在Prompt中加入角色或具体性要求(如“用高中生能理解的方式解释”)。

多层级信息 📚:提供不同抽象层次的信息选项,让用户自主选择所需具体程度。

后处理筛选 🚪:输出前按预设规则,筛选调整内容抽象级别,确保贴合需求。

✅ 7:回答不完整(Incomplete)🧩

核心问题:📌 仅回答用户问题的一部分,遗漏关键信息,影响使用体验

解决方案:⚠️ 本质是RAG的幻觉衍生问题,目前暂无最优解决方案,需结合前6个痛点的优化,间接降低不完整概率。

💡 总结:RAG的7大痛点核心集中在“信息获取-检索-提取-输出”四大环节🔄,优先解决1、2两个基础痛点,能大幅提升整体效果🚀,其余痛点可按需逐步优化~✅

这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

1. 成长路线图&学习规划

要学习一门新的技术,作为新手一定要先学习成长路线图,方向不对,努力白费。

这里,我们为新手和想要进一步提升的专业人士准备了一份详细的学习成长路线图和规划。可以说是最科学最系统的学习成长路线。
在这里插入图片描述

2. 大模型经典PDF书籍

书籍和学习文档资料是学习大模型过程中必不可少的,我们精选了一系列深入探讨大模型技术的书籍和学习文档,它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。(书籍含电子版PDF)

在这里插入图片描述

3. 大模型视频教程

对于很多自学或者没有基础的同学来说,书籍这些纯文字类的学习教材会觉得比较晦涩难以理解,因此,我们提供了丰富的大模型视频教程,以动态、形象的方式展示技术概念,帮助你更快、更轻松地掌握核心知识。

在这里插入图片描述

4. 2026行业报告

行业分析主要包括对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5. 大模型项目实战

学以致用 ,当你的理论知识积累到一定程度,就需要通过项目实战,在实际操作中检验和巩固你所学到的知识,同时为你找工作和职业发展打下坚实的基础。

在这里插入图片描述

6. 大模型面试题

面试不仅是技术的较量,更需要充分的准备。

在你已经掌握了大模型技术之后,就需要开始准备面试,我们将提供精心整理的大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

在这里插入图片描述

7. 资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

从被动检索到主动思考:Naive RAG 到 Agentic RAG 的架构演进与关键技术解析 本文系统梳理了检索增强生成(RAG)技术从基础Naive RAG到新一代Agentic RAG的演进路径。针对大语言模型的知识滞后与幻觉问题,RAG通过实时检索与上下文增强实现可控生成。文章剖析了Naive RAG的架构局限,重点阐述Agentic RAG的创新特性:递归检索、动态任务规划、工具集成和多智能体协作,并通过实验数据验证其在复杂任务中的性能优势(如HotpotQA多跳推理任务F1得分提升25.5%)。最后探讨了延迟优化、安全风险等现存挑战及自我进化等未来方向,为RAG技术的进一步发展提供参考。 阅读详情

相关推荐

STM32H723串口接收全为0 & CAN错误中断问题

STM32H723串口接收全为0 和 叠加的导致CAN错误问题

weixin_38743772的博客 3916

RAG 排坑指南001——文档解析

RAG搜索增强是一个极其简单的概念。简而言之就是将搜索召回的内容,送给模型润色,重新生成更好的答案。看似简单,实际做起来,就极其的复杂。想要做个演示demo也很简单,复杂的是如何把回答正确率提升到90以上。RAG中的问题非常之多。并且问题环环相扣。例如,如果文档解析做不到,就不可能在召回的阶段将内容准确的召回(也就是召回率低)虽然可以通过扩大topK来尽可能的提升召回率,但是假如在解析的过程中数据丢失了。是无论如何都找回不到的。如果无法召回,正确的答案就无法送给模型,自认而然就无法回答正确。

Angus 1969

在matlab中运行自带的模块(以CCSDS LDPC Decoder模块为例)

最新版的获取需要注册 MathWorks 账户 访问账户注册页面:www.mathworks.cn/mwaccount/register。下载新版本或历史版本的MATLAB,请登陆:https://www.mathworks.cn/downloads 并下载。点击此处可以拷贝调用例程的命令,在matlab命令行输入即可自动获取代码。可以看到页面中写了该模块需要在R2022b以上版本使用。运行.m文件可以生成simulink运行所需要的数据。可以看到左侧下载到了官方历程的文件。之后双击slx文件即可打开。

qq_28455081的博客 885

大模型:RAG 开发四大痛点及解决方案

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

m0_56255097的博客 2270

Android14到Android16源码移植中的Bluetooth模块规范适配指南

本文详细解析了从Android14到Android16源码移植过程中Bluetooth模块的规范适配挑战,重点介绍了Android.bp配置差异及常见编译报错解决方案。针对代码规范检查、final字段声明、静态方法优化等核心问题提供实用修复方法,帮助开发者高效完成版本升级适配工作。

fire9的博客 254

python多线程实现http代理

python多线程实现http代理文章要求1.py socket模块2.py threading模块3.环境搭建3.1设置代理3.2搭建http简单服务器代码分析1.完整代码2.逻辑结构 文章要求 1.py socket模块 socket模块接触后很简单,我实现的是阻塞性的套接字。 需要了解到,连接套接字,监听套接字,和套接字accept()方法的返回值是元组 数据传递过程sock.recv(1024),sock.send()也不需要转换编码,直接以b"二进制流"传输 2.py threading模块 th

qq_43402663的博客 2508

用通俗易懂的方式讲解:12 个大模型 RAG 痛点及解决方案

我们探讨了开发RAG管道中的12个痛点(来自论文的7个和额外的5个),并为所有这些问题提供了相应的解决方案。

2301_78285120的博客 2834

AGV路径规划实战:如何用Python+ROS实现激光SLAM导航(附避障代码)

本文提供了一份基于Python和ROS实现AGV激光SLAM导航的实战指南。内容涵盖从Docker环境搭建、激光雷达数据处理、Gmapping建图,到Move_Base全局/局部路径规划与TEB局部规划器配置的全流程。重点解析了如何通过参数调优实现稳定导航,并附带了紧急避障代码,帮助开发者快速构建具备自主路径规划与实时避障能力的AGV系统。

pepsi的博客 1235

收藏级干货!RAG系统开发的7大失败点与解决方案详解

文章基于论文系统梳理RAG系统的七大痛点:内容缺失、未返回高排名文档、上下文整合不当、未能提取、格式错误、具体性不正确和回答不完整。针对每个痛点提供解决方案,强调优先解决前两个基础痛点能显著提升系统效果。这些解决方案覆盖"信息获取-检索-提取-输出"四大环节,为RAG系统工程落地提供实用指导。

datian1234的博客 589

解密GPT-5-Codex CLI安全最佳实践:从API Key保护到沙箱模式详解

本文深入解析GPT-5-Codex CLI在企业环境中的安全最佳实践,涵盖API Key全生命周期管理、沙箱模式配置及网络传输加固等核心防护策略。通过分层存储方案、动态环境变量加载和精细化权限设计,帮助开发团队构建企业级AI编程助手的安全防线,有效预防密钥泄露和未授权访问风险。

weixin_29309785的博客 586

京东前端200道面试题及参考答案(中)

前端优化是“提升用户体验、降低资源消耗”的核心手段,需围绕“用户感知的性能指标”(如页面加载速度、交互流畅度)展开,覆盖加载优化、渲染优化、代码优化、网络优化、缓存优化、性能监控六大维度,每个维度下有具体可落地的措施,同时需结合项目实际场景(如单页应用、电商首页)选择优化方案。分页组件需通过props接收“数据总量、当前页、每页条数”等基础信息,通过emit触发“页码切换、每页条数变化”的回调(供父组件请求对应页数据),同时定义默认值确保兼容性。核心Props与Emit设计<template>

大模型大数据攻城狮的专栏 590

RAG所存在的问题和解决方案

本文探讨了RAG系统中的关键技术和挑战。主要问题包括:文档解析准确性、文本分块策略、查询优化、检索质量、结果排序和回答评估。对于RAG出现的问题提出优化方案。

weixin_72563696的博客 834

踩坑2周总结:Python+YOLO26搭建工业级多路视频分析应用,从单路卡顿到16路4K稳跑30FPS

本文分享了工业级多路视频分析系统的实战经验,针对智慧物流园区的车辆违停和人员安全监测需求,提出了一套完整的解决方案。作者通过踩坑实践,总结出多路视频分析的四大核心痛点:视频流解码瓶颈、推理调度混乱、内存占用爆炸和部署兼容性差。 文章详细介绍了技术选型方案,推荐使用FFmpeg+PyAV进行硬件加速解码、YOLO26+TensorRT INT8量化推理、单进程多线程的生产者-消费者架构,以及内存池复用等技术组合。该方案在RTX 4070 Ti上实现了16路4K视频30FPS稳定运行,GPU利用率达85%以上,

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 955

【RAG】37-RAG 问答问题及应对策略:探讨RAG问答中存在的问题及解决方案

RAG(Retrieval-Augmented Generation)问答系统结合了信息检索与生成模型的优势,在智能客服、教育辅助和医疗咨询等多个领域展现出巨大潜力。然而,在实际应用中,RAG系统仍面临着检索准确性、生成质量、上下文理解等多方面挑战。本文将深入分析这些问题,并提出针对性的应对策略,助力RAG系统在实际应用中发挥更大价值。

rengang66的博客 721

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

大模型RAG保姆级教程:问题解析、解决方案与开源工具,建议收藏!

只将最核心的信息提供给最终的生成模型。

Everly_的博客 1054

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

LLM Agent应用场景:Agentic RAG

例如,在回答“找出所有区域的共同休假日期”时,查询规划代理可以首先将问题分解为查询每个区域的休假日期子问题,然后将这些子问题的结果合并以找出共同休假日期。例如,询问“找出所有区域的共同休假日期”时,如果只能传递前K个片段给大型语言模型(LLM),那么能够比较的区域数量就受到K的限制,导致结果不够全面。例如,在需要同时进行概括和语义搜索的任务中,路由代理可以将查询分别发送到概括工具和语义搜索工具中,然后将两个工具的结果进行合并和整合。的概念来增强LLM的能力,成功地解决了传统RAG在处理复杂查询时的局限性。

编程就像打游戏,编出一个项目就打过了一个BOSS 1172

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

大模型安全 | RAG 精确应对大模型敏感问题知识幻觉难题

在大模型中,不局限于特定任务,幻觉往往指的是与世界知识不一致,即不符合事实。尤其是在对输出内容真实性的容忍度较低时,大模型的幻觉现象会严重影响其落地效果。因此,纠正这些幻觉现象,是一个值得长期关注的问题。

瓦罗兰特顶级C位的博客 1144

一文梳理有效提升RAG效果的方法

在大模型实际落地的时候,存在一些问题,主要集中在以下方面:缺少垂直领域知识:虽然大模型压缩了大量的人类知识,但在垂直场景上明显存在短板,需要专业化的服务去解决特定问题。存在幻觉、应用有一定门槛:在大模型使用上有一些幻觉、合规问题,没有办法很好地落地,配套工作不足,缺乏现成的方案来管理非结构化文本、进行测试、运营和管理等。存在重复建设:各业务孤立摸索,资产无法沉淀,存在低水平重复建设,对公司来说ROI低,不够高效。

qingkahui24689的博客 901

大模型安全问题 | RAG 精确应对大模型敏感问题知识幻觉难题

在大模型的实际应用落地过程中,会遇到所谓的幻觉(Hallucination)问题。对于语言模型而言,当生成的文本语法正确流畅,但与原文不符(Faithfulness)或事实不符(Factualness)时,模型便出现了幻觉的问题。

Y525698136的博客 415

一文读懂什么是RAG,如何搭建多模态RAG降低大模型幻觉

当我们向 LLM 提出超出其预训练知识范围的问题时,通常 LLM 会出现幻觉。例如,如果我们向 LLM 提出涉及医学或法律等高度专业化的问题,并包含大量内部术语时,我们就有可能得到 LLM 随机生成的不准确的回答。缓解这一问题的一种方法是使用特定的数据集对 LLM 进行微调。虽然这种方法很有效,但十分耗时且高成本,需要消耗的内存也非常高。RAG 是另一种基于信息检索方法,可以缓解 LLM 幻觉。我们首先获取用户的查询,然后在我们的数据库中找到最相关的上下文,这些上下文可以帮助 LLM 生成准确的回答。

python1234_的博客 1085

RAG模式下文档向量切片问题及解决方案

在使用RAG(Retrieval Augmented Generation)检索增强技术时,会涉及到知识库的构建和文档的切分。文档切分的好坏对下游任务的效果至关重要。文档切分粒度不好把控,既担心噪声太多,又担心语义信息丢失。

longxiaotian718的博客 3447

AI大模型落地RAG系列:RAG入门及RAG面临的挑战和解决方案!大模型入门到精通,收藏这篇就足够了!

本文首先介绍什么是 RAG、为什需要 RAG、介绍 Naive RAG 工作流程及Naive RAG 存在的问题和挑战!

2301_81888214的博客 992

大模型RAG入门到精通全指南:详细教程,一篇文章搞定

大模型(Large Language Model,LLM)的浪潮已经席卷了几乎各行业,但当涉及到专业场景或行业细分域时,通用大模型就会面临专业知识不足的问题。相对于成本昂贵的“Post Train”或“SFT”,基于RAG的技术方案往成为一种更优选择。本文从RAG架构入手,详细介绍相关技术细节,并附上一份实践案例。前排提示,文末有大模型AGI-优快云独家资料包哦!本文列举了LLM的问题。简单介绍了什么是 RAG ,以及 RAG 的流程。最后使用了一个简单的LangChain代码示例来展示 RAG 的使用。

2401_85390073的博客 1178

万字长文,深度复盘“死板的RAG”!从问题根源到解决方案,一文带你入门到精通!

RAG的机制决定了其执行流程比较死板,而Agent更符合人类的思维模式。

Python_cocola的博客 1087
上一篇: 一文学会如何构建无向量 RAG 系统
下一篇: 从被动唤醒到主动守望:基于AI Agent的智能任务架构实践
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值