Dify 2.0 重磅升级!知识管道登场,RAG 开发效率直接翻倍,大模型入门到精通,收藏这篇就足够了!

dify案例分享-告别 PS!借助 Dify 实现 Gemini 2.0 Flash Exp 文字一键生图改图 基于 Gemini 2.0 Flash Experimental 大模型,实现了一个利用文字生成图片以及修改图片的工作流。我详细介绍了整个工作流的实现步骤,该工作流包含开始、问题分类器、会话变量、条件分支、LLM 大模型等部分。这个工作流功能十分强大,借助 Google 大模型实现了一键改图,达成了文字 P 图的功能,基本将 P 图的门槛降低到普通人都能学会的程度。 阅读详情

上个月就给大家同步了dify的下一个工作,rag2.0,当时我和他们的产品聊过rag2.0,核心的rag不会变动太多(dify本身rag能力够用,问题最多的在于文档格式)。主要是数据解析这块,以流水线的方式处理文档。 也叫知识管道。

上周dify发布了1.8.1以后,随后又发布了预览版dify 2.0.0 作为dify的大版本升级,更新的内容会比较多,如果是生产环境,建议先不要升级,等到正式发布以后再动,如果只是体验,可以直接升级。

注意,注意,注意,升级前一定要先备份一下。

升级

本次预览版的升级,是以tag的形式发布的。如果你fork的代码,不会同步tags和其他分支的,你可以把.git/config里的地址改为dify的。
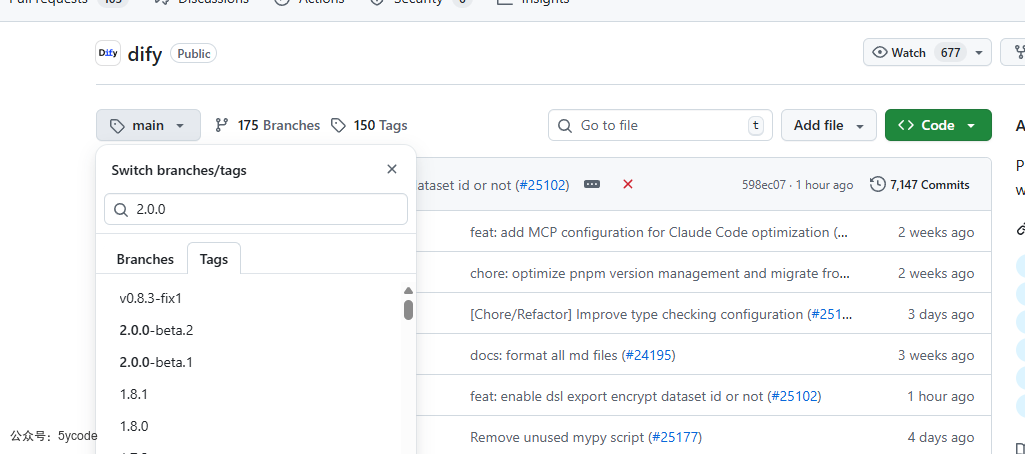
如果自己本身代码有改动,先拉一个分支,本地提交下,然后再创建一个新的分支,来试验2.0.0版本。

# 只拉取指定的taggit fetch origin tag 2.0.0-beta.2# 创建一个2.0.0-beta的分支git checkout -b 2.0.0-beta 2.0.0-beta.2

关闭并重启

docker compose downdocker compose up -d#执行2.0升级命令,分组名称,默认是docker-api-1  我命名为dify了docker exec -it dify-api-1 uv run flask transform-datasource-credentials

知识管道

在升级之前我们要么在后台直接上传文本处理知识库,要么在通过工作流或者代码直接调用api处理。在本次升级以后,官方直接把知识库的处理流程给开放了出来,并且提供了一些模板案例。
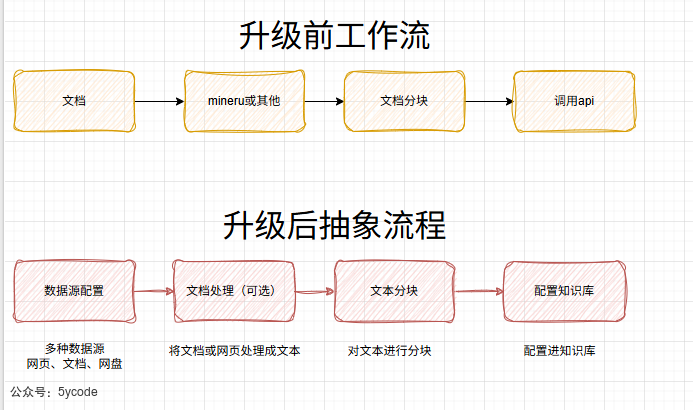
在升级之前,我们通过工作流也能完成,无非麻烦一些,升级以后,官方将处理流程进行了抽象。

变化
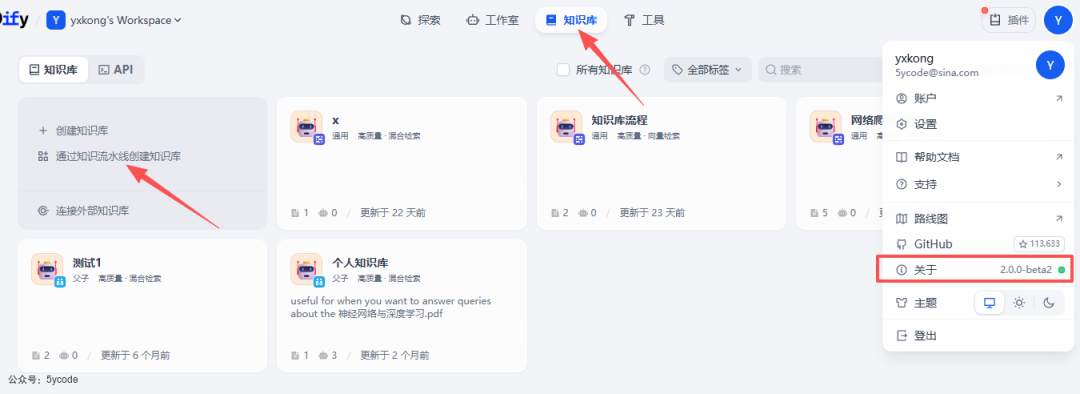
升级以后,可以在知识库中创建知识库的下方看到有一个通过知识流水线创建知识库。
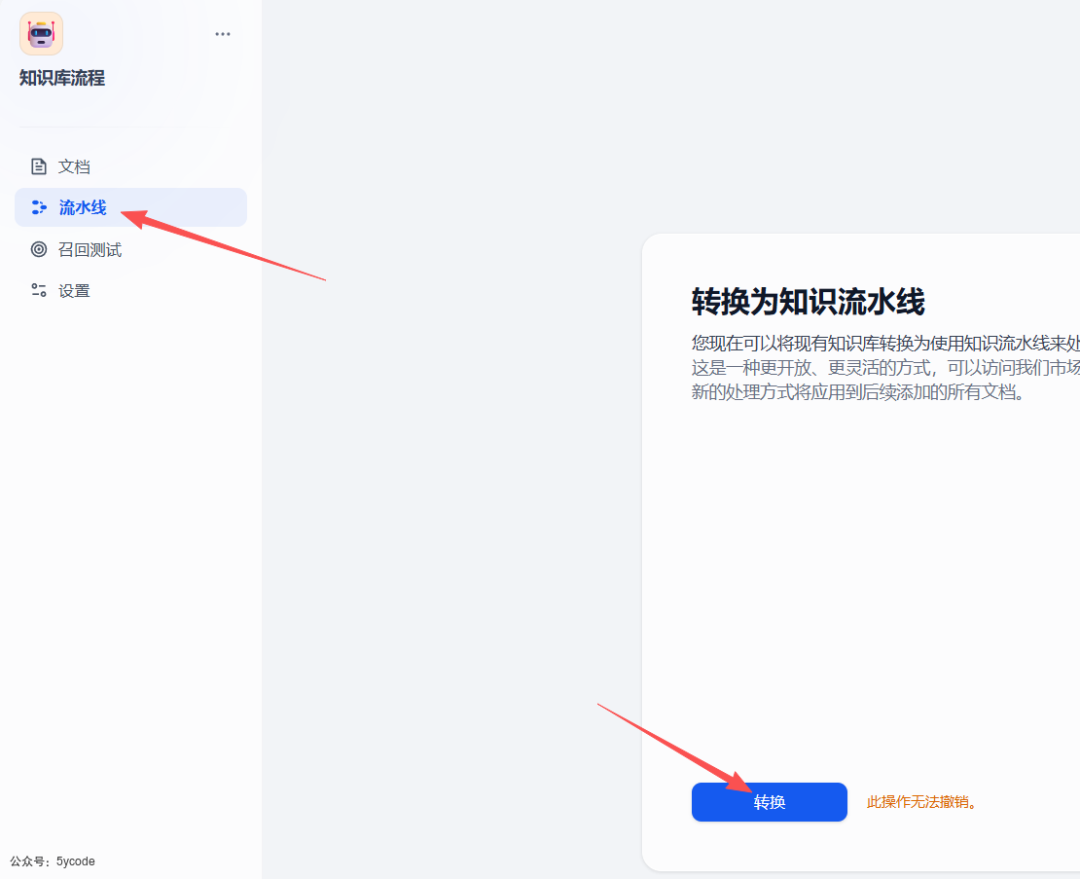
在知识库里有一个流水线的功能,存量知识库可以转换为流水线。

通过知识管道处理知识库

知识管道创建

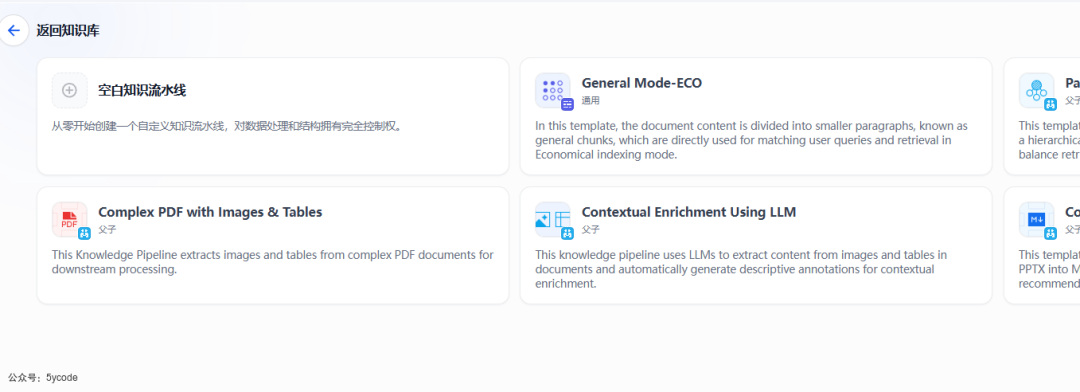
知识管道创建有两种模式,一种是创建一个空白的管道自己配置,一种是利用官方内置流水线(Built-in Pipeline)。
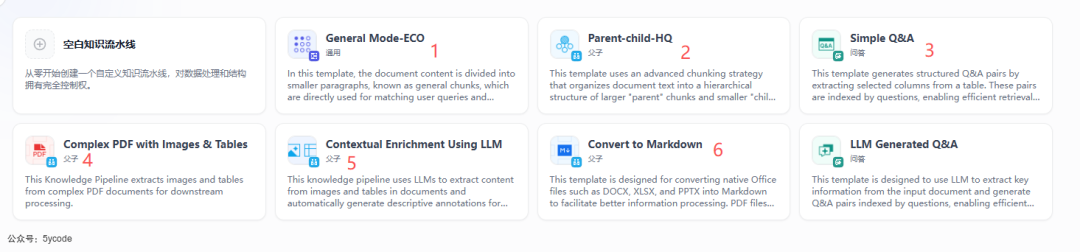
先看下内置的流水线种类,以及作用。内置的知识流水线有以下七种:

模版名称分段结构索引方式检索设置说明
1 ,通用模式(General Mode)通用模式经济倒排索引将文档内容分割成较小的段落块(通用块),直接用于匹配用户查询和检索。
2 ,父子模式(Parent-child Structure)父子模式高质量混合检索采用了高级分块策略,将文档文本分成较大的”父块”和较小的”子块”。其中,“父块”包含了”子块”。这样既保证了检索的精确性,又维持了上下文的完整性。
3 ,简单问答(Simple Q&A)问答模式高质量向量搜索将表格数据转化为一问一答的形式,通过问题匹配来快速找到对应的答案信息。适用于结构化表格数据。
4 ,复杂 PDF (含图片和表格)(Complex PDF with Images & Tables)父子模式高质量混合检索 - 加权评分提取 PDF 文件内的图像和表格内容。
5 ,LLM 上下文增强(Contextual Enriching Using LLM)父子模式高质量混合检索 - 加权评分将文档内的图片和表格提取出来,使用大型语言模型自动生成描述性注释,实现上下文的智能增强。
6 ,Markdown 转换(Convert to Markdown)父子模式高质量混合检索 - 加权评分专为 DOCX、XLSX 和 PPTX 等 Office 原生文件格式设计,将其转换为 Markdown 格式以便更好地进行信息处理。
7 ,LLM 生成问答(LLM Generated Q&A)问答模式高质量向量搜索 - 加权评分使用大型语言模型自动生成结构化的问答对,通过问题匹配机制找到相关的答

需要注意的是,断网情况下这些内置流水线加载不出来。从日志上可以看到,先从官方加载,官方网络不通,直接从本地加载,我是一路升级过来的,数据库里应该没有对应的信息。

通用模式
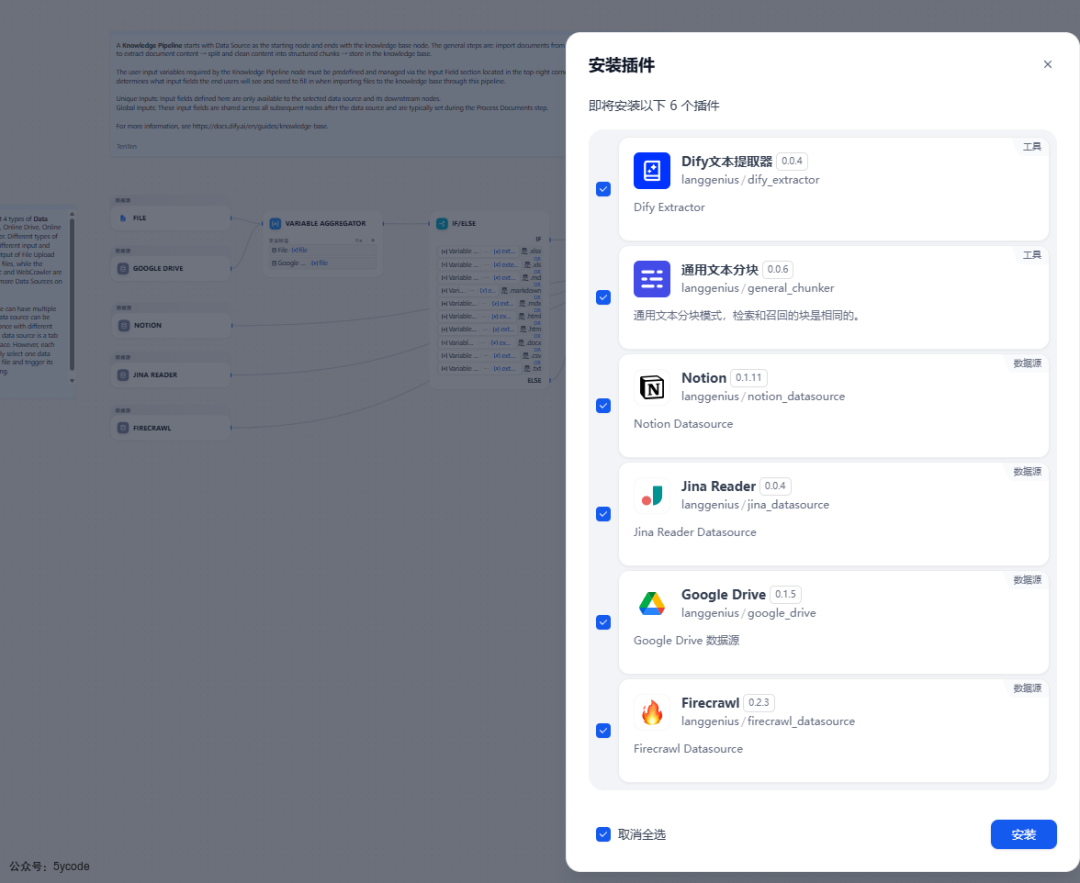
创建以后,可以看到依赖一堆的插件。因为官方是示例性质的,所以是一个大而全的集合。这里需要重点说一下两个插件

  • • dify文本提取器

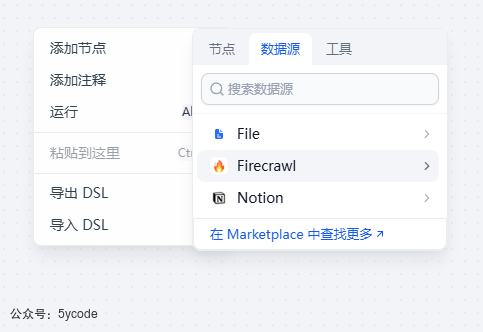
在知识管道里,点击空白右键,添加节点,在面板中有数据源的选项,这个是和现有工作流的差异。
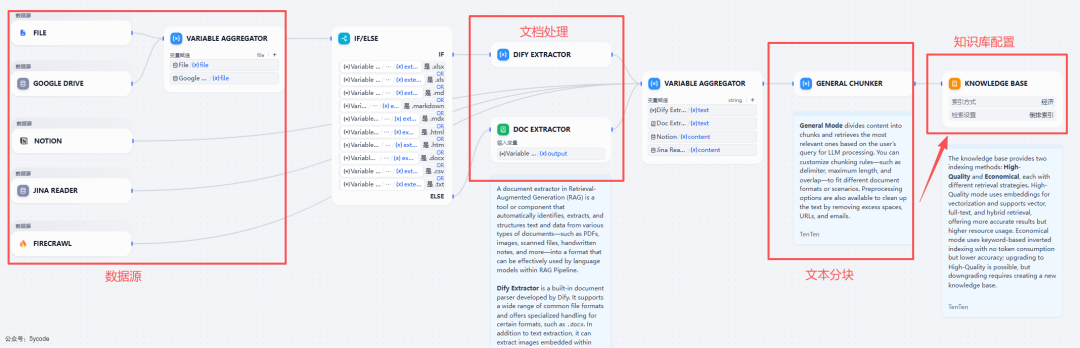
从模板上我们可以看到下,也是这么四步。

  • • 第一步配置数据源,多种形态
  • • 第二步文档处理:这个示例里配置了两个处理器,一个是dify内置的文档解析器(Dify Extractor),一个是原来工作流节点的文档提取器。
  • • 第三步:文本分块,这里使用的是dify 封装的通用分块器
  • • 第四步:知识库配置,这里主要是配置索引方法和检索策略,这个和第三步紧密关联,
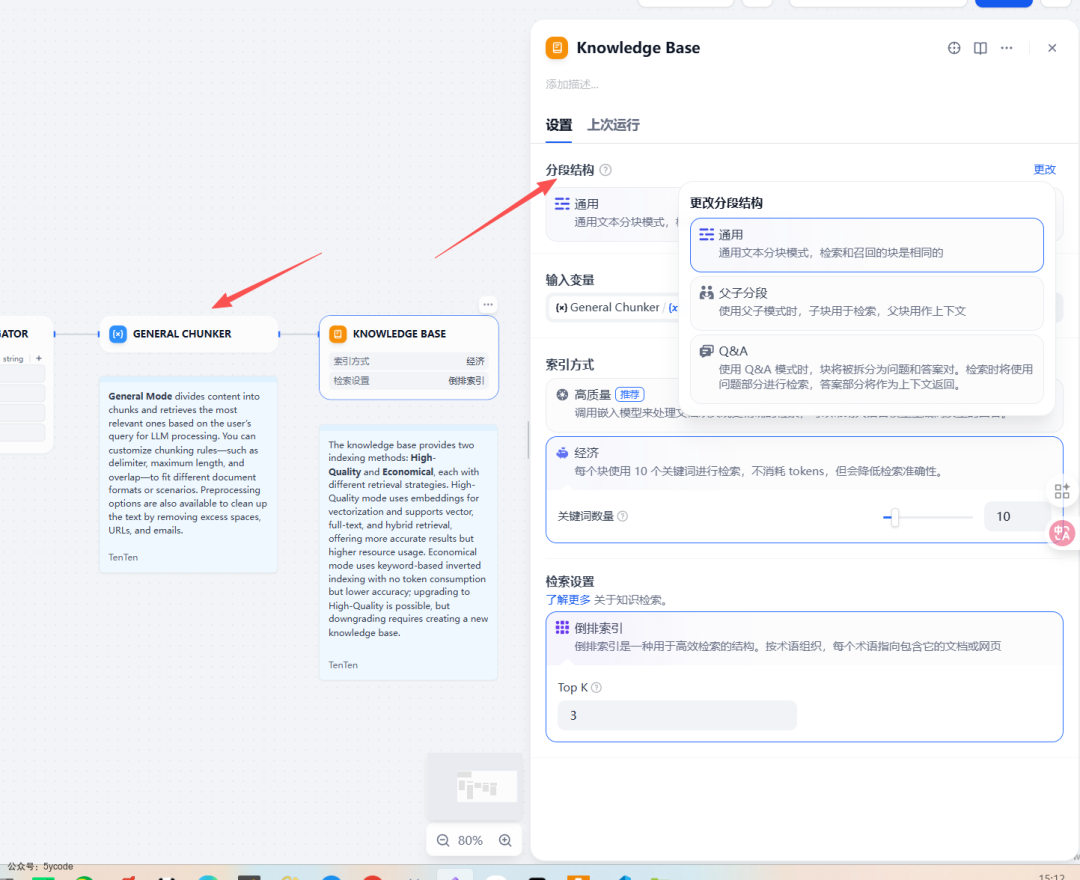
在第四步,分段结构没有必要,这个由第三步的分块器决定的,有这块配置反而增加了配置的复杂度。还不如直接根据第三步直接填写。

从dify的示例来说,大都是父子分段的格式,从另外一个层面可以反映出来,复杂文档,父子分段的效果最好。

我再讲解两个复杂的案例。

复杂 PDF 处理

这个是从模板4创建而来的。
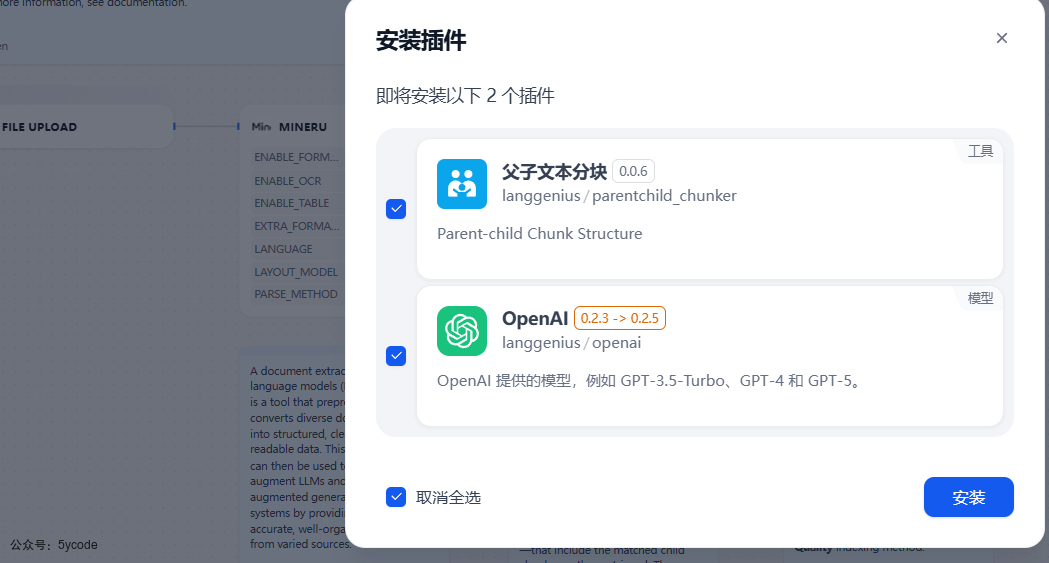
依赖父子文本分块器。
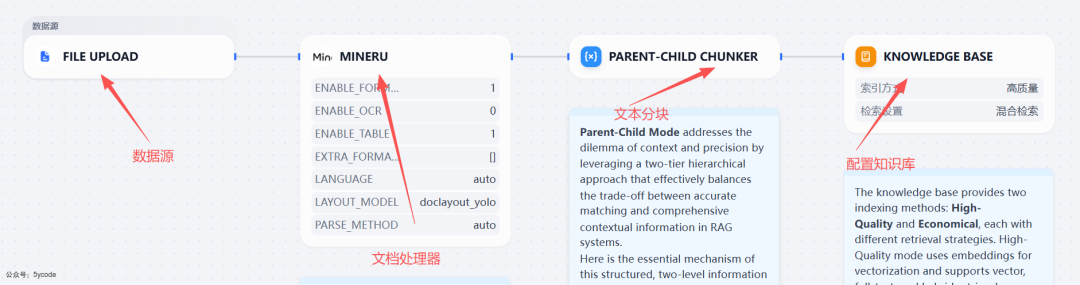
整个流程,还是按照之前的四步来处理的。

  • • 第一步配置数据源,是上传的文本
  • • 第二步文档处理:这里使用的是MINERU,除了MINERU还可以用其他的文档处理插件处理。
  • • 第三步:文本分块,使用的是父子分块器
  • • 第四步:知识库配置,这里主要是配置索引方法和检索策略,这个和第三步紧密关联,
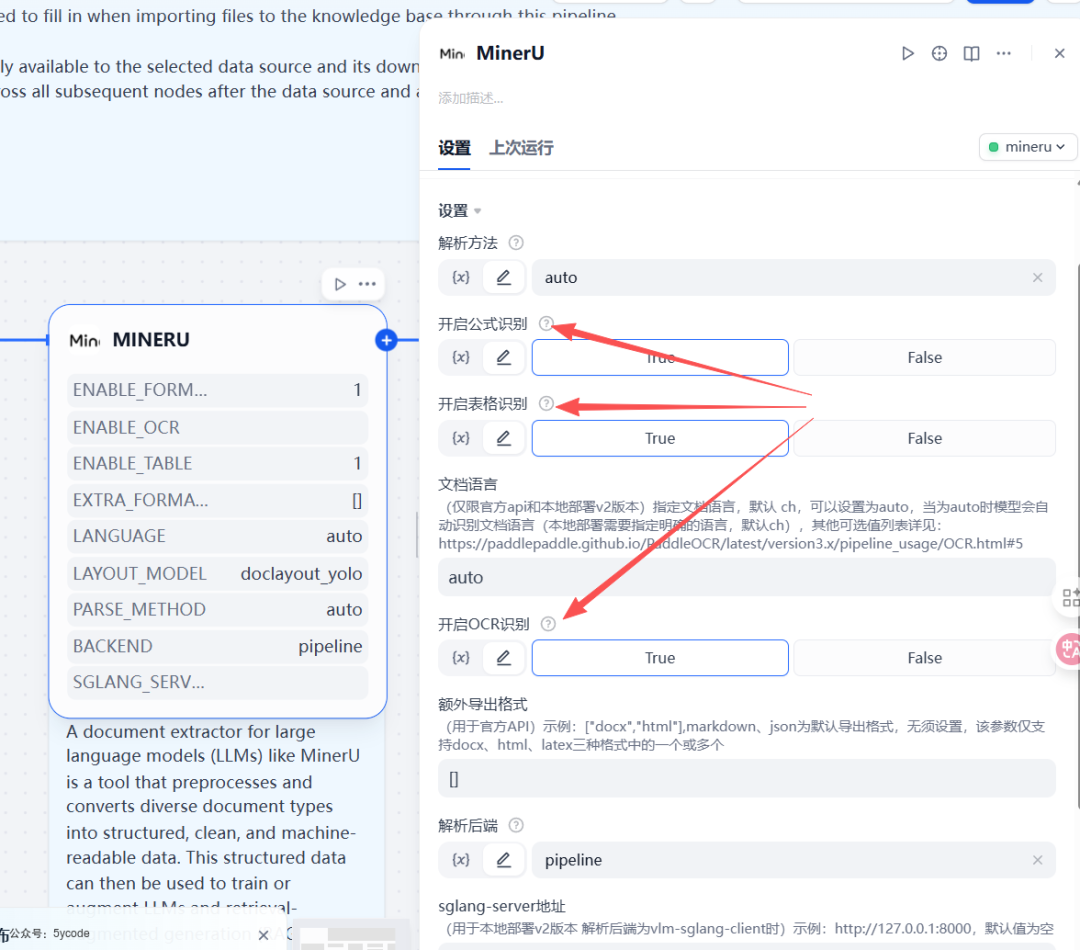
复杂pdf的处理,完全依赖于处理器的能力。

大家关闭梯子,去mineru的官网申请token就可以
https://mineru.net/apiManage/token
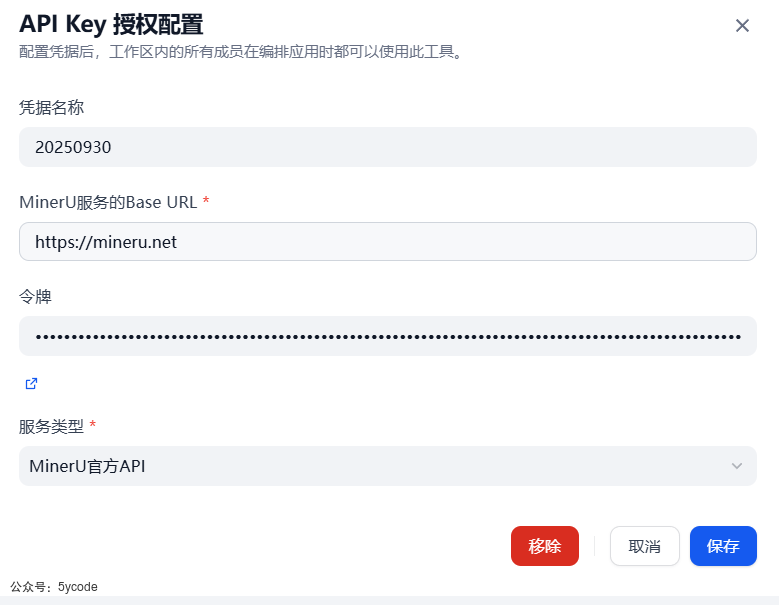
申请完token以后mineru的配置也很简单。
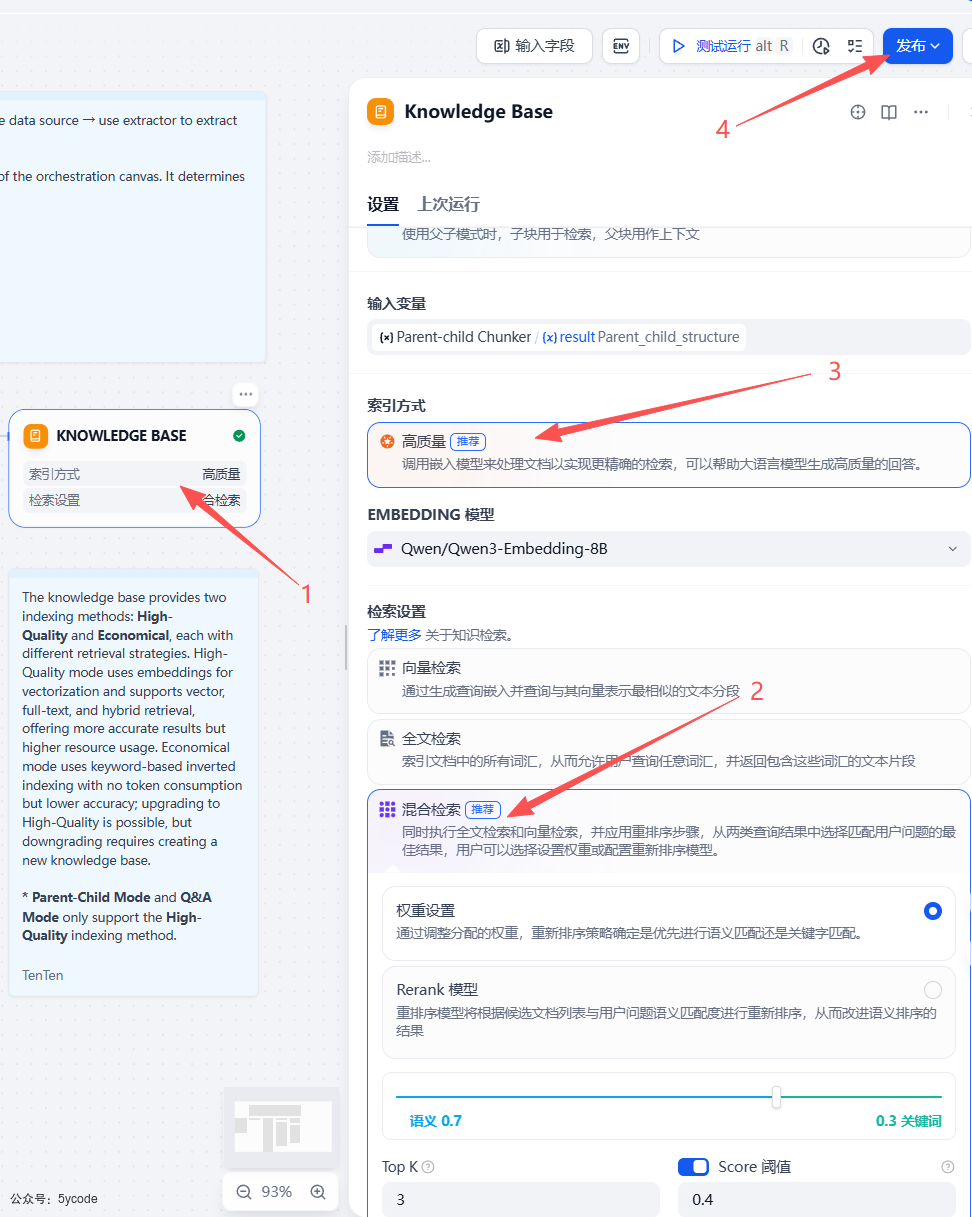
最后配置完索引方式和检索设置以后,别忘点击右上角的发布,发布的工作流,只是在本知识库中使用。回到文档那里,我们上传文档,然后等待管道的处理即可。
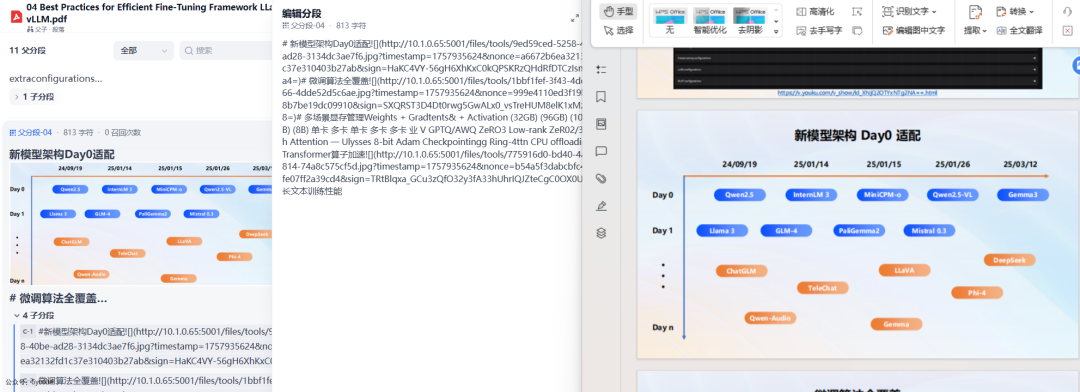
这个是上传的一个ppt的解析效果。图片解析出来了,也显示了。

这个折腾了1个多小时,才显示出图片,需要注意,升级那里的配置图片显示。
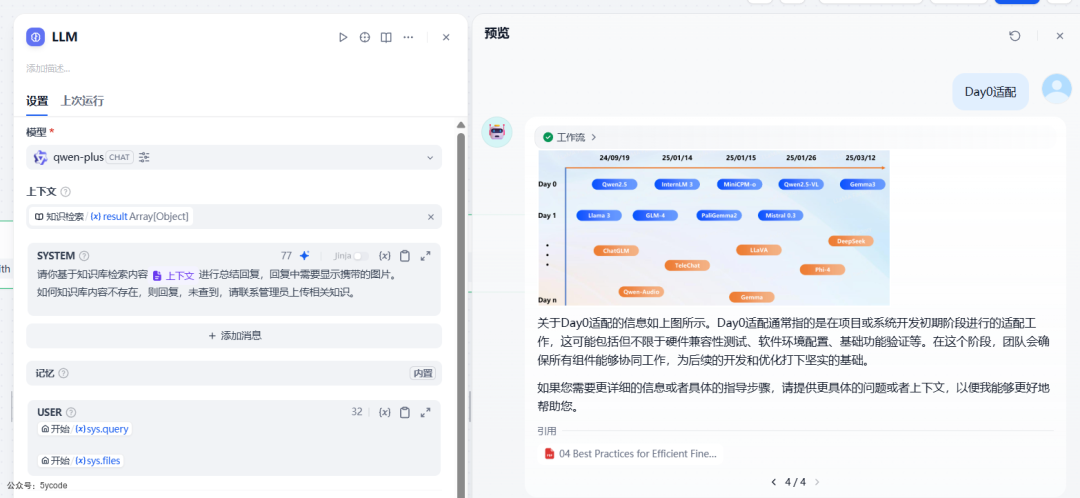
LLM 上下文增强
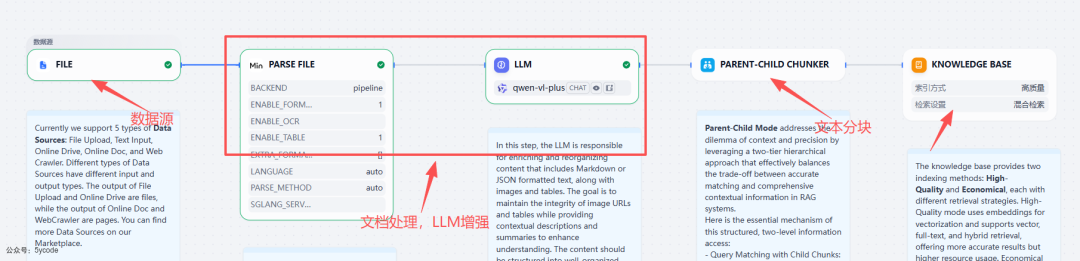
整个流程,还是按照之前的四步来处理的。

  • • 第一步配置数据源,是上传的文本
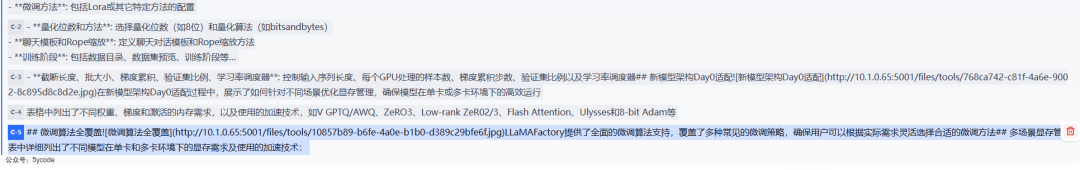
  • • 第二步文档处理:这里使用的是MINERU+LLM,我使用的qwen-vl.
  • • 第三步:文本分块,使用的是父子分块器
  • • 第四步:知识库配置,同上

对比

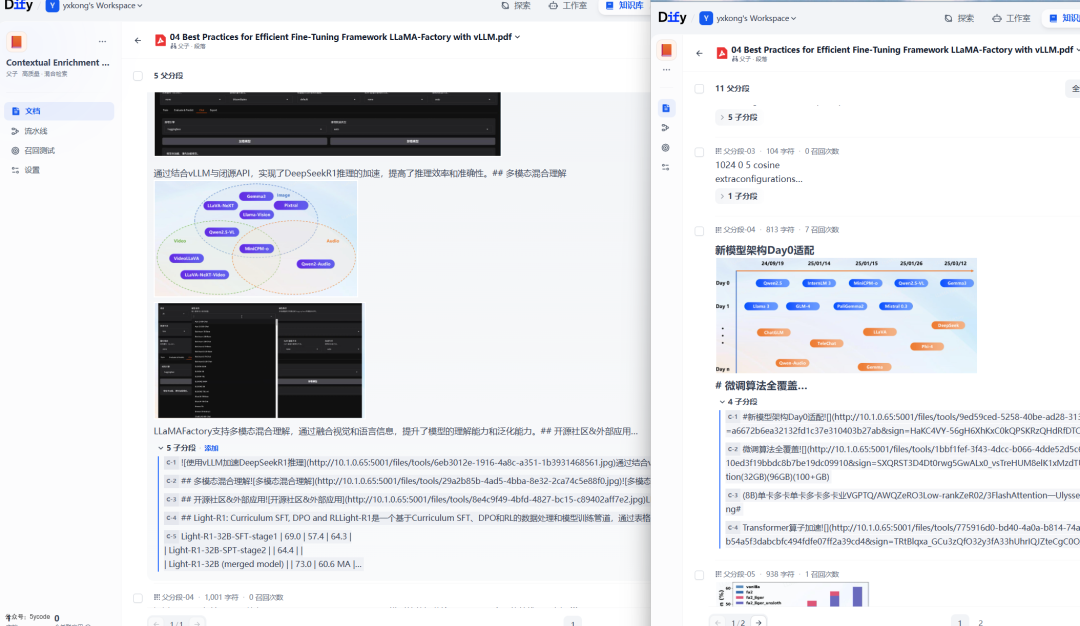
上图左侧为通过多模态增强的解析,右侧为只用mineru解析,可以看到

  • • 增加了多模态,只分了5段,根据语义做了归拢
  • • 单纯的mineru 解析出来了11个分段

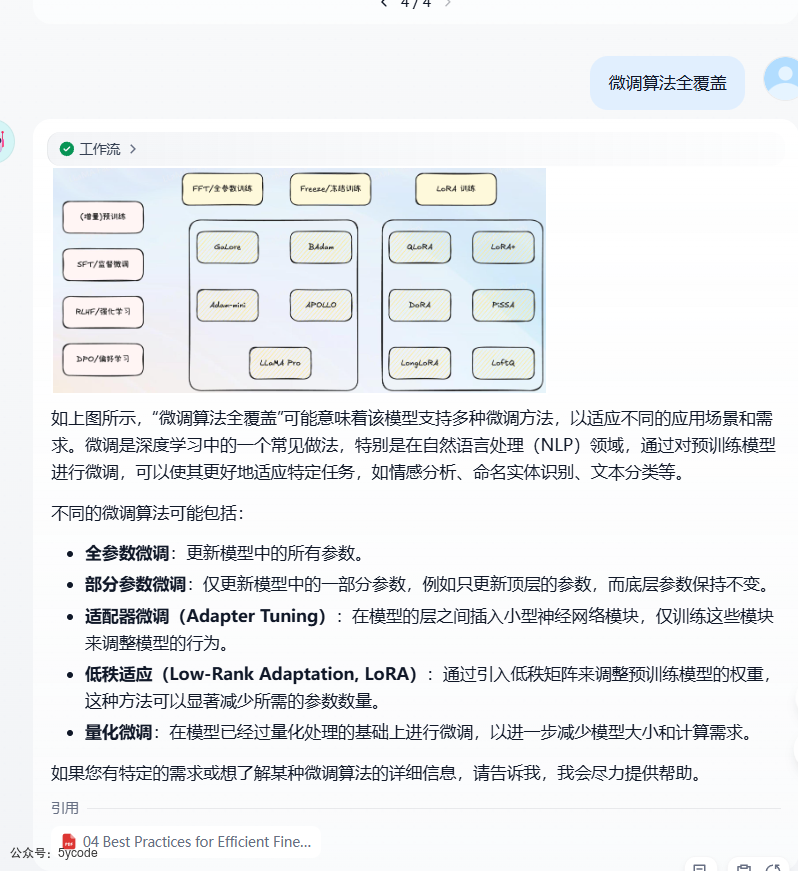
单纯的从解析出来的内容来看,多模态对图片进行了简单的描述,方便检索到对应的图片,同时内容的准确度也有极大的提升。
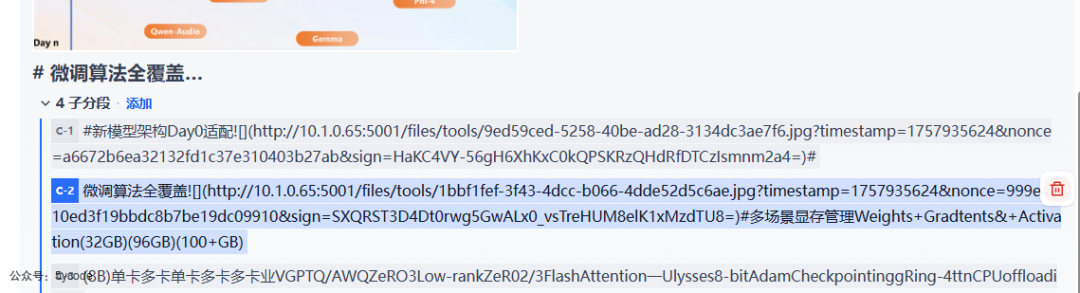
mineru只是对图片进行了简单的解析,图片后面跟的是后面的内容,并没有对图片进行描述。

其他

数据源插件

dify 2.0支持多种来源的数据。
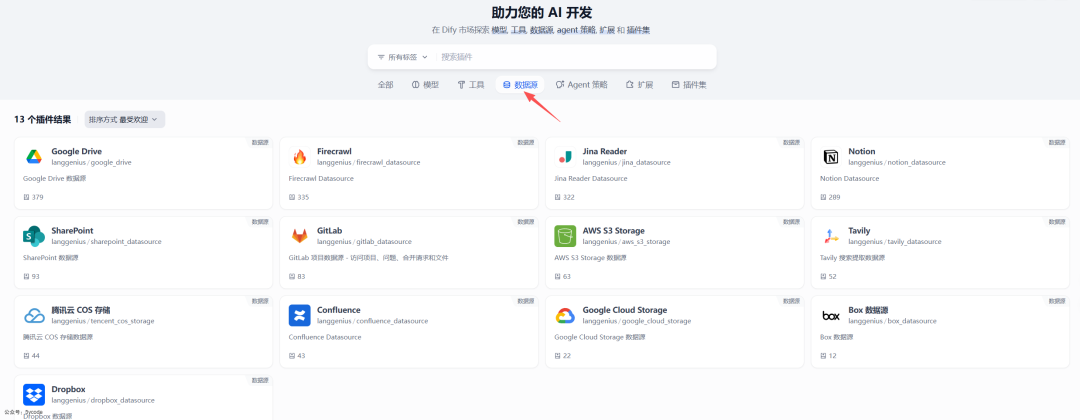
在插件市场有一个数据源的插件的分类。是数据管道支持的数据源类型。大家可以看看。

文档处理

文档处理器是一个特殊的插件,官方示例里有下面几种:

  • • 文档提取器 (Doc Extractor)
  • • Dify 提取器 (Dify Extractor):dify开发的内置提取器,针对 Doc 文件进行了专门优化。它能够从文档中提取图片,进行存储并返回图片的 URL
  • • MinerU
  • • Unstructured:将文档转换为结构化的机器可读格式,具有高度可定制的处理策略

在插件市场我们可以看到其他的插件,比如合合

分块器

目前dify官方支持三种分块器,其实就是知识库里的配置进行了抽取。

  • • 通用分块器 (General Chunker)
  • • 父子分块器 (Parent-child Chunker)
  • • 问答处理器 Q&A Processor (Extractor+Chunker)

每个分块器都有不同的特点和使用场景。

类型特点使用场景
通用分块器固定大小分块,支持自定义分隔符结构简单的基础文档
父子分块器双层分段结构,平衡匹配精准度和上下文需要较多上下文信息的复杂文档结构
问答处理器处理表格中的问答组合CSV 和 Excel 的结构化问答数据

分块器的设置,是在处理文档的时候进行设置,每个文档都可以自定义。

知识库配置

索引方式和检索设置参考原知识库设置即可。

常见问题解决

新建流水线空白
开启梯子,重新刷新即可。
mineru 异常

  • • 无法登录

  • •

    关闭梯子

图片不显示

按照下面的内容配置以后,销毁并重启服务

.env配置

# 配置文件外网路径,自己本机ip或者域名FILES_URL=http://10.1.0.65:5001# 内网地址,不能配置,否则无法显示图片INTERNAL_FILES_URL=

docker-compose.yaml配置

# 我增加了name,不加,默认为dockername: 'dify'  services:    # API service    api:      image: langgenius/dify-api:2.0.0-beta.2      ports:        - '${DIFY_PORTS:-5001}:5001' # 开放api的的端口,用于文件访问

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

Dify 2.0 重磅升级!知识管道登场,RAG 开发效率直接翻倍 上周dify发布了1.8.1以后,随后又发布了预览版dify 2.0.0 作为dify的大版本升级,更新的内容会比较多,如果是生产环境,建议先不要升级,等到正式发布以后再动,如果只是体验,可以直接升级。dify的下一个工作,rag2.0,当时我和他们的产品聊过rag2.0,核心的rag不会变动太多(dify本身rag能力够用,问题最多的在于文档格式)。单纯的从解析出来的内容来看,多模态对图片进行了简单的描述,方便检索到对应的图片,同时内容的准确度也有极大的提升。创建以后,可以看到依赖一堆的插件。 阅读详情

相关推荐

大模型——Dify 2.0 知识管道,赋予RAG前所未有的可控性

Dify 2.0 Beta版推出知识管道(Knowledge Pipeline)功能,为企业RAG(检索增强生成)提供可视化数据处理解决方案。该功能通过可拖拽节点实现数据源接入、文档解析、转换和加载的全流程管理,解决企业数据处理中的碎片化、解析丢失和处理黑箱化三大痛点。支持多种数据源连接、精细化ETL控制、7种场景模板及开放插件生态,使企业能灵活定制高效的数据处理流程。知识管道提升了RAG的可控性和透明度,降低企业技术门槛和维护成本。

1268

全网首发!Dify 2.0.0 图文混排上线,每个新功能都是爆款!附实战教程(建议收藏)

震惊,图文混合回答终于上线啦!Dify 2.0.0 全新升级,知识库模块全面重构!新增图文混排回答、拖拽式工作流、多源数据接入等功能,操作更直观。AI智能体的知识库也进入了可视化新时代。

sinat_29950703的博客 3270

Win11系统下Notepad++右键菜单失效?3种修复方法实测有效(附注册表备份指南)

本文针对Windows 11系统中Notepad++右键菜单失效的常见问题,提供了三种经过实测有效的修复方法。核心解决方案包括使用官方NppShell.dll重新注册、手动修复注册表项以及系统级问题排查,并详细说明了操作前的注册表备份指南,确保修复过程安全可靠。

m2n3b4v5c6的博客 328

大模型知识库构建利器:Dify 2.0知识管道全解析(小白也能学会,建议收藏)

文章介绍了Dify 2.0.0预览版的新增知识管道功能,该功能以流水线方式处理文档,提供了7种内置模板简化知识库构建流程。详细说明了升级步骤、知识管道创建方法(包括空白管道和内置模板),以及如何配置数据源、文档处理、文本分块和知识库设置。特别强调了父子分块器在处理复杂文档时的优势,并提供了复杂PDF处理和LLM上下文增强的实际案例,以及常见问题的解决方案。

2401_84815887的博客 2677

Xilinx FPGA MultiBoot实战:7Series与UltraScale的SPI Fallback配置详解

本文深入解析了Xilinx FPGA的MultiBoot(多启动)与Fallback(回退)功能,针对7系列与UltraScale/UltraScale+系列,提供了从约束文件编写、看门狗集成到镜像烧录的完整实战配置指南。文章重点对比了两个系列在SPI Fallback配置上的关键差异与注意事项,旨在帮助工程师构建高可靠、永不宕机的FPGA系统。

weixin_29197051的博客 547

机器人系统能用MQTT5.0代替ROS2吗?

更为灵活和友好的方案是通过把ROS(Robot Operating System)与MQTT(Message Queuing Telemetry Transport)协议相结合的解决方案,利用MQTT的轻量级、跨平台和广泛适用性特点,扩展ROS系统的通信能力,或将非ROS系统接入ROS网络。

QzmAIoT 2163

Dify2.0重磅升级!零基础到精通,Dify2.0实战教程一篇搞定!

Dify 2.0引入知识管道功能,提供7种内置模板处理不同类型文档,支持多种数据源和灵活分块策略。文章详细介绍了通用模式、复杂PDF处理和LLM上下文增强三种管道的创建方法,解决了升级过程中可能遇到的常见问题,如图片显示和MINERU配置等,为用户提供了一套完整的RAG2.0实施方案。上个月就给大家同步了dify的下一个工作,rag2.0,当时我和他们的产品聊过rag2.0,核心的rag不会变动太多(dify本身rag能力够用,问题最多的在于文档格式)。主要是也叫知识管道。

h1453586413的博客 2030

【芯片验证随心记】1.SystemVerilog中,rand和randc的区别?如何用constraint实现randc?

在SystemVerilog里,randc 的“不重复循环”特性是用一个 周期性排列器(permutation engine) 实现的,而这个引擎在 LRM 里并没有公开。我们只能在 “用户空间” 用 rand + constraint 去模仿它的行为。每次随机化只取 queue.pop_front(),用完再洗。在4次随机化内,y会依次出现0,1,2,3各一次(顺序随机)每次随机化,x可能是0-3中的任意值,可能连续多次相同。每次随机化时,在未使用的值里随机挑一个;第5次随机化时,重新生成新的排列周期。

qq_43172512的博客 342

Dify 2.0深度解析:知识管道重构RAG开发,从升级实操到场景落地全指南

对于复杂场景(如对接私有数据源、自定义分块逻辑),开发者可选择“空白流水线”,从零开始编排节点。添加数据源节点:在流水线画布右键,选择“数据源”,可接入本地文件、Firecrawl网页爬虫、Notion等,配置数据源参数(如API密钥、文件路径);配置文档处理节点:添加解析插件(如MinerU用于PDF图片提取,Unstructured用于多格式转换),设置处理规则(如是否开启OCR、公式识别);选择分块器。

weixin_54447959的博客 1438

导数与微分在 FPS 射击游戏中的实际应用:把“手感”算出来

摘要:射击游戏开发中,单线程适用于简单小游戏(如单机打靶),所有任务由主线程顺序处理,代码简单但效率较低;多线程则适合复杂场景(如多人在线3D大作),通过渲染、逻辑、网络、音效等线程分工协作,确保画面流畅、响应迅速和实时同步。选择依据取决于游戏复杂度、联网需求和性能要求,小型游戏用单线程,大型高要求项目必须采用多线程架构。(149字)

本博客聚焦游戏开发技巧、创业实战心得及大学热门课程干货。这里既有技术深度,也有思维广度,无论你是开发者、创业者还是高校学子,都能在这里找到适合自己的成长之路! 3278

YOLO26涨点改进 | 损失函数改进篇 | 引入SlideLoss,适配尺度变化+遮挡+难易样本不平衡,手把手配置+实战案例

COCO-Hard是COCO数据集的复杂场景子集,包含80个类别,重点筛选多尺度、遮挡密集样本,其中小尺度目标(<32×32像素)占比42%,大尺度目标(>128×128像素)占比28%,遮挡目标占比57%,场景涵盖人群密集、车流拥堵、复杂工业环境,完美模拟真实复杂检测场景,适合验证SlideLoss的适配性。

qq_36130719的博客 157

你的 RAG 还在“垃圾进,垃圾出”?我用这套流程,把“废料”文档变成了黄金知识库

你的 RAG 还在“垃圾进,垃圾出”?我用这套流程,把“废料”文档变成了黄金知识库 最近大家关注Dify的进展的话,应该知道它的版本更新直接从1.8.0—>2.0.1了。跨越了一个大的版本。它本次的主要更新就在于知识库构建的知识流水线。 我认为Dify2.0以后的知识流水线会极大地降低了构建知识库的门槛,未来也许能高效处理 80% 的相对标准的文档。

datian1234的博客 1145

RK3588 buildroot 制作的系统增加 docker 支持

RK3588 使用buildroot制作的系统添加 docker 和 docker-compose 的功能

荻夜的博客 1567

Dify 2.0.0 beta.2 发布,4 大提升,AI 开发效率飞升!

第二步,文字部分送到文本理解模块;不过,一个由我们中国团队主导的开源项目Dify,最近发布了一个新版本,叫Dify 2.0.0 beta.2,它就像是给AI应用开发领域带来了一套全新的、高效的施工方案,让原来复杂的事情变得简单了许多。现在,具备了多模态能力的AI可以直接“看”懂整张发票的布局,它能准确地知道哪个是抬头,哪个是总金额,中间的表格里又有哪些具体的消费项目。但是,大家可能不太了解的是,在这些光鲜亮丽的应用背后,开发它们的过程其实相当复杂和繁琐,对很多公司和开发者来说都是一个不小的挑战。

2301_76841790的博客 1301

【数据集】中国2003年至2022年全天空每日气温数据集

中国2003年至2022年全天空每日气温数据集

WW、forever的博客 603

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

25-Dify框架:开源大模型开发平台解析

Dify作为一款开源的大型语言模型(LLM)应用开发平台,致力于简化生成式AI应用的创建和部署,为开发者提供了一个全方位的AI应用开发环境。本文简单介绍Dify框架的基本内容。

rengang66的博客 948

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

【大模型实战】Dify 2.0.0图文混排实战:3个开关实现自动转URL,小白也能轻松掌握大模型图文问答

本文详细介绍了Dify 2.0.0实现图文混合输出的方法。通过修改docker/.env中的FILES_URL和INTERNAL_FILES_URL配置,并添加5001端口,实现自动转URL功能。文章演示了创建知识库、选择数据源、文本分段的完整流程,最终实现无需手动转换图片的图文问答功能。这一方法简化了操作,使小白用户也能轻松搭建图文知识库,掌握大模型图文问答技能。

datian1234的博客 2005

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

dify+数据库+登录可生成完整企业级查询操作2.0

还在为搭建 dify + 数据库场景时的登录功能发愁吗?这份超实用的工作流指南来啦! 跟着这份指南,你就能顺利搞定 dify 登录 + 数据库查询的综合操作!后续还会有更多有趣的工作流分享,感兴趣的话就赶紧进来学习,持续关注吧~

m0_74425792的博客 903

Dify自定义工具身份认证实战(OAuth 2.0深度解析)

掌握Dify自定义工具OAuth认证全流程,解决第三方服务安全接入难题。涵盖API对接、令牌管理与权限控制,适用于多场景集成,提升开发效率与安全性。方法实用,步骤清晰,值得收藏。

PixelStream的博客 993

AI应用开发平台,dify版本升级操作指引

-利用大模型,比如豆包、deepseek,比对最新的.env和docker-compose.yaml两个文件与备份的文件之间的差异(比对时后缀加上.txt方便比对,修改完成后再去除.txt后缀),提示词如下。--更新docker,powershell->切换到\dify\docker目录->docker compose up -d,等待更新完成。----请对两个文件进行比对,并指出新版本要修改的项及内容,以表格输出,.xxx.0811.txt为旧版本,要求如下。

soldierluo的专栏 693

【Dify】三分钟实现自己的聊天助手

Github 项目推荐。Dify:让您轻松便捷地实现从大模型到应用程序

qq_61567032的博客 9358

Dify 2.0图文混合输出实战教程:从零基础配置到图文问答精通,一篇搞定大模型应用!

本文详细介绍了如何在Dify 2.0.0平台上实现图文混合输出的完整流程。通过修改docker配置文件中的FILES_URL、INTERNAL_FILES_URL和端口设置,创建知识库并配置数据源,实现图片自动转换为本地URL,最终完成图文问答功能。教程提供了具体步骤和代码示例,帮助读者快速搭建图文知识库。字数 868,阅读大约需 5 分钟所谓“强中自有强中手”💯粉丝朋友在的时候就摸索出了🥳无论是手动还是自动,都是要把,才能实现图文共存。受粉丝朋友启发✊,笔者又摸索出一个,只要打开这。

h1453586413的博客 1699

Dify的搭建

Dify是一个开源的大语言模型应用开发平台,结合BaaS和LLMOps理念,支持开发者快速构建生成式AI应用。其核心功能包括应用创建、技术栈支持和企业级LLMOps平台。安装方式支持在线使用或本地Docker部署,本文详细介绍了Windows环境下通过Docker Desktop安装Dify社区版的步骤,包括环境配置、镜像源设置和部署流程。同时还提供了MySQL 8.0在Windows的安装指南,以及Dify连接MySQL的配置方法,涉及依赖库安装、端口设置和网络访问权限调整等内容。

weixin_46300935的博客 1376

Dify 和 Langflow 的版权协议对比

允许商业化和私有部署,但 Dify 对合规性要求更严格,Langflow 限制更少。(必须在衍生项目中包含原始许可和版权信息)若修改代码,需在衍生项目中清晰标注变更。:衍生项目可使用不同协议(包括闭源)涉及专利的场景更安全(有明确授权)。专利授权(贡献者自动授予专利许可)(对代码的修改需标注变更记录)子项目使用其他协议(包括闭源)(在软件副本中包含原许可声明)仅需保留版权声明,自由度更高。适合快速集成到商业闭源产品中。文件,需在衍生项目中保留。以原作者名义背书衍生项目。:衍生项目可任意更换协议。

openeis的专栏 1066

Dify条件分支节点全解析|10大典型应用场景配置方案详解|

本文将展开介绍Dify平台的条件分支节点,包括:核心功能与作用;关键配置项详解;10种条件分支节点的典型应用场景:金融风控、医疗健康助手、电商智能客服、内容审核平台、智能硬件IOT平台、智能招聘、K12教育、供应链管理、AIGC内容创作平台、智慧农业。

2401_82469710的博客 4121
上一篇: 使用MaxKB部署本地知识库问答系统,大模型入门到精通,收藏这篇就足够了!
下一篇: 手把手教你完全本地化部署本地知识库(基于RAGFlow + DeepSeek [+ Ollama])
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值