


1.1 提示词工程(Prompt Engineering)
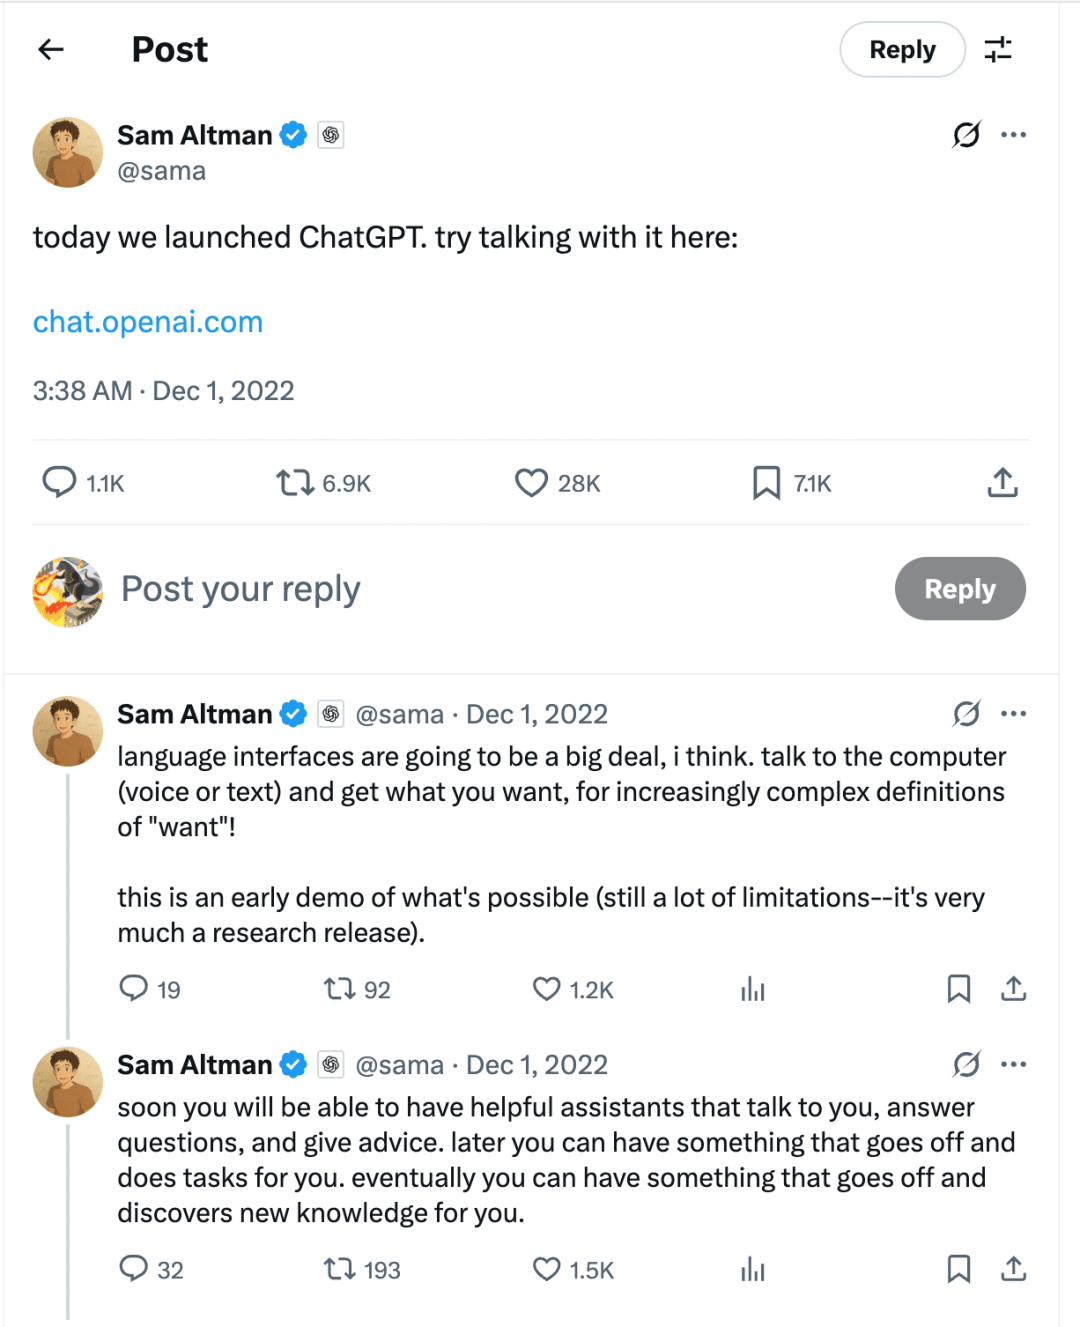
上面这个是OpenAI的CEO Sam Altman在2022年12月发的一条推文,预示着ChatGPT正式走上历史的舞台。在那之后,ChatGPT在5天内就达到了百万个用户
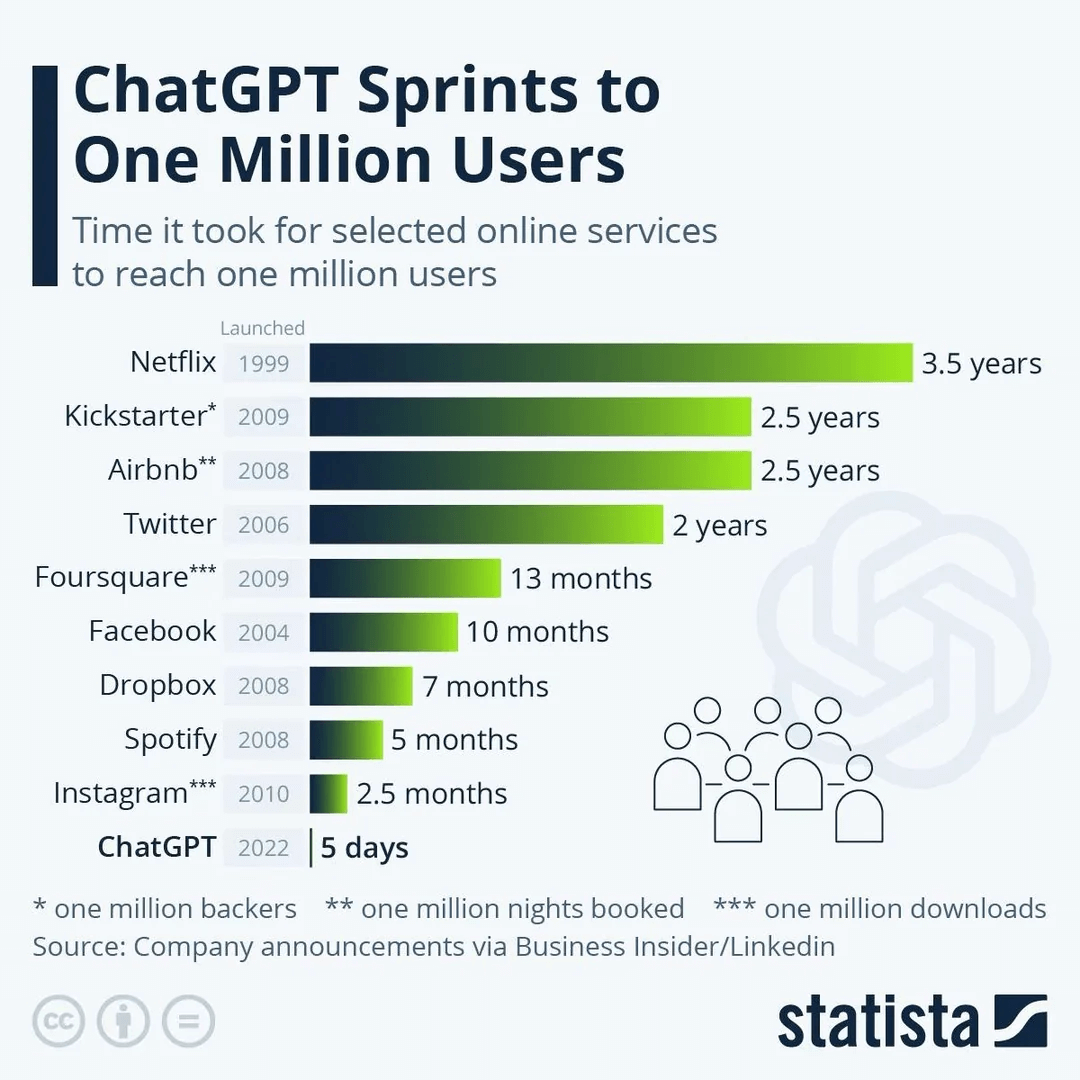
支撑ChatGPT风靡全球的根源是大语言模型(LLM,Large Language Model)。这是一个以神经网络为基础训练出来的模型,和早期的神经网络不同,ChatGPT是基于Google在2017发布的Transformer架构[1]所训练出来的大语言模型。
Transformer架构引入了注意力机制(Self-Attention),使得模型在处理每一个词语时,能够动态地关注序列中其他所有词的位置与关系,从而更有效地理解语境、捕捉长距离依赖信息。
基于Transformer架构的强大能力,OpenAI掀起了新一轮人工智能革命的浪潮,大语言模型正式进入了大众的视野。各大科技公司和AI初创企业开始投入大语言模型军备赛,争相推出参数级别更大的模型以达到更好的智能水平。
基于这个之下,**提示词工程(Prompt Engineering)**应运而生,成为激发大语言模型潜力的关键手段,也逐渐发展为一个全新的学科方向和新兴职业领域。提示工程主要关注提示词的设计、优化与策略制定,致力于帮助用户更高效地调动大语言模型的能力,进而推动其在各类实际场景和研究领域中的应用。
掌握提示工程技能,不仅能够提升使用效率,还能深入理解大语言模型的能力边界与局限性。研究人员通过提示工程可以显著增强模型在问答、逻辑推理、数学计算等复杂任务上的表现;开发者则可以借助提示策略,构建与LLM或外部工具的协同工作流,推动AI系统的实用化落地。
值得注意的是,提示工程不仅限于编写好提示词,它涵盖了与大语言模型交互、对接、调优等多项技术与方法,涵盖了从模型安全性提升、能力增强(如引入专业知识库或调用外部工具等)到产品级提示结构设计等多个维度。
了解完背景之后,现在我们来进一步看看什么是提示词。首先我们用一简单的例子来展示:
Leo: 我是
上面是我和ChatGPT的对话,可以看到,一开始我们发送我是的时候,它并没有补全句子,这是因为ChatGPT在系统提示词里被设定为聊天导向型的助手了,所以它不会无脑的补充你发的话,虽然这个行为是大语言模型的本质(预测下一个Token)。
我们在第二次的时候,增加了提示词,也就是补全这个句子:这段话,这个就是一个简单的提示词,告诉大语言模型应该做什么,应该怎么做。这也是提示词的核心。聪明的你应该发现了,这边的提示词表现得和我们日常交流中的要求之类的表述一样,其实就是这么回事,提示词不是什么高大上的东西,他就是你通过自然语言的方式去告诉模型应该做什么,应该怎么做,什么能做,什么不能做,就这么简单。
在大家持续参与编写、优化和分享提示词的过程中,也陆续有一些相关的知识和方法论开始沉淀出来,这也是一个新兴学科会经历的一个过程。在我们实践过程中,提示词的写法也是有迹可循的,通常会包含以下这些部分:
•指令(Instruction):明确告诉模型需要它做什么
•上下文(Context):相关的背景信息,让模型有更多的上下文用于决策
•输入数据(Input Data):必要的输入,可以是问题、目标等
•输出提示(Output Constraints):约束输出格式、风格或长度,让结果更符合你的需求
给一段简单的提示词构成:
You are ChatGPT, a large language model trained by OpenAI, based on the GPT-4.5 architecture.
这是一份GPT4.5的系统提示词(System Prompt),下面我翻译成一版中文的
你是ChatGPT,基于GPT-4.5架构的大型语言模型,由OpenAI训练。
里面包含了明确的指示,比如:
bio工具已禁用。不要向其发送任何消息。如果用户明确要求你记住某些内容,请礼貌地要求他们前往设置>个性化>记忆来启用记忆功能
还提供了一些相关的背景信息,比如:
你是ChatGPT,基于GPT-4.5架构的大型语言模型,由OpenAI训练。
还有对于输出的一些限制和格式要求:
期望一个符合此模式的JSON字符串:
因为这个是System Prompt,所以没有包含用户输入。
我们可以通过观测一些主流的ChatBot、AI Agent的System Prompt来学习提示词的编写。我在附录里放了一些主流的Prompt供大家进行学习。
不过现在很多提示词的学习资料已经略显过时了。随着模型能力不断演进,简单的Prompt已经不再是问题的全部,真正影响AI表现的,是它知道什么、记住什么以及如何组合信息。于是**上下文工程(Context Engineering)**逐渐浮出水面,也将提示词工程取而代之,成为目前人人追捧、研究的对象。
1.2 上下文工程(Context Engineering)
1.2.1 What:上下文工程是什么?
“Context engineering is the delicate art and science of filling the context window with just the right information for the next step.”
——Andrej Karpathy
**上下文工程(Context Engineering)**这个名词并不新,但是在今年以来持续获得关注,尤其是当Karpathy在2025年6月25日引用了Shopify CEO Tobi Lutke那条推文[2],并发表了简洁但深刻的推文[3]之后,全行业开始认真对待上下文工程这个概念、艺术、实践,或者甚至可以说是一个学科。
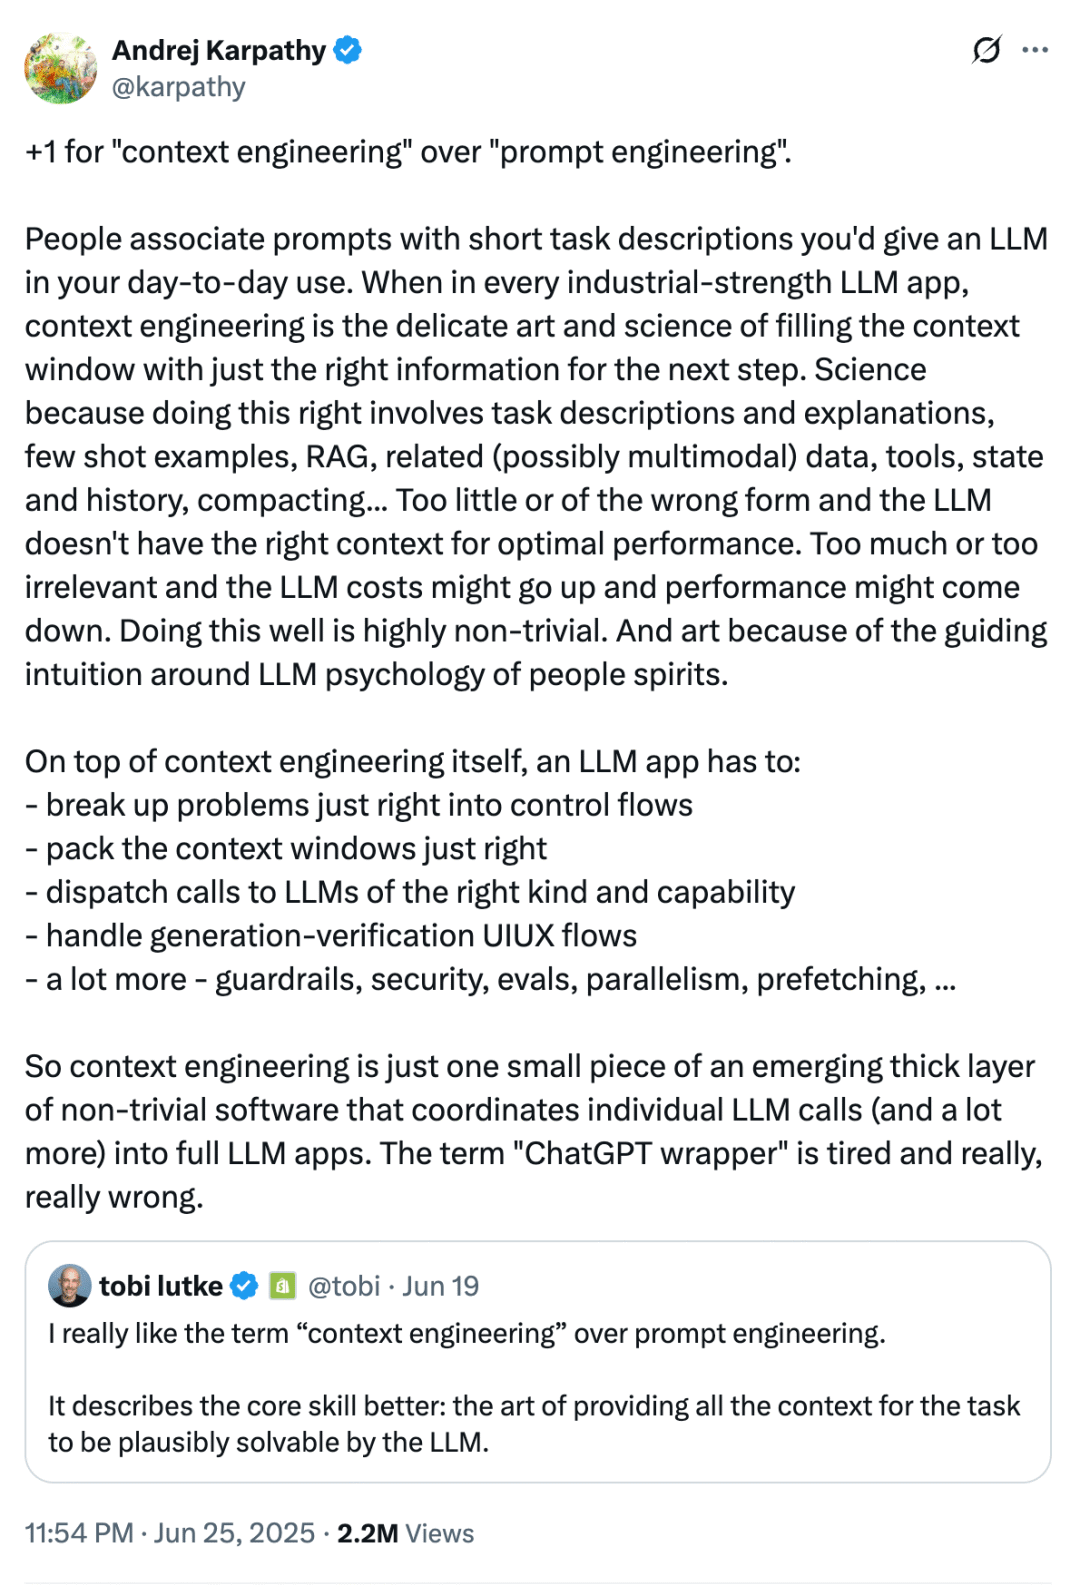
Karpathy在Y Combinator Startup School的演讲里提出Software 3.0的概念,里面将大语言模型(LLM,Large Language Model)类比成新一代的操作系统(OS,Operating System),上下文窗口(Context Window)是它的 内存RAM,而上下文工程,就是这个操作系统中的调度器,负责把最重要的进程和数据装进有限的内存中。
简单说,上下文工程是一种为大语言模型构建、优化、动态管理输入上下文的工程化方法。不单单是写好提示词,更是一个系统化的过程,包括:
1.信息收集和整合:从多源数据中获取与任务高度相关的内容
2.结构化和格式化:将信息结构化组织,按照一定格式提供给大模型
3.上下文管理:在有限的上下文窗口内,通过裁剪、隔离、压缩、持久化等手段来管理
4.工具和外部系统接入:通过与外部工具和系统交互,增强模型的能力
本质上,上下文工程是让大模型在特定场景下具备即插即用的任务能力,大模型在推理的时候所拥有的只有训练阶段获得的能力+上下文内容,在前者无法改变的情况之下,后者显得尤为重要,不管大模型曾经执行或者交互过多少轮次,最新的这次只能依赖所提供的上下文去做推理,因此上下文在推理阶段才如此重要。
1.2.2 Why:为什么需要?
为什么我们需要上下文工程呢?
首先是大语言模型需要上下文,在上下文缺少的情况之下,哪怕模型能力特别强,也无法给出正确的结果,就好比我们需要一个人去送快递,却不告知收件地址,那无论这个快递员开车多么溜,对于这个城市或这个片区的路有多么的熟悉,也无法顺利将快递送到收件人手中。
其次是,错误源于信息不足,而不是模型不够好。回到前面这个例子,当我们只告知快递员一个精确到楼栋的地址,却给了错误的手机号,快递员无法联系上收件人,这种情况之下如果快递员仍想努力送达,那么只能针对这栋楼挨家挨户的问了。这个在大模型的应用之中是很常见的一个情况,当我们需要大模型帮我改一个文件里面的代码,但是我们却没有给到其对应文件的代码,大模型是完全不知道怎么改的,或者说我们要改一个接口的功能,我们给了接口层的代码,却没有给数据库操作的代码,大模型依然无法帮我们从接口出发,一条龙的改下去。
就好比前段时间Anthropic的Claude Code(下称CC)大火,很多技术人员纷纷从Cursor转投CC的怀抱,抛开商业,这背后就是CC的上下文工程完胜Cursor的上下文工程。就拿目前Coding能力最强的模型Sonnet4和Opus4来说,Cursor和CC底层都基于一样的模型的情况之下,出来的效果都大不相同,CC可以更好地调用系统命令,更智能地从一个需求,到计划处几个目标,再到执行,最后再结合编译或者运行来做验收,整个过程每一步都是在处理上下文,都是在上下文工程的范畴之内。CC也因此获得了很多专业人士的喜好。我们也能看到一些用户通过CC去调用Kimi的K2模型或者Qwen的Coder模型,都能获得不错的效果,这正是因为CC本身的上下文工程的底子足够好,不管底层调用什么大语言模型,都可以最大程度发挥出模型的能力。
最后是复杂任务及多源信息融合的挑战。现实生活中的任务,通常并不是一个单一信息源就能完成的,就好比我们写一篇文章,我们需要浏览器查阅资料,需要通讯软件和别人交流和交换思想,也需要一个编辑器来写文章,最最后可能还需要有一定的平台或软件来分发我们的内容。这本身就涉及多个信息源,也需要和多个外部工具或系统交互。围绕着大模型,2025年是AI Agent大流行的一年,从单Agent到多Agent(Multi-Agent)追求的都是可以让大模型自主决定与外部交互的动作,并能在任务完成前持续的决策和交互。例如现在以Devin、OpenHands和Manus为主的AI Agent就为大模型配备了浏览器、编辑器、命令行(Shell),这可能就是一个程序员的标配,这样大模型就有了与外界交流的三个主要工具,因此可以自动化完成任务了。
从告诉模型做什么的Prompt阶段,到为模型准备什么认知环境的Context阶段,这是一种根本性的思维方式转变。上下文工程不是锦上添花,而是AI应用时代的关键基础设施。它不仅决定了LLM是否聪明,更决定了它是否有用。换言之:训练和微调决定了模型的能力,上下文工程则决定了模型能发挥出多少能力。
1.2.3 How:如何做呢?
在知道了上下文工程是什么以及为什么需要上下文工程之后,我们抛出最后一个问题,我们应该怎样做呢?
虽然上下文工程今年火起来,但是背后的技术和解决方案一直在发展,这也符合发展规律,一个学科发展就是经历了高速发展的野蛮生长阶段,在这一阶段会针对不同的问题产生出不同的解决方案。直到各种技术发展趋稳,并被广泛接受和应用之后,体系化就会出现,也预示着学科的诞生。这也是上下文工程在这个时候出现并不是偶然的,而是发展阶段到达需要关注上下文工程的时候,同时配套的技术和解决方案也趋于成熟。
我们看看Philschmid[4]对于上下文工程的一个维恩图:
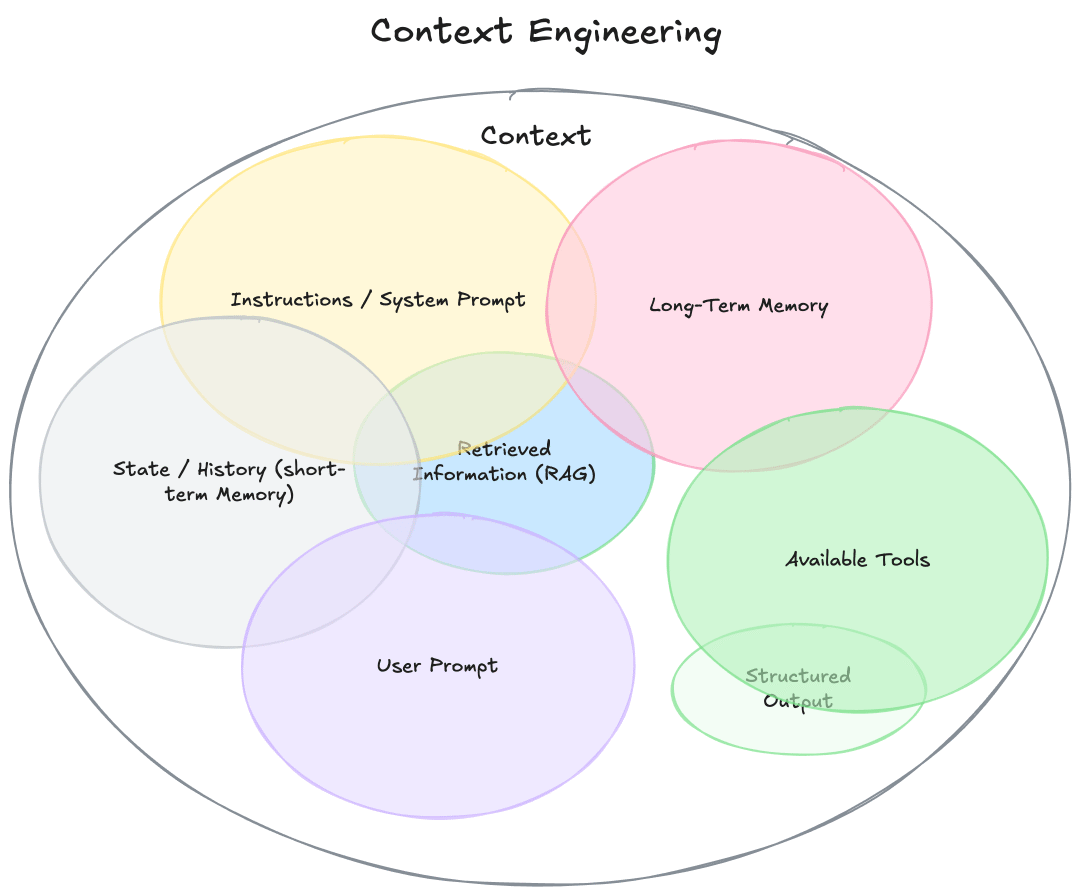
这张图用较为直观的方式展示了上下文工程中,目前涉及的一些技术手段,有我们场景的RAG、提示词技术(Prompt)、工具,也有一些记忆系统。这也是本书的核心,就是通过系统化的方式学会上下文工程的相关技术理论,并进一步学会如何实践。
关于这些技术,我这边就不展开讨论了,我们在第二部分,也就是第四章开始,会有详细的介绍。
1.3 两种范式的本质差异
**提示词工程的目标,是用一句话、一段话、一个格式、一个role prompt来激发模型的潜力。**它像是给模型下达精心措辞的指令,让它在你设定的框架内回答问题。这在早期以ChatBot这种聊天助手为主的AI应用场景里一度非常有效,尤其是当时大模型没有记忆、没有外部知识:
•静态、单轮、指令导向
•适用于封闭任务、结构化回答
•零样本提示/少样本提示/思维链提示 等技巧层出不穷
但它的局限也很明显:
•缺乏灵活的记忆管理,每轮对话要么是孤岛,要么是历史记录堆积
•无法有效处理任务链条和复杂流程
提示词(Prompt)和这个词本身透露出的含义是一致的,也就是围绕着提示这个目标来构建对应的文本,因为目前的大语言模型底层是依托于Transfomer架构,本身就是基于神经网络结合注意力机制来做的概率计算,因此在有提示词的情况之下,可以让大语言模型关联注意到这些提示词,进而在生成结果的时候,有更高的概率是在这个方向上去生成。
但是随着技术的发展,尤其2024年以来,函数调用和MCP的发展普及,进一步推动了大模型调用外部工具的需求和场景,另外以Agent为主的AI应用形态开始大流行,各种Agent不断涌现,**此时对于上下文的管理已经从早起的简单对话形态进展到了需要各类技术辅助才能有效管理的阶段。**这样就有了上下文工程的出现。
上下文工程的出发点不同,它不再把模型当作回答者,而是当作协作者或者说希望模型有一定的“自主性”。这也是目前AI Agent的实践中很重要的一个认知和目标,就是**让模型可以在运行时持续的获取相关的信息,基于这些信息做出最佳的决策,产生最合适的结果。**它更像是构建一个运行环境,包含:
•信息架构设计
•记忆系统(短期 / 长期)
•检索增强(RAG)
•工具调用
特点:
•动态、多轮、环境导向
•支持状态管理、任务演进、链式推理
•具备Agent级别的操作能力
在明确了上下文工程的概念、必要性与应用范式之后,我们将从下一章开始,深入拆解支撑上下文工程的关键技术栈与实现思路。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 822


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


