Llama 2 + GPT4All + Chroma实现100%本地化RAG,大模型入门到精通,收藏这篇就足够了!

本地运行Llama 3实战指南:Ollama+GPT4ALL双轨工作流 大语言模型(LLM)本地化部署是当前AI工程落地的关键路径,其核心在于平衡推理性能、硬件约束与开发效率。Llama 3作为开源高性能模型代表,凭借8B参数量级与优异的中文代码理解能力,成为轻量级本地AI的理想选择;而Ollama通过GGUF量化与统一API抽象,显著降低GPU显存压力并支持自动化集成,GPT4ALL则提供低门槛桌面交互体验。二者协同构成‘开发-验证-交付’闭环,广泛应用于VSCode智能编程辅助、企业文档RAG问答、离线数据处理等场景。本文基于真实笔记本硬件环境(i7+RTX3060),详解 阅读详情

今天为大家带来的分享是如何实现100%本地化的大模型应用。我们利用LangChain的模板来创建一个RAG应用,在它的架构中,生成模型采用Llama2,Embedding模型采用GPT4All所提供的组件,向量存储则是Chromadb。

为什么做这期分享呢? 原因在于,在AI应用的开发中,开发者广泛使用OpenAI等大模型供应商的服务。而随着开发的深入,越来越多的用户发现,在这些模型的使用中,个人数据会交给外部模型处理, 这带来了巨大的隐私泄露的风险。随之而来的,是对纯本地化解决方案的探索。

今天我们就利用LangChain模版来快速构建一个纯本地化的RAG应用。这是一款完全不需要网络就能执行的应用。那我们现在就开始吧。

分享共分为三个部分。

1 - 什么是LangChain模版?

LangChain Templates(模版) 提供了一系列易于部署的AI应用架构,任何人都可以使用,可以开发并贡献,以帮助开发人员更快地投入生产。这是创建、共享、维护、下载和自定义链和代理的新方式。它们都采用标准格式,可以轻松地通过 LangServe 部署,使开发者能够轻松获得产品级的 API产品,同时也提供Playground供测试和体验。

2 - 什么是Ollama?

Ollama是允许开发者在本地运行开源大模型(比如Llama 2)的开源工具。Ollama将模型权重、配置和数据捆绑成一个单一的包,由一个模型文件(Modelfile)定义。它优化了设置和配置细节,包括GPU的使用。

Ollama的官方代码仓库:https://github.com/jmorganca/ollama

3 - 利用模版rag-chroma-private创建RAG应用

我们现在开始创建应用。

首先安装LangChain CLI。这是使用LangChain模版的重要工具。

$ pip install -U langchain-cli

现在就可以在命令行中使用 langchain 命令。

利用该CLI创建LangChain应用 private-llm 。命令如下:

01coder@localhost langchain-templates % langchain app new private-llm``What package would you like to add? (leave blank to skip):` `01coder@localhost langchain-templates % cd private-llm` `01coder@localhost private-llm % ls``Dockerfile      README.md       app             packages        pyproject.toml

接下来为应用添加模版 rag-chroma-private。此模板实现RAG,并不依赖外部API。它利用了Ollama提供的Llama 2模型,GPT4All用于Embedding,以及Chroma用于向量存储。

01coder@localhost private-llm % langchain app add rag-chroma-private```Would you like to `pip install -e` the template(s)? [y/n]: y```Adding https://github.com/langchain-ai/langchain.git@master...` `- Downloaded templates/rag-chroma-private to rag-chroma-private``......``Successfully installed asgiref-3.7.2 bcrypt-4.1.1 ...``   ``To use this template, add the following to your app:``   `` ```````from rag_chroma_private import chain as rag_chroma_private_chain``   ``add_routes(app, rag_chroma_private_chain, path="/rag-chroma-private")`` ```

现在将上述命令执行的输出最后给出的代码加入app/server.py。

from rag_chroma_private import chain as rag_chroma_private_chain``   ``add_routes(app, rag_chroma_private_chain, path="/rag-chroma-private")``   

这条route正是该langchain应用在该模版的支持下提供的接口。

在运行该应用前,还需要安装Ollama,以支持本地运行开源大模型,比如Llama 2 7B。

按 https://github.com/jmorganca/ollama 提供的安装指令完成安装,我们应该在命令行可以使用工具 ollama 。通过如下命令拉取期望使用的模型。模版 rag-chroma-private 使用的是模型 llama2:7b-chat,我们通过如下命令拉取:

$ ollama pull llama2:7b-chat

启动 ollama 服务

$ ollama serve

现在可以通过以下命令,启动应用 private-llm。

$ langchain serve

正常启动后,我们期望看到如下输出:
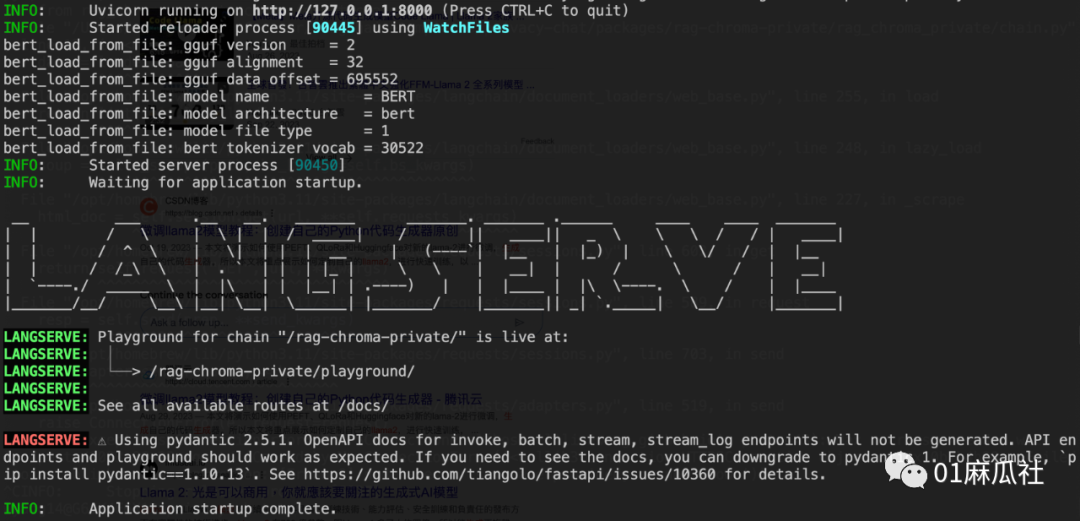
我们来试试Playground。浏览器中访问:

http://127.0.0.1:8000/rag-chroma-private/playground/
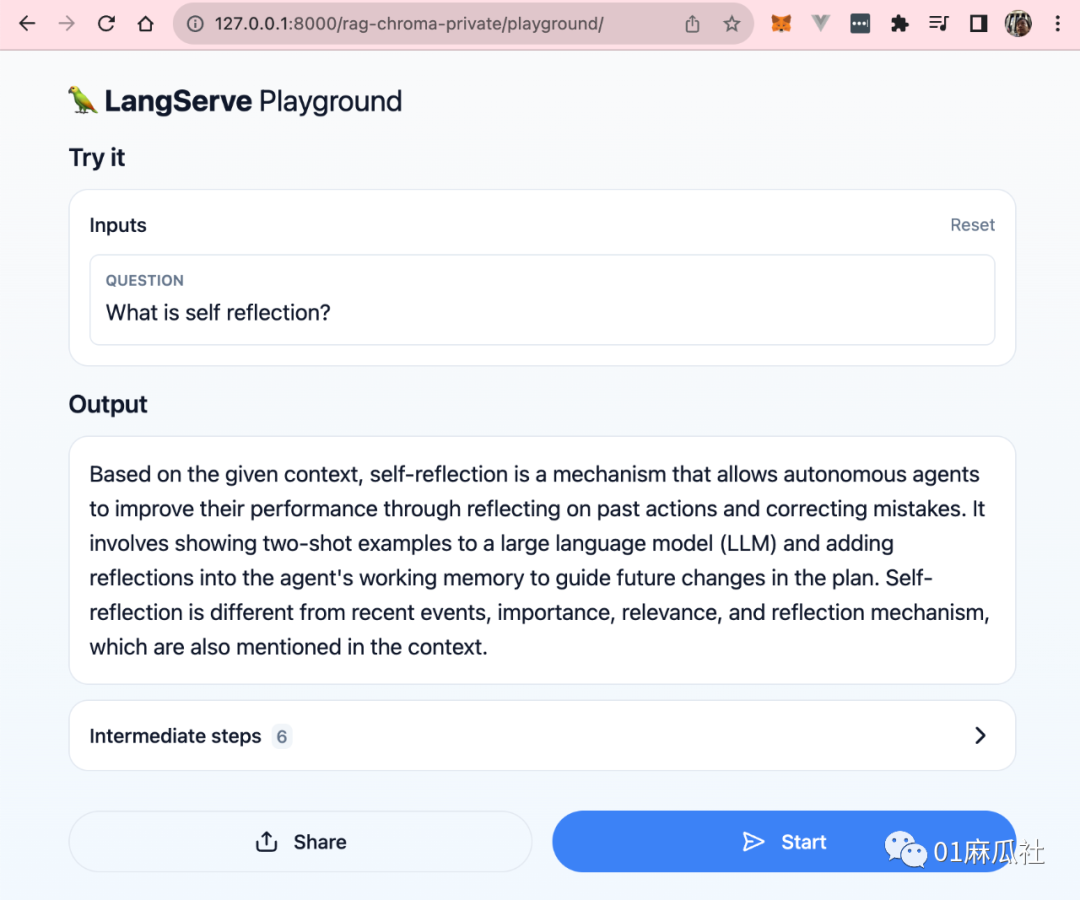
该RAG应用的知识库是什么呢?我们看看模版源码就清楚了。

https://github.com/langchain-ai/langchain/blob/master/templates/rag-chroma-private/rag_chroma_private/chain.py

模版的核心代码chain.py中,定义了加载的数据。

loader = WebBaseLoader("https://lilianweng.github.io/posts/2023-06-23-agent/")``data = loader.load()

正是这一篇博文 LLM Powered Autonomous Agents:

https://lilianweng.github.io/posts/2023-06-23-agent/

大家可以基于这篇文章的内容来问答。


好了,今天就分享到这里。虽然是个非常简单的RAG应用,但是也期望能以此给到大家一些启发,如何利用优秀的开源项目,帮助开发者快速构建100%本地化的AI应用,为用户提供优秀的产品体验时,确保用户数据的隐私性。


想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

GPT4All本地大模型实战:CPU运行GGUF量化模型指南 本地大模型是指无需联网、不依赖GPU、在普通笔记本上即可运行的轻量级大语言模型,其核心原理是模型量化(如Q4_K_M)与CPU推理优化,结合GGUF格式实现高效加载与跨平台一致性。该技术显著降低AI使用门槛,具备数据隐私强、部署成本低、合规性高三大技术价值,广泛应用于企业内网AI助手、开发者快速验证、离线文档问答等场景。本文聚焦GPT4All框架,深入解析GGUF格式优势、CPU推理优化机制及真实环境下的模型选型、RAG集成与LoRA微调实践。 阅读详情

相关推荐

开源大模型实战指南:从LLaMA部署到RAG应用开发

Transformer架构作为现代大语言模型的核心,通过自注意力机制和前馈网络等组件实现了强大的序列建模能力。其技术价值在于为自然语言处理任务提供了统一的框架,推动了AI技术的民主化进程。在实际应用中,开发者常面临模型部署、资源优化和领域适配等工程挑战。针对这些需求,以LLaMA为代表的开源模型生态提供了可行的解决方案,结合LoRA微调技术和RAG检索增强生成框架,能够在有限算力下实现高效的模型定制与应用开发。本文聚焦于开源大模型的实战落地,详细拆解了从环境搭建、模型量化到微调优化的全流程,并深入探讨了如何

weixin_30696427的博客 409

Llama 2 + GPT4All + Chroma实现100%本地化RAG

今天为大家带来的分享是如何实现100%本地化的大模型应用。我们利用LangChain的模板来创建一个RAG应用,在它的架构中,生成模型采用Llama2,Embedding模型采用GPT4All所提供的组件,向量存储则是Chromadb。

pythonhy的博客 1256

大模型入门必知:从Transformer到RAG的100个核心概念解析

Transformer架构作为现代大语言模型的核心,通过自注意力机制实现了对长序列的高效并行处理,奠定了模型理解与生成能力的基础。其编码器-解码器结构衍生出BERT、GPT等不同架构,分别擅长文本理解与生成任务。基于此,检索增强生成(RAG)技术通过结合外部知识库与生成模型,有效缓解了模型幻觉问题,提升了回答的准确性与时效性,成为企业级AI应用的关键解决方案。掌握这些基础原理与技术价值,是理解大模型训练流程、性能评估及实际应用场景的起点,也是构建智能问答、内容创作等实践项目的认知基石。

478

最新ChatGPT GPT-4 相似匹配Embedding技术详解(附ipynb与python源码及视频讲解)——开源DataWhale发布入门ChatGPT技术新手从0到1必备使用指南手册(一)

如果您想提高文本处理的效率和精度,那么Embedding技术就是您必须掌握的最重要利器。在本文中,不仅将详细介绍Embedding的基本概念,还将通过实际代码演示如何使用相关API,其中包括LMAS Embedding API和ChatGPT API等。同时还深入剖析Embedding在QA应用、聚类应用和推荐应用方面的具体应用场景。

小胡说人工智能的博客 8544

本地化YouTube视频RAG系统构建指南

向量检索增强生成(RAG)是一种将大语言模型与外部知识源结合的关键技术,其核心原理是通过嵌入向量实现语义级信息检索,从而突破模型上下文长度限制并显著降低幻觉率。该技术具备轻量化部署、数据隐私可控、响应延迟低等工程优势,广泛应用于企业知识库、音视频内容理解、培训资料智能问答等场景。本文聚焦于YouTube视频的本地化RAG实践,基于Whisper语音识别、all-MiniLM-L6-v2嵌入模型与ChromaDB向量数据库,构建端到端可离线运行的视频结构化问答系统,完整覆盖从URL下载、时间戳字幕清洗、语义分

chenshixi3325的博客 461

使用本地 Llama 2 模型和向量数据库建立私有检索增强生成 (RAG) 系统 LangChain

在人工智能领域,获取最新且准确的数据至关重要。检索增强生成(RAG)模型证明了这一点,它作为人工智能生态系统中的既定工具,利用大型语言模型与外部数据库的协同作用,提供更精确和最新的答案。借助 RAG,您不仅能获得黑匣子答案,还能获得黑匣子答案。您将收到基于直接从最新数据源提取的实时信息的见解。然而,当 RAG 拥有可靠且高效的数据源时,它的力量才能真正发挥出来。这就是非结构化的闪光点。想象一下,有一个以各种格式和位置分布的数据宝库,利用它的任务感觉非常艰巨。

iCloudEnd的博客 1694

从 GPT4All 体验 LLM

大型语言模型最近变得流行起来。ChatGPT很时髦。尝试 ChatGPT 以了解 LLM 的内容很容易,但有时,您可能需要一个可以在您的计算机上运行的离线替代方案。在这篇文章中,您将了解 GPT4All 作为可以安装在计算机上的 LLM。

ygtu2018的博客 866

[医学图像分割综述] Medical Image Segmentation Using Deep Learning: A Survey

本综述有两个独创之处,首先,与传统的调查方法直接将医学图像分割的文献划分为多个组,并对每个组详细介绍文献的方法相比,我们将目前流行的文献按照从粗到细的多层次结构进行分类。其次,本文重点研究了监督学习和弱监督学习方法,但未包括无监督方法,这种方法目前在医学图像领域并不流行。对于监督学习方法,我们从骨干网络的选择、网络块的设计和损失函数的改进三个方面对文献进行了分析。对于弱监督学习方法,我们分别根据数据增强,迁移学习和交互式分割研究文献。与已有的调查相比,本次调查的文献分类与以往有很大的不同,更便于读者了解相关

qq_38932073的博客 4万+

藏在笔记本里的大语言模型 - GPT4All

GPT4All支持多种不同大小和类型的模型,用户可以按需选择。序号模型许可介绍1商业许可基于GPT-J,在全新GPT4All数据集上训练2非商业许可基于Llama 13b,在全新GPT4All数据集上训练3商业许可基于GPT-J,在v2 GPT4All数据集上训练。4商业许可基于GPT-J,在v1 GPT4All数据集上训练5商业许可基于GPT-J,在v0 GPT4All数据集上训练6非商业许可。

Gefangenes的博客 1648

Postman账号

Postman账号一、为什么要注册一个Postm账号二、如何注册Postman账号三、登录账号四、切换账号五、找回账号密码 一、为什么要注册一个Postm账号 注册Postman账号是免费的。当注册并登录一个Postman账号后,用户可以获得一下权限。 (1)同步和备份历史、集合、环境和预置头。 (2)可以轻松处理来自不同机器的多个Postman实例‘ (3)创建集合链接发送给其他开发人员。 当然,不注册也可以使用Postman。 二、如何注册Postman账号 (1)下载、安装Postman应用程序。 (

精益求精,永无止境,永远在路上! 6775

STM32H750实战:如何用CubeMX配置NAND Flash时序(附常见问题排查)

本文详细解析了STM32H750通过CubeMX配置NAND Flash时序的实战技巧,包括硬件连接、时序参数计算与优化策略,以及常见问题如RGB屏幕干扰、多片选冲突的解决方案。特别针对NAND Flash的时序配置和抗干扰设计提供了实用代码示例和优化建议,帮助开发者提升系统稳定性和性能。

weixin_29176179的博客 363

GPT4All-J + LangChain 本地化部署实战指南

大语言模型(LLM)的本地化部署是企业级AI应用的关键路径,尤其在数据合规、低延迟和离线可用等刚性需求下,轻量级模型与推理框架的协同成为技术落地核心。GPT4All-J凭借4-bit GGUF量化、CPU友好设计及2.1GB内存占用,显著降低边缘设备部署门槛;LangChain则通过RetrievalQA链、ConversationBufferMemory等模块,系统性解决RAG构建、对话状态管理与工具编排难题。二者结合,可在无GPU的16GB内存办公机上实现稳定<200ms响应的生产级知识问答系统,广泛适

angw337679452的博客 398

unet学习笔记(milesial/Pytorch-UNet)

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 unet学习笔记(milesial/Pytorch-UNet)原理讲解unet_parts.py内容predict.py内容 所用到的代码Pytorch-UNet/predict.py at master · milesial/Pytorch-UNet ·GitHub 原理讲解 蓝/白色框表示 feature map; 蓝色箭头表示 3x3 卷积,用于特征提取; 灰色箭头表示skip-connection,用于特征融合; 红色箭头.

weixin_67138138的博客 2553

给大模型通过RAG挂上知识库

本文介绍了三种实现大模型+知识库的方法:1. 图形化工具:推荐GPT4All和腾讯iMA,操作便捷但功能有限,存在不支持Markdown等不足;2. Open-WebUI:适合依赖Ollama运行模型的用户,支持更多自定义功能;3. 工程化方案:使用Langchain+Chroma组合,详细展示了代码实现流程,包括文档加载、向量转换、相似度搜索等操作,并提供了完整的Python代码示例。文章比较了不同方案的适用场景,指出工程化场景建议采用Langchain+Chroma方案,而简单尝试可选择图形化工具。

jike007gt的博客 1037

力软敏捷开发框架源码7.0.6旗舰版 JNPF开发平台3.4.5 企业版 旗舰版

JNPF作为作为一款深受用户喜爱的低代码产品,凭借雄厚的科研技术力量、丰富的软件开发项目经验、严谨的项目开发流程和高质量的售后服务,已成功帮助千家企业完成数字化项目,建立了覆盖不同行业客户和不同发展阶段的软件产品服务体系。

huoooos0的博客 1839

XXL-Job 分布式定时任务

XXL-JOB是一款轻量级分布式定时任务调度框架,采用调度中心与执行器分离架构,解决单机任务宕机、重复执行等问题。核心模块包括调度中心(管理任务配置、触发调度)和执行器(执行任务逻辑),支持集群部署保证高可用。框架提供丰富的任务触发规则、路由策略、阻塞策略及完善的运维能力,适用于多种业务场景如数据同步、定时推送等。安装时需准备MySQL数据库并初始化表结构,通过Docker部署调度中心服务。相比其他定时框架,XXL-JOB具有轻量化、可视化等优势,是中小企业的首选方案。

郭宝的博客 700

基于RAG-GPT与本地大模型构建LangChain智能客服实践指南

检索增强生成(RAG)技术通过将外部知识库与大型语言模型(LLM)相结合,有效解决了通用大模型在专业领域知识上的幻觉与时效性问题。其核心原理是将文档向量化存储,在用户提问时先进行语义检索,再将相关上下文注入提示词中,引导模型生成基于事实的精准回答。这一技术价值在于显著提升了AI应用在垂直领域的可靠性与实用性,尤其适用于技术文档问答、企业知识库等场景。本文以构建LangChain官方文档智能客服为例,详细演示了如何利用RAG-GPT框架与Ollama本地大模型,实现从环境配置、知识库构建、提示词工程到效果优化

weixin_34414196的博客 552

linux平台Modbus TCP测试

【代码】linux平台Modbus TCP测试。

无线互联&网络介绍 818

本地运行Llama 3实战指南:零基础在笔记本部署AI开发环境

大语言模型(LLM)正从云端服务演进为开发者本地基础设施,其核心价值在于离线可用性、数据主权与响应确定性。基于Transformer架构的开源模型如Llama系列,通过量化压缩(GGUF格式)和轻量推理引擎(llama.cpp/Ollama),已可在8GB内存笔记本上实现45+ token/s的稳定推理。这种端侧AI能力不再依赖API调用,而是以CLI工具、VSCode插件和RAG应用等形式深度嵌入日常开发流——尤其适合处理敏感代码审查、私有文档问答、合规报告生成等强隐私场景。本文聚焦Llama 3的本地化

wjxbj的博客 533

从零实现深度学习框架——自动求导神器计算图

本文介绍自动求导神器——计算图,从本篇文章开始介绍一个自定义的求导工具。

日积月累,天道酬勤 4199

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

基于开源大模型构建私有化AI应用:从Llama部署到RAG实战

开源大模型通过公开模型架构与权重参数,为开发者提供了可自主研究、修改和部署的AI基础设施。其核心原理在于利用Transformer等先进架构,通过大规模预训练获得通用语言理解能力。这一技术范式打破了闭源模型的技术垄断,显著降低了AI应用门槛,使开发者能够在保障数据隐私的前提下,以可控成本构建定制化智能系统。在实际应用场景中,结合检索增强生成(RAG)技术,可将开源模型与私有知识库深度融合,打造出适用于企业内部助手、学术研究支持等场景的专属AI解决方案。本文以Meta Llama系列模型为例,详细阐述了如何利

weixin_34025151的博客 368

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

AI大模型应用开发实战:从RAG到智能体的系统化入门指南

如果你是一名刚接触AI大模型开发的工程师,面对网上铺天盖地的“从入门到精通”教程,是否感到无从下手?概念太多、环境复杂、代码跑不通、学完不知道能做什么——这是绝大多数新手开发者最真实的困境。 今天要介绍的,是一个在GitHub上获得了超过80,000颗星标的开源项目。它之所以能获得如此高的认可,并非因为它提出了多么前沿的算法,而恰恰是因为它精准地解决了上述所有痛点: 它可能是目前最适合新手系统化入门AI大模型应用开发的学习路线与实践指南 。 这个项目没有停留在理论空谈,而是构建了一条清晰的路径:从环境搭建、

weixin_30879833的博客 483

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

RAG技能全攻略:Chroma、FAISS与Pinecone构建高效检索增强生成系统

想要构建强大的AI应用却苦于大模型的知识局限性?检索增强生成(RAG)技术正是解决这一挑战的终极方案!本指南将深入解析AI-Research-SKILLs项目中三大核心RAG技能:Chroma、FAISS和Pinecone,帮助您快速掌握构建高效检索增强生成系统的关键技能。无论您是AI新手还是经验丰富的开发者,这份完整指南都能为您提供从零到生产的全面指导。 ## 📊 RAG技术架构全景图 检

gitblog_01145的博客 918

LangChain实现本地化RAG系统的核心技术解析

RAG(检索增强生成)是当前AI应用开发的核心架构,通过结合信息检索与文本生成技术,显著提升问答系统的准确性和可靠性。其技术原理是将用户查询与知识库进行语义匹配,再基于检索结果生成回答,有效解决了纯生成模型的幻觉问题。在工程实践中,本地化部署的Native RAG方案因具备数据隐私保护、低延迟等优势,特别适合医疗、金融等敏感场景。LangChain作为主流开发框架,提供了从文档加载、文本向量化到检索器配置的完整工具链,配合FAISS等本地向量数据库,可快速构建高性能RAG系统。本文以实际项目为例,详解如何通

weixin_30372371的博客 441

RAG知识库问答系统搭建指南:从原理到实践

检索增强生成(RAG)技术通过结合信息检索与大语言模型(LLM)的优势,有效解决了传统生成式AI的幻觉问题。其核心原理是将用户查询转化为向量表示,通过相似度计算从知识库中检索相关文档片段,再交由LLM生成精准回答。这种架构在保持模型语言理解能力的同时,显著提升了回答的准确性与可解释性。工程实践中,开发者需要关注文档分块策略、向量嵌入模型选择(如MiniLM)、以及检索-生成模块的协同优化。典型应用场景包括企业知识库问答、技术文档智能助手等,其中使用类似Llama2等开源模型配合FAISS/Chroma向量数

weixin_30555515的博客 481
上一篇: 用LM Studio工具部署本地AI大模型,真的太省事了!(普通人也能用)大模型入门到精通,收藏这篇就足够了!
下一篇: 《大模型白盒子构建指南》毕业,仅需2G显存,手搓关于LLM的一切!大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
