LangChain + Milvus组合拳,从零搭建一个 LLM 应用,大模型入门到精通,收藏这篇就足够了!

Milvus+LangChain企业私有知识库实战部署指南 向量数据库是支撑RAG系统高效检索的核心基础设施,其本质是将非结构化文本转化为可计算的稠密向量,并通过近似最近邻搜索实现语义匹配。Milvus作为专为向量检索设计的数据库,相比传统关系型数据库扩展方案(如pgvector),在混合查询、增量更新、高并发低延迟等工业级场景中展现出显著技术优势;LangChain则提供模块化编排能力,使大模型、业务规则与多源数据深度协同。该技术组合特别适用于制造业等强合规、高定制需求领域,解决设备手册、工艺SOP、质检标准等海量异构文档的精准问答难题——本文基于三家真实产线落地 阅读详情

如何从零搭建一个 LLM 应用?不妨试试 LangChain + Milvus 的组合拳。

作为开发 LLM 应用的框架,LangChain 内部不仅包含诸多模块,而且支持外部集成;Milvus 同样可以支持诸多 LLM 集成,二者结合除了可以轻松搭建一个 LLM 应用,还可以起到强化 ChatGPT 功能和效率的作用。

本文为解码 LangChain 系列,将深入探讨如何借助 LangChain 与 Milvus 的力量增强 LLM 应用,以及如何构建和优化 AIGC 应用的小秘籍!
01.

LangChain + 向量数据库 :解决幻觉问题

  • LangChain

LangChain 是一种用于开发 LLM 应用的框架。LangChain 设计如下:

  • Data-aware:连接 LLM 与其他数据源
  • Agentic:允许 LLM 与 LangChain 环境交互

LangChain 包括许多模块,例如 Models、Prompts、Memory、Indexes、Chains、Agents 和 Callbacks。对于每个模块,LangChain 都提供标准化的可扩展接口。LangChain 还支持外部集成,甚至可实现端到端。LLM Wrapper 是 LangChain 的核心功能,提供了许多 LLM 模型,例如 OpenAI、Cohere、Hugging Face 等模型。

LangChain 提供一系列有用的大型语言模型(LLMs),可满足多样的用户需求。LangChain 的另一大亮点是其扩展功能——集成各种向量数据库(如 Milvus、Faiss 等),因此可以很好地进行语义搜索。

LangChain 通过 VectorStore Wrapper 提供了标准化的接口,从而简化数据加载和检索的流程。例如,大家可以使用 LangChain 的 Milvus 类,通过from_text方法存储文档的特征向量,然后调用similarity_search方法获取查询语句的相似向量(也就是在向量空间中找到距离最接近的文档向量),从而轻松实现语义搜索。

通过 ChatGPT-Retrieval-Plugin 项目可以发现,向量数据库在 LLM 应用中起着至关重要的作用,它并不只局限于语义检索的用途,还包括其他用途,比如:

  • 存储问答上下文。这是 Auto-GPT 和 BabyAGI 等 LLM 平台提供的有用功能。这种功能可以增强LLM 应用对于上下文的理解和记忆能力。
  • 为 GPTCache 等 LLM 平台提供语义缓存,优化性能并节省成本。
  • 实现文档知识功能,降低 LLM 应用产生幻觉概率(如:OSSChat)。
  • 如何解决 ChatGPT 的幻觉问题?

人工智能系统经常会产生“幻觉”、捏造事实、返回错误信息,更有甚者把 ChatGPT 形容为“一本正经地说废话“。因此,幻觉问题会降低 ChatGPT 回答的可信度,向量数据库可以有效解决幻觉问题。

其工作流程如下图所示:
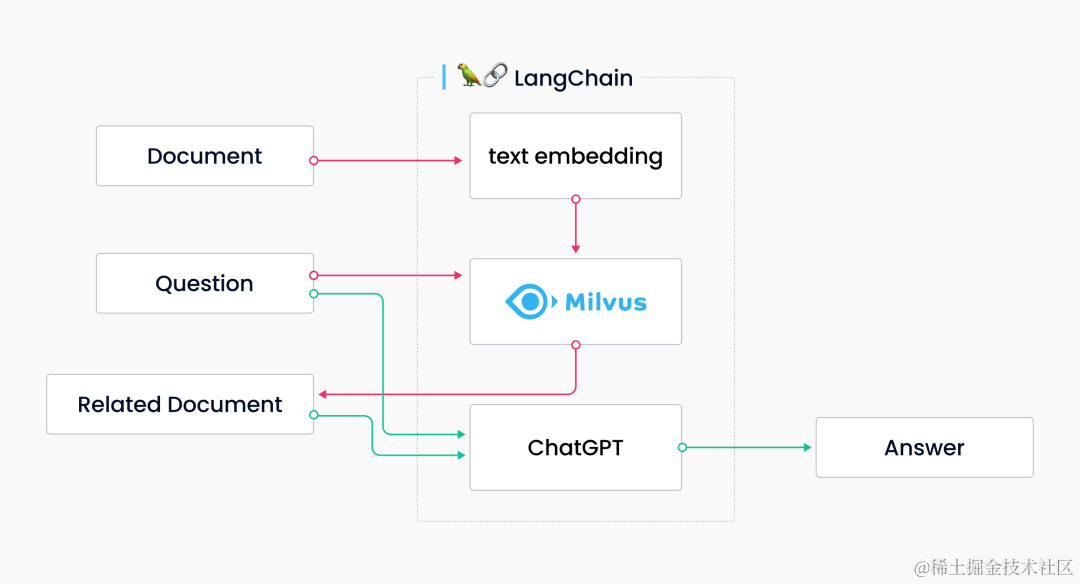
首先,在 Milvus 中存储由官方文档转化而来的文本向量。然后,在响应问题时搜索相关文档(如上图中红色箭头流程所示)。ChatGPT 最后根据正确的上下文回答问题,从而产生准确的答案(如上图中绿色箭头流程所示)。

上述事例说明,用户无需标记、训练数据或进行额外开发和微调,只需将文本数据转化为向量并存储在 Milvus 中,即可解决 ChatGPT 的幻觉问题。LangChain + Milvus + ChatGPT 的组合可实现文本存储。ChatGPT 的答案也是基于参考文档库中的内容而返回的,可大大提高其回答的准确性。这样一来,聊天机器人可以基于正确的知识进行问答,减少出现“胡说八道”的可能性。

接下来分享一个 LangChain + Milvus + ChatGPT 的组合一个实际的具体应用场景:

如果我是一名 Milvus 社区管理员,每天需要回答各种社区相关问题,那么可以搭建一套智能应用来大大提高自己的工作效率。首先,可以将所有 Milvus 官方文档存储起来。然后,将这些文档作为必要的上下文知识提供给 ChatGPT。这样一来,如果用户问道:“如何使用 Milvus 搭建聊天机器人?”,构建的聊天机器人可以搜索与用户问题语义相关的官方文档。这种方法无需进行额外的数据训练,但能够大大提升工作效率和回答准确性。

02.

LangChain + Milvus :搭建智能应用

  • 搭建流程

1. 前提条件

  • 运行 pip install langchain命令安装 LangChain。
  • 安装向量数据库 Milvus 或注册 Zilliz Cloud ——大家可以选择在本地系统上安装和启动开源向量数据库 Milvus 或者选择全托管向量数据库 Zilliz Cloud 服务,免去运维部署的麻烦。Zilliz Cloud 简单易用,具备高扩展性,提供超强性能,本教程将使用 Zilliz Cloud。

2. 加载知识库数据

首先,需要使用标准格式加载数据。也就是说,我们需要将文本切成小块,从而确保传入 LLM 模型的数据为一段段小的文本片段。

代码语言:javascript

**复制

from langchain.embeddings.openai import OpenAIEmbeddings
from langchain.text_splitter import CharacterTextSplitter
from langchain.vectorstores import Milvus
from langchain.document_loaders import TextLoader

loader = TextLoader('state_of_the_union.txt')
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=1000, chunk_overlap=0)
docs = text_splitter.split_documents(documents)

接下来,我们需要将小块的文本片段转化为向量并存储在向量数据库中。以下示例代码使用 OpenAI 的模型和 Zilliz Cloud 向量数据库。

代码语言:javascript

**复制

embeddings = OpenAIEmbeddings()

vector_db = Milvus.from_documents(
    docs,
    embeddings,
    connection_args={
        "uri": "YOUR_ZILLIZ_CLOUD_URI",
        "user": "YOUR_ZILLIZ_CLOUD_USERNAME",
        "password": "YOUR_ZILLIZ_CLOUD_PASSWORD",
        "secure": True
    }
)

3. 查询数据

加载数据后,可以在问答链(Chain)中使用这些数据,下述代码主要解决上文提到的“幻觉”问题。

使用 similarity_search方法将查询语句转化为特征向量,然后在 Zilliz Cloud 中搜索相似向量,以及相关的文档内容。

代码语言:javascript

**复制

query = "What did the president say about Ketanji Brown Jackson"
docs = vector_db.similarity_search(query)

运行 load_qa_chain获取最终答案。这是一个最通用的用于回答问题的接口,它加载一整个链,可以根据所有数据库中文本进行问答。以下示例代码使用 OpenAI 作为 LLM 模型。在运行时,QA Chain 接收input_documents和 question,将其作为输入。input_documents是与数据库中的query相关的文档。LLM 基于这些文档的内容和所提问的问题来组织答案。

代码语言:javascript

**复制

from langchain.chains.question_answering import load_qa_chain
from langchain.llms import OpenAI

llm = OpenAI(temperature=0)
chain = load_qa_chain(llm, chain_type="stuff")
chain.run(input_documents=docs, question=query)
  • Milvus:更适合 AIGC 应用的向量数据库

如果想要提高应用的可靠性,需要使用数据库存储文本向量。但为什么选择 Milvus 向量数据库?

  • 助力语义搜索:不同于传统数据库,Milvus 专为向量设计,可以实现语义检索。
  • 高度可扩展:支持灵活扩展,用户可轻松存储和检索十亿级向量数据。此外,可扩展性对于检索速度和效率至关重要。
  • 支持混合查询:Milvus 支持混合查询,将向量相似性搜索和标量过滤相结合,可满足不同的搜索场景和要求。
  • 提供丰富的 API:Milvus 提供多语言的 API,包括 Python、Java、Go、Restful 等,方便用户在各种应用中集成和使用 Milvus。
  • 集成多种 LLM 模型:Milvus 可与多种主流 LLM 模型集成,包括 OpenAI Plugin、LangChain、LLamaIndex 等,方便用户灵活定制化其应用。
  • 多种部署版本和配置:Milvus 提供多种版本(如:MilvusLite 版、单机版、分布式版和云服务版),可以轻松适应不同类型的应用场景,即可支持小型项目,也可适用于企业级数据检索。

03.

如何优化 AIGC 应用?

人工智能领域中不断涌现各种新技术、新突破。本文将介绍 2 种优化 AIGC 应用的秘籍,帮助你进一步提升 AIGC 应用的性能和搜索质量。

  • 提升 AIGC 应用程序性能:使用 GPTCache

如果想要提升 AIGC 应用性能并节省成本,可以试试 GPTCache。这个创新项目旨在创建语义缓存,以存储 LLM 响应。

具体而言,GPTCache 会缓存 LLM 的响应。在收到问题时,GPTCache 使用向量数据库检索相似的问题并查询此前缓存的响应。这样一来,应用便可快速准确地回答用户。GPTCache 可有效避免重复问题多次调用 LLM 接口所产生的费用以及需要等待的响应时间,从而提供更快速、更准确的答案,使 AIGC 应用更受用户欢迎。

  • 提高搜索质量:调整 Embedding 模型和 Prompt

此外,我们可以通过微调 Embedding 模型和 Prompt 达到提高搜索质量的效果。Embedding 模型在 AIGC 应用中不可或缺,发挥着将文本转化为向量的关键作用。微调模型具体指调节模型从而使其注重关注某些关键词或短语,并调整模型权重和评分机制,从而迎合用户的需求和偏好。微调后,模型可以更准确地理解用户问题、将其进行分类,从而提高语义搜索结果的准确性和相关性,返回准确的结果。

影响搜索质量的另一重要因素是搜索提示。例如“我有什么可以帮助您的?”或“您有什么想法?”都可以用于提示用户该输入何种提问。通过测试和修改这些提示,可以提高搜索结果的质量和相关性。如果你的应用程序面向特定行业或人群,可以在提示内加入一些行业术语,这样有助于指导用户进行更相关的搜索查询。

总之,LangChain + Milvus 的组合方式可以帮助开发者从零开始搭建 LLM 应用。LangChain 为 LLM 提供了标准化且易用的接口,Milvus 则提供出色的存储和检索能力,从而整体提升 ChatGPT 等应用的功能和效率。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

2026年AI面试核心:Langchain+Milvus+RAG+Agent生产级系统设计全解析 检索增强生成(RAG)是一种将外部知识库与大语言模型结合的技术范式,旨在解决模型幻觉和知识更新问题。其核心原理是通过向量化技术将非结构化文档转换为高维向量,并利用向量数据库进行高效相似度检索,将检索到的相关上下文注入模型提示词中,从而生成更准确、可追溯的答案。这项技术的核心价值在于,它为大模型应用提供了可靠的知识底座,是实现企业级智能问答、知识管理、对话系统等场景的关键。在实际工程实践中,一个健壮的RAG系统通常涉及文档加载、智能文本分割、向量化模型选型、多路召回与重排序等关键环节。本文将以一个基于私有知识 阅读详情

相关推荐

从零搭建私有化AI应用:本地部署、RAG知识库与模型微调实战指南

最近在尝试将大模型应用到实际业务中时,很多开发者都卡在了几个关键环节:如何安全地在本地部署一个可用的模型?如何让模型理解并回答我们私有的知识?如何低成本地让模型适应特定任务?以及,有没有一个现成的平台能快速搭建应用?这些问题看似独立,实则环环相扣,构成了从模型到应用的全链路挑战。 本文将为你系统性地拆解这套组合拳:从大模型的本地部署开始,到构建一个能“读懂”你文档的RAG知识库,再到通过微调让模型更“听话”,最后使用Dify平台快速组装成可用的AI应用。整个过程将提供完整的代码、配置和避坑指南,无论你是想学

caodaoxi的专栏 415

小白程序员必备:6.9万字LangChain教程,轻松掌握大模型开发

本文全面介绍了LangChain框架及其应用开发。LangChain是一个开源框架,用于构建基于大语言模型(LLM)的应用程序,如问答系统、智能助手和文档搜索等。文章详细讲解了大模型基础、LangChain核心组件(Model I/O、Chains、Retrieval、Agents等),并提供了RAG、Milvus、Ollama等高级应用的实例代码教学。通过6.9万字的内容,帮助开发者从入门到精通,快速掌握使用LangChain开发各类AI应用的能力。

Trb201013的博客 1375

【阿里云大模型高级工程师ACP习题集】2.9 大模型应用生产实践(下篇)

【摘要】这是我精心整理出对应的习题集,里面足足有 30 道题目,从基础概念到深度拓展,全方位覆盖章节重点、难点。不管你是想检验自己的学习成果,还是想针对薄弱环节进行强化训练,它都能完美适配!

davidkorhenn的博客 2237

LangChain + Milvus组合拳,从零搭建一个 LLM 应用

本文为解码 LangChain 系列,将深入探讨如何借助 LangChain 与 Milvus 的力量增强 LLM 应用,以及如何构建和优化 AIGC 应用的小秘籍!

pythonhy的博客 1224

Anaconda安装及配置+pytorch深度学习环境(2024复旦计算机工作站0705)

Pytorch是torch的python版本,是由Facebook开源的神经网络框架,专门针对 GPU 加速的深度神经网络(DNN)编程。Torch 是一个经典的对多维矩阵数据进行操作的张量(tensor )库,在机器学习和其他数学密集型应用有广泛应用。与Tensorflow的静态计算图不同,Pytorch的计算图是动态的,可以根据计算需要实时改变计算图。但由于Torch语言采用 Lua,导致在国内一直很小众,并逐渐被支持 Python 的 Tensorflow 抢走用户。

ZhiYilang的博客 2348

博图HMI多语言文本列表一键生成攻略:从Excel模板到TIA Portal的完整流程

本文详细介绍了如何利用Excel模板和TIA Portal API实现博图HMI多语言文本列表的一键生成。通过标准化Excel模板设计、解析TIA Portal的XML结构,并结合C#代码实现自动化导入,大幅提升多语言项目的开发效率。特别适用于需要支持多语言版本的自动化设备HMI界面开发。

weixin_26934905的博客 218

用 LangChain 和 Milvus 从零搭建 LLM 应用

微调后,模型可以更准确地理解用户问题、将其进行分类,从而提高语义搜索结果的准确性和相关性,返回准确的结果。例如,大家可以使用 LangChain 的 Milvus 类,通过from_text方法存储文档的特征向量,然后调用similarity_search方法获取查询语句的相似向量(也就是在向量空间中找到距离最接近的文档向量),从而轻松实现语义搜索。LangChain 为 LLM 提供了标准化且易用的接口,Milvus 则提供出色的存储和检索能力,从而整体提升 ChatGPT 等应用的功能和效率。

YiRan_Zhao的博客 1892

Vercel部署个人博客

先去注册一个账号,建议注册一个Github账号后,使用Github账号来登录Vercel。vercel 部署静态资源网站极其方便简单,并且有可观的访问速度,最主要的是免费部署。此时项目已经成功搭建完毕了,点击图片即可跳转到 vercel 所提供的二级域名访问。然后可以直接拉取我的仓库,所有已经配置好了,可以直接使用,建议fork成自己的!然后修改dns就行,注意vercel提供的域名可能访问不了,需要自己绑定!如果有自己的域名,还可以在 vercel 中进行设置。进入Vercel官网。

醉里博客202271.xyz 2358

解码 LangChain|用 LangChain 和 Milvus 从零搭建 LLM 应用

作为开发 LLM 应用的框架,LangChain 内部不仅包含诸多模块,而且支持外部集成;Milvus 同样可以支持诸多 LLM 集成,二者结合除了可以轻松搭建一个 LLM 应用,还可以起到强化 ChatGPT 功能和效率的作用。

2401_82469710的博客 1785

手把手教你用8位单片机IO口直接驱动WS2812灯带(附完整代码和避坑指南)

本文详细介绍了如何使用8位单片机IO口直接驱动WS2812灯带,包括硬件准备、时序生成、色彩引擎与特效算法的实现,以及调试技巧与性能优化。通过汇编语言优化和精确时序控制,实现高效的LED驱动和炫酷的彩虹灯效,适合嵌入式开发者和硬件爱好者参考。

weixin_42696271的博客 304

YOLOv11的代数不变量解释:Syzygy模分析特征重要性,用交换代数揭示卷积核的语义相关性

本文提出了一种基于代数几何与交换代数的创新方法,特别是运用Syzygy模理论,对YOLOv11目标检测算法的卷积核语义相关性进行数学解释。研究揭示了YOLO系列算法演进背后的代数结构特征,建立了网络组件与多项式环、理想簇等代数概念的对应关系。通过构建分层的准同构代数系统,分析了YOLOv11在不同尺度下保持语义不变性的数学本质。文章系统阐述了Syzygy模在CNN特征冗余分析、跨层依赖关系建模和语义聚类中的应用,并提出了适用于动态稀疏训练的改进算法。该理论框架为深度神经网络的解释性研究提供了新的数学工具,同

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1270

解码 LangChain|用 LangChain 和 Milvus 从零搭建 LLM 应用,大模型入门到精通,收藏这篇就足够了!

LangChain 为 LLM 提供了标准化且易用的接口,Milvus 则提供出色的存储和检索能力,从而整体提升 ChatGPT 等应用的功能和效率。

Y525698136的博客 406

IgH EtherCAT 从入门到精通:第 2 章 环境搭建与编译安装

环境搭建与编译安装指南 本章详细介绍了搭建IgH EtherCAT Master开发环境的完整流程。内容包括: 硬件要求:支持多种Intel和Realtek网卡的原生驱动,以及通用网卡的generic驱动选项 软件依赖:列出Linux系统下所需的工具链和开发包 源码获取:通过Git克隆官方仓库并切换稳定版本的方法 配置选项:详细解析bootstrap脚本和configure的核心参数,包括路径设置、功能开关和实时框架选项 编译流程:从生成构建系统到最终编译安装的完整步骤 通过本章指导,读者可以完成一个可运行

从事嵌入式linux android驱动开发,拥有全栈能力 479

大模型应用开发实战:LangChain、RAG、Agent与向量数据库Milvus全栈解析

在人工智能应用开发领域,检索增强生成(RAG)和智能体(Agent)是两种核心范式,它们共同解决了大语言模型的知识更新与任务执行难题。RAG通过从外部知识库检索相关信息来增强模型生成,有效应对了模型知识过时和“幻觉”问题,其技术核心在于高效的向量检索与上下文构建。智能体则赋予模型规划与工具调用的能力,使其能够自主完成多步骤复杂任务。这两种技术通常需要与向量数据库(如Milvus)和应用框架(如LangChain)协同工作,构建起从数据处理、知识存储到智能交互的完整链路。本文将以一个完整的智能问答系统为例,深

weixin_30644369的博客 372

USB_TYPE-C 母座电路设计

本文详细介绍了USB Type-C接口(C2765186)的电路设计要点,重点解析了电源、识别和数据三部分的关键连接方案。电源部分需并联VBUS和GND引脚并加宽走线以承载3A电流;识别部分必须为CC1/CC2引脚配置5.1kΩ±1%精度的下拉电阻,这是触发PD充电的核心条件;数据部分通过短接正反插引脚实现盲插功能。文档还提供了完整的引脚对照表,并强调PCB布局需注意ESD防护、差分走线阻抗控制等要点,为Type-C接口设计提供了实用指导。

在读研究生,FPGA电路设计与功能开发。 585

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

大模型技术转型指南:从入门到求职实战

大语言模型(LLM)作为AI领域的重要突破,正在重塑技术人才的发展路径。其核心原理是通过海量数据预训练获得通用语义理解能力,再通过微调适配具体场景。这种技术范式降低了AI应用门槛,使传统开发者能快速切入AI赛道。从工程实践看,LLM生态已形成算法层、工具链、应用层的完整技术栈,其中LangChain等框架大幅简化了AI代理开发流程。在医疗、教育等行业,结合领域知识的Prompt Engineering和RAG架构成为热门解决方案。对于转型者而言,掌握Python基础与API调用后,可逐步深入模型微调与分布式

aodiyi6351的博客 383

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

30分钟给Spring Boot加上AI能力——从零跑通你的第一个企业级AI接口

网上教程都是Python的,看不懂也用不上看了几篇RAG原理文章,但不知道怎么在Spring Boot里落地跑通了官方Demo,但不知道怎么改造才能上生产这篇文章解决的就是**“从0到1在Spring Boot里跑通企业级AI接口”**的问题。30分钟跑通最简AI对话接口10分钟升级为带知识库的RAG问答再加3个生产级防护,让它真的能上生产你不需要AI基础,但需要熟悉Spring Boot和Maven。方案优势劣势推荐场景功能全面、社区活跃、上手快抽象层较薄通用AI应用开发。

qq_41104628的博客 375

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

零基础学AI大模型之MultiQueryRetriever多查询检索全解析

工藤学编程博主分享AI大模型系列教程,涵盖从基础概念到实战应用的完整学习路径。内容包括:大模型API调用、SpringAI整合、私有化部署、可视化界面开发等基础知识;LangChain核心模块详解、Prompt工程、流式输出等进阶内容;以及RAG技术、文档处理、向量数据库(Milvus)部署与实战等高级应用。该系列循序渐进,结合代码实例与最佳实践,为零基础学习者提供全面的AI大模型开发指南。

chandfy的博客 1349

零基础七天实战:从RAG、Agent到微调,手把手搭建大模型应用

检索增强生成(RAG)和智能体(Agent)是当前构建大模型应用的两大核心技术。RAG通过外接知识库,有效解决了大模型知识陈旧和“幻觉”问题,其核心流程包括索引、检索、增强与生成。Agent则赋予大模型使用工具的能力,通过“思考-行动-观察”的循环,自主规划并执行复杂任务。结合低成本的LoRA微调技术,可以进一步调整模型的输出风格与领域适应性。这些技术共同构成了从知识问答到自动化任务处理的应用基础。本文将以【零基础】和【七天实战】为路径,详解如何从环境搭建开始,逐步整合RAG、Agent与微调,最终构建出可

weixin_34367257的博客 444

从零部署AI大模型:本地RAG系统搭建与实战指南

大语言模型作为当前人工智能领域的核心技术,通过海量数据预训练获得了强大的语言理解和生成能力。其核心原理基于Transformer架构,通过自注意力机制处理序列数据,实现了从通用对话到专业任务的广泛适应性。这项技术的核心价值在于将自然语言转化为可执行的智能交互,极大地降低了人机沟通的门槛。在实际应用场景中,企业常面临如何让大模型掌握私有、最新知识的问题,这正是RAG(检索增强生成)技术发挥作用的领域。通过将外部知识库向量化并与大模型结合,RAG有效解决了模型幻觉和知识陈旧等痛点。本文聚焦于如何在个人工作站本地

362

Java 开发者转型大模型应用实战评测

很多开发者在接触大模型应用开发时,往往陷入一种“调包侠”的误区:觉得只要调用了 API,拼凑几个提示词,就能立刻得到一个智能助手。然而,当真正着手将大语言模型(LLM)落地到具体业务场景,尤其是构建检索增强生成(RAG)系统或智能体(Agent)时,才会发现从 Demo 到生产环境的距离远比想象中遥远。数据怎么存?检索不准怎么办?上下文窗口不够用如何权衡?本地部署的成本是否可控?这些问题如果缺乏系统的工程化思维,很容易导致项目半途而废。这篇文章正是为了解决这些实际痛点而生。

2601_96189255的博客 1106

TRAE+Milvus+MCP:中文开发者零门槛向量数据库实战指南

向量数据库是AI原生应用的核心基础设施,其原理在于将非结构化数据(如文本、图像)映射为高维空间中的数学向量,并通过相似度计算实现语义检索。技术价值体现在突破关键词匹配局限,支撑RAG、智能搜索、推荐系统等关键场景。然而传统落地常受困于环境配置复杂、中文化支持薄弱、与LLM协同能力缺失等痛点。本文聚焦TRAE AI开发环境与Milvus向量数据库的深度集成,依托MCP协议实现自然语言驱动的Collection创建、向量插入与混合查询,特别强化对中文字段命名习惯和本地化知识注入的支持,让Python后端工程师无

weixin_34025051的博客 333

从零部署AI应用基础设施:LLM网关、RAG与MCP协议实战指南

检索增强生成(RAG)和大型语言模型(LLM)网关是构建现代AI应用的核心技术组件。RAG通过将外部知识库与LLM结合,有效解决了模型知识滞后与幻觉问题,提升了回答的准确性与可信度。其原理是将文档向量化后存储,在查询时进行语义检索,并将相关片段注入LLM上下文以生成精准答案。LLM网关则作为统一接入层,实现了对多模型API的路由、负载均衡与治理。在工程实践中,结合Docker容器化部署与微服务架构,可以快速搭建起包含RAG知识库和LLM网关的端到端AI基础设施。本文聚焦的实战项目,进一步集成了前沿的MCP协

weixin_33834628的博客 293
上一篇: RAG知识库:本地搭建chatgpt知识库,大模型入门到精通,收藏这篇就足够了!
下一篇: [特殊字符]️ 优化 GraphRAG:LightRAG 的三大改进,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
