RAG系列(七):解析优化 - 不同文件类型统一转换成Markdown

RAG系统必备:如何用Markdown统一处理Word、Excel、PPT等多格式文档? 本文深入探讨了在构建RAG系统时,如何通过将Word、Excel、PPT、PDF等多格式文档统一转换为Markdown来简化架构、提升处理效率。文章分析了Markdown作为中间格式的优势,提供了具体的工具选型与实战代码示例,并详细阐述了如何处理表格、公式等复杂元素,以及如何将标准化后的Markdown内容集成到RAG工作流中,从而实现更高质量的智能检索与问答。 阅读详情

引言

在 RAG 系统中,文件解析是构建知识库和实现高效信息检索的关键环节。随着系统需要处理的文件类型日益增多(如PDF、Word、Excel、PPT、HTML等),如何高效解析并利用这些异构数据成为核心挑战。

由于每种文件类型的数据结构和内容(如PDF的复杂排版、Excel的表格结构、PPT的多媒体元素)都不一致,在实际的应用场景中,我们需要对不同文件类型实现不同的解析器,解析之后还需要根据不同文件的结构实现对应的文档分块方法。整体来说,这样的系统实现和维护成本都是比较高的,要把每种文件类型的解析都做到比较好是比较繁琐的,但是文件解析如果做的不好,就会不同程度地影响后续 RAG 系统流程,该种方案流程如下:
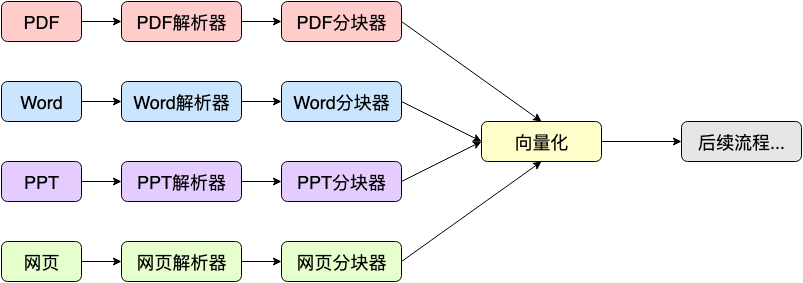
可能你会问,为什么需要这么多的解析器呢?不能把各种文件直接读取成字节流后丢给 LLM 吗?以当前 LLM 的能力,无论是什么内容都需要得组织成文本,它才能处理。而 PDF、Word、网页等其实都是富文本,里面除了文字,通常还包含公式、图片、表格、统计图,排版方式也各不相同,甚至其中的格式也是很重要的内容,而这也是文件解析的作用,把各种富文本转换成 LLM 好理解的纯文本的过程。

为什么是 Markdown

  • • 统一数据格式,降低解析复杂度:Markdown 以纯文本形式保留了基本结构(标题、列表、代码块、表格),同时去除了冗余的格式信息(如字体、颜色);所有文件统一转换为 Markdown 后,RAG 系统只需针对一种格式进行后续处理(如分段、分句、实体提取),显著降低代码复杂度。
  • • 提升信息提取与语义理解能力: Markdown 的标题语法(#、##)可直接映射为文档结构,便于模型快速定位关键信息;Markdown 的表格和代码块标记(如`````)能保留原始数据的排版逻辑,帮助模型理解数据关系;通过-、>等符号标记的列表和引用内容,可辅助模型识别要点和上下文关联。去除原始文件中的样式、脚注、页眉页脚等非核心内容,使文本更聚焦于语义信息。
  • • 优化存储与检索效率:Markdown 文件体积小,适合大规模知识库的存储和快速加载;基于 Markdown 的结构化文本可直接生成倒排索引,提升检索速度和准确性。
  • • 增强可维护性与可解释性:开发者可直接通过文本编辑器查看 Markdown 内容,便于调试和验证解析结果;Markdown 文件易于进行版本管理(如Git),支持团队协作和历史追溯。

统一转换成 Markdown 之后,可优化成如下流程:
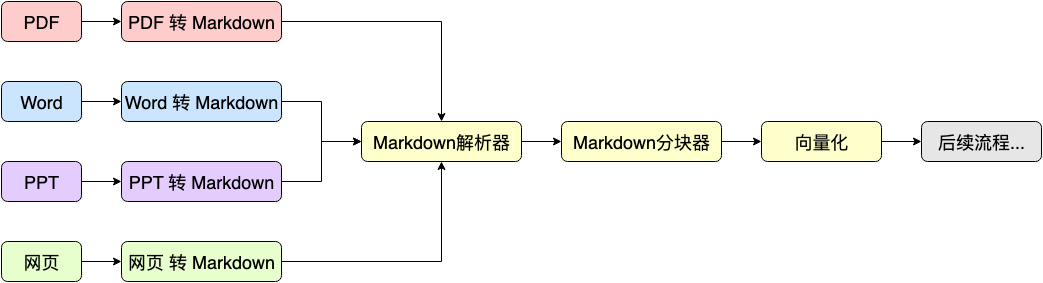
统一转成 Markdown 之后,只需要将注意力专注在 Markdown 解析和处理上就可以了,这样可以大幅降低整个系统的开发、维护成本。

而将 PDF 转 Markdown、Word 转 Markdown 等有很多成熟的工具可以使用这样就没必要自己写解析器来处理了,比如 MinerU[1] - 上海人工智能实验室开源的项目、MarkItDown - Microsoft AutoGen 团队开源的项目等等,这些项目都是专门用于将各种文件格式转换为 Markdown,可以参考借鉴和使用。

本文完整代码地址[2]

MinerU 使用方法

今天就以 CPU 运行的方式来简单介绍下 MinerU 的使用方法(没有找到类似 Nodejs 的工具,只能使用 Python 来介绍了…),更多内容到 Github 上使用cpu快速体验[3]查看。

安装 magic-pdf

conda create -n .venv 'python=3.12' -y
conda activate .venv
pip install -U "magic-pdf[full]" -i https://mirrors.aliyun.com/pypi/simple

以上是官方示例。如果你没有安装 conda(不建议使用 uv,有兼容性问题),可以直接使用 Python 的命令创建虚拟空间安装:

python3.12 -m venv .venv
source .venv/bin/activate
pip install -U "magic-pdf[full]" -i https://mirrors.aliyun.com/pypi/simple

(截止到发文时)这里需要注意,Python 的版本需要在 3.10 ~ 3.12 之间,不然 magic-pdf 会被自动降级到 0.6.1。

下载模型文件

模型文件可以从 Hugging Face 或 Model Scope 下载,由于网络原因,国内用户访问 HF 可能会失败,请使用 ModelScope。

pip install modelscope
wget https://gcore.jsdelivr.net/gh/opendatalab/MinerU@master/scripts/download_models.py -O download_models.py
python download_models.py

修改配置文件【可选】

完成第二个步骤后,脚本会自动生成用户目录下的 magic-pdf.json 文件,并自动配置默认模型路径。 您可在【用户目录】下找到 magic-pdf.json 文件。

windows的用户目录为 “C:\Users\用户名”,

linux用户目录为 “/home/用户名”,

macOS用户目录为 “/Users/用户名”。

您可修改该文件中的部分配置实现功能的开关,如表格识别功能:

{
// other config
"layout-config":{
"model":"doclayout_yolo"
},
"formula-config":{
"mfd_model":"yolo_v8_mfd",
"mfr_model":"unimernet_small",
"enable":true// 公式识别功能默认是开启的,如果需要关闭请修改此处的值为"false"
},
"table-config":{
"model":"rapid_table",
"sub_model":"slanet_plus",
"enable":true,// 表格识别功能默认是开启的,如果需要关闭请修改此处的值为"false"
"max_time":400
}
}

代码示例

import os
from magic_pdf.data.data_reader_writer import FileBasedDataWriter, FileBasedDataReader
from magic_pdf.data.dataset import PymuDocDataset
from magic_pdf.model.doc_analyze_by_custom_model import doc_analyze
from magic_pdf.config.enums import SupportedPdfParseMethod

defmain():
# args
    pdf_file_name = "2024少儿编程教育行业发展趋势报告.pdf"# replace with the real pdf path
    name_without_suff = pdf_file_name.split(".")[0]

# prepare env
    local_image_dir, local_md_dir = "output/images", "output"
    image_dir = str(os.path.basename(local_image_dir))

    os.makedirs(local_image_dir, exist_ok=True)

    image_writer, md_writer = FileBasedDataWriter(local_image_dir), FileBasedDataWriter(
        local_md_dir
    )

# read bytes
    reader1 = FileBasedDataReader("")
    pdf_bytes = reader1.read(pdf_file_name)  # read the pdf content

# proc
# Create Dataset Instance
    ds = PymuDocDataset(pdf_bytes)

# inference
if ds.classify() == SupportedPdfParseMethod.OCR:
        infer_result = ds.apply(doc_analyze, ocr=True)

# pipeline
        pipe_result = infer_result.pipe_ocr_mode(image_writer)

else:
        infer_result = ds.apply(doc_analyze, ocr=False)

# pipeline
        pipe_result = infer_result.pipe_txt_mode(image_writer)

# draw model result on each page
    infer_result.draw_model(os.path.join(
        local_md_dir, f"{name_without_suff}_model.pdf"))

# get model inference result
    model_inference_result = infer_result.get_infer_res()

# draw layout result on each page
    pipe_result.draw_layout(os.path.join(
        local_md_dir, f"{name_without_suff}_layout.pdf"))

# draw spans result on each page
    pipe_result.draw_span(os.path.join(
        local_md_dir, f"{name_without_suff}_spans.pdf"))

# get markdown content
    md_content = pipe_result.get_markdown(image_dir)

# dump markdown
    pipe_result.dump_md(md_writer, f"{name_without_suff}.md", image_dir)

# get content list content
    content_list_content = pipe_result.get_content_list(image_dir)

# dump content list
    pipe_result.dump_content_list(
        md_writer, f"{name_without_suff}_content_list.json", image_dir)

# get middle json
    middle_json_content = pipe_result.get_middle_json()

# dump middle json
    pipe_result.dump_middle_json(md_writer, f'{name_without_suff}_middle.json')

if __name__ == "__main__":
    main()

运行之后,会在本地生成提取到的图片、中间过程文件以及最终生成的 Markdown 文件。
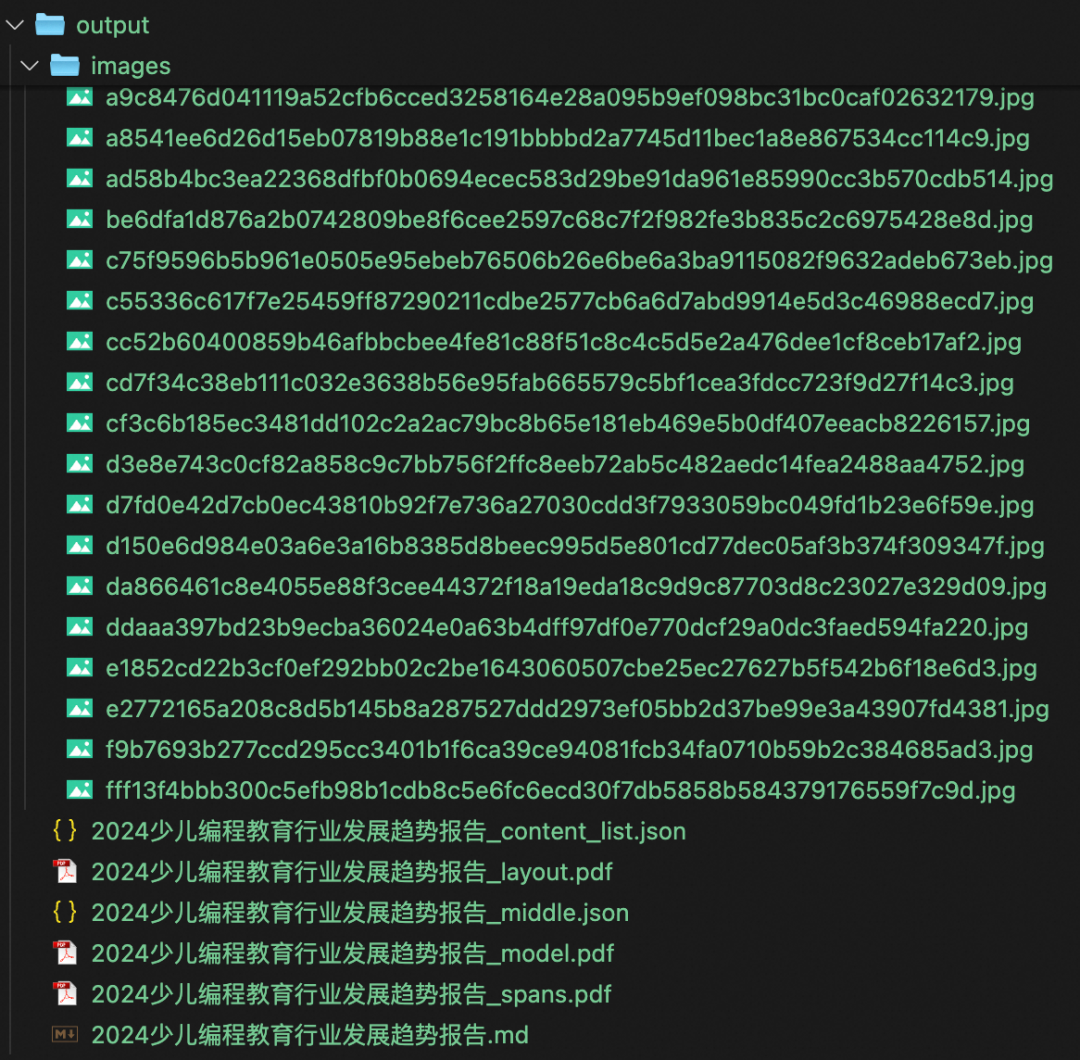
生成的 Markdown 文档:
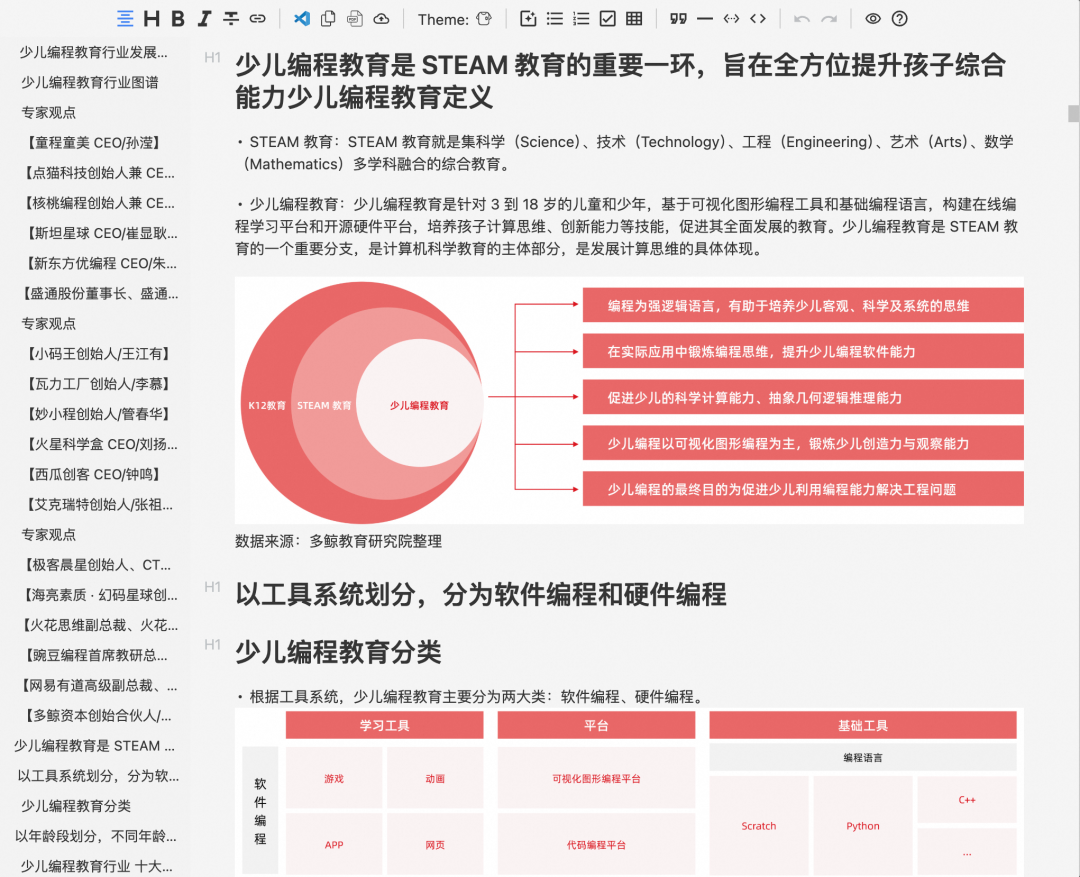
原始文档:
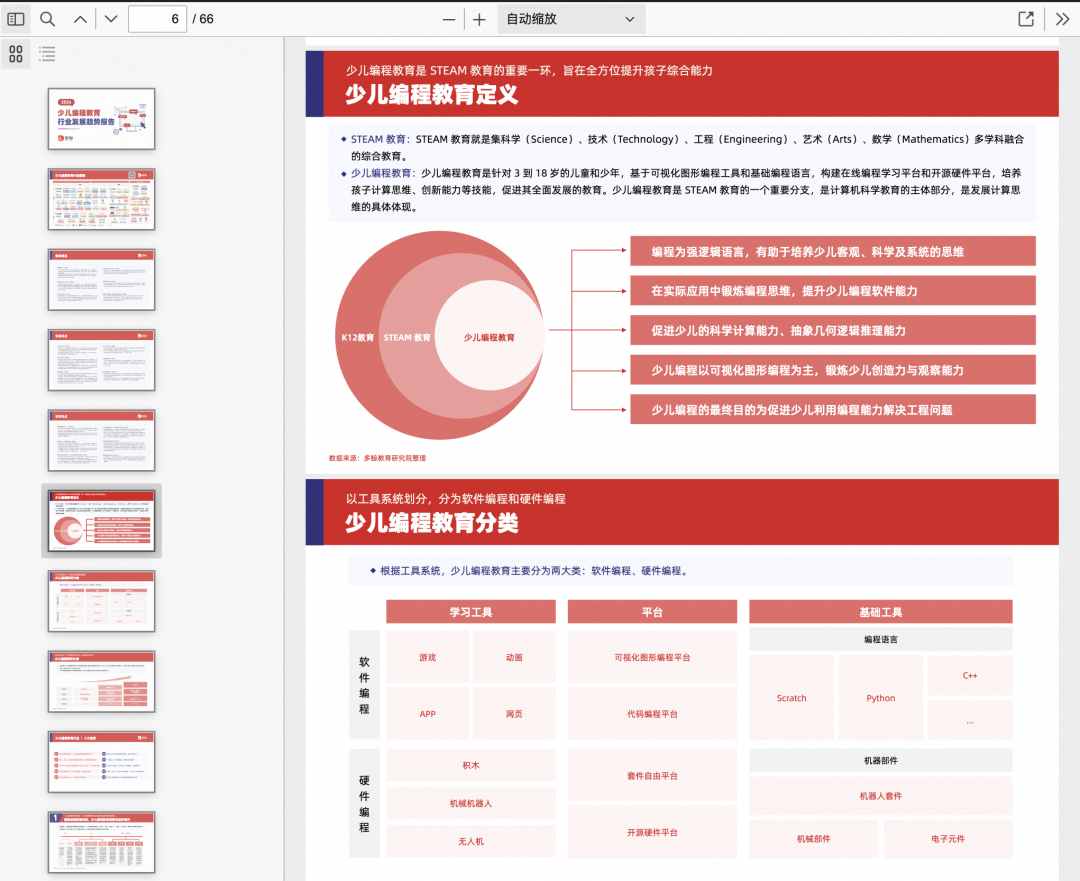
可以看到,提取的结果还是比较符合预期的,图片也都正确提取出来了。

结语

今天通过简单介绍 MinerU 的使用方法的同时,来给大家带来一种文件解析优化的思路,希望能对大家有所启发。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

为什么RAG系统偏爱Markdown?从文件解析到信息提取的全流程优化 本文探讨了RAG系统为何偏爱Markdown格式,从文件解析到信息提取的全流程优化。通过对比PDF、Word等异构文档的处理难题,揭示了Markdown在格式归一化、信息密度和模型友好性方面的优势,并提供了现代转换工具链实战和自动化流水线设计示例,帮助开发者提升检索增强生成系统的效率。 阅读详情

相关推荐

RAG实战:多格式文档转Markdown的高效解析方案

本文探讨了在RAG系统中将PDF、Word、Excel等多格式文档统一转换为Markdown格式的高效解析方案。通过分析不同文件类型的解析难点,并介绍以MinerU等工具为核心的自动化流水线构建方法,旨在为RAG预处理提供结构清晰、机器友好的标准化文本,从而提升后续检索与生成的准确性和系统稳定性。

weixin_29290863的博客 574

为什么在 RAG 中,文档解析为 JSON 优于 Markdown?

本文将分享作者和团队在实践中对 RAG 场景的深入探索和体会,阐述为什么将文档解析为 JSON 格式相比 Markdown 更加适合。

weixin_55585835的博客 2494

# RAG | Langchain # Langchain RAG:打造Markdown文件的结构化分割解决方案

【文章简介】在信息技术快速发展的今天,有效处理和分析文本数据变得尤为重要。Markdown文件因其简洁性和可读性,在知识共享和文档编写中扮演着关键角色。然而,传统的文本分割方法未能充分利用Markdown的结构化特性,导致信息提取和知识理解的效率受限。本文提出一种基于Langchain的结构化分割方法,通过MarkdownHeaderTextSplitter工具,按标题层级精确分割文档,保留关键的结构和上下文信息,特别适合报告和教程等结构化文档。

weixin_45312236的博客 1万+

检索增强生成架构详解【RAG】

生成式AI技术很强大,但它们受到知识的限制。虽然像 ChatGPT 这样的LLM可以执行许多任务,但每个LLM的基线知识都存在基于其训练数据的差距。如果你要求LLM写一些关于最近趋势或事件的文章,LLM不会知道你在说什么,而且回答最好是混合的,坏的情况下往往还是有问题的。

新缸中之脑 1450

(17-3-03)检索增强生成(RAG):分割编程语言代码+Markdown文本分割器

(3)分割Markdown文档:使用 markdown_splitter.split_text() 方法对Markdown文档进行分割,得到一个包含分割后内容和元数据的文档列表 md_header_splits。(1)分割Python代码文本:使用 python_splitter.create_documents()方法对Python代码文本进行分割,生成了一个文档列表 python_docs,每个文档包含了分割后的部分Python代码。在这个例子中只有一个文档,所以它只打印了整个Python代码文本。

码农三叔 1339

保姆级教程:在RK3588 Android12设备树(DTS)中配置MIPI 8 Lane双通道与DSC显示

本文详细介绍了在RK3588 Android12平台上配置MIPI 8 Lane双通道与DSC显示的实战指南。通过设备树(DTS)参数详解、DSC参数计算与PPS配置、双通道同步机制实现等内容,帮助开发者高效完成高分辨率屏幕驱动配置,解决嵌入式显示系统开发中的常见挑战。

weixin_30905133的博客 399

[python]MinerU的python接口使用例子

参考官方例子:mineru.readthedocs.io/en/latest/user_guide/quick_start/to_markdown.html。

FL1623863129的博客 1751

【Unity Shader】2D模型 3D模型混用的穿模问题(Spine在3D场景中出现前后穿模问题的解决办法)

问题描述: 在3D场景中使用Spine模型(2D), 因为Spine需要像Billboard类似的处理,永远是垂直与相机的, 所以一般情况下2D模型能正常显示且前后的阻挡关系也是没有问题的,如下图所示,一切都很美好.(这里用一个四边形,图中的福字表示2D模型) 可是如果后面蓝色的格子比较高,或者2D角色本身也比较高,那么就会出现模型穿插的问题,如下图所示: 如果吧2D模型竖立起来,前后关系肯定是没有问题的,所以也能避免模型穿插的问题,可是就没有Billboard效果,圆形的福字已经被压扁了,如下图:

Vitens的专栏 4591

优化需求类 Markdown 文件以提高 RAG 系统查询准确度

处理需求类的 Markdown 文件时,由于标题如“需求名称”、“功能描述”等过于通用,直接用于检索难以准确定位有价值的内容。因此需要对文件进行预处理,通过丰富标题语义、清洗文本、生成摘要、文本切分等步骤提高 RAG(Retrieval-Augmented Generation)系统的查询准确度。通过这样的预处理流程,可以显著提高需求文档在 RAG 系统中的查询准确度,满足用户快速查找需求信息的需求。对处理后的文本进行向量化和存储,以供后续检索使用。将文本切分为语义完整的片段,适合向量化处理。

pumpkin84514的博客 804

YOLOv11改进策略【Neck】| 替换RT-DETR中的CCFF跨尺度特征融合颈部结构,优化计算瓶颈与冗余问题

RT-DETR中的CCFF模块用于优化多尺度特征融合,解决传统方法的计算瓶颈与冗余问题,提升模型速度与精度,以适应实时检测需求。

Limiiiing的博客 1830

从SOMEIP看SOA,汽车电子电器架构的转变

从SOMEIP看SOA,汽车电子电器架构的转变

天赐好车的博客 241

RAG系列:不同文件类型统一转换成Markdown

RAG高质量内容生成方法。

持之以恒 2422

Codex 100个真实案例 - 全系列总结与Codex最佳实践全解析

历经100个案例的淬炼,我们终于来到了终点!本篇是整个系列的压轴之作——全面回顾100个案例的分类统计、提炼Codex使用的核心技巧和最佳实践、总结Prompt工程的精华要点、剖析常见错误及解决方案、展望AI编程的未来趋势,并为不同水平的读者规划学习路径。这不仅是一篇总结,更是一本Codex实战手册!

yueyeguzhuo的专栏 136

RAG系列:解析优化 - 不同文件类型统一转换成Markdown

本文探讨了RAG系统中文件解析的优化方案,提出将各类异构文件(PDF、Word、Excel等)统一转换为Markdown格式的思路。Markdown能保留文档基本结构,去除冗余格式,显著降低系统复杂度。文章推荐使用开源工具如MinerU进行格式转换,并详细介绍了在CPU环境下安装配置MinerU的方法,包括环境搭建、模型下载和代码示例。通过将不同文件格式统一处理为Markdown,可简化后续文本处理流程,提高系统效率和可维护性。该方法为处理多格式文档提供了一种实用解决方案。

Q2024107的博客 1072

OceanBase数据库:与MySQL和Oracle的函数差异分析

OceanBase数据库兼容性解析:MySQL与Oracle模式深度比较 摘要:OceanBase通过独特的双模式架构,实现了对MySQL和Oracle的高度兼容。文章首先分析了OceanBase的兼容性架构,包括SQL解析层、优化器层和执行引擎层的差异化设计。随后对比了两种模式在数据类型、SQL语法、函数支持等方面的兼容性差异,其中MySQL模式兼容5.7版本大部分功能,Oracle模式则支持155个内置函数和PL/SQL特性。最后提出了模式选择的六大考量因素,包括现有系统基础、功能需求和迁移成本等,为数

本博客聚焦 YOLOv11 全流程落地,涵盖架构优化、数据集处理、训练技巧与多场景部署,兼及国产数据库、Java 开发与 AI 模型应用,内容兼顾理论与工程实践,为开发者提供系统干货,助力高效提升技术能力。 1228

图神经网络实战(6)——使用PyTorch构建图神经网络

图数据集通常比简单的连接集合更加丰富,因为节点和边可以具有表示分数、颜色、单词等特征。包含这些额外信息在输入数据中对于生成最佳嵌入至关重要。在本节中,我们将使用 Cora 和 Facebook Page-Page 数据集,首先将它们视为表格数据集,观察香草神经网络在节点特征上的表现如何。然后,尝试在神经网络中加入拓扑信息,实现图神经网络 (Graph Neural Networks, GNN) 架构:一个同时考虑节点特征和边的简单模型。最后,我们将比较两种架构的性能。

盼小辉丶的博客 2万+

提升RAG效果的关键一步:多格式文件转Markdown实战

在 RAG 系统中,文件解析是构建知识库和实现高效信息检索的关键环节。随着系统需要处理的文件类型日益增多(如PDF、Word、Excel、PPT、HTML等),如何高效解析并利用这些异构数据成为核心挑战。

2401_85325726的博客 1448

复合材料仿真PAM-COMPOSITE 全工艺案例实操参数模板

复合材料仿真PAM-COMPOSITE 全工艺案例实操参数模板

源代码杀手的博客 277

RAG系列:解析优化 - 使用 Doc2X 将 PDF 高效转换为 Markdown

Doc2X 是一款专为开发者设计的强大文档解析产品。Doc2X 提供 RESTful API 与 SDK 工具包,支持多种开发语言与框架,让您轻松将文档处理功能嵌入现有系统,方便快捷地实现将 PDF、扫描件、图片等多种格式的文档精准转换为 Markdown、LaTeX、HTML、Word 等结构化或半结构化格式的能力。Doc2X文档图片公式识别/翻译/转换本文给大家再介绍了一款优秀强大的文档解析产品 -Doc2X。

jike007gt的博客 1041

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

为什么RAG系统都爱用Markdown?深度解析格式统一背后的工程智慧

本文深度解析了RAG系统普遍采用Markdown作为统一中间格式背后的工程智慧。通过将PDF、Word等异构文档转换为Markdown,系统实现了结构保留与噪音剔除的平衡,极大简化了文档分块、向量化等下游任务,提升了系统的稳定性、效率与可维护性。

weixin_29232121的博客 103

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

e2m:将多种文件格式一键转换成 Markdown

**e2m** 是一个能够把 doc, docx, epub, html, pdf, ppt, pptx, mp3, m4a 等多种文件类型转换成 Markdown 格式的 Python 库。它的出现为文档转换提供了极大便利,尤其适用于 RAG 和模型训练、微调场景,旨在提供高质量的数据。 ## 项目介绍 e2m 的核心在于其解析器和转换器的架构设计。通过一系列精心设计的解析器,它能够读取各种

gitblog_01059的博客 916

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

使用TextIn文档解析工具为RAG开发提供更多可能性

目前,海内外各家厂商开发的大语言模型已进入绝大多数使用者与企业用户的视野,展示了很多令人兴奋的可能性。但当企业级应用需求出现,从系统开发到知识库问答产品的真正落地,我们还有一系列技术问题需要解决。举例来说,被广泛讨论的幻觉问题(大模型在不擅长或不具备相关知识的场景下一本正经的胡说八道)、知识局限问题(难以获取实时信息与非公开数据)、数据安全问题(公司私有数据上传到第三方平台安全性和隐私性难以保障)都是企业应用的阻碍。

商务合作欢迎私信我 7347

RAG系列(八):切分优化 - 基于 Markdown 语法的文档切分

从本文开始,我会根据不同优化阶段来选择要重点关注的指标,不必要每次都关注五个指标的表现,这样可以让我们的优化更聚焦,通过优化每个阶段的重点指标,从而逐步优化系统的各个环节。

pythonhy的博客 1079

Java:RAG系统中基于Markdown标题的文档分块优化实践(附完整代码)

本文深入探讨了RAG系统中文档分块的重要性,并提供了基于Markdown标题进行分块的Java实现方案。针对传统固定长度分块导致语义割裂的问题,文章提出以标题为锚点,确保每个分块语义完整,从而提升检索准确性。文中详细介绍了从PDF预处理到核心分块器实现的完整流程,并附有可运行的完整代码,为优化RAG系统检索效果提供了实用指南。

water的专栏 824

AI智能客服进阶教程第6节:深入解析RAG文档导入,使用MinerU将PDF转化为Markdown文档!

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

2401_85375151的博客 1383
上一篇: RAG系列(六):问题优化 - 意图识别&同义改写&多视角分解&补充上下文
下一篇: RAG系列(八):切分优化 - 基于 Markdown 语法的文档切分
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
