


引言
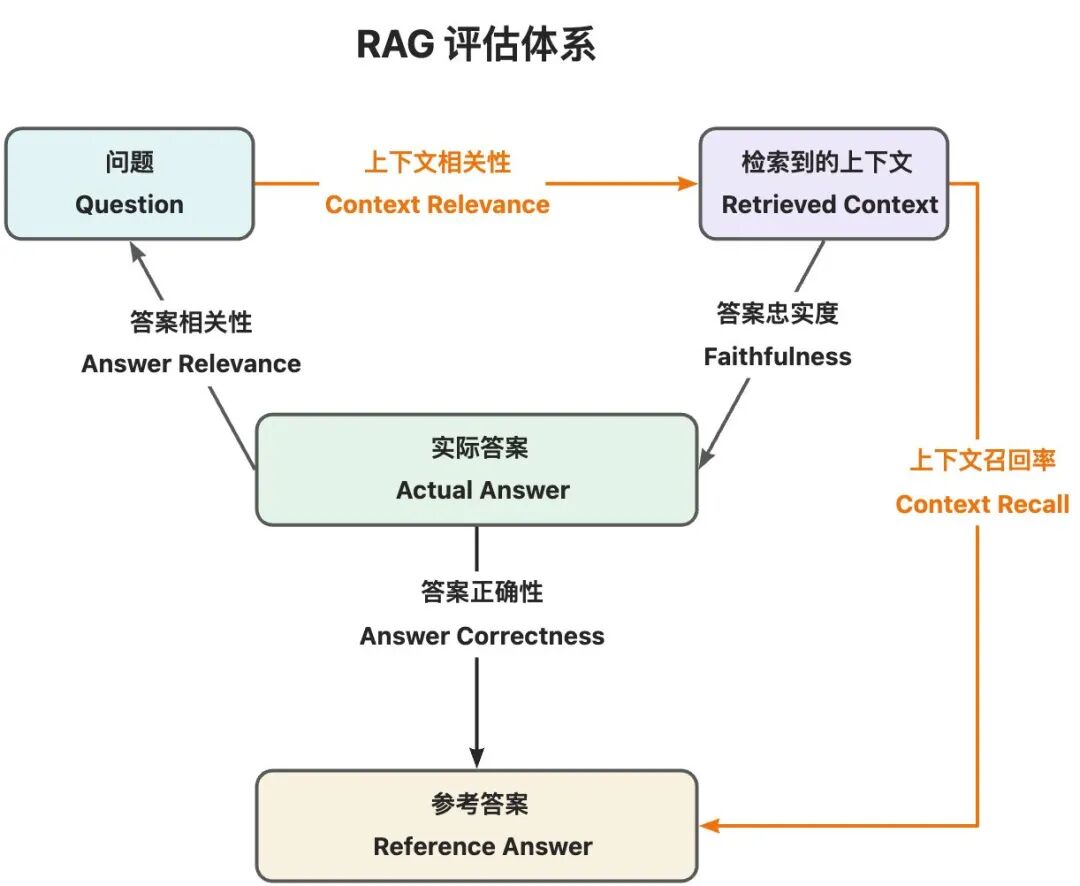
今天我们将基于 LLM-as-judge 自己实现一套 RAG 系统评估系统,以基础版 RAG 系统这 5 个评估指标值作为基准,通过学习不同的优化方法来提升这 5 个指标。
因为是通过 LLM 来评估,所以评估 LLM 的能力越强,理论上评估就会越准确,因此在实际的业务场景中,尽可能选用能力更强的 LLM。
为了学习方便,本文采用的评估 LLM 是 Ollama 部署的 qwen2.5 14b。
本文完整代码地址[1]:https://github.com/laixiangran/ai-learn/blob/main/src/app/rag/03_rag_evaluator/route.ts
下面具体讲解下每个指标评估器的代码实现:
上下文召回率评估器实现
衡量检索到的上下文是否覆盖参考答案所需的所有关键信息,避免遗漏关键信息。
取值在 0 到 1 之间,数值越高表示检索到的上下文覆盖越全面。
计算公式:上下文召回率 = 上下文覆盖的关键信息数量 / 参考答案中关键信息总数量。
例如,参考答案需要 5 个关键信息,若检索到的上下文覆盖其中 4 个关键信息,则上下文召回率为 0.8。
-
- 将参考答案(referenceAnswer)拆分成多个句子/关键信息(referenceAnswerStatements)。
举个例子:
{
"referenceAnswer":"2024年市场规模预计约488亿人民币,未来有望达到千亿级别,显示行业持续增长的潜力。",
"referenceAnswerStatements":[
"2024年市场规模预计约488亿人民币。",
"未来有望达到千亿级别,显示行业持续增长的潜力。"
]
}
代码实现如下:
/**
 * 将文本拆分为多个句子(关键信息)
 * @param text 待拆分的文本
 * @param evaluateLLM 拆分的 LLM
 * @returns
 */
asyncfunctionstatementSplit(text, evaluateLLM) {
const prompt = `
  你是一个语言专家,你的任务是将以下文本拆分为多个独立的句子,每个句子独立表达一个完整含义,同时保留原意的逻辑连贯性。

  说明:
  1. 严格按以下JSON格式返回:["句子1", "句子2", ...],不能输出其他无关内容。

  文本:
${text}

  回答:

  `;
const res = await evaluateLLM.invoke(prompt);
const data = formatToJson(res) || [];
console.log('statements: ', data);
return data;
}
-
- 逐个分析每个句子/关键信息(referenceAnswerStatements)是否可归因于给定的上下文(retrievedContext)并计算上下文召回率(contextRecall)。
举个例子:
{
"retrievedContext":[
"2016 年,美国教育部拨款40亿\n美元用以计算机科学教育普及\n五年计划。\n英国:渗透率9.3%\n2024 年,英国把编程纳入5-12 岁\n少儿的必修课。\n芬兰\n2016年,芬兰将编程纳入小学教学大纲",
    ...
],
"referenceAnswer":"2024年市场规模预计约488亿人民币,未来有望达到千亿级别,显示行业持续增长的潜力。",
"referenceAnswerStatements":[
"2024年市场规模预计约488亿人民币。",
"未来有望达到千亿级别,显示行业持续增长的潜力。"
]
"contextRecall":{
"score":1,
"data":[
{"score":1,"statement":"2024年市场规模预计约488亿人民币。"},
{
"score":1,
"statement":"未来有望达到千亿级别,显示行业持续增长的潜力。"
}
]
}
}
代码实现如下:
/**
 * 上下文召回率评估器。
 * 实现步骤:
 * 1. 将参考答案拆分成多个句子(关键信息);
 * 2. 逐个分析每个句子(关键信息)是否可归因于给定的上下文;
 * 3. 根据每个句子(关键信息)的得分,计算上下文召回率。
 * @param evaluateData 评估数据
 * @param evaluateLLM 评估 LLM
 * @returns
 */
asyncfunctioncontextRecallEvaluator(evaluateData, evaluateLLM) {
// retrievedContext 检索到的上下文
// referenceAnswer 参考答案
// referenceAnswerStatements 参考答案拆分出的多个句子(关键信息)
const { retrievedContext, referenceAnswer, referenceAnswerStatements } =
    evaluateData;
let newStatements = [];
if (!referenceAnswerStatements) {
    newStatements = awaitstatementSplit(referenceAnswer, evaluateLLM);
  } else {
    newStatements = [...referenceAnswerStatements];
  }
const allRes = [];
// 逐个分析每个句子(关键信息)是否可归因于给定的上下文
while (newStatements.length > 0) {
const statement = newStatements.shift();
const prompt = `
你是一个语言专家,你的任务是分析句子是否可归因于给定的上下文。

说明:
1. 如果句子不能归因于上下文,则得分为0;
2. 如果句子能够归因于上下文,则得分为1;
3. 严格按以下JSON格式返回:{"score": "得分"},不能输出其他无关内容。

句子:
${statement}

上下文:
${retrievedContext.join('\n')}

回答:

`;
const llmRes = await evaluateLLM.invoke(prompt);
const data = formatToJson(llmRes);
    allRes.push({
score: data?.score ? +data.score : 0,
      statement,
    });
console.log('contextRecallEvaluator: ', allRes);
  }
// 根据每个句子(关键信息)的得分,计算上下文召回率
const score =
    allRes.reduce((score, cur) => {
      score += +cur.score;
return score;
    }, 0) / allRes.length;
return {
    score,
data: allRes,
  };
}
上下文相关性评估器实现
衡量检索到的上下文与问题之间的相关性,避免包含无关冗余内容。
取值在 0 到 1 之间,数值越高表示检索到的上下文相关性越高。
计算公式:上下文相关性 = 上下文中与问题相关的片段数量 / 上下文中片段总数量。
例如,检索到的上下文总共有 5 个片段,与问题相关的片段有 4 个,则上下文相关性为 0.8。
-
- 逐个分析每个上下文片段(retrievedContext)是否与问题(question)相关并计算上下文相关性(contextRelevance)。
举个例子:
{
"question":"预计2024年少儿编程教育市场规模是多少?未来潜力如何?",
"retrievedContext":[
"2016 年,美国教育部拨款40亿\n美元用以计算机科学教育普及\n五年计划。\n英国:渗透率9.3%\n2024 年,英国把编程纳入5-12 岁\n少儿的必修课。\n芬兰\n2016年,芬兰将编程纳入小学教学大纲",
    ...
],
"contextRelevance":{
"score":0.7,
"data":[
{
"score":0,
"context":"2016 年,美国教育部拨款40亿\n美元用以计算机科学教育普及\n五年计划。\n英国:渗透率9.3%\n2024 年,英国把编程纳入5-12 岁\n少儿的必修课。\n芬兰\n2016年,芬兰将编程纳入小学教学大纲"
},
      ...
]
}
}
代码实现如下:
/**
 * 上下文相关性评估器
 * 实现步骤:
 * 1. 逐个分析每个上下文片段是否与问题相关;
 * 2. 根据每个上下文片段的得分,计算上下文相关性。
 * @param evaluateData 评估数据
 * @param evaluateLLM 评估 LLM
 * @returns
 */
asyncfunctioncontextRelevanceEvaluator(evaluateData, evaluateLLM) {
// question 问题
// retrievedContext 检索到的上下文
const { question, retrievedContext } = evaluateData;
const newRetrievedContext = [...retrievedContext];
const allRes = [];
// 逐个分析每个上下文片段是否与问题相关
while (newRetrievedContext.length > 0) {
const context = newRetrievedContext.shift();
const prompt = `
你是一个语言专家,你的任务是确定上下文是否与问题有关。

说明:
1. 如果上下文与问题无关,则得分为0;
2. 如果上下文与问题有关,则得分为1;
3. 严格按以下JSON格式返回:{"score": "得分"},不能输出其他无关内容。

问题:
${question}

上下文:
${context}

回答:

`;
const llmRes = await evaluateLLM.invoke(prompt);
const data = formatToJson(llmRes);
    allRes.push({
score: data?.score ? +data.score : 0,
      context,
    });
console.log('contextRelevanceEvaluator: ', allRes);
  }
// 根据每个上下文片段的得分,计算上下文相关性
const score =
    allRes.reduce((score, cur) => {
      score += +cur.score;
return score;
    }, 0) / allRes.length;
return {
    score,
data: allRes,
  };
}
答案忠实度评估器实现
衡量实际答案是否严格基于检索到的上下文,避免幻觉。
取值在 0 到 1 之间,数值越高表示实际答案越严格基于检索到的上下文。
计算公式:答案忠实度 = 上下文能够推断出事实的数量 / 实际答案拆解出的事实总数量。
例如,实际答案拆解出 5 个事实,若检索到的上下文覆盖其中 4 个事实,则答案忠实度为 0.8。
-
- 将实际答案(answer)拆分成多个句子(answerStatements)。
举个例子:
{
"answer":"根据提供的上下文信息,2024年少儿编程教育市场的规模约为488亿元人民币。从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。这表明少儿编程教育具有巨大的发展潜力和空间。",
"answerStatements":[
"2024年少儿编程教育市场的规模约为488亿元人民币。",
"从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。",
"这表明少儿编程教育具有巨大的发展潜力和空间。"
]
}
代码实现如下:
/**
 * 将文本拆分为多个句子(关键信息)
 * @param text 待拆分的文本
 * @param evaluateLLM 拆分的 LLM
 * @returns
 */
asyncfunctionstatementSplit(text, evaluateLLM) {
const prompt = `
  你是一个语言专家,你的任务是将以下文本拆分为多个独立的句子,每个句子独立表达一个完整含义,同时保留原意的逻辑连贯性。

  说明:
  1. 严格按以下JSON格式返回:["句子1", "句子2", ...],不能输出其他无关内容。

  文本:
${text}

  回答:

  `;
const res = await evaluateLLM.invoke(prompt);
const data = formatToJson(res) || [];
console.log('statements: ', data);
return data;
}
-
- 逐个分析每个句子(answerStatements)是否可归因于给定的上下文(retrievedContext)并计算答案忠实度(faithfulness)。
举个例子:
{
"retrievedContext":[
"2016 年,美国教育部拨款40亿\n美元用以计算机科学教育普及\n五年计划。\n英国:渗透率9.3%\n2024 年,英国把编程纳入5-12 岁\n少儿的必修课。\n芬兰\n2016年,芬兰将编程纳入小学教学大纲",
    ...
],
"answer":"根据提供的上下文信息,2024年少儿编程教育市场的规模约为488亿元人民币。从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。这表明少儿编程教育具有巨大的发展潜力和空间。",
"answerStatements":[
"2024年少儿编程教育市场的规模约为488亿元人民币。",
"从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。",
"这表明少儿编程教育具有巨大的发展潜力和空间。"
],
"faithfulness":{
"score":1,
"data":[
{
"score":1,
"statement":"2024年少儿编程教育市场的规模约为488亿元人民币。"
},
{
"score":1,
"statement":"从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。"
},
{
"score":1,
"statement":"这表明少儿编程教育具有巨大的发展潜力和空间。"
}
]
}
}
代码实现如下:
/**
 * 答案忠实度评估器
 * 实现步骤:
 * 1. 将实际答案拆分成多个句子(事实);
 * 2. 逐个分析每个句子(事实)是否可归因于给定的上下文;
 * 3. 根据每个句子(事实)的得分,计算答案忠实度。
 * @param evaluateData 评估数据
 * @param evaluateLLM 评估 LLM
 * @returns
 */
asyncfunctionfaithfulnessEvaluator(evaluateData, evaluateLLM) {
// retrievedContext 检索到的上下文
// answer 实际答案
// answerStatements 实际答案拆分出的多个句子(事实)
const { retrievedContext, answer, answerStatements } = evaluateData;
let newStatements = [];
if (!answerStatements) {
    newStatements = awaitstatementSplit(answer, evaluateLLM);
  } else {
    newStatements = [...answerStatements];
  }
const allRes = [];
// 逐个分析每个句子(事实)是否可归因于给定的上下文
while (newStatements.length > 0) {
const statement = newStatements.shift();
const prompt = `
你是一个语言专家,你的任务是分析句子是否可归因于给定的上下文。

说明:
1. 如果句子不能归因于上下文,则得分为0;
2. 如果句子能够归因于上下文,则得分为1;
3. 严格按以下JSON格式返回:{"score": "得分"},不能输出其他无关内容。

句子:
${statement}

上下文:
${retrievedContext.join('\n')}

回答:

`;
const llmRes = await evaluateLLM.invoke(prompt);
const data = formatToJson(llmRes);
    allRes.push({
score: data?.score ? +data.score : 0,
      statement,
    });
console.log('faithfulnessEvaluator: ', allRes);
  }
// 根据每个句子(事实)的得分,计算答案忠实度
const score =
    allRes.reduce((score, cur) => {
      score += +cur.score;
return score;
    }, 0) / allRes.length;
return {
    score,
data: allRes,
  };
}
答案相关性评估器实现
衡量实际答案是否直接完整回答用户问题,排除冗余或跑题。
取值在 0 到 1 之间,数值越高表示实际答案更直接完整回答用户问题。
计算公式:答案相关性 = 与实际问题相关的模拟问题数量 / 实际答案推导出的模拟问题总数量。
例如,实际答案推导出 5 个模拟问题,若其中 4 个与实际问题相关,则答案相关性为 0.8。
-
- 根据实际答案(answer)推导出多个模拟问题(simulationQuestions)。
举个例子:
{
"answer":"根据提供的上下文信息,2024年少儿编程教育市场的规模约为488亿元人民币。从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。这表明少儿编程教育具有巨大的发展潜力和空间。",
"simulationQuestions":[
"2024年少儿编程教育市场的规模是多少?",
"未来五年到十年,少儿编程教育市场规模预计能达到多少?",
"为什么说少儿编程教育有巨大的发展空间?"
]
}
代码实现如下:
/**
 * 根据答案推导出多个模拟问题
 * @param text
 * @param evaluateLLM
 * @returns
 */
asyncfunctionsimulationQuestion(text, evaluateLLM) {
const prompt = `
  你是一个语言专家,你的任务是根据以下答案的核心内容来生成3个用户可能问的问题。

  说明:
  1. 严格按以下JSON格式返回:["问题1", "问题2", ...],不能输出其他无关内容。

  答案:
${text}

  回答:

  `;
const res = await evaluateLLM.invoke(prompt);
const data = formatToJson(res) || [];
console.log('questions: ', data);
return data;
}
-
- 逐个分析每个模拟问题(simulationQuestions)是否与原问题(question)相似并计算答案相关性(answerRelevance)。
举个例子:
{
"question":"预计2024年少儿编程教育市场规模是多少?未来潜力如何?",
"answer":"根据提供的上下文信息,2024年少儿编程教育市场的规模约为488亿元人民币。从长远来看,随着越来越多家长认同编程教育的重要性以及其逐渐渗透进入教学体系内,该市场有望在未来5到10年内发展成为一个千亿级别的大市场。这表明少儿编程教育具有巨大的发展潜力和空间。",
"simulationQuestions":[
"2024年少儿编程教育市场的规模是多少?",
"未来五年到十年,少儿编程教育市场规模预计能达到多少?",
"为什么说少儿编程教育有巨大的发展空间?"
],
"answerRelevance":{
"score":1,
"data":[
{
"score":1,
"simulationQuestion":"2024年少儿编程教育市场的规模是多少?"
},
{
"score":1,
"simulationQuestion":"未来五年到十年,少儿编程教育市场规模预计能达到多少?"
},
{
"score":1,
"simulationQuestion":"为什么说少儿编程教育有巨大的发展空间?"
}
]
}
}
代码实现如下:
/**
 * 答案相关性评估器
 * 实现步骤:
 * 1. 根据实际答案推导出多个模拟问题;
 * 2. 逐个分析每个模拟问题是否与原问题相似;
 * 3. 根据每个模拟问题的得分,计算答案相关性。
 * @param evaluateData 评估数据
 * @param evaluateLLM 评估 LLM
 * @returns
 */
asyncfunctionanswerRelevanceEvaluator(evaluateData, evaluateLLM) {
// question 问题
// answer 实际答案
// simulationQuestions 根据实际答案推导出的多个模拟问题
const { question, answer, simulationQuestions } = evaluateData;
let newSimulationQuestions = [];
if (!simulationQuestions) {
    newSimulationQuestions = awaitsimulationQuestion(answer, evaluateLLM);
  } else {
    newSimulationQuestions = [...simulationQuestions];
  }
const allRes = [];
// 逐个分析每个模拟问题是否与原问题相似
while (newSimulationQuestions.length > 0) {
const simulationQuestion = newSimulationQuestions.shift();
const prompt = `
你是一个语言专家,你的任务是分析模拟问题和实际问题是否相似。

说明:
1. 如果模拟问题与实际问题不相似,则得分为0;
2. 如果模拟问题与实际问题相似,则得分为1;
3. 严格按以下JSON格式返回:{"score": "相似度"},不能输出其他无关内容。

模拟问题:
${simulationQuestion}

实际问题:
${question}

回答:

`;
const llmRes = await evaluateLLM.invoke(prompt);
const data = formatToJson(llmRes);
    allRes.push({
score: data?.score ? +data.score : 0,
      simulationQuestion,
    });
console.log('answerRelevanceEvaluator: ', allRes);
  }
// 根据每个模拟问题的得分,计算答案相关性
const score =
    allRes.reduce((score, cur) => {
      score += +cur.score;
return score;
    }, 0) / allRes.length;
return {
    score,
data: allRes,
  };
}
答案正确性评估器实现
衡量实际答案的准确性,需与参考答案对比。
取值在 0 到 1 之间,数值越高表示实际答案与参考答案匹配度越高,准确性也就越高。
计算公式:答案准确性 = 实际答案覆盖的关键信息数量 / 参考答案中关键信息总数量。
例如,参考答案需要 5 个关键信息,若实际答案覆盖其中 4 个关键信息,则答案正确性为 0.8。
-
- 将参考答案(referenceAnswer)拆分成多个句子/关键信息(referenceAnswerStatements)。
举个例子:
{
"referenceAnswer":"2024年市场规模预计约488亿人民币,未来有望达到千亿级别,显示行业持续增长的潜力。",
"referenceAnswerStatements":[
"2024年市场规模预计约488亿人民币。",
"未来有望达到千亿级别,显示行业持续增长的潜力。"
]
}
代码实现如下:
/**
 * 将文本拆分为多个句子(关键信息)
 * @param text 待拆分的文本
 * @param evaluateLLM 拆分的 LLM
 * @returns
 */
asyncfunctionstatementSplit(text, evaluateLLM) {
const prompt = `
  你是一个语言专家,你的任务是将以下文本拆分为多个独立的句子,每个句子独立表达一个完整含义,同时保留原意的逻辑连贯性。

  说明:
  1. 严格按以下JSON格式返回:["句子1", "句子2", ...],不能输出其他无关内容。

  文本:
${text}

  回答:

  `;
const res = await evaluateLLM.invoke(prompt);
const data = formatToJson(res) || [];
console.log('statements: ', data);
return data;
}
-
- 逐个分析每个句子/关键信息(referenceAnswerStatements)是否可归因于给定的实际答案(question)并计算答案正确性(answerCorrectness)。
举个例子:
{
"question":"预计2024年少儿编程教育市场规模是多少?未来潜力如何?",
"referenceAnswer":"2024年市场规模预计约488亿人民币,未来有望达到千亿级别,显示行业持续增长的潜力。",
"referenceAnswerStatements":[
"2024年市场规模预计约488亿人民币。",
"未来有望达到千亿级别,显示行业持续增长的潜力。"
]
"answerCorrectness":{
"score":1,
"data":[
{"score":1,"statement":"2024年市场规模预计约488亿人民币。"},
{
"score":1,
"statement":"未来有望达到千亿级别,显示行业持续增长的潜力。"
}
]
}
}
代码实现如下:
/**
 * 答案正确性评估器
 * 实现步骤:
 * 1. 将参考答案拆分成多个句子(关键信息);
 * 2. 逐个分析每个句子(关键信息)是否可归因于给定的实际答案;
 * 3. 根据每个句子(关键信息)的得分,计算答案正确性。
 * @param evaluateData 评估数据
 * @param evaluateLLM 评估 LLM
 * @returns
 */
asyncfunctionanswerCorrectnessEvaluator(evaluateData, evaluateLLM) {
// answer 实际答案
// referenceAnswer 参考答案
// referenceAnswerStatements 参考答案拆分出的多个句子(关键信息)
const { answer, referenceAnswer, referenceAnswerStatements } = evaluateData;
let newStatements = [];
if (!referenceAnswerStatements) {
    newStatements = awaitstatementSplit(referenceAnswer, evaluateLLM);
  } else {
    newStatements = [...referenceAnswerStatements];
  }
const allRes = [];
// 逐个分析每个句子(关键信息)是否可归因于给定的实际答案
while (newStatements.length > 0) {
const statement = newStatements.shift();
const prompt = `
你是一个语言专家,你的任务是分析句子是否可归因于给定的实际答案。

说明:
1. 如果句子不能归因于实际答案,则得分为0;
2. 如果句子能够归因于实际答案,则得分为1;
3. 严格按以下JSON格式返回:{"score": "得分"},不能输出其他无关内容。

句子:
${statement}

实际答案:
${answer}

回答:

`;
const llmRes = await evaluateLLM.invoke(prompt);
const data = formatToJson(llmRes);
    allRes.push({
score: data?.score ? +data.score : 0,
      statement,
    });
console.log('answerCorrectnessEvaluator: ', allRes);
  }
// 根据每个句子(关键信息)的得分,计算答案正确性
const score =
    allRes.reduce((score, cur) => {
      score += +cur.score;
return score;
    }, 0) / allRes.length;
return {
    score,
data: allRes,
  };
}
基础版 RAG 系统评估
至此,我们基于 LLM-as-judge 自己实现了一套 RAG 系统评估系统,下面我们通过该评估系统来评估基础版 RAG 系统。
以下每一步的详细代码就不贴了,评估详细代码地址[2]:https://github.com/laixiangran/ai-learn/blob/main/src/app/rag/03_rag_evaluator/route.ts
准备 QA 测试数据
这里我准备了 20 个 测试 QA(含参考答案),QA 测试数据文件地址[3]:https://github.com/laixiangran/ai-learn/blob/main/src/app/data/qa_test_20.json
[
  ...
{
"question":"预计2024年少儿编程教育市场规模是多少?未来潜力如何?",
"referenceAnswer":"2024年市场规模预计约488亿人民币,未来有望达到千亿级别,显示行业持续增长的潜力。"
},
  ...
]
知识库构建
文档切分配置:
- • 用于分割文本的字符或字符串(separator):[“\n\n”, “\n”, " ", “”];
- • 每个文本块的最大字符数(chunk_size):500;
- • 文本块之间的重叠字符数(chunk_overlap):50。
Embedding 模型:
- • nomic-embed-text。
代码实现如下:
// 1. 文件解析
const docs = awaitloadPdf(
'src/app/data/2024少儿编程教育行业发展趋势报告.pdf'
  );

// 2. 文件切分
const texts = awaitsplitDocuments(docs);

// 3. 初始化向量模型和向量数据库,并将文档存储到向量数据库
awaitaddDocuments(texts);
指标评估
检索上下文 TopK: 3;
评估 LLM: qwen2.5:14b(Ollama 部署)。
代码实现如下:
// 单个指标评估
asyncfunctionbathEvaluator(indexName: string) {
const evaluatorMap = {
contextRecall: contextRecallEvaluator,
contextRelevance: contextRelevanceEvaluator,
faithfulness: faithfulnessEvaluator,
answerRelevance: answerRelevanceEvaluator,
answerCorrectness: answerCorrectnessEvaluator,
  };
const evaluator = evaluatorMap[indexName];
const inputPath = 'src/app/data/qa_test_20.json';
const outputPath = 'src/app/data/qa_test_20_base_evaluate.json';
const qaDatas = awaitreadJsonFile(inputPath);
const llm = initOllamaLLM('qwen2.5:14b');

const res = [];
while (qaDatas.length > 0) {
const data = qaDatas.shift();
if (!data.answer) {
const { retrievedContext, answer } = awaitllmAnswerByQaData(
        data.question
      );
      data.retrievedContext = retrievedContext;
      data.answer = answer;
    }
const evaluateRes = awaitevaluator(data, llm);
    res.push({
      ...data,
      [indexName]: evaluateRes,
    });
  }

// 将 LLM 回答结果保存到文件中
awaitsaveJsonFile(JSON.stringify(res), outputPath);

// 计算最终指标数据
const score =
    res.reduce((score, cur) => {
      score += cur[indexName].score;
return score;
    }, 0) / res.length;

return { [indexName]: +score.toFixed(1) };
}

// 指标评估
const indexs = [
'contextRecall',
'contextRelevance',
'faithfulness',
'answerRelevance',
'answerCorrectness',
];
constdata: any = {};
while (indexs.length > 0) {
const indexName = indexs.shift() || '';
const indexRes = awaitbathEvaluator(indexName);
  data[indexName] = indexRes[indexName];
}
基础版 RAG 系统(V1.0)各指标的评估结果如下:

| 版本 | 优化描述 | 上下文召回率(contextRecall) | 上下文相关性(contextRelevance) | 答案忠实度(faithfulness) | 答案相关性(answerRelevance) | 答案正确性(answerCorrectness) |
|---|---|---|---|---|---|---|
| 基础 RAG 系统(V1.0) | 无 | 0.6 | 0.5 | 0.8 | 0.5 | 0.6 |
结语
至此,我们基于 LLM-as-judge 自己实现一套 RAG 系统评估系统,用该评估系统评估了基础版 RAG 系统(V1.0)的 5 个评估指标的表现,可以看到基础版 RAG 系统(V1.0)这 5 个指标的值都是偏低的,所以后面我将通过讲解不同的优化方法来提升基础版 RAG 系统(V1.0)这 5 个指标,敬请期待。
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、大模型经典书籍(免费分享)
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取
 1342


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


