RAG系列(二):基于 DeepSeek + Chroma + LangChain 开发一个简单 RAG 系统

Ollama 可以在 Windows 上运行了 阅读详情

那么,今天我们基于这一套全栈 AI 应用开发框架开发一个简单的 RAG 系统。

创建 Next 项目

首先,使用 npx create-next-app@latest 根据提示完成 Next 项目的创建:

# 创建 Next 项目
npx create-next-app@latest

创建好项目之后,在 src/app 目录下新建 rag 目录,本次 demo 的代码都将放在这里。

知识库构建

接下来,我们将构建知识库,主要目标是将准备好的 pdf 通过向量化存到向量数据库中,以便后续的检索。

由于本次 RAG 系统的开发都要依赖 LangChain 框架,所以我们先在项目中安装 LangChain 框架和核心依赖:

# LangChain 框架和核心依赖
npm install langchain @langchain/core

文档加载

LangChain 的 DocumentLoaders[1] 提供了种类丰富的文档加载器,可加载文件系统的文件也可以加载线上文件,包括 csv、docx、pdf、pptx、html、github、youtube等等。

现在我们使用 PDFLoader[2] 来实现 pdf 的数据加载。

先安装所需的依赖包:

# @langchain/community:包含第三方集成,这些集成实现了 LangChain Core 中定义的基本接口,如:文档加载、文档嵌入、向量数据库等等
# pdf-parse:读取 pdf 文本
npm install @langchain/community pdf-parse

然后添加加载 pdf 的代码:

import { PDFLoader } from'@langchain/community/document_loaders/fs/pdf';

const loader = newPDFLoader('public/example.pdf', { splitPages: false });
const docs = await loader.load();

文档分割

加载完成后,由于加载的文档可能过长,不适合模型的上下文窗口,需要将文档分割成合适的大小。

LangChain 提供了 TextSplitter[3] 组件来实现文档分割:

import { RecursiveCharacterTextSplitter } from'langchain/text_splitter';

// chunkSize:分割文档的长度
// chunkOverlap:分割文档间的重叠长度
const textSplitter = newRecursiveCharacterTextSplitter({
chunkSize: 1000,
chunkOverlap: 200,
});
const texts = await textSplitter.splitDocuments(docs);

文档向量嵌入

接下来我们需要对分割后的文本块进行向量嵌入,然后使用 Chroma 向量数据库存储。

向量模型使用 ollama 安装的 nomic-embed-text 模型,可用 ollama run nomic-embed-text进行下载和运行,完整的代码如下:

import {
Chroma,
ChromaLibArgs,
} from'@langchain/community/vectorstores/chroma';
import { ChatOllama, OllamaEmbeddings } from'@langchain/ollama';
import { EmbeddingsInterface } from'@langchain/core/embeddings';

// 初始化 embeddings 函数
exportfunctioninitOllamaEmbeddings(model = 'nomic-embed-text') {
returnnewOllamaEmbeddings({ model });
}

// 初始化向量数据库
exportfunctioninitChroma(
  embeddings: EmbeddingsInterface = initOllamaEmbeddings(),
  args: ChromaLibArgs = {
    collectionName: 'rag_collection',
    url: 'http://localhost:8000',
  }
) {
returnnewChroma(embeddings, args);
}

// 初始化向量数据库
const chromadb = initChroma();
// 保存文本块
const documents = await chromadb.addDocuments(texts);

到此就构建好了一个简单的知识库。

RAG 系统构建

在创建好知识库之后,接下来就可以开始构建一个基础的 RAG 系统。该系统包括检索器与生成器两部分,具体工作流程如下:对于用户输入的问题,检索器先搜索与该问题相关的文档,接着将检索到的文档与初始问题一起传递给生成器,即大语言模型,最后将模型生成的答案返回给用户。

检索器创建

我们先基于 VectorStoreRetriever 创建检索器,利用向量相似度进行检索。

// 初始化向量数据库
const chromadb = initChroma();
// 创建检索器
const retriever = chromadb.asRetriever();

生成器创建

接下来我们创建生成器,这里我们使用 Ollama 安装的 deepseek-r1:14b 大模型作为生成器。

import { ChatOllama } from'@langchain/ollama';

exportfunctioninitOllamaLLM(model = 'deepseek-r1:14b') {
returnnewChatOllama({ model });
}

// 创建生成器(初始化大模型)
const ollamaLLM = initOllamaLLM()

然后再设置提示模版:

// 设置提示模版
const prompt = PromptTemplate.fromTemplate(
'你是负责回答问题的助手。使用以下检索到的上下文片段来回答问题。如果你不知道答案,就说你不知道。\n\n上下文:{context}\n\n问题:{question}\n\n回答:'
  );

RAG 链生成答案

最后我们通过 RAG 链将检索器和生成器整合在一起,这里可以使用 LangChain 表达式语言(LangChain Execution Language,LCEL)来方便快捷地构建一个链,将检索到的文档、构建的输入 Prompt 以及模型的输出组合起来。

// 使用 LCEL 构建 RAG 链
const ragChain = RunnableSequence.from([
    {
context: retriever.pipe((docs) => {
// 文档列表使用 \n\n 拼接为字符串
return docs.map((doc) => doc.pageContent).join('\n\n');
      }),
question: newRunnablePassthrough(),
    },
    prompt,
    ollamaLLM,
newStringOutputParser(),
  ]);

// 使用 RAG 链生成答案
const answer = await ragChain.invoke(question);

项目代码

代码:https://github.com/laixiangran/ai-learn

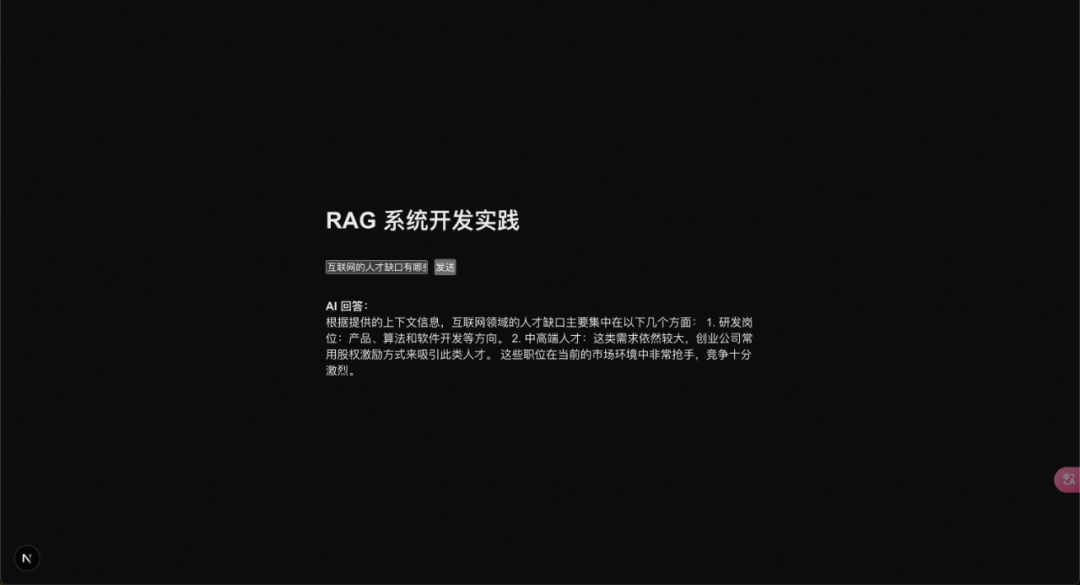
启动项目之后在浏览器输入 http://localhost:3000/rag 即可访问该 RAG 系统,然后在输入框输入问题:互联网的人才缺口有哪些
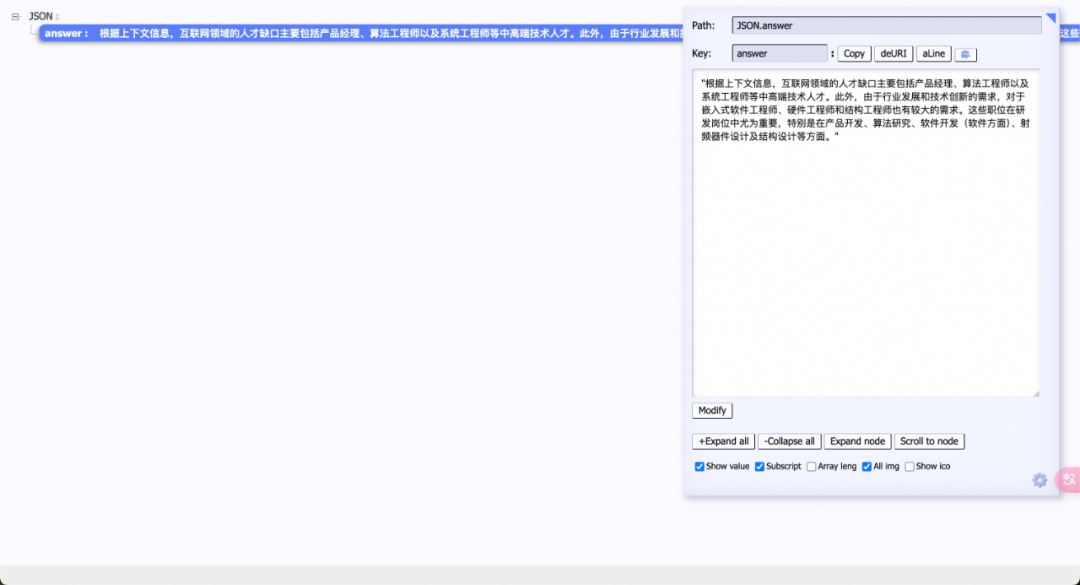
也可以通过访问 http://localhost:3000/rag/generate?question=互联网的人才缺口有哪些
通过以上步骤,我们就完成了一个基础 RAG 系统的搭建,其中借助于 LangChain 提供了一系列强大的工具和组件,使得构建和整合检索与生成过程变得简单而高效。而借助 Ollama 我们也能够在本地部署大语言模型和向量模型,这让我们可以以较小的资源进行 AI 的开发学习实践。
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

Ollama入门教程:从安装到运行的完整指南 随着人工智能(AI)技术的快速发展,大型语言模型(LLMs)逐渐成为了各行各业的重要工具。然而,使用这些强大模型的同时,数据隐私、处理效率和部署复杂度等问题也逐渐浮现。为了解决这些问题,Ollama 提供了一种创新的解决方案——通过本地化部署大型语言模型,不仅能够增强数据隐私性,还能提高模型的运行效率。本文将详细介绍如何下载和安装 Ollama,如何选择和运行不同的语言模型,以及 Ollama 的特点、适用场景、优缺点等内容,帮助大家深入了解这一平台。ollama官网🚪 ollama官方文档🚪 根据自己 阅读详情

相关推荐

Ollama:一个在本地部署、运行大型语言模型的工具

所谓自定义模型就是不适用Ollama官方模型库中的模型,理论可以使用其他各类经过转换处理的模型Ollama库中的模型可以通过提示进行自定义。python复制代码FROM llama3 # 设置温度参数 PARAMETER temperature 1 # 设置SYSTEM 消息 SYSTEM """作为AI智能助手,你将竭尽所能为员工提供严谨和有帮助的答复。"""Modelfile文档One-API是一个OpenAI接口管理 & 分发系统,支持各类大模型。这里使用Docker快速进行部署。拉取镜像。

2401_84495725的博客 6721

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

DeepSeek-R1本地RAG部署实战:Ollama+LangChain+Chroma避坑指南

RAG(检索增强生成)是让大模型精准回答私有文档问题的核心技术,其本质是将向量检索与语言生成协同工作,通过分块、嵌入、检索、重排、生成五步闭环提升事实准确性并抑制幻觉。技术价值在于平衡响应速度、显存占用与答案质量,尤其适合合同解读、技术文档问答等办公场景。实际落地时,OllamaEmbeddings与DeepSeek-R1模型同源性、Chroma持久化路径配置、PDF扫描件OCR适配等细节直接决定系统稳定性。本文聚焦本地化RAG工程实践,详解如何基于Ollama、LangChain和Chroma构建可交付的

weixin_33719619的博客 342

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

【大模型工程局】基于Ollama、DeepSeek、LangChain和Streamlit的RAG应用部署

随着AI技术的迅猛发展,Retrieval-Augmented Generation (RAG)系统已成为构建智能问答系统的核心。RAG系统通过结合信息检索与生成模型的能力,不仅能够检索相关知识,还能基于这些知识生成准确的答案。本文将带你深入了解如何使用Ollama、DeepSeek、LangChain和Streamlit等技术栈,在Ubuntu系统上部署一个完整的RAG应用。

高校图书馆高级系统架构师/研究馆员,推动高校AI从概念演示到可评审、可交付、可运维:路线图与立项评审、PoC交付、评测回归与上线运维(Baseline/Eval/Ops)。 1858

OpenWrt国内镜像源一键切换脚本:清华/阿里/中科大源全搞定

本文介绍了OpenWrt国内镜像源一键切换脚本,支持清华、阿里和中科大三大源,自动识别设备架构和系统版本,显著提升软件包安装速度和成功率。脚本包含架构自动识别、版本适配、多源选择和配置备份等功能,适用于x86_64、ramips/mt7621等常见架构,帮助用户解决海外源访问缓慢的问题。

g5h6i的博客 1176

RAG系列:基于 DeepSeek + Chroma + LangChain 开发一个简单 RAG 系统

今天我们基于这一套全栈 AI 应用开发框架开发一个简单的 RAG 系统。

大模型教程的博客 1967

使用vcpkg快速安装opencascade并自动配置部署开发环境

广泛的开源库:vcpkg 提供了上千个流行的 C++ 开源库,用户可以通过简单的命令安装和集成这些库,包括 Boost、OpenCV、SQLite、fmt 等。确保包版本一致性:通过 vcpkg.json 文件,开发者可以指定依赖的库版本,确保项目在不同环境下的构建结果一致,避免由于依赖库版本不一致而导致的构建问题。强大的社区支持:Vcpkg 是开源项目,拥有活跃的社区和微软团队的支持,提供了稳定的更新和问题修复。快速更新:Vcpkg 社区活跃,库的更新速度较快,开发者可以迅速获得库的最新版本。

loujiand的博客 2293

大模型实战;基于 DeepSeek + Chroma + LangChain 开发一个简单 RAG 系统

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

2401_85375186的博客 1107

ShardingSphere分库分表教程,java后端开发面试题

???? 简介:Java领域优质创作者????、优快云哪吒公众号作者✌ 、Java架构师奋斗者???? ???? 扫描主页左侧二维码,加入群聊,一起学习、一起进步 ???? 欢迎点赞 ???? 收藏 ⭐留言 ???? 目录 一、分库分表 二、分库分表的方式 1、垂直分表 2、垂直分库 3、水平分表 4、水平分库 三、分库分表带来的问题 1、学习成本问题 2、事务问题 3、跨节点join问题 4、跨节点的count、order by、group by以及聚合函数问题 5、数据迁移、容量规划、扩

m0_64205716的博客 3015

打造会自主学习的 AI 助手:OpenClaw 记忆系统完全指南

这不是科幻,这是我正在使用的系统。我的 AI 助手「小琳」已经运行了一段时间,积累了大量的知识和经验,而且还在不断学习成长。心跳(Heartbeat)是 OpenClaw 的定时轮询机制,可以让 AI 主动做一些事情。你有没有遇到过这样的困扰:每次和 AI 对话,它都像失忆了一样,之前聊过的内容完全不记得?设置定时任务:每天早上 8 点,查询天气和热点新闻,通过钉钉推送给我。让你的 AI 助手拥有持久记忆,能够自主学习、总结经验、不断成长。这不仅仅是一个「能记住事情的 AI」,而是一个。

Honmaple的博客 1633

零基础吗,手把手教你基于 DeepSeek + Chroma + LangChain 开发一个简单 RAG 系统

那么,今天我们基于这一套全栈 AI 应用开发框架开发一个简单的 RAG 系统。

ytt0523_com的博客 1106

SAP中MRP运行计划行超限问题的分析与解决

SAP中基于生产性物料的采购特点,通常会采用采购计划协议的方式进行采购。其具体的采购计划通常来自于成品计划独立需求,然后通过物料清单,经由MRP跑出。 在采购计划协议中的计划行中,存在一个计划行号,随着MRP在不断跑出新的计划行,该行号资源会消耗完。当计划行号消耗完后,MRP不会再跑出新的计划行。且在MD04或MD02中看不到类似提示信息。此时可以通过MD05来查看是否出现类似下图的提示信息。 ...

专注SAP应用技术文章写作,致力于拉近用户与系统间的距离; 3845

大模型开发手记(二):基于 LangChain 的 RAG 架构全面解析与落地实践

这个系列博客主要打算汇总一下python大模型开发的所有知识体系,大模型知识点太多,包括langchain、langgraph、deepagent、RAG应用等等,时间长了脑子就乱子,这篇博客主要汇总一下基于langchain的RAG开发的相关知识点,重点在整个流程和原理,只要弄懂了原理,不一定是基于langchain,用java调用各个组件,也是可以实现rag的大部分流程。

勇往直前的博客 912

Unity WebGL项目如何实现画布透明,完美融入网页背景(附.jslib文件与完整配置)

本文详细解析了Unity WebGL项目实现画布透明化的技术原理与实战步骤,从.jslib文件配置到前端框架集成,帮助开发者解决默认背景色问题,实现3D内容与网页设计的无缝融合。重点介绍了透明化核心机制、常见误区及React/Vue等现代框架中的最佳实践方案。

weixin_31896061的博客 300

matlab 一维相位解缠

一维相位解缠算法的matlab代码实现。

点云侠的博客 372

1.从零拆解一个 RAG 系统:纯 API 调用、无需 GPU|基于 LangChain + Chroma + DeepSeek 的学习笔记

RAG 的核心思路并不复杂——先搜后答。切分决定了知识库的"颗粒度"检索决定了能不能找到对的内容Prompt决定了大模型能不能好好利用这些内容这个项目的价值在于,它把这些环节都做成了可配置、可对比的,非常适合用来学习和实验。如果你也在学 RAG,建议把项目跑起来,多试几种参数组合,看看效果的变化,比光看文档理解深刻得多。📌 本文基于个人学习实践整理,如有错误欢迎指正。

Valiners的博客 482

083、多帧降噪(MFR)与VST算法:低照度场景下的信噪比提升与鬼影抑制

本文深入探讨了多帧降噪(MFR)和VST算法在低照度场景中的应用与优化。作者从实际项目案例出发,指出单帧降噪的局限性,详细分析了MFR的核心原理与工程实现中的关键环节,包括帧对齐、帧选择、融合策略和鬼影抑制等技术要点。文章特别强调VST变换对噪声均匀化的重要性,并分享了实际开发中的调试经验与参数优化技巧,如"三明治"调试法和性能平衡策略。最后指出,优秀的MFR方案需要在信噪比提升、鬼影抑制和纹理保留之间找到场景化的平衡点,建议开发者通过真实场景测试验证算法效果。全文既有理论分析,又包含丰富的实战经验和技术细

zzfmlxs的博客 123

基于LangChain的RAG开发(02)-简单的RAG应用

本文采用deepseek-chat模型作为大模型,以智谱AI的Embedding-3模型为词嵌入模型,采用Chroma向量库,记忆LangChain框架实现简单的RAG应用。

pythonhy的博客 787

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

如何使用 DeepSeek-R1、LangChain 和 Ollama 构建隐私优先的 RAG

k: 检索结果数量控制响应中使用的文档块数量。更高的k: 更多上下文,响应较慢。更低的k: 更少上下文,响应较快。: 相似度阈值根据相关性过滤检索结果。更高的阈值: 仅检索高度相关的块。更低的阈值: 更广泛的上下文但不够精确。

大模型教程的博客 1099

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

基于LangChain与DeepSeek构建本地知识库问答系统

知识库问答系统(KBQA)是自然语言处理与信息检索技术的结合体,通过将非结构化文档转化为结构化知识,实现精准的语义搜索与答案生成。其核心技术RAG(检索增强生成)通过向量数据库存储文档嵌入,利用大语言模型理解查询意图并生成回答,有效解决了传统搜索返回结果冗余和大模型幻觉问题。在工程实践中,LangChain框架通过模块化设计简化了文档加载、文本分割、向量检索的流程集成,而国产大模型DeepSeek凭借出色的中文理解能力成为本地化部署的优选方案。这种技术组合特别适用于企业知识管理、法律条款查询等需要高准确率的

weixin_34248487的博客 431

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

从零构建本地知识库问答系统:LangChain + DeepSeek + Chroma 实战

本文介绍了如何用不到200行Python代码构建基于LangChain+DeepSeek+Chroma的本地知识库问答系统。该系统采用RAG(检索增强生成)技术,解决大语言模型的知识局限和幻觉问题,支持PDF/TXT/MD文件和网页内容加载,使用中文优化的Embedding模型,具备持久化向量库和多轮对话功能。文章详细解析了系统架构、核心代码实现(文档切分、向量库构建、RAG链)以及快速上手指南,并展示了实际问答效果。该项目模块化设计、开箱即用,可作为RAG落地的入门实践基础。

wangxinpo的博客 810

Python+LangChain+Ollama+Chroma实现RAG问答

Python+LangChain+Ollama+Chroma实现RAG问答

tadexinnian的博客 563
上一篇: RAG系列(一):一文让你由浅到深搞懂RAG实现,大模型入门到精通,收藏这篇就足够了!
下一篇: RAG系列(三):系统评估 - 构造QA测试数据集
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
