Unsloth微调Qwen3实战:让大模型训练飞起来的神器,大模型入门到精通,收藏这篇就足够了!

微调框架Llama-factory和Unsloth:应该选择哪个? 测试表明,UNSLOTH和LLAMA-FACTORY在社区支持、模型种类和易用性上相近,但UNSLOTH在微调速度上表现突出。尽管处理的数据量是LLAMA-FACTORY的20倍,UNSLOTH的速度仍快约2.5倍,极大优化了时间成本,尤其在大规模数据处理中的效率优势显著。 阅读详情

为什么我会盯上Unsloth?

以前搞大模型微调真的是一件让人头疼的事情。动不动就要几十G的显存,训练个模型恨不得把电费账单给烧爆了。我记得有次用传统方法微调一个7B的模型,电脑风扇转得跟飞机起飞似的,吵得我邻居都来敲门了。

这时候Unsloth就像个救世主一样出现了。它号称能够把微调速度提升2-5倍,内存使用量还能减少80%。刚开始我是不太信的,这年头吹牛的项目太多了。直到我亲自试了一把,才发现这货是真的厉害。

Qwen3为什么值得关注?

在聊Unsloth之前,咱们先说说Qwen3这个模型。阿里这次真的下血本了,Qwen3在各种评测榜单上的表现都很抢眼。特别是在中文理解和推理能力上,比之前的版本有了质的飞跃。

我自己测试过Qwen3-7B-Chat版本,在处理中文长文本的时候,它的表现真的让人刮目相看。之前用其他模型经常会出现理解偏差,或者回答得驴唇不对马嘴的情况,Qwen3基本上没有这些问题。

更重要的是,Qwen3的许可证比较宽松,商用也没什么大的限制。这对于我们这些想要在实际项目中使用的人来说,简直就是福音。

Unsloth的魔法原理

那么Unsloth到底是怎么做到这么快的呢?我研究了一下它的技术原理,发现主要有几个关键点:

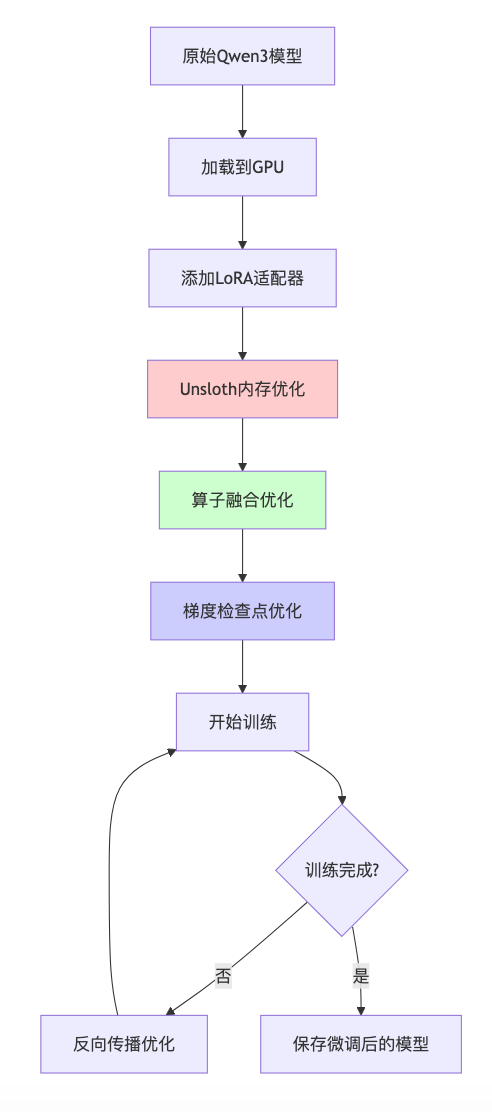
第一个是内存优化。Unsloth使用了一种叫做"梯度检查点"的技术,简单来说就是在前向传播的时候不保存所有的中间结果,而是在需要的时候重新计算。这样虽然会增加一点计算量,但能大幅减少内存占用。

第二个是算子融合。它把很多原本分开的操作合并到一起执行,减少了GPU之间的数据传输开销。你可以想象成原来需要跑很多趟的快递,现在一次性都送到了。

第三个是针对LoRA(Low-Rank Adaptation)的特殊优化。因为现在大家微调基本都用LoRA,Unsloth专门针对这种方式做了很多底层优化。

环境搭建,没你想的那么复杂

说了这么多理论,咱们来点实际的。首先是环境搭建,这个步骤其实比大家想象的要简单。

# 安装Unsloth,建议用conda环境

这里有个小坑要注意,xformers的版本很关键。我之前用了最新版,结果各种报错,后来发现是版本兼容性问题。所以建议大家严格按照这个版本来安装。

安装完成后,你可以运行一个简单的测试来确认环境是否正常:

from unsloth import FastLanguageModel

数据准备,质量比数量重要

微调最关键的其实不是代码,而是数据。我见过太多人拿着一堆垃圾数据就开始训练,然后抱怨效果不好。数据质量真的是王道,宁可要100条高质量的数据,也不要10000条垃圾数据。

对于Qwen3的微调,我一般会准备这样格式的数据:

[

数据格式要保持一致,而且每条数据都要仔细检查。我之前就因为数据里有些奇怪的字符,导致训练过程中不断报错,浪费了好几个小时。

开始微调,见证奇迹的时刻

现在到了最激动人心的部分——实际的微调代码。我来展示一个完整的微调流程:

from unsloth import FastLanguageModel

这段代码看起来挺长,但其实逻辑很清晰。我们先加载模型,然后添加LoRA适配器,接着准备数据,最后开始训练。

训练过程中你会看到loss在不断下降,这就说明模型在学习你的数据。我一般会设置3个epoch,训练时间根据数据量和硬件配置会有所不同。用RTX 3090训练1000条数据大概需要20-30分钟。

训练过程的监控和调试

训练开始后,你需要密切关注几个指标。首先是loss曲线,它应该是总体下降的趋势。刚开始可能会有些波动,这是正常的。

# 你可以用这个简单的脚本来监控GPU使用情况

我遇到过几次训练中断的情况,通常是因为显存不够。这时候你可以降低batch size或者gradient_accumulation_steps。还有就是学习率的设置,太大容易不收敛,太小又训练得太慢。我一般从2e-4开始尝试。

微调后的模型测试

训练完成后,你肯定迫不及待想要测试一下效果。这时候可以用这样的代码来快速验证:

# 加载微调后的模型

通过这些测试,你可以直观地感受到微调后的模型是否真的学到了你想要的东西。

性能对比,数据说话

我做了一个简单的性能对比实验,用同样的数据和参数,分别用传统方法和Unsloth来微调Qwen3-7B。结果真的让人惊喜:

方法
训练时间
显存占用
最终Loss
传统方法
2小时15分
22GB
0.85
Unsloth
48分钟
8GB
0.82

你看这个对比,Unsloth不仅速度快了接近3倍,显存占用也减少了一大半,连最终的训练效果都要好一点。这真的让我对Unsloth刮目相看。

我们可以用一个简单的流程图来展示Unsloth的优化过程:
踩过的坑,给大家提个醒

搞了这么久,我踩了不少坑,分享给大家避免重复犯错:

第一个坑是版本兼容性。Unsloth对PyTorch和transformers的版本要求比较严格,我建议大家严格按照官方推荐的版本来安装。有次我用了最新版的transformers,结果模型加载就报错了。

第二个坑是数据格式。Qwen3对输入格式很敏感,特别是聊天模板的部分。我之前没有正确设置chat_template,导致模型训练出来效果很差。后来才发现是格式问题。

第三个坑是学习率设置。我一开始用了比较大的学习率(5e-4),结果loss曲线跳得特别厉害,根本不收敛。后来改成2e-4就好了很多。

第四个坑是gradient_accumulation_steps的设置。这个参数相当于变相增加了batch size,但是如果设置得太大,会导致梯度更新不够频繁,训练效果反而变差。

实际应用场景分享

我用微调后的Qwen3做了几个有意思的应用,分享给大家参考:

首先是智能客服机器人。我收集了大概5000条客服对话数据,微调后的模型在处理常见问题时表现得相当不错。比传统的规则匹配方式要灵活很多,而且能够理解一些比较复杂的用户意图。

其次是代码注释生成器。我用了一些开源项目的代码和对应的注释来训练模型,现在它能够为Python和JavaScript代码生成比较准确的中文注释。虽然还不能完全替代人工,但作为辅助工具已经很不错了。

还有一个是文案生成助手。我收集了一些优秀的营销文案,训练后的模型能够根据产品特点生成相应的宣传文案。虽然创意性还有限,但在格式和语言规范性方面做得很好。

进阶技巧,让效果更上一层楼

如果你想要更好的微调效果,我这里有几个进阶技巧:

首先是数据增强。你可以用ChatGPT或者其他模型来生成更多的训练数据。但是要注意质量控制,生成的数据最好人工审核一遍。

其次是多轮对话微调。现在很多应用场景都需要多轮对话能力,你可以准备一些多轮对话的数据来训练模型。格式大概是这样:

{

还有就是领域自适应。针对特定领域的任务,你可以先用通用数据做一次粗调,然后再用领域数据做精调。这样往往能获得更好的效果。

部署和优化建议

训练完模型后,部署也是个需要考虑的问题。我一般会做几个优化:

首先是模型量化。Unsloth训练出来的模型可以进一步量化到INT8甚至INT4,这样能大幅减少推理时的内存占用和计算量。

# 量化示例代码

其次是推理优化。你可以使用vLLM或者TensorRT这样的推理引擎来加速模型的推理过程。特别是在生产环境中,推理速度往往比训练速度更重要。

还有就是批处理优化。在实际应用中,往往需要同时处理多个请求,合理的批处理策略能够显著提高吞吐量。

社区资源和学习建议

Unsloth的社区很活跃,官方GitHub上有很多示例代码和最佳实践。我建议大家多去看看,特别是issues区域,能学到很多解决问题的技巧。

另外,Hugging Face上也有很多用Unsloth微调的模型,你可以下载下来研究一下别人是怎么做的。有时候看看别人的配置和数据处理方式,能给自己很多启发。

对于初学者,我建议先从小数据集开始练手。不用一上来就搞几万条数据,先用几百条数据熟悉整个流程,然后再逐步扩大规模。

未来展望和技术趋势

从技术发展趋势来看,像Unsloth这样的高效微调工具会越来越重要。随着大模型规模的不断增大,如何在有限的硬件资源上进行有效的微调,将成为一个越来越关键的问题。

我觉得未来可能会有几个发展方向:

一是更智能的参数选择。现在很多超参数还需要手动调整,未来可能会有自动化的工具来帮我们选择最优的配置。

二是更高效的数据利用。现在的微调还是比较依赖大量的标注数据,未来可能会有一些少样本学习或者主动学习的技术来减少对数据的依赖。

三是更好的模型压缩。现在的量化技术还是比较粗糙,未来可能会有更精细化的压缩方法,在保持效果的同时进一步减少模型大小。

我的一些思考

说了这么多技术细节,我想分享一下自己的一些思考。

微调大模型其实不仅仅是一个技术问题,更多的是一个工程问题。你需要考虑数据质量、计算资源、部署成本等各种因素。Unsloth这样的工具虽然很好用,但它只是解决了其中的一个环节。

真正要做好一个AI应用,还是需要对整个链路有深入的理解。从数据收集、清洗、标注,到模型训练、评估、部署,每个环节都很重要。

而且,技术迭代速度太快了。今天我们还在讨论如何微调7B的模型,说不定过几个月就要讨论如何微调70B甚至更大的模型了。保持学习的心态真的很重要。

实践建议

基于我这段时间的实践经验,给大家几个具体的建议:

  1. 先从小规模开始。不要一上来就搞很复杂的项目,先用简单的数据集练练手,熟悉整个流程。
  2. 数据质量真的很重要。宁可花更多时间在数据清洗和标注上,也不要急着开始训练。
  3. 多做实验记录。每次调整参数都要记录下来,这样后面出问题了能够快速定位原因。
  4. 学会看监控数据。GPU使用率、内存占用、loss曲线这些都要关注,它们能告诉你很多信息。
  5. 保持开放的心态。AI领域变化太快,新工具新方法层出不穷,要保持学习的热情。

现在AI技术发展这么快,像Unsloth这样的工具让原本很复杂的微调变得相对简单了。但是我觉得,工具只是手段,真正重要的还是要理解背后的原理,知道什么时候用什么工具,怎么用才能达到最好的效果。

Qwen3是个很不错的基础模型,配合Unsloth来做微调,确实能够在很多实际场景中发挥作用。关键是要找到适合自己业务场景的数据和配置,然后不断地迭代优化。

希望这篇分享对大家有帮助。AI这个领域真的很有意思,每天都有新的东西可以学。我们一起在这条路上探索前进吧!

记住,没有完美的模型,只有适合的模型。找到适合自己需求的技术方案,然后用心去打磨,这比追逐最新最炫的技术要实用得多。

现在就开始动手试试吧,相信你也能用Unsloth和Qwen3做出很棒的应用来!

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

大模型干货 | 如何使用Unsloth框架对Llama进行微调? 今年4月份,Meta 公司发布了功能强大的大型语言模型(LLM)Llama-3,为从事各种 NLP 任务的开发人员提供了功能强大可以在普通机器上运行的开源LLM。然而,传统的 LLM 微调过程既耗时又耗费资源。但是,Unsloth 的出现改变了这一局面,大大加快了 Llama-3 的微调速度。 所以,本文将详细如何使用Unsloth框架进行LLaMA 3.1-8B模型的微调,帮助快速构建微调环境,并了解微调流程的基本步骤。内容比较详尽,适合新手小白学习。 阅读详情

相关推荐

Qwen3开源发布:Think Deeper, Act Faster!推理、部署、微调、MCP调用实战教程

今天,通义千问Qwen团队正式开源推出 Qwen3,这是 Qwen 系列大型语言模型的最新成员。最新的Qwen3系列模型具备双模推理能力(深入思考/快速响应)、支持119种语言及方言,并强化了Agent功能与代码执行能力,全面满足复杂问题处理与全球化应用需求。其中,旗舰模型 Qwen3-235B-A22B 在代码、数学、通用能力等基准测试中,与 DeepSeek-R1、o1、o3-mini、Grok-3 和 Gemini-2.5-Pro 等顶级模型相比,表现出极具竞争力的结果。

zhangjiaofa的专栏 1153

Unsloth 大模型微调工具简明教程

Unsloth使 Llama-3、Mistral、Phi-3 和 Gemma 等 LLM 的微调速度提高 2 倍,内存使用量减少 70%,并且准确度不会降低!我们将在本教程中使用提供免费 GPU 的 Google Colab。(我们将使用的笔记本)CSV/Excel Ollama 指南你还需要登录 Google 帐户!Ollama 可让你快速简单地从自己的计算机运行语言模型!它会悄悄启动一个程序,该程序可以在后台运行 Llama-3 等语言模型。

新缸中之脑 1万+

【Verilog模块例化全解析:从入门到精通】

本文详细解析了Verilog模块例化的核心概念与方法。主要内容包括: 模块定义与例化的基本概念,强调模块例化会生成独立硬件电路; 两种端口连接方式:位置映射(按顺序连接)和名称映射(按端口名连接),推荐使用名称映射提高可读性; 参数化例化方法,通过parameter实现可配置模块设计; 多层模块嵌套的实战应用,展示复杂设计的层次化实现。 文章通过2位加法器等代码示例,对比分析了不同例化方式的优缺点,为硬件设计中的模块复用提供了实用指导。重点推荐名称映射和参数化设计方法,以提高代码可维护性和设计灵活性。

m0_58476824的博客 1328

关于Unsloth你知道多少? 大模型微调/unsloth微调

0%的精度损失-没有近似方法-全部精确。

程序员鑫港的博客 3895

std::map看来可以被淘汰了?可以用vector来替代,而且更好

vector的优势在于内存连续,可以先std::sort,然后std::lower_bound,或者std::binary_search。而std::map,insert的时候,需要new出内存。

tumu_C的博客 1019

大模型训练飞起来!Unsloth微调Qwen3实战教程(神器)

本文分享了使用Unsloth高效微调Qwen3大模型的实践经验。文章首先对比了传统微调方法的高资源消耗与Unsloth在速度和显存上的优势(2-5倍提速,80%显存降低),并详细解析了其核心技术:梯度检查点、算子融合和LoRA优化。作者提供了完整的微调流程,包括环境配置、数据准备、训练代码和模型测试,特别强调了数据质量的重要性。通过实验数据展示,Unsloth微调Qwen3-7B仅需48分钟,显存占用8GB,效果优于传统方法。文章还分享了智能客服、代码注释生成等应用案例,以及量化部署等进阶技巧,为开发者提供

m0_65555479的博客 2838

SAP-PLM传输MBOM传输至SAP

BOM 项目文本 (行 2)PLM创建及修改BOM接口。PLM 创建BOM接口抬头。BOM 项目文本(行1)PLM 创建BOM接口抬头。PLM BOM 错误消息。PLM BOM接口组件。组件数量 (BTCI)

qq_32198063的博客 432

Unsloth微调Qwen3实战:让大模型训练飞起来的神器

以前搞大模型微调真的是一件让人头疼的事情。动不动就要几十G的显存,训练个模型恨不得把电费账单给烧爆了。我记得有次用传统方法微调一个7B的模型,电脑风扇转得跟飞机起飞似的,吵得我邻居都来敲门了。

m0_59163425的博客 1343

【DRAM存储器五十六】LPDDR5介绍--WCK2CK Leveling和Read gate training

简述LPDDR5 WCK2CK leveling和read gate traning基本原理与操作步骤

highman110的博客 8791

自然语言处理之机器翻译:Transformer:Transformer在低资源语言翻译中的应用

Transformer模型是自然语言处理领域的一个重要突破,由Vaswani等人在2017年的论文《Attention is All You Need》中提出。它摒弃了传统的循环神经网络(RNN)和卷积神经网络(CNN)的序列依赖性,采用自注意力机制(Self-Attention)处理输入序列,极大地提高了训练效率和模型性能。

zhubeibei168的博客 1015

大模型训练加速!Unsloth微调Qwen3实战教程(神器)!

本文介绍了如何利用Unsloth高效微调Qwen3大模型。Unsloth通过内存优化、算子融合和LoRA特殊优化等技术,可将微调速度提升2-5倍,显存占用减少80%。作者分享了完整实战流程:从环境搭建、数据准备到模型训练和测试,重点强调了数据质量的重要性,并提供了性能对比数据(训练时间从2小时缩短至48分钟)。文章还总结了常见问题、进阶技巧和部署建议,指出Unsloth使大模型微调变得高效可行,适合在有限硬件资源下进行模型优化。

2301_80239908的博客 1652

【入门AUTOSAR网络管理测试】RSS-PBM状态转换

随着智能电动汽车行业的快速发展,目前AUTOSAR网络管理也得到了广泛应用,AUTOSAR网络管理测试也是汽车网络测试中非常重要的环节,NM问题导致的汽车ECU不能唤醒、电瓶亏电等问题,对于新入门AUTOSAR网络管理测试的同学不清楚如何开展测试,那么本章节就主要给大家介绍网络管理中RSS-PBM状态转换如何测试。【入门AUTOSAR网络管理测试】AUTOSAR网络管理规范需求解读。

测试领域技术分享 872

Unsloth微调Qwen3实战:让大模型训练飞起来的神器,大模型从入门到精通,收藏这篇就够了

Qwen3是个很不错的基础模型,配合Unsloth来做微调,确实能够在很多实际场景中发挥作用。关键是要找到适合自己业务场景的数据和配置,然后不断地迭代优化。

DEVELOPERAA的博客 754

用R来做一个临床研究亚组分析的森林图

在编程语言里R语言最强大的功能是做图功能,我们知道在做Meta分析的时候会需要做森林图,实际上我们在很多临床研究中也经常看到森林图,主要是亚组分析的森林图,比如下面这篇文章里的一个森林图: 今天就教教大家怎么用R语言来做上面这种亚组分析的森林图 1. 在Excel里编辑好数据,按照下面的格式整理,保存为csv格式 2. 下载安装R跟Rstudio R软件的下载地址: https://mirrors.tuna.tsinghua.edu.cn/CRAN/ Rstudio下

Mrrunsen的博客 5340

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

【AI大模型】Unsloth微调Qwen3实战:让大模型训练飞起来的神器,真的爽!!!

以前搞大模型微调真的是一件让人头疼的事情。动不动就要几十G的显存,训练个模型恨不得把电费账单给烧爆了。我记得有次用传统方法微调一个7B的模型,电脑风扇转得跟飞机起飞似的,吵得我邻居都来敲门了。 这时候Unsloth就像个救世主一样出现了。它号称能够把微调速度提升2-5倍,内存使用量还能减少80%。刚开始我是不太信的,这年头吹牛的项目太多了。直到我亲自试了一把,才发现这货是真的厉害。

Android23333的博客 897

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

LLM实战:LLM微调加速神器-Unsloth + Qwen1.5

1. 背景 上一篇介绍了基于训练加速框架Unsloth,微调训练Llama3的显卡资源占用及训练时间对比。 近期Unsloth新增了Qwen1.5的模型适配,因此本qiang~马不停蹄地又进行了一次实验对比。 对Unsloth的简介,感兴趣的客观可以查阅上一篇《LLM微调加速神器:Unsloth + LLama3》。 2. 实战 本着眼过千遍不如手过一遍的宗旨,本qiang~针对Unsloth做了一个对比实现。 对比的实验环境为: A800,模型为Qwen1.5-32B-Chat。 可以使用如下命令进行更新

LuckyTHP 1401

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

[大模型实战 06] 我的模型我做主:在 Kaggle 上用 Unsloth 极速微调 Qwen3

基础理论结束,咱们今天的重心是使用快速高效的微调库Unsloth在Kaggle的T4显卡上,用15分钟将Qwen3-4B模型微调成认主咱们的专属模型。

Add bricks to the edifice of the world as you envision it. 879

LLM实战:LLM微调加速神器-Unsloth + LLama3

本文主要是使用unsloth框架针对llama3的高效微调实验,提供了详细的对比代码以及不同维度的对比分析结果。

MENGERN的专栏 3141

大模型微调神器Unsloth框架详解:让普通GPU变身训练利器,效率提升5倍!

Unsloth是专为解决大模型微调与部署效率问题而设计的轻量级高效框架,通过内存优化、低精度训练和QLoRA等技术,让用户能在消费级GPU上完成原本需要昂贵算力的模型训练。文章详细介绍了其核心功能、分层架构设计、显著优势及实际应用示例,展示了在降低硬件门槛、提高训练速度方面的突出表现,是开发者值得关注的高效工具。

Gaga246的博客 1211

【实战】使用 Unsloth 高效微调 Qwen2.5-7B 全流程指南

【实战】使用 Unsloth 高效微调 Qwen2.5-7B 全流程指南

core815的专栏 1576

学废大模型蒸馏术:Qwen-3 微调轻松上手

Qwen-3 正在刷新性能基准!   Qwen3 一经发布便迅速成为开发者的首选,其在编程、数学和综合能力等核心评估中的基准测试的成绩斐然,该模型不仅超越 DeepSeek-R1、o1、o3-mini、Grok-3 和 Gemini-2.5-Pro 等主流模型,其混合专家模型 Qwen3-30B-A3B 更以仅 10% 的激活参数量胜过 Qwen-32B,甚至小如 Qwen3-4B 的版本也能媲美 Qwen2.5-72B-Instruct 的表现。  

2401_85343303的博客 2397

Unsloth + Qwen2.5 微调实战:高性能GPU适配优化教程

本文介绍了如何在星图GPU平台上自动化部署Unsloth镜像,以高效微调Qwen2.5等大语言模型。该平台简化了环境配置,用户可快速启动基于Unsloth框架的训练流程,显著降低显存占用并提升速度,典型应用于创建个性化的AI助手或专业领域的知识问答模型。

weixin_29050829的博客 913
上一篇: Obsidian + RAGFlow,打造最强本地知识库,大模型入门到精通,收藏这篇就足够了!
下一篇: GitHub 上 6 万人收藏!RAG 引擎让知识库活起来,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
