


paper: DeepSeek-R1
DeepSeek-R1的论文介绍中不仅描述了比较完整的技术实现路径,同时也提供了一些失败的实验尝试,这给其他厂商提供了完整的复现方式。先看一下大模型的效果。
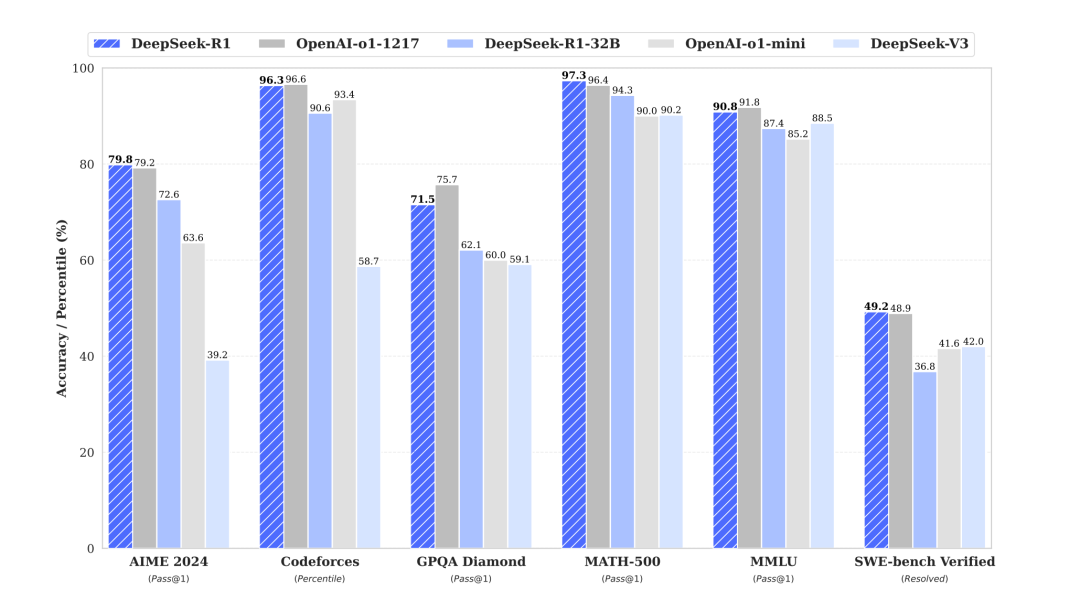
Benchmark performance of DeepSeek-R1
通过上图可以看到DeepSeek-R1大模型的实验结果几乎与OpenAi-o1-1217结果持平,在一些测试数据上(AIME 2024、MATH-500)评测结果甚至超过了后者。
1.训练目标
DeepSeek大模型通过从DeepSeek-v2和DeepSeek-v3的沉淀积累,到DeepSeek-R1这一代模型的训练技术路线是相对简洁的。我们先看一下他的文章中描述的训练DeepSeek-R1大模型的目标描述。
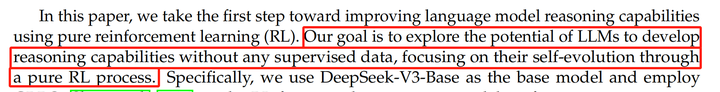
DeepSeek-R1:goal
目标是探索在没有任何监督数据的条件下,发掘大语言模型通过纯强化学习RL的训练,进行自我更新并涌现复杂推理能力的可能性。
2.训练方法
文章中描述的整体训练过程如下:
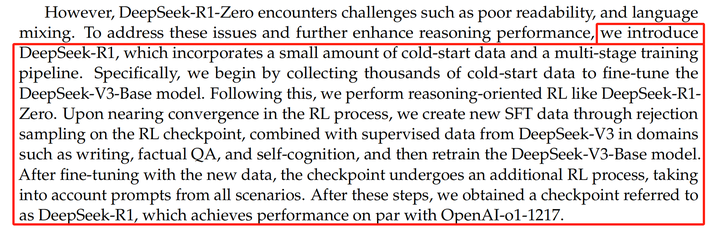
DeepSeek-R1:train method
针对没有进行冷启动,直接进行GRPO(Group Relative Policy Optimization,GRPO)强化学习训练获得DeepSeek-R1-Zero模型在推理过程中遇到的生成内容可读性差、语言混杂等问题,为了解决这些问题并提高推理性能,DeepSeek-R1大模型的整个训练过程总共包含如下几个步骤:
(1)先收集几千条高质量的冷启动数据集,使用该数据集微调DeepSeek-V3-Base模型,获得模型model_a。
(2)使用model_a使用强化学习算法GRPO进行强化学习训练,获得收敛模型model_B。
(3)使用收敛模型model_B产生高质量的SFT数据集,并与DeepSeek-V3-Base模型产生的其他领域的写作、事实问答、自我认知数据进行合并形成一份高质量的数据集。
(4)使用获得的最新的数据集训练原始的DeepSeek-V3-Base模型,获得模型model_C。
(5)使用model_C模型进行步骤2中的强化学习训练,这时数据考虑到所有场景的数据,收敛后的模型为model_D,文章中把这个模型命名为DeepSeek-R1。
3.实验贡献
(1)直接对DeepSeek-V3-Base模型进行GPRO训练,跳过SFT,也可以获得不错的效果。这一发现证明了LLM的推理能力可以通过纯强化学习激励,而无需SFT。
(2)两阶段的强化学习训练路径RL->采样SFT->RL->蒸馏SFT的过程对其他模型的训练具有启示作用。
(3)使用较大模型蒸馏的数据集用于训练小模型获得的效果比直接从零对小模型进行强化学习获得的效果要好。这一点的发现也说明数据集本身的好坏对模型的训练其决定性的作用,未来训练模型介意使用优质大模型蒸馏的数据集进行训练。
4.具体实现
4.1 强化学习算法
为了降低强化学习的训练成本,文章中采用了组相对策略优化(Group Relative Policy Optimization,GRPO)。该算法放弃了通常与策略模型(policy model)规模相同的评价模型(Critic model),而是使用组评分(group scores)进行估计基线。

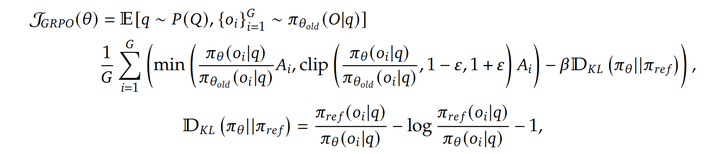
Algorithm:GRPO

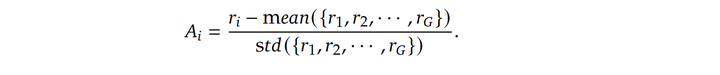
4.2 奖励模型
奖励是训练信号的来源,决定了强化学习的优化方向,为了训练DeepSeek-R1-Zero,文章中提到采用了基于规则的奖励系统,该系统主要包括两种奖励类型。
(1)准确性奖励(Accuracy rewards):准确性奖励模型用于评估模型的回答是否正确。比如对于具有确定性结果的数学问题中,模型需要以指定格式(例如,方框内)提供最终答案,以便通过基于规则的方法可靠地验证其正确性。对于LeetCode问题,可以使用编译器基于预定义的测试用例生成反馈。
(2)格式奖励(Format rewards):格式奖励是指将其推理过程放在和标签之间。
在开发DeepSeek-R1-Zero的过程中,没有采用基于神经网络的奖励模型,因为发现神经奖励模型在大规模强化学习过程中可能会受到欺骗的影响。而且,重新训练奖励模型需要额外的训练资源,并会使得整个训练流程变得更加复杂。
4.3 训练模板
为了训练DeepSeek-R1-Zero,设计了一个简单的模板,引导基础模型遵循指定的指令。模板如下表所示,该模版要求DeepSeek-R1-Zero先生成推理过程,然后提供最终答案。我们有意将约束限制在这种结构化格式上,避免任何内容相关的偏见,例如强制反思性推理或强调特定的解题策略,以确保我们能够准确观察模型在强化学习过程中的自然演进。
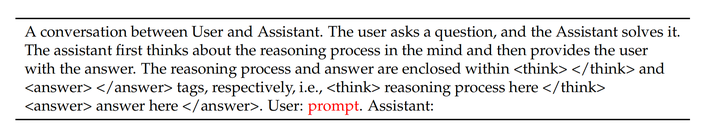
Table1:Template
4.4 DeepSeek-R1-Zero的性能、自我进化过程与Aha Moment
(1) DeepSeek-R1-Zero的性能
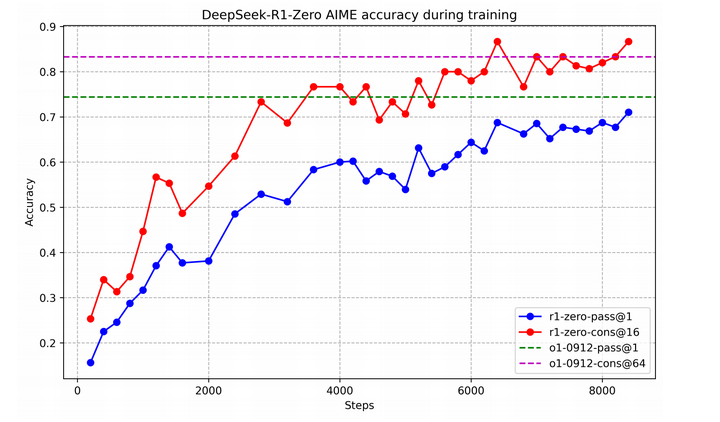
AIME accuracy:DeepSeek-R1-Zero
上图展示了DeepSeek-R1-Zero在RL训练过程中,在AIME2024基准测试上的性能变化,可以看到随着强化学习的推进,DeepSeek-R1-Zero模型的性能稳步上升,值得注意的是,其在 AIME 2024 基准测试上的平均 pass@1 得分从最初的 15.6% 显著提高至 71.0%,达到了与 OpenAI-o1-0912 相当的水平。这一重大改进凸显了RL算法在优化模型性能方面的有效性。
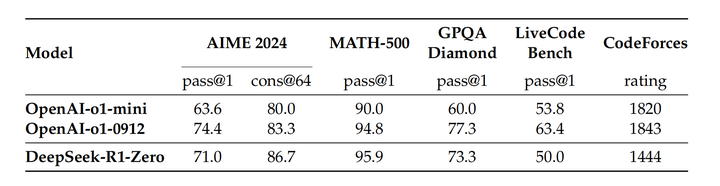
Table2:Comparison:DeepSeek-R1-Zero and OpenAI o1
表2对比了DeepSeek-R1-Zero与OpenAI 的o1-0912模型在多个推理基准测试上的表现。
- 实验结果表明,强化学习使 DeepSeek-R1-Zero 能够在不依赖任何监督微调数据的情况下获得强大的推理能力。
- DeepSeek-R1-Zero的性能可以通过 多数投票 (majority voting) 进一步提升。例如,在 AIME 基准测试上,使用多数投票后,DeepSeek-R1-Zero的性能从 71.0% 上升至 86.7%,超越了 OpenAI-o1-0912。
- DeepSeek-R1-Zero在有无多数投票的情况下均能达到如此具有竞争力的性能,这不仅凸显了其强大的基础能力,也展现了其在推理任务上的进一步发展潜力。
(2) DeepSeek-R1-Zero的自我进化过程
DeepSeek-R1-Zero的自我进化过程生动展现了强化学习 (RL) 如何推动模型自主提升推理能力。通过直接从基础模型开始强化学习,我们能够在不受监督微调阶段影响的情况下,密切观察模型的演变过程。这种方法清晰地展示了模型随时间的发展,特别是在处理复杂推理任务方面的能力提升。
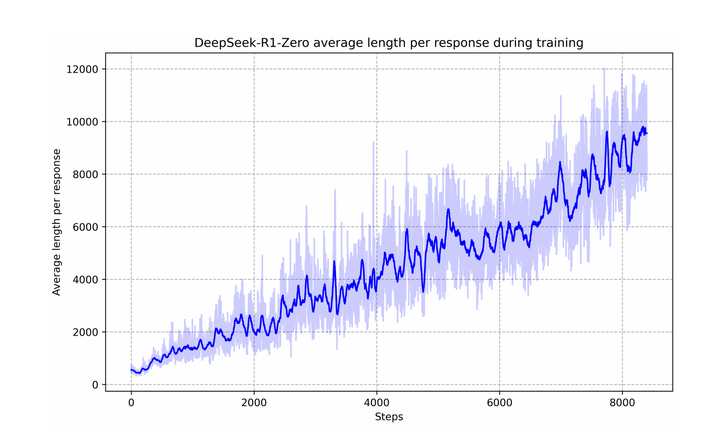
The average response length of DeepSeek-R1-Zero on the training
如上图所示,DeepSeek-R1-Zero 的思考时间在训练过程中持续优化。这一改进并非外部调整的结果,而是模型内部自我发展的体现。DeepSeek-R1-Zero 通过扩展测试时计算 (test-time computation) 自然习得了解决日益复杂推理任务的能力。这种计算扩展涉及生成数百到数千个推理token,使模型能够更深入地探索和完善其思维过程。
这种自我进化最引人注目的特点之一是,随着测试时计算能力的提升,模型自主涌现出复杂行为。例如,反思 (reflection)–模型会回顾并重新评估其先前的推理步骤,以及探索不同的解题方法。这些行为并非人为显式编程的结果,而是模型与强化学习环境交互过程中自然形成的。这样的自发发展显著增强了DeepSeek-R1-Zero的推理能力,使其能够更高效、更精准地解决更具挑战性的任务。
(3) DeepSeek-R1-Zero的"Aha moment"
在训练DeepSeek-R1-Zero的过程中,我们观察到一个特别有趣的现象,即“aha moment”(顿悟时刻)。如表3所示,这一时刻出现在模型的某个中间版本。在这个阶段,DeepSeek-R1-Zero 学会通过重新评估其最初的解题思路,为问题分配更多的思考时间。这一行为不仅证明了模型推理能力的提升,同时也是强化学习能够产生意想不到且高度复杂结果的一个引人注目的案例。
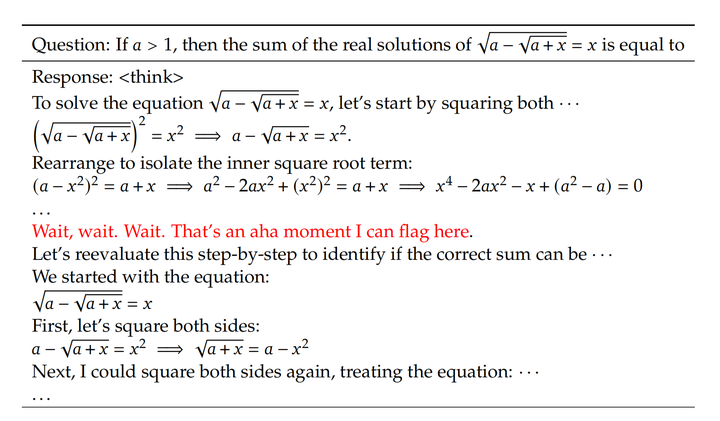
Table3:aha moment of DeepSeek-R1-Zero
这一时刻不仅是模型的"aha moment",也是研究人员的"aha moment"。它凸显了强化学习的强大与美妙之处:我们并未直接教授模型如何解题,而只是提供了合适的激励,模型便能自主发展出先进的解题策略。“aha moment” 强有力地证明了强化学习在开发更自主、更具适应性的人工智能系统方面的潜力,为未来智能模型的发展铺平了道路。
(4) DeepSeek-R1-Zero的局限性
尽管DeepSeek-R1-Zero展现出了强大的推理能力,并自主涌现出许多意想不到且强大的推理行为,但仍然存在一些问题。例如,它在可读性和语言混杂方面存在挑战。为了提高推理过程的可读性,并使其更易于分享给开放社区,我们探索了 DeepSeek-R1,这是一种结合了强化学习 (RL) 和人类友好的冷启动 (Cold Start) 数据的方法。
4.5 DeepSeek-R1:结合冷启动的强化学习
(1)冷启动(Cold Start)
与DeepSeek-R1-Zero训练方法不同,为了避免 RL训练初期的不稳定性,DeepSeek-R1在训练初期引入了一小部分长思维链 (Long CoT) 数据,对模型进行微调,使其成为初始的RL Actor。我们探索了多种数据收集方法,包括:
- 使用少样本 (few-shot) 提示,以长思维链作为示例,引导模型生成详细推理过程。
- 直接提示模型生成包含反思 (reflection) 和验证 (verification) 的完整回答。
- 提取DeepSeek-R1-Zero的推理结果,并以可读格式进行重构。
- 人工后处理 (post-processing),对模型输出进行优化,使其更加清晰易读。
最终,我们收集了数千条冷启动数据,并用这些数据微调DeepSeek-V3-Base作为强化学习RL训练的起点。相比 DeepSeek-R1-Zero,冷启动数据的主要优势是:
- 可读性(Readability):针对DeepSeek-R1-Zero模型的回答存在可读性差。在DeepSeek-R1的冷启动数据中,特别设计了可读性模式(readable pattern),在每个回答的末尾添加摘要,并筛选出不适合阅读的回答。其输出格式如下:|special_token|<reasoning_process>|special_token|。其中<reasoning_process>代表用于query的思维链,用于总结推理结果。
- 潜力(Potential):通过精心设计带有人类模式先验知识的冷启动数据,通过实验观察到DeepSeek-R1相比DeepSeek-R1-Zero有更好的性能,我们相信这种迭代训练方式更加适合推理模型的优化。
(2)面向推理的强化学习
在对DeepSeek-V3-Base在冷启动数据上进行微调后,我们应用了与DeepSeek-R1-Zero中使用的相同大规模强化学习训练过程。这个过程的主要是专注提高模型的推理能力,特别是在代码、数学、科学和逻辑推理任务中,这些任务问题定义清晰,且具有明确的解决方案。
在训练的过程中,观察到思维链经常会出现语言混杂的现象,特别是当涉及到多种语言的RL提示时。为了解决该问题,在进行RL训练期间引入了语言一致性奖励,计算方式是衡量推理过程中目标语言单词的占比。尽管消融实验表明,这种对齐会导致模型的性能略有下降,但这种奖励与人类的偏好一致,使其具有可读性。
最终通过推理任务的准确性奖励与语言一致性奖励相加,形成最终的奖励函数,并在微调后的模型上使用RL训练,直到推理任务收敛。
(3)拒绝采样和SFT
当面向推理的强化学习模型收敛时,我们使用得到的模型进行生成SFT数据集,用于下一轮的模型训练。与最初的冷启动数据不同,这个阶段收集的数据集包含其他领域的数据,用于增强模型在写作、角色扮演和其他通用任务方面的能力。
- 推理数据:从通过RL训练的检查点采样推理任务数据,并进行拒绝采样,确保仅保留高质量的推理结果;在上一阶段仅包括基于规则奖励进行评估的数据。而在这一阶段,我们对数据集进行了扩展,使用生成式奖励模型,把真实值和模型预测输入DeepSeek-V3进行判断;过滤掉哪些不好阅读、混合语言的思维链、长段落和代码块;对于每个prompt采样了多个响应,并保留了正确的响应,总共收集了约60万条与推理相关的数据。
- 非推理数据:对于像写作、事实问答、自我认知和翻译这些非推理数据,采用DeepSeek-V3流程,并复用了部分DeepSeek-V3的SFT数据集;对于非推理任务,通过提示调用DeepSeek-V3生成一个潜在的思维链,然后再通过提示进行回答;最终共收集了大约20万条与推理无关的训练样本。
- 训练数据:使用上述精心挑选的大约80万条样本的数据集,对DeepSeek-V3-Base模型进行了两个周期的微调。
(4)适用于所有场景的强化学习
为了进一步使得模型与人类偏好保持一致,文章中实施了一个次要的强化学习阶段,旨在提高模型的有用性和无害性,同时精细化其推理能力。
具体的,结合了奖励信号和多样化的提示分布对模型进行训;对于推理数据遵循了DeepSeek-R1-Zero中的方法,在数学、代码和逻辑推理领域采用基于规则的奖励机制来引导学习过程。对于一般数据,采用奖励模型来捕捉人类在复杂和微妙场景中的偏好。对于有用性,专注于最终摘要,确保评估过程强调响应对用户的实用性和相关性,同时尽量减少对底层推理过程的干扰。对于无害性,评估模型的整个响应,包括推理过程和摘要,以识别并减少可能在生成过程中出现的风险、偏见或有害内容。最终,奖励信号与多样化数据分布的结合使我们能够训练出既擅长推理又优先考虑有用性和无害性的模型。
4.6 Distillation:赋予小模型的推理能力
为了使更高效的小型模型具备类似DeepSeek-R1的推理能力,使用基于DeepSeek-R1精选的80万条数据,直接对开源模型(如Qwen和Llama)进行微调。实验结果表明,这种简单的蒸馏方法显著增强了小型模型的推理能力。
在基础模型的选择上,我们使用了Qwen2.5-Math-1.5B、Qwen2.5-Math-7B、Qwen2.5-14B、Qwen2.5-32B、Llama-3.1-8B 和 Llama-3.3-70B-Instruct。之所以选择 Llama-3.3,是因为它的推理能力略优于Llama-3.1。
对于蒸馏后的模型,仅应用 SFT策略,而未包含强化学习(RL)阶段,尽管加入RL可能会大幅提升模型性能。在此的主要目标是展示蒸馏技术的有效性。
5.实验
对于实验结果的评估默认使用pass@k的评估方法,采用temperature是0.6和0.95的top-p值,以生成k个响应(通常在4到64之间)进行回答每个问题。pass@1的计算公式如下:
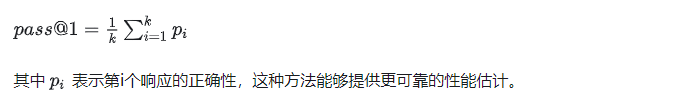
5.1 DeepSeek-R1评估
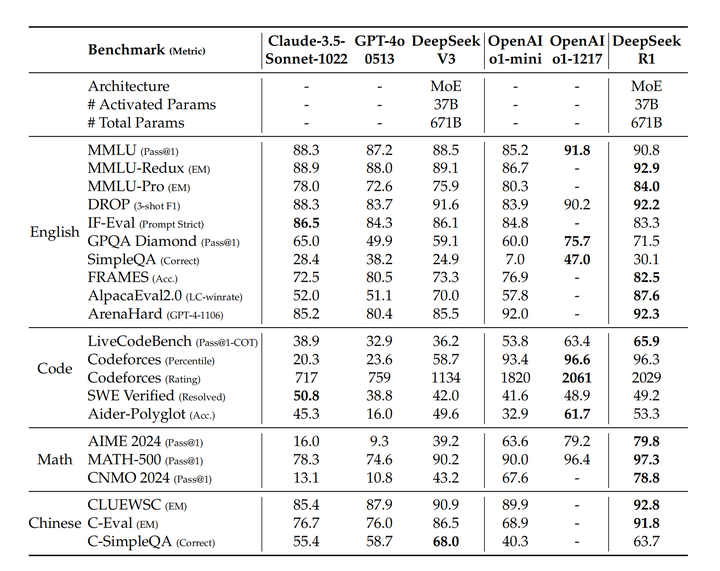
Table4:DeepSeek-R1 vs other representative models
从表4结果可知,对于面向教育的知识基准(如 MMLU、MMLU-Pro 和 GPQA Diamond),DeepSeek-R1展现出优于DeepSeek-V3的性能。
在事实性基准测试SimpleQA上,DeepSeek-R1超越了DeepSeek-V3,证明了其在处理基于事实的 query 方面的能力。然而,在中文C-SimpleQA基准上,DeepSeek-R1的表现不如 DeepSeek-V3,主要原因在于安全性强化学习(Safety RL) 使其在某些 query 上更倾向于拒答。如果不进行安全性 RL,DeepSeek-R1 的准确率可超过70%。
在数学任务上,DeepSeek-R1的表现与OpenAI-o1-1217相当,并大幅领先于其他模型。类似的趋势也出现在编码算法任务(如 LiveCodeBench和 Codeforces)上,推理驱动的模型在这些基准中占据主导地位。在工程相关的编程任务中,OpenAI-o1-1217 在 Aider上优于DeepSeek-R1,但在 SWE Verified 上两者表现相当。我们认为,DeepSeek-R1的工程领域表现将在下个版本中进一步提升,因为当前相关的强化学习训练数据仍然有限。
5.2 蒸馏模型评估 Table5:DeepSeek-R1 distilled models vs other models on reasoning-related benchmarks
从表5结果可知,简单地蒸馏DeepSeek-R1的输出使得高效的DeepSeek-R1-7B(即 DeepSeek-R1-Distill-Qwen-7B,下面同样简写)在各项评估中超越了非推理模型如 GPT-4o-0513。DeepSeek-R1-14B 在所有评估指标上都超过了 QwQ-32BPreview,而 DeepSeek-R1-32B 和 DeepSeek-R1-70B 在大多数基准测试中显著超越了 o1-mini。这些结果展示了蒸馏的强大潜力。此外,如果将强化学习应用于这些蒸馏模型可以带来显著的进一步提升。这一点值得进一步探索,这里只呈现了简单 SFT 蒸馏模型的结果。
6.讨论
Distillation vs Reinforcement Learning
通过蒸馏DeepSeek-R1实验,较小的模型能够取得令人印象深刻的结果。然而,仍然有一个问题:模型是否可以不进行蒸馏,而通过大规模强化学习训练达到可比的性能?
为了回答这个问题,基于Qwen-32B-Base模型进行了大规模强化学习训练,使用数学、代码和STEM数据,训练超过10K步,最终得到了DeepSeek-R1-Zero-Qwen-32B。实验结果如表6 所示,表明经过大规模强化学习训练后的32B基础模型在性能上与QwQ-32B-Preview相当。然而,从DeepSeek-R1蒸馏得到的DeepSeek-R1-Distill-Qwen-32B,在所有基准测试中表现明显优于 DeepSeek-R1-Zero-Qwen-32B。
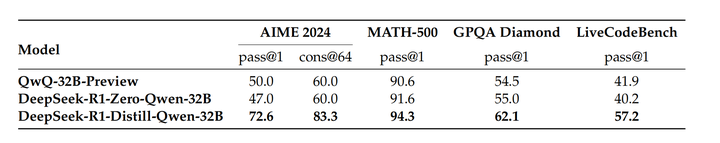
Table 6:Comparison distilled and RL models
因此可以获得如下结论:
(1)将更大强的模型蒸馏为较小的模型可以获得极佳的结果,而依赖于本文提到的大规模强化学习的较小模型需要巨大的计算能力,甚至无法达到蒸馏策略的性能。
(2)尽管蒸馏策略既经济又有效,但要超越智能的界限可能仍需要更强大的基础模型和更大规模的强化学习。
7.结果
文章内容分享了通过强化学习增强模型推理能力的过程。DeepSeek-R1-Zero代表了一种纯的强化学习方法,不依赖冷启动数据,在各类任务上表现出色,但生成结果也会出现不可读,语言混杂等问题。
DeepSeek-R1模型推理能力更强大,该模型的训练结合了冷启动数据和多阶段的强化学习微调。最终DeepSeek-R1在多个任务上达到了与OpenAi-o1-1217相当的效果。
探索了将推理能力蒸馏到小型稠密模型中,使用DeepSeek-R1作为教师模型,生成了80万个训练样本,并微调了多个小型稠密模型。结果是有希望的:DeepSeek-R1-Distill-Qwen-1.5B在数学基准测试中表现超越GPT-4o和Claude-3.5-Sonnet,在 AIME上达到了28.9%,在MATH上达到了83.9%。其他稠密模型也取得了显著成果,远远超过了基于相同基础检查点的其他指令调优模型。
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、大模型经典书籍(免费分享)
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取
 3440


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


