LLaMA-Factory 一键微调大模型

Ollama 可以在 Windows 上运行了 阅读详情

LLaMA-Factory 是南京大学人工智能创新研究院开源的轻量级大语言模型(LLM)微调工具包。它的设计目标很明确:让普通开发者也能低成本地玩转大模型。在消费级显卡上即可完成训练,不再需要动辄数十万的集群算力。兼容 100+ 开源大模型:LLaMA、Mistral、Baichuan、Qwen、ChatGLM 等主流模型均已覆盖。

核心特点:

  1. 一站式微调框架

  2. 支持多种微调方法

  3. 全参数微调(Full Fine-tuning)

  4. LoRA / QLoRA(低资源高效微调)

  5. P-Tuning(提示词优化)

  6. Delta Weights(模型权重复用)

申请 GPU 云算力

在算多多可免费使用 3060 (30+ 小时),
访问地址:gpuduoduo.com
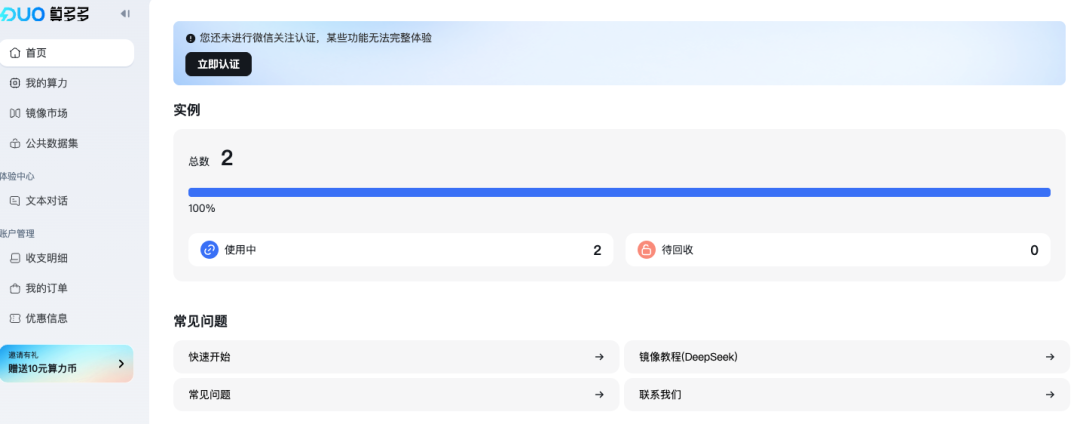
申请免费算力

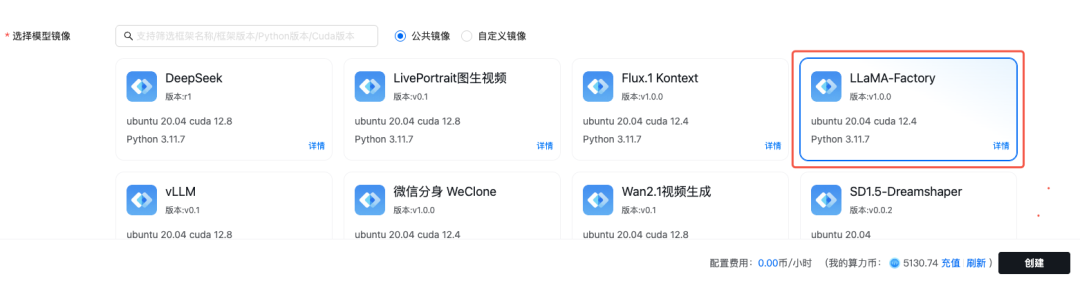
使用 LLaMA-Factory 镜像申请实例
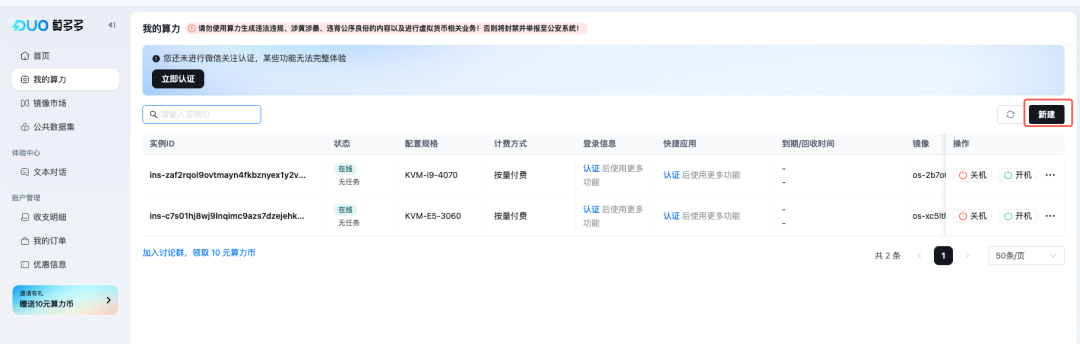
等待 1-3 分钟可完成实例的创建。

开始微调

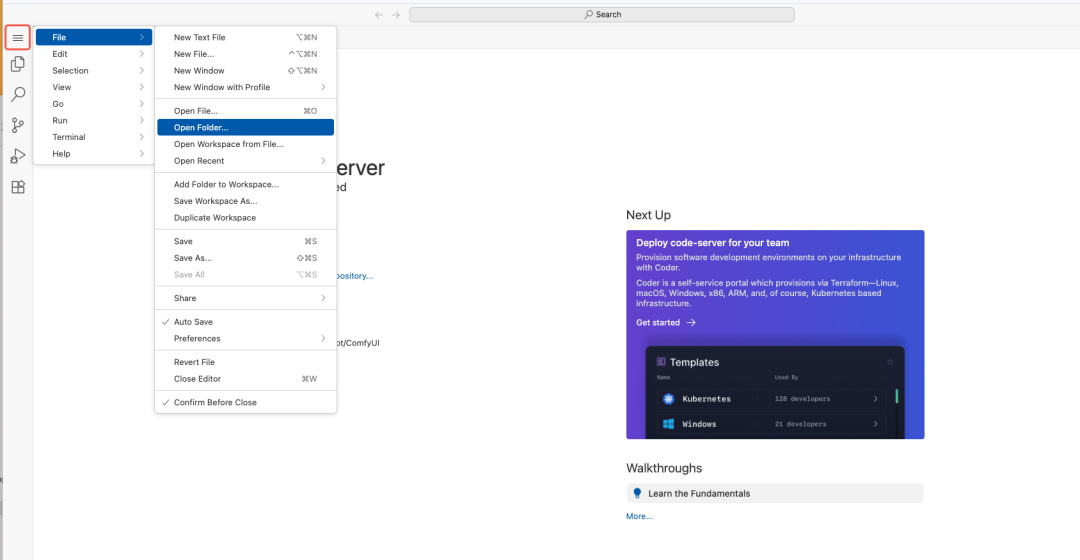
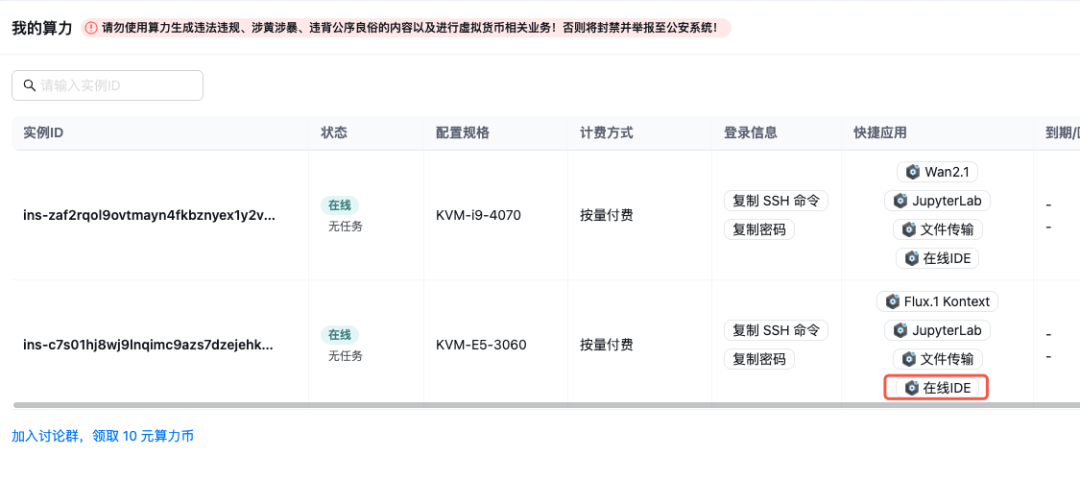
    1. 实例创建成功后(状态正常,功能可点击),点击"在线 IDE",打开在线 VSCode 进行编码
    1. 打开工程目录
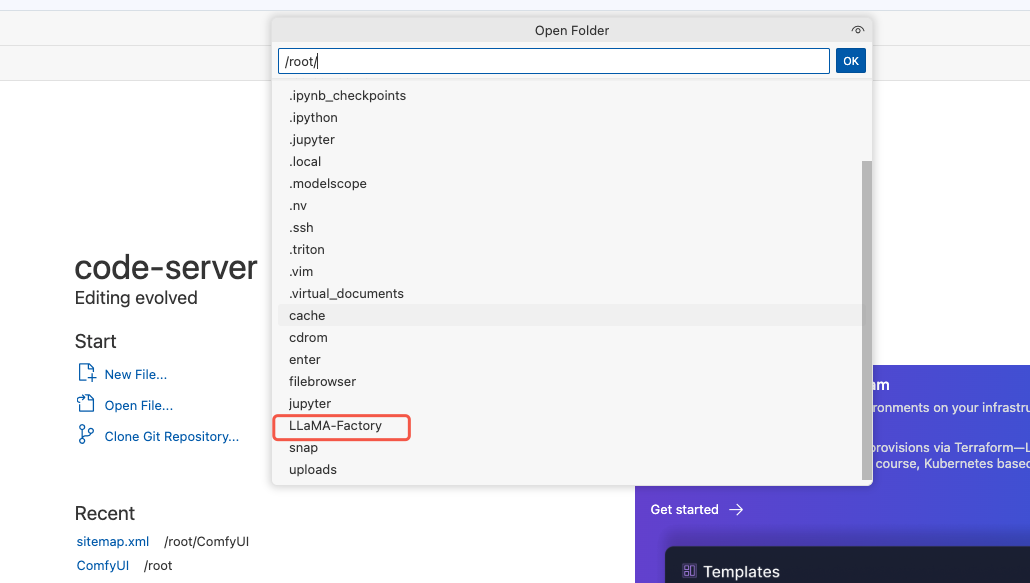
      进入llama-factory 所在的目录

点击 OK

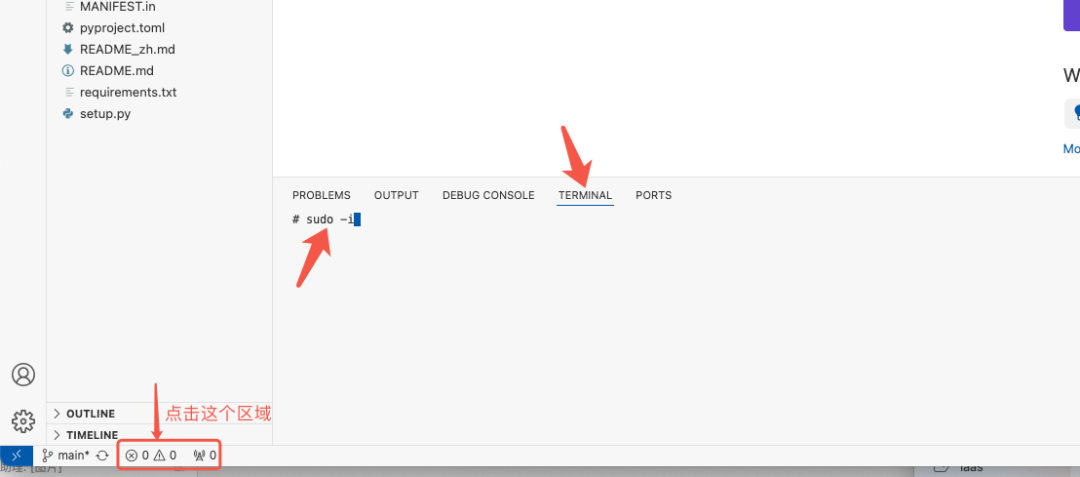
进入终端

根据图示打开终端:

在终端中执行命令提升权限

sudo -i
进入 conda 虚拟环境
cd /root/LLaMA-Factory
conda activate llama_factory
启动服务

使用 llamafactory-cli 命令启动带有 web 页面服务的 llamafactory

llamafactory-cli webui

启动成功后,可以看到控制台打印类似的日志:

* Running on local URL:  http://0.0.0.0:7860
* To create a public link, set `share=True` in `launch()`.
打开微调页面

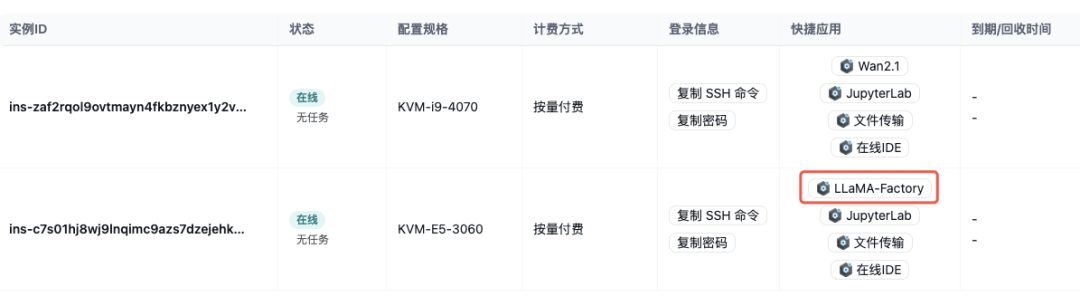
回到算多多,点击“LLaMA-Factory”打开微调页面
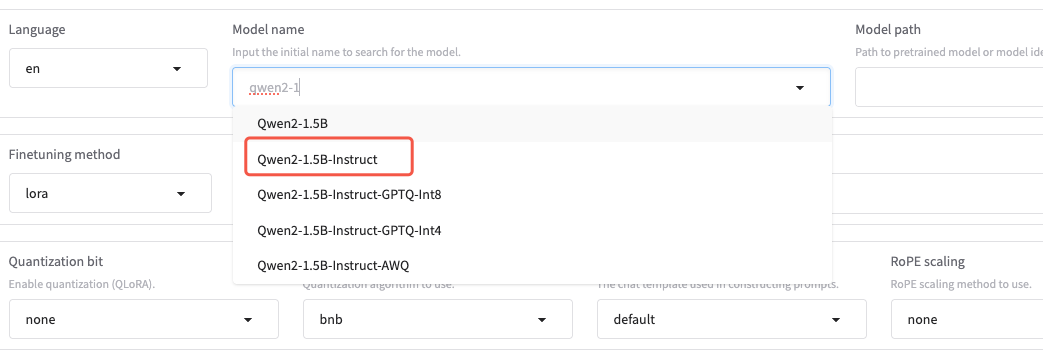
微调的基础模型

实例已预置了Qwen2-1.5B模型,如果模型没有下载,会自动从互联网上下载(默认已调整为 modelscope 源,更加适合国内的网络环境)

其他配置也可以自行修改,如果有需要,可以参考官方教程修改。
选一个你想要使用的数据集

测试阶段可以选第一个,数据量比较小,速度比较快
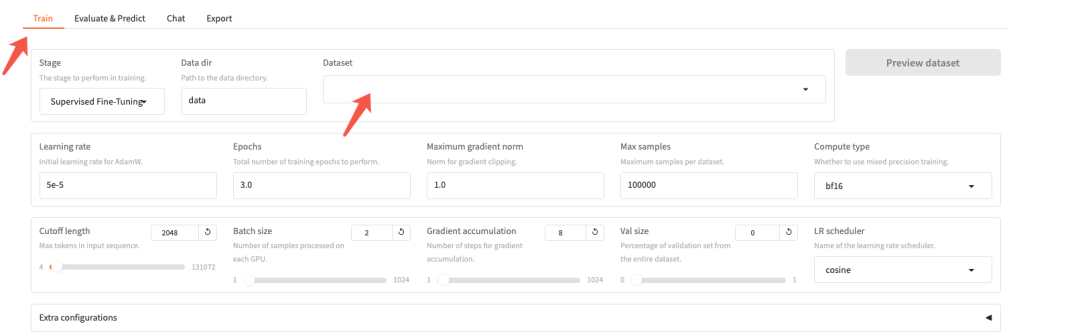
注意:在 /LLaMA-Factory/data/dataset_info.json 可以增加自定义的数据

执行微调

把 web 页面滑到下方,有一个"Start"按钮,点击可以执行微调工作
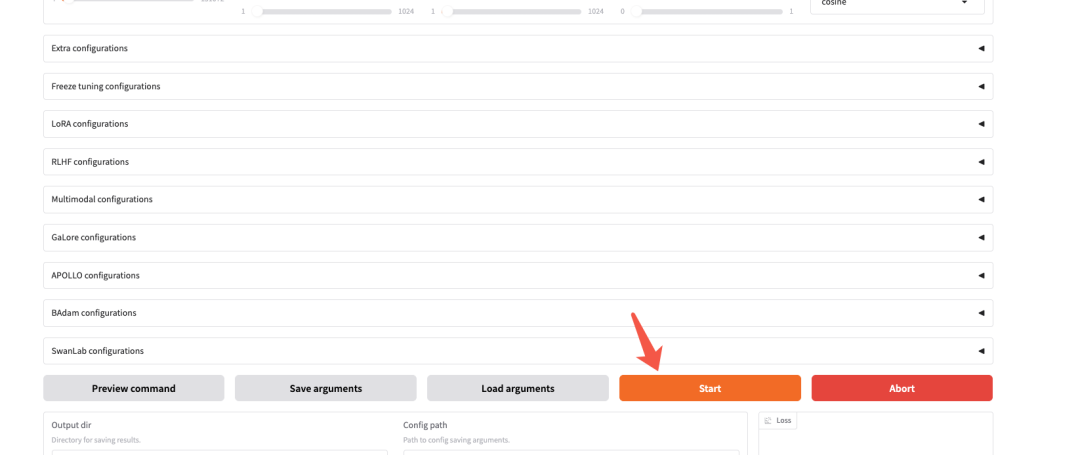
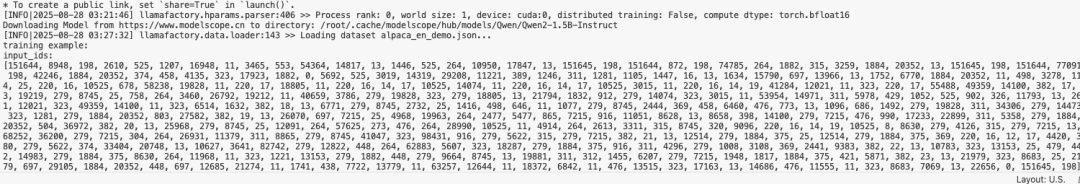
点击后,可以从在线 IDE 终端查看当前的进展情况。
现在正在下载模型:

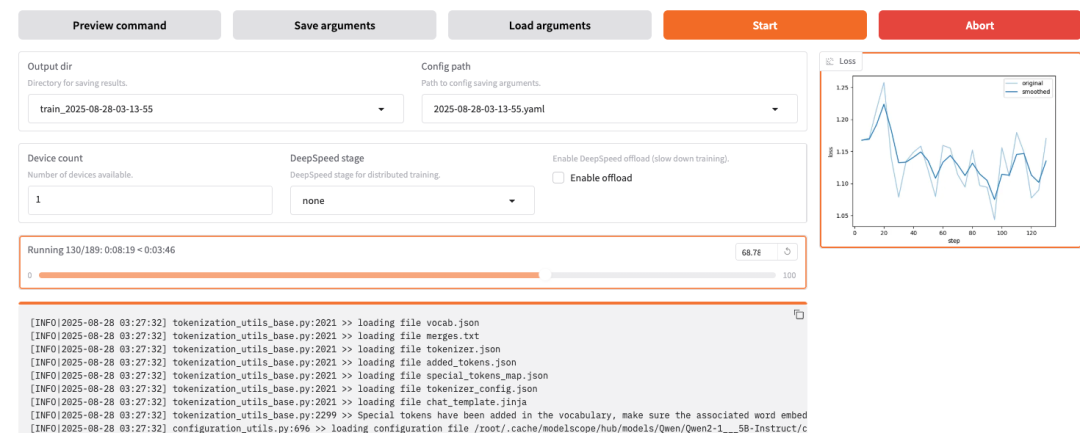
开始微调了
在 web 页面上也能看到进度和日志
微调完成
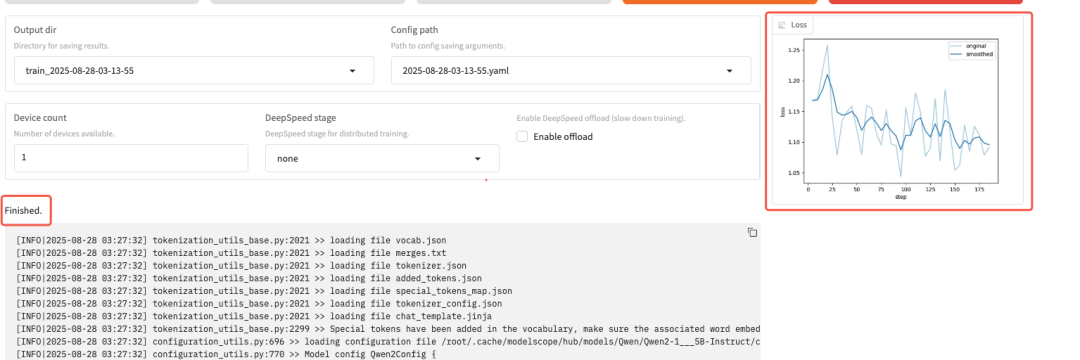
模型保存在 /opt/LLaMA-Factory/saves/

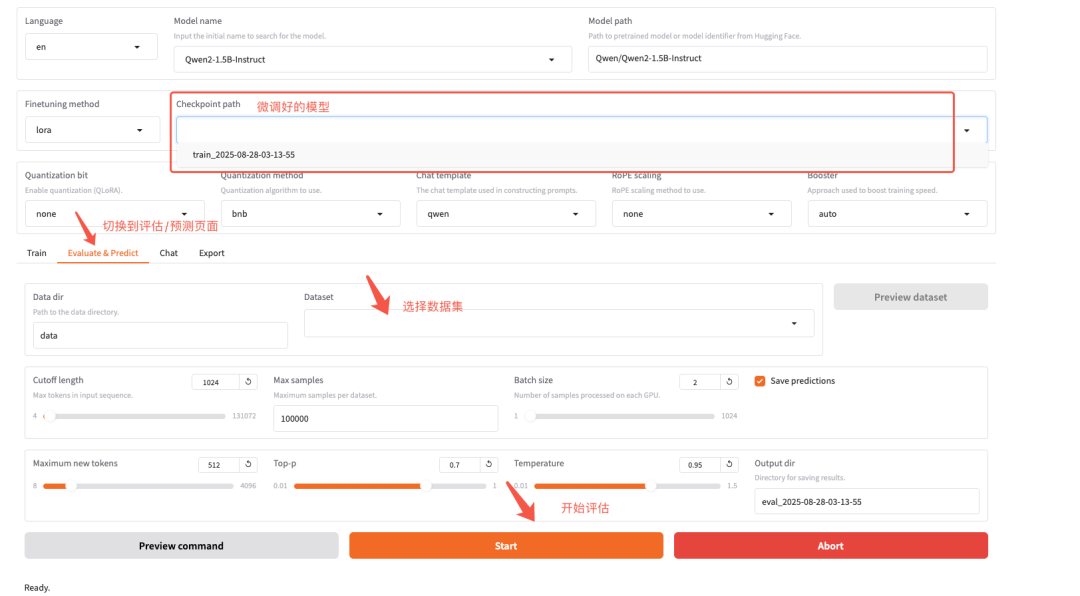
评估微调的模型

主要步骤如下:

    1. 选择评估模型(即刚刚微调后保存的)
    1. 切换到对应预测界面
    1. 选择评估数据集
    1. 开始评估

具体可参考下图进行操作:

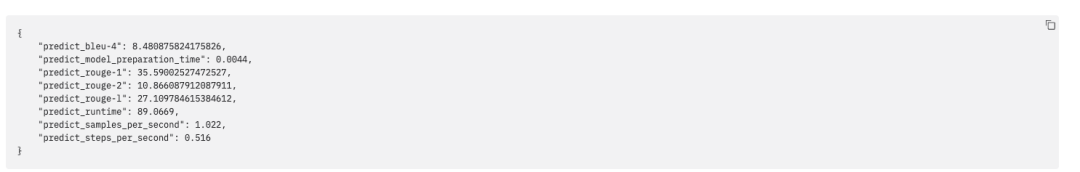
可以看到评估完成了:

如何分析评估结果?

在自然语言处理(NLP)里,模型效果通常需要客观指标来衡量。以下是几种常见的指标:

BLEU-4:常用于机器翻译。基于 n-gram 精确匹配,取 4-gram。值越高,说明翻译结果和参考译文越接近。
ROUGE-1:常用于自动摘要。计算 unigram(单词级别)匹配率。
ROUGE-2:同样用于摘要,基于 bigram(二元词组)匹配率,比 ROUGE-1 更严格。
ROUGE-L:基于 最长公共子序列(Longest Common Subsequence, LCS),能反映整体句子结构的相似度。

一句话总结:
BLEU 看翻译,越高越好;
ROUGE 看摘要,数值越高,说明模型提炼信息的能力越强。

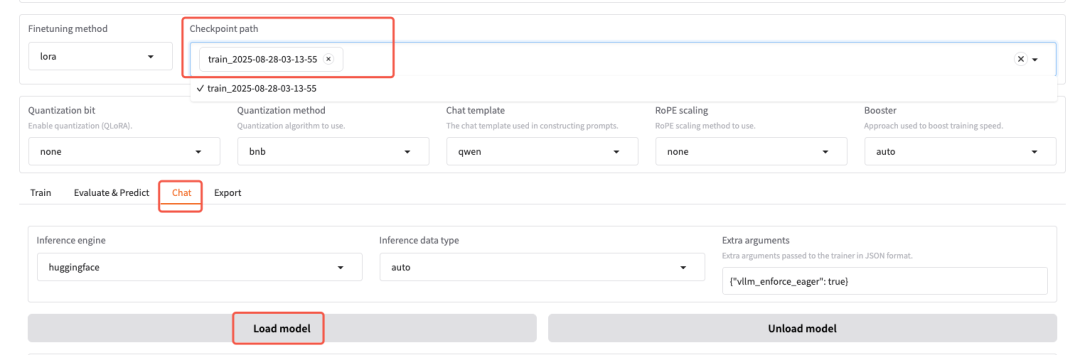
使用微调好的模型进行推理对话

主要步骤如下:

    1. 选择微调模型
    1. 切换到 Chat 对话界面
    1. 点击 “Load Model” 加载模型

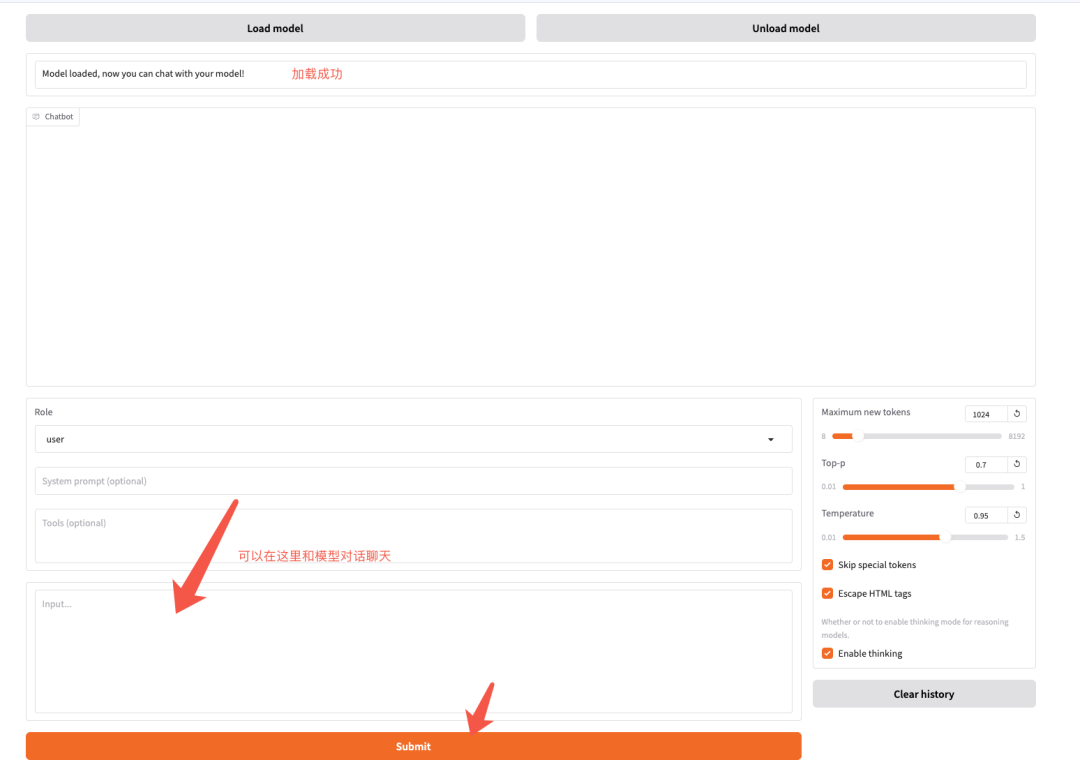
加载成功了,开始对话吧

:

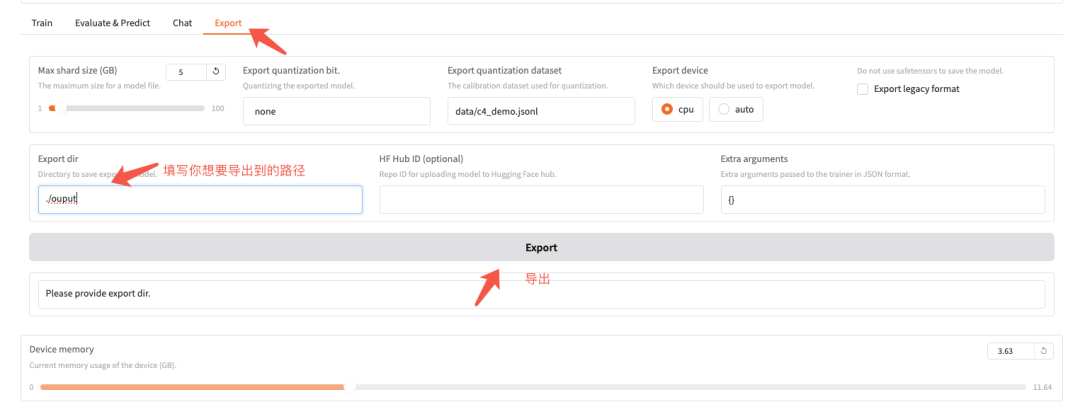
导出

主要步骤如下:

    1. 切换到 Export 页面
    1. 填写你想要导出到哪个路径,比如 ./ouput
    1. 点击 “Export” 按钮,导出后的模型保存在工程的 saves 目录 ./ouput 下

导出成功后,会在导出文件夹中看到 model.safetensors 等模型文件。

接下来可以使用 vllm 或 ollama 或其他工具进行实际的推理应用了,具体的使用教程后面有需要再进行详细介绍。

llam-factory 使用总结

可以看到,从算多多进行一次 llama-factory 的微调、推理、测试工作是非常简单的,没有太多背景的同学也能在 30 分钟左右完成工作,我们在熟悉之后也可以参考更多官方教程,进行其他功能的体验

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

Ollama入门教程:从安装到运行的完整指南 随着人工智能(AI)技术的快速发展,大型语言模型(LLMs)逐渐成为了各行各业的重要工具。然而,使用这些强大模型的同时,数据隐私、处理效率和部署复杂度等问题也逐渐浮现。为了解决这些问题,Ollama 提供了一种创新的解决方案——通过本地化部署大型语言模型,不仅能够增强数据隐私性,还能提高模型的运行效率。本文将详细介绍如何下载和安装 Ollama,如何选择和运行不同的语言模型,以及 Ollama 的特点、适用场景、优缺点等内容,帮助大家深入了解这一平台。ollama官网🚪 ollama官方文档🚪 根据自己 阅读详情

相关推荐

Ollama:一个在本地部署、运行大型语言模型的工具

所谓自定义模型就是不适用Ollama官方模型库中的模型,理论可以使用其他各类经过转换处理的模型Ollama库中的模型可以通过提示进行自定义。python复制代码FROM llama3 # 设置温度参数 PARAMETER temperature 1 # 设置SYSTEM 消息 SYSTEM """作为AI智能助手,你将竭尽所能为员工提供严谨和有帮助的答复。"""Modelfile文档One-API是一个OpenAI接口管理 & 分发系统,支持各类大模型。这里使用Docker快速进行部署。拉取镜像。

2401_84495725的博客 6721

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

大模型微调指南之 LLaMA-Factory 篇:一键启动LLaMA系列模型高效微调

LLaMA-Factory 是一个功能强大的工具,支持模型的训练、微调、评估、推理和导出。它提供了全参数微调、LoRA 微调、QLoRA 微调等多种微调方法,并支持通过可视化界面或命令行进行操作。安装过程包括创建虚拟环境、下载仓库和安装依赖。使用 WebUI 可以方便地进行模型训练、评估、对话和导出,而命令行则提供了更灵活的配置选项,支持模型微调、合并、推理和评估。LLaMA-Factory 还支持自定义数据集和断点重连功能,适用于多种模型训练和微调场景。

冷不丁 5279

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

LLaMA-Factory与Ollama:可视化微调与一键部署大模型的工程实践

大语言模型(LLM)微调是让通用模型适配特定领域知识的关键技术,其核心原理是通过在特定数据集上继续训练,调整模型参数以学习新的任务或领域分布。这项技术的价值在于能显著提升模型在垂直场景下的准确性和实用性,是实现私有化、定制化AI助手的基础。在工程实践中,微调常面临环境配置复杂、训练流程繁琐和模型部署困难等挑战。针对这些痛点,结合可视化微调工具LLaMA-Factory与轻量级模型服务框架Ollama,可以构建一套从数据准备到服务上线的完整解决方案。LLaMA-Factory通过Web界面封装了数据准备、参数

weixin_34006468的博客 308

计算机网络-自顶向下方法 第三章课后习题答案(第七版)

复习题 R1. a) 就叫这个协议为简单传输协议STP(Simple Transport Protocol)。在发送方,STP从发送进程接收不超过1196字节的数据块、目标主机地址和目标端口号。STP向每个块添加一个4字节的头,并将目标进程的端口号放在头中。STP然后将目标主机地址和结果段提供给网络层。网络层将段交付给目的地主机的STP。目的主机基于STP检查段中的端口号,从段中提取数据,并将数据传递给由端口号标识的进程。 b) 在发送方,STP从发送进程接收不超过1192字节的数据块、目标主机地址和目标端

Erekilu的博客 2万+

大模型微调新姿势:用Llama Factory一键搞定LlaMA 3定制

通过Llama Factory,我们实现了LlaMA 3模型的快速微调实验,大大缩短了从想法到验证的周期。需要快速验证不同微调方法的团队资源有限但希望尝试大模型的研究者想要专注于业务逻辑而非工程细节的开发者混合使用多种微调方法(如先预训练再LoRA)探索更大的LlaMA 3模型(如70B版本)将微调模型部署为在线服务现在,你已经掌握了使用Llama Factory进行LlaMA 3定制的基本方法,不妨立即动手试试,看看能调教出什么样的个性化大模型吧!

BloodstoneHawk77的博客 951

倍加福(P+F)R2000修改雷达IP

在调试车子的时候,用到了倍加福R2000的一款雷达,设备启动建图时发现建不了图,于是查看/scan发现话题无数据,尝试ping雷达接口发现ping不通,应该是IP地址与上位机端口的IP地址不对。首先查看雷达的IP地址,这个在雷达上有两个按键,按下后可以显示IP: 按两下右边的键再按一下左边的键雷达上会显示出IP号,这里拍的不是很清楚。查看到开始时雷达IP地址为192.168.111.10,而上位机ping的IP地址为192.168.188.50.与实际不同,所以需要对雷达进行配置。一台windows笔记本

YiYeZhiNian的博客 5890

Llama-Factory镜像发布:一键微调百种大模型,GPU算力需求全解析

Llama-Factory通过容器化镜像集成百余种大模型与LoRA/QLoRA高效微调技术,支持低显存训练,提供可视化界面与自动化流程,显著降低大模型微调门槛,适配消费级GPU,实现开箱即用的分布式训练体验。

weixin_42504649的博客 647

汽水音乐自动化薅羊毛教程:从零搭建稳定赚钱脚本

📖 前言:为什么要学习自动化脚本?在数字时代,时间就是金钱。汽水音乐等App通过观看广告奖励用户金币的模式,本质上是将我们的时间转化为收益。本教程将教你如何用Python自动化这个过程,让程序为你"打工",实现被动收入。通过本教程,你将学到:移动端自动化测试的核心技术Python在自动化领域的实际应用如何将重复性任务转化为自动化流程创造属于自己的"数字员工"第一章:环境准备与基础配置1.1 硬件要求Android手机一部(建议使用备用机)USB数据线。

weixin_44947827的博客 5788

用Python玩转Milvus:从安装SDK到完成第一个向量搜索Demo

本文为Python开发者提供了一份详细的Milvus向量数据库实战指南。文章重点讲解了如何规避版本兼容性陷阱,正确部署Milvus服务端并安装匹配的Python SDK。通过一个电影推荐系统的完整案例,演示了从数据建模、集合创建、向量插入、索引构建到执行混合搜索的全流程,帮助开发者快速上手并完成第一个向量搜索Demo。

weixin_29239279的博客 192

Llama-Factory镜像发布:一键微调百款大模型,GPU算力变现新路径

Llama-Factory镜像通过Docker封装,集成LoRA与QLoRA技术,支持百款大模型高效微调,显著降低显存消耗与使用门槛。用户可在消费级GPU上完成70B级模型训练,并借助可视化界面实现无代码操作,推动AI普惠化与算力变现新模式。

weixin_35755640的博客 755

PyTorch模型生产部署:ONNX/Triton导出与高可用架构实战

机器学习模型部署本质是训练环境与生产环境之间的运行时契约建立过程,涉及序列化协议、推理引擎兼容性、动态批处理及资源隔离等核心问题。ONNX凭借标准化算子集和跨框架支持,成为平衡兼容性、性能与可维护性的首选导出格式;Triton Inference Server则通过原生多框架支持、动态batching和热加载能力,显著提升GPU利用率与服务SLA保障水平。在金融风控、电商推荐等高要求场景中,基于ONNX+Triton+K8s的分层架构可稳定支撑千级QPS与毫秒级P95延迟,同时满足模型热更新、可观测性与版本

weixin_33857679的博客 448

CBT-LLM 心理大模型微调,用LLaMA Factory微调框架就够啦!| 附一键复现指南

CBT-LLM 心理大模型微调,用LLaMA Factory微调框架就够啦!| 附一键复现指南

huang9604的博客 1235

华为OD机试真题-国际移动用户识别码(IMSI)匹配

华为OD机试双机位C卷 国际移动用户识别码(IMSI)匹配 , 提供C语言、Java、C++、Python、Go、JavaScript源码实现,并提供完整思路讲解。华为OD机试 - 国际移动用户识别码(IMSI)匹配

qq_45776114的博客 4927

innovus:streamOut gds中pg text带有冒号(:)解决办法

streamOut后查看layout,发现部分PG text后面加了冒号,比如VDD: / VSS:。当然,这个问题还有另一种解决办法,就是通过脚本给terminal打text再streamOut。我正在「拾陆楼」和朋友们讨论有趣的话题,你⼀起来吧?

m0_61544122的博客 1190

LLaMA-Factory:一键微调你的专属大模型(附教程)

这个由北航和北大合作开发的项目,不仅集成了高效的训练技术,还通过LLaMA Board提供了一个用户友好的网页界面,让个性化微调变得轻松而直观。

pythonhy的博客 1216

Y-Branch and a closed y-branch loop

双臂后面的区域,我们将它的双臂使用一个波导进行了连接,使得它本身形成了一个闭合回路,因此,该结构被称作。它们均是用来对经过它们的光束能量进行分割的一种器件。首先,我们知道一点,在光波导层面,今天给大家介绍一下,什么是。

u011699626的博客 630

Llama-Factory镜像发布:一键实现大模型全参数微调与LoRA训练

Llama-Factory提供开箱即用的Docker镜像,支持全参数微调、LoRA和QLoRA训练,兼容主流大模型架构,通过WebUI实现可视化操作,显著降低大模型微调的硬件门槛与技术复杂度,适用于从个人开发者到企业级的高效定制需求。

weixin_29840475的博客 850

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

Llama-Factory镜像发布:一键微调百款大模型,GPU算力需求全解析

Llama-Factory镜像实现大模型高效微调,支持LoRA/QLoRA技术,显著降低GPU显存需求。通过容器化与WebUI可视化,可在消费级显卡如RTX 3090上微调13B级别模型,提升算力利用率,简化从训练到部署的全流程。

weixin_42588672的博客 279

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

LLama-Factory镜像发布:一键微调百款大模型,支持LoRA与QLoRA高效训练

LLama-Factory镜像支持LoRA与QLoRA高效微调,显著降低大模型训练显存与成本,提供可视化WebUI界面,实现开箱即用的模型定制,适用于个人开发者、中小企业与科研教学场景。

weixin_30674431的博客 1085

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Llama Factory懒人包:一键部署你的专属大模型微调平台

通过Llama Factory懒人包,我成功为朋友的电商项目搭建了智能客服系统,从环境准备到模型上线只用了不到一天时间。选择一个适合的基础模型准备业务相关的问答数据通过Web界面完成微调导出模型并集成到应用大模型微调并没有想象中那么困难,关键是要选对工具。Llama Factory的抽象设计让开发者可以专注于业务逻辑,而不是底层实现细节。建议先从7B量级的模型开始尝试,熟悉流程后再挑战更大规模的模型。

IronwoodStag78的博客 668

【项目复现上新】LLaMA Factory 微调实践:从零构建苏东坡角色扮演大模型 | 附Lab4AI平台一键复现指南

【项目复现上新】LLaMA Factory 微调实践:从零构建苏东坡角色扮演大模型 | 附Lab4AI平台一键复现指南

瓦罗兰特顶级C位的博客 676

LLaMA-Factory 一键微调大模型,大模型入门到精通,收藏这篇就足够了!

LLaMA-Factory 是南京大学人工智能创新研究院开源的轻量级大语言模型(LLM)微调工具包。它的设计目标很明确:让普通开发者也能低成本地玩转大模型。

Y525698136的博客 928

10分钟搞定大模型微调:LLaMA Factory云端GPU一键部署方案

想微调一个属于自己的聊天机器人,却被复杂的依赖安装和显存不足劝退?LLaMA Factory作为一款开源低代码大模型微调框架,能让你在10分钟内快速上手个性化模型定制。本文将手把手带你通过云端GPU环境,零代码完成从部署到微调的全流程。这类任务通常需要GPU环境支持,目前优快云算力平台提供了包含LLaMA Factory的预置镜像,可快速部署验证。下面我们就从实际需求出发,看看如何用最简单的方式实现大模型微调。

QuartzLynx65的博客 1275
上一篇: 从零到实战:用 LLaMA-Factory 微调 Qwen2.5-VL
下一篇: 0 基础转行做生成式人工智能系统测试员,学习资源与路径全公开
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值