从零搭建 RAG 知识库:3 步搞定,小白也能学会,零基础入门大模型,收藏这篇就足够了

RAG 入门指南:从零开始构建一个 RAG 系统 在开始之前,我还是打算再次简要的介绍一下 RAG。在 Meta 的官方 Blog 上有这样一段话:这段话主要讲述了一个新的模型架构,也就是RAG (检索增强生成)的重要性和优势。可以概括为以下几点:1. 构建一个能够进行研究和上下文分析的模型虽然更具挑战性,但对未来的技术进步非常关键;2. 通过在知识密集的下游任务上微调,RAG 可以实现最先进的结果,比现有的最大的预训练序列到序列语言模型还要好;3. 与传统的预训练模型不同,RAG 的内部知识可以轻松地动态更改或补充。 阅读详情

上一篇文章给大家讲了 RAG 是什么、为什么好用,今天就来手把手教大家:怎么从零开始搭一个属于自己的 RAG 系统?其实核心就 3 步,哪怕是 AI 初学者也能看懂,赶紧码住~

图片

Step 1:数据预处理 —— 给知识 “拆包”“编码”

想让大模型用上咱们的专业知识,第一步得把原始数据 “处理成它能看懂的形式”。这一步就像咱们看书前先给书分类、标重点,方便之后快速查找。具体分 3 小步:

1. 收集知识库:把 “原材料” 攒起来

首先得有 “料”—— 不管是公司的业务手册、PDF 文档、Excel 表格,还是网页上的专业文章,只要是和你的业务相关的知识,都可以收集起来。比如做法律客服,就收集法条、案例;做教育辅导,就收集教材、题库。

2. 文档分块:把知识切成 “小块”

收集来的文档可能很长(比如一本几百页的手册),直接喂给模型会效率很低。这时候就需要 “分块”—— 把长文档切成一个个短片段(叫 “Chunks”),比如按章节、按段落,或者固定长度(比如每 300 字一段)。

关键原则:既不能切太碎(比如一句话一段,可能破坏语义),也不能切太大(比如一整本书一段,检索起来太慢)。目标是让每个 “小块” 既能独立表达一个完整意思,又方便后续快速查找。

3. 向量化:给知识 “编密码”

这是最核心的一步!大模型看不懂文字,得把文字转换成它能理解的 “数字向量”(比如一串 768 维或 1024 维的数字)。就像咱们用字母拼单词,模型用向量 “拼” 知识 —— 语义越像的文字,向量越接近。

  • 工具推荐

    :初学者不用自己写模型,直接用开源的 Embedding 模型就行,比如 BGE、M3E,几行代码就能把文本转成向量。

  • 存哪里

    :转换好的向量会存在 “向量数据库” 里(比如 Pinecone、Milvus,简单理解就是专门存向量的 “仓库”),方便后面快速检索。

小补充:向量化的原理有点复杂,后面会专门写一篇文章拆解,这里知道 “文字转数字,方便模型比对” 就行~

Step 2:数据检索 —— 让模型 “精准找答案”

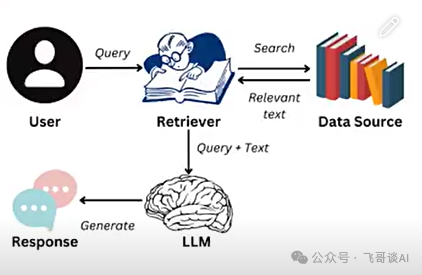
当用户提问时,RAG 会先帮模型 “搜资料”,找到最相关的知识片段。这一步就像咱们查字典:先根据问题找关键词,再翻到对应的页码。

1. 问题转向量:把用户的话 “编码”

用户问的问题(比如 “信用卡逾期一天影响征信吗?”),也要先用 Step 1 里的向量化工具转换成向量 —— 相当于给问题 “编个密码”,方便和知识库的向量比对。

2. 相似度检索:找到 “最像的知识”

向量数据库会计算 “问题向量” 和 “知识库向量” 的相似度(比如用余弦相似度、欧氏距离),挑出最像的 Top K 个片段(比如 Top 3 或 Top 5)。

小技巧:可以用提示词工程优化问题,让检索更准。比如用户问 “有什么好的美元理财产品?”,可以让大模型先把问题扩写成 “有什么预期收益率高、灵活取用的美元理财产品?”,关键词更明确,找到的知识也更相关。

工具推荐:LangChain 里的 QA 模块(qa_langchain)可以直接实现这一步,不用自己写复杂代码~
图片

Step 3:生成答案 —— 让模型 “基于知识说话”

最后一步,就是让大模型结合用户的问题和检索到的知识,生成最终回答。这时候模型不会瞎编,而是会基于找到的 “知识片段” 总结,相当于带着 “参考资料” 答题,准确率自然更高。

比如用户问 “信用卡逾期一天影响征信吗?”,RAG 会先从知识库找到《信用卡章程》里的相关条款(比如 “逾期 3 天内还款不上征信”),再让大模型基于这条款回答,既专业又准确。

灵魂拷问:模型怎么知道啥时候用 RAG?

有同学可能会问:大模型怎么判断 “该用自己的知识回答,还是该查 RAG 知识库”?比如用户问 “今天天气怎么样”,可能不需要查业务知识;但问 “公司的年假政策”,就必须查 RAG。

其实有 3 种常见做法:

  1. 让大模型自己判断

    :在提示词里加一句 “如果问题和业务相关,就用 RAG 知识库回答,否则直接回答”。

  2. 强制查 RAG

    :所有问题都先过一遍 RAG,确保回答基于最新知识(适合对准确性要求极高的场景,比如医疗、法律)。

  3. 用智能体(Agent)管理

    :让 Agent 像 “小助理” 一样,自动判断什么时候需要调用 RAG 工具,什么时候直接回答。这种方式更智能,后面会专门讲~

 我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

大模型技术学习系列(5): 基于langchain构建RAG应用 本章中,我们回归了一下RAG的流程,并分析了下这个过程中涉及到的组件以及这些组件在langchain中对应的实现方式,并整合这些方式,实现了带RAG的大模型应用。通过这个实践过程,能够帮助我们更好的理解RAG的整个过程。 阅读详情

相关推荐

AI学习指南RAG篇(7)-RAG知识库构建

RAG知识库的构建过程包括数据收集、预处理、分块和向量化四个关键步骤。每个步骤都至关重要,直接影响到RAG系统的性能和效果。通过本文的详细讲解和示例代码,希望你能更好地理解RAG知识库的构建过程,并在实际应用中加以运用。如果你对RAG技术感兴趣,欢迎继续关注本系列的后续文章,我们将深入探讨RAG技术的实现细节和实践应用。

俞兆鹏的博客 1195

RAG与知识库搭建,手把手教你构建RAG系统

自从发现可以利用自有数据来增强大语言模型(LLM)的能力以来,如何将 LLM 的通用知识与个人数据有效结合一直是热门话题。关于使用微调(fine-tuning)还是检索增强生成(RAG)来实现这一目标的讨论持续不断。检索增强生成 (RAG) 是一种使用来自私有或专有数据源的信息来辅助文本生成的技术。它将检索模型(设计用于搜索大型数据集或知识库)和生成模型(例如大型语言模型 (LLM),此类模型会使用检索到的信息生成可供阅读的文本回复)结合在一起。

qkh1234567的博客 5180

Nginx/OpenResty目录穿越漏洞复现

Nginx/OpenResty目录穿越漏洞复现 漏洞背景: 2020年03月18日, 360CERT监测发现 openwall oss-security 邮件组披露了两枚漏洞。在特定配置下 nginx/openresty 存在 内存泄漏漏洞/目录穿越漏洞。 Nginx 是异步框架的网页服务器,也可以用作反向代理、负载平衡器和HTTP缓存。 OpenResty是一个基于nginx的Web平台,它对nginx增加LuaJIT引擎使其运行Lua脚本。 影响版本: nginx <= v1.17

小小猪的博客 1万+

从零搭建 RAG 知识库:3 步搞定,小白也能学会,大模型入门到精通,收藏这篇就足够了!

今天就来手把手教大家:怎么从零开始搭一个属于自己的 RAG 系统?其实核心就 3 步,哪怕是 AI 初学者也能看懂,赶紧码住~

DEVELOPERAA的博客 1081

告别手动归档:基于Allegro Skill的XTools一键生成Gerber与生产文件实践

本文详细介绍了基于Allegro Skill的XTools工具如何实现一键生成Gerber与生产文件,大幅提升PCB设计效率。通过自动化流程,解决了传统手动归档中的重复劳动、人为失误和标准不统一等问题,特别适合需要频繁输出生产文件的工程师。文章包含安装配置、实战操作、问题排查及进阶技巧,帮助用户快速掌握这一高效工具。

weixin_30505225的博客 461

汇川EASY521 PLC实战指南:从硬件选型到程序架构与故障排查

可编程逻辑控制器(PLC)是工业自动化系统的核心大脑,其工作原理基于循环扫描机制,持续读取输入、执行用户程序并更新输出。这种确定性控制方式,使其在逻辑控制、顺序控制和运动控制中具有不可替代的技术价值,广泛应用于机械设备、生产线和过程控制等场景。对于汇川EASY521这类紧凑型高性能PLC,其核心优势在于集成了运动控制与丰富通讯接口,为中小型设备提供了高性价比的一站式解决方案。在实际应用中,工程师常需处理如“汇川sv660n”伺服驱动器的集成调试,或利用“hslcommunication”等开源库实现C#上位

weixin_42525264的博客 736

从零搭建 RAG 知识库:3 步搞定,小白也能学会

今天就来手把手教大家:怎么从零开始搭一个属于自己的 RAG 系统?其实核心就 3 步,哪怕是 AI 初学者也能看懂,赶紧码住~

2401_82469710的博客 1138

告别卡顿!用LVGL+DMA刷新STM32F407的SPI屏幕,性能提升实战

本文详细介绍了如何通过LVGL+DMA技术优化STM32F407驱动SPI屏幕的性能,实现接近60FPS的流畅刷新。从硬件瓶颈分析到SPI与DMA的精细化配置,再到LVGL的双缓冲机制与局部刷新优化,提供了一套完整的性能提升方案。特别适合嵌入式GUI开发中面临卡顿问题的工程师参考。

weixin_42531588的博客 379

从零搭建本地 Dify+RAG 知识库:全流程实战指南​,大模型入门到精通,收藏这篇就足够了!

本教程将带你从零实现本地 Dify+RAG 知识库搭建,涵盖环境部署、模型配置、知识库构建、性能优化全流程,即使零基础也能快速上手。

2301_81888214的博客 2550

最简解决 Unity Error Registry configuration is invalid Unable to connect https packages.unity.cn

前言 在学习其他大佬项目的时候,大佬说项目能直接运行,然后我拉下来就报如下错误 Unity报错:[Package Manager]Error Registry configuration is invalid:Unable to connect “https://packages.unity.cn” 翻了很多博发现是 unity3d 中国增强版的原因,中国增强版屏蔽了国外自定义的插件仓库。 安装 非中国增强版后可以成功打开。 然后大家给出的解决方案都比较激进,大抵就是更换Unity版本就OK了。 当然我是觉

Gipsyz的博客 6842

【学习笔记】无人机(UAV)在3GPP系统中的增强支持(四)-无人机系统(UAS)命令与控制(C2)通信用例

UTM向5G网络提供无人机系统C2通信所需的信息,例如服务类别、无人机系统服务的流量类型、授权的无人机系统服务所需的QoS以及无人机系统服务的订阅。遵循模型B的网络辅助C2模型,为了确保UAS操作的C2通信的服务可用性和可靠性,特别是当无人机在操作员的视线之外(BLOS)飞行时,为无人机提供支持冗余的C2通信链路。如果需要创建额外的C2通信连接或更改现有数据连接的配置以进行C2通信,则5G网络会根据无人机系统的授权服务信息和C2通信中所需的QoS和优先级,修改或分配一个或多个C2通信流量的QoS流。

u011376987的博客 2051

基于Dify的RAG知识库搭建,大模型入门到精通,收藏这篇就足够了!

Dify 是一款开源的大模型应用开发平台,旨在帮助开发者快速构建生产级生成式 AI 应用。在Dify 本地化部署中,知识库功能是实现企业级 AI 应用的核心能力。

瓦罗兰特顶级C位的博客 1116

14 | TensorFlow2对阿拉伯语手写字符数据集进行识别

该数据集由 60 名参与者书写的16,800 个字符组成,年龄范围在 19 至 40 岁之间,90% 的参与者是右手。每个参与者在两种形式上写下每个字符(从“alef”到“yeh”)十次,如图 7(a)和 7(b)所示。表格以 300 dpi 的分辨率扫描。使用 Matlab 2016a 自动分割每个块以确定每个块的坐标。该数据库分为两组:训练集(每类 13,440 个字符到 480 个图像)和测试集(每类 3,360 个字符到 120 个图像)。数据标签为1到28个类别。

微信号:RunsenLiu 2876

从零搭建企业级RAG知识库问答系统,大模型入门到精通,收藏这篇就足够了!

RAG(Retrieval-Augmented Generation,检索增强生成) 是一种融合信息检索与大模型生成能力的技术架构。

2401_82469710的博客 1153

YOLO26优化:原创自研 | 自研独家创新DSAM注意力 ,基于BiLevelRoutingAttention注意力升级

提出新颖的注意力DSAM(Deformable Bi-level SpatialAttention Module),创新度极佳,适合科研创新,效果秒杀CBAM,Channel Attention+Spartial Attention升级为新颖的Deformable Bi-level Attention+Spartial Attention

①答疑群聊服务;②YOLO大模型知识问答系统;③计算机视觉论文生成智能体; 365

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

RAG知识库:本地搭建chatgpt知识库,大模型入门到精通,收藏这篇就足够了!

🤖️ 一种利用 langchain 思想实现的基于本地知识库的问答应用,目标期望建立一套对中文场景与开源模型支持友好、可离线运行的知识库问答解决方案。

pythonhy的博客 860

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

Dify 搭建私有的RAG知识库(实操篇)大模型入门到精通,收藏这篇就足够了!

还在为构建私有化AI应用犯愁吗?今天给大家介绍一款强大的开源利器——Dify。这款被称为’AI应用开发神器’的平台,正在悄悄改变着开发者构建AI应用的方式。

瓦罗兰特顶级C位的博客 1377

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

[n8n搭建知识库]RAG技术入门:让AI更懂你的知识库,大模型入门到精通,收藏这篇就足够了!

本文章提供的是一种使用n8n搭建RAG系统的思路,本文章所展示的工作流为基础入门实践,里面有很多部分可以根据自己的需要进行扩展。

2401_82469710的博客 1169
上一篇: 从零搭建迪士尼客服 RAG 系统:小白也能学会的 3 步实操指南
下一篇: AI“学霸”是怎么炼成的?揭秘ChatGPT背后的“大语言模型”
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值