


为了解放生产力,人们发明了算法去控制、代替重复劳动的工作。
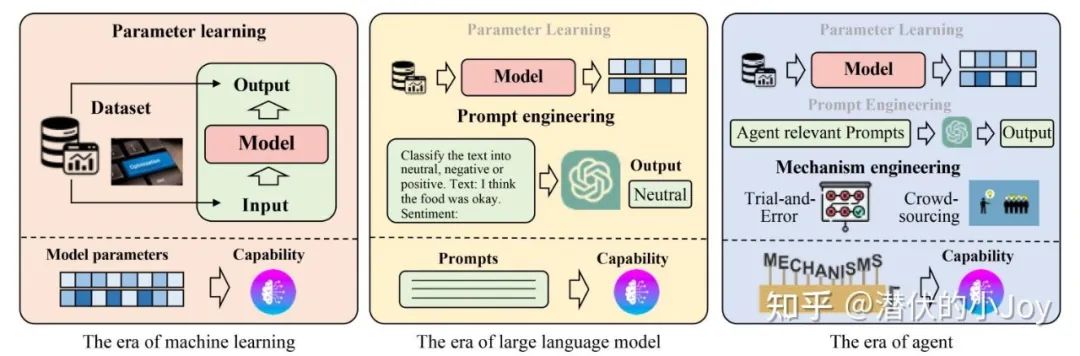
随着大语言模型(LLM)的发展,人们不再偏好局限性的算法,而利用 LLM 的思考,规划能力,并为其赋予可以格式化调用的工具(如 api),进一步的满足人们不同的需求。
同时,外部工具的引入,更加先进的 Prompt Engineering 技术,RAG、KAG 等外部信息库的补充,也进一步增强了 LLM 能力。
本文尝试从 Single Agent,以 Camel-ai.org 为代表的一系列 multi-agents 框架,Agents Universe 的构建与统一化协议,AI for science、Applications 分析与介绍。
01
What is agent?
什么是智能体?在强化学习中通常把智能体看做是一个决策实体,在环境中采取行动并通过与环境的交互来学习如何最大化其长期回报的实体。
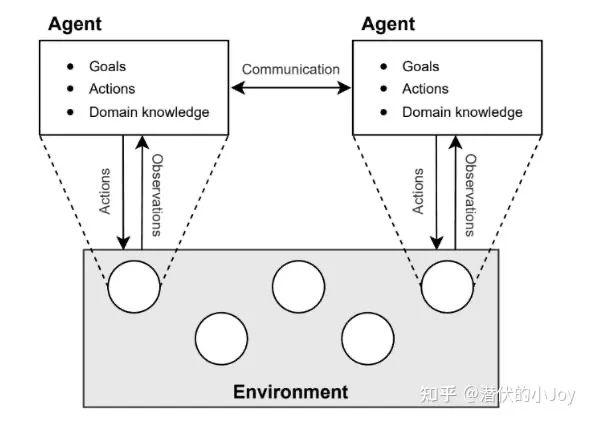
在应用层面,我们将大语言模型接入各种应用 api,引入知识图谱 RAG、思维链 CoT 等技术,让 LLM 不仅有预训练的丰富知识还可以利用各种工具,完成更具体的、更丰富的任务,成为一个能力更加强悍的智能体。
智能体通常由三个部分组成:
-
Planing & Reasoning
-
Memory
-
Tool use & Action
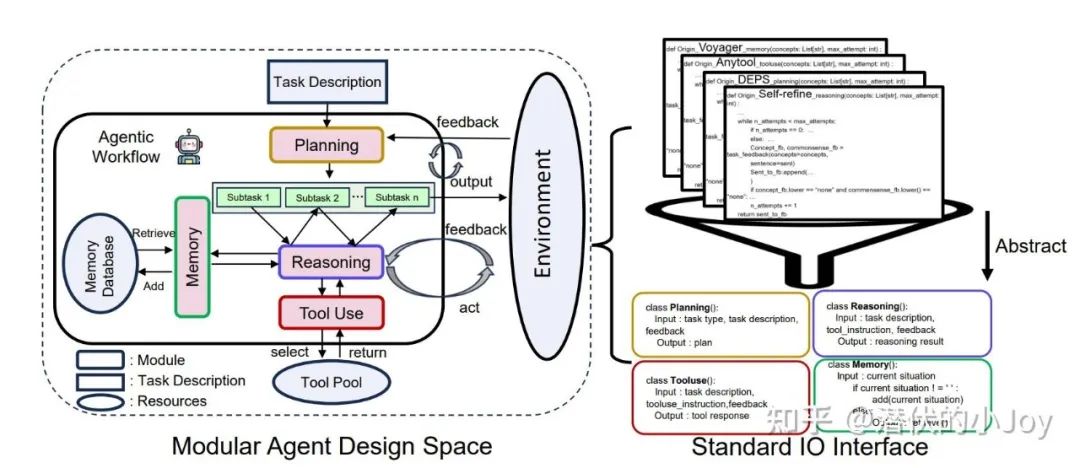
(1)Planing
看作是对问题进行一个总体的规划,通过提示词让 LLM 思考该如何回答这个询问或完成这个问题。
比如 LLM 尝试规划一条 Step by step 的解决问题路径或是将主任务分解几个小任务,接下来再这个一个一个解决问题。
通常有如下四种方案:
-
将复杂任务分解为多个子任务,然后逐一规划解决每个子任务。
-
生成多个备选计划,并通过某种搜索算法选择最优计划执行
-
通过LLM形式化任务,然后使用外部规划器来生成计划。
-
先生成计划,然后进行反思,最后根据反思结果精炼计划。
(2)Reasoning
LLM 需要对过去的行为进行自我批评和反思,从错误中吸取教训,并为未来的步骤进行改进,加入反思会显著提高 LLM 的回答质量。
关于 LLM 推理,可以参考 Lilian Weng 的博客和 Prompt Engineering Guide 网站。基础的 Chain of Thoughts 链状推理在大部分场景足够使用。
最近也看到很多有意思的研究:
快慢思维协调的 Talker-Reasoner 系统:talker 快速反应 reasoner 深度思考,二者即可分开工作也可协同反应;慢思考在面部识别、有存在异常干扰的数据分类任务上表现不如快思考;
逆向规划:类似于传统搜索算法中的A*算法,不仅有前向的思维链思考,还有从目标逆向的思考:
思维马尔可夫链 MCoT:与传统的多步推理不同,MCoT 将每一步推理视为一个状态转换过程,并且在简化问题后清除上下文缓存,从而支持更长的推理路径;
Stream of Search (SoS):通过 CoT 生成的包含正确答案和错误尝试的数据对 LLM 微调,让其学习搜索与回溯的能力;
动态推理 DOTS:给定一些推理策略,让 LLM 能够根据问题的具体特征和自身的能力,让自己选择最优的推理策略;
一个有趣的观点:从信息论角度来理解 CoT 的作用;其实关于 LLM 推理的问题,其实可以建模成熟悉的数据结构,链也好(CoT),树也好(ToT),图也罢(GoT),结合传统数据结构的搜索回溯算法,去进行推理路径的选择。
或是建模成优化问题,关注 Explore 和 Explicit(或许与快慢思考有一定对照关系)去探索尝试。
除了 prompt 设计外,越来越多的是在RL偏好对齐或者 SFT 层直接对思维链数据进行训练,锻炼模型的思考能力。
(3)Memory
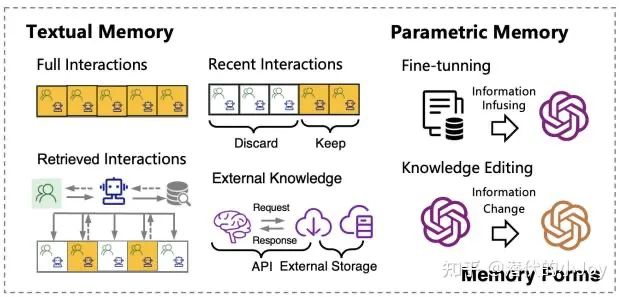
人类的记忆可大致分类为感官记忆、短期记忆、长期记忆,与之对应为大模型的多模态输入时的原始嵌入表示,对话交互,以及在外部储存的对话中提取的信息。
前二者是模型本身架构的限制,通常在 128k 上下文长度,最多 8k 的生成内容。
为了有效增强与 LLM 对话的准确性和丰富性,引入可以视为长期记忆的外部知识检索库,如 RAG 技术。关于知识检索,与计算机系统的文件系统、数据库检索有一定的相似性。
(4)Tool Use & Action
通过 Json 格式化输出,调用所需要使用的 api 接口或是其他资源工具,让 LLM 不止停留在说而可以做。同样,每一次工具调用得到反馈我们也可以进行一次反思总结。
同时每一次 action 都随着反馈进行 reasoning 和优化 LLM 下一步的决策,如 StepTool,为每一步工具调用涉及奖励进行分布强化学习,每一步后进行选择优化。
因为 LLM,我们现在可以使用自然语言去操控一个个软件,进一步的还可以操控其他智能体/模型。
1. 最基础的操控类似于 Google Search api,DeepL(一个翻译软件) api 等等。
一个有趣的例子是让 LLM 帮你订一张机票,其中通过对网页 html 代码的交互进行:
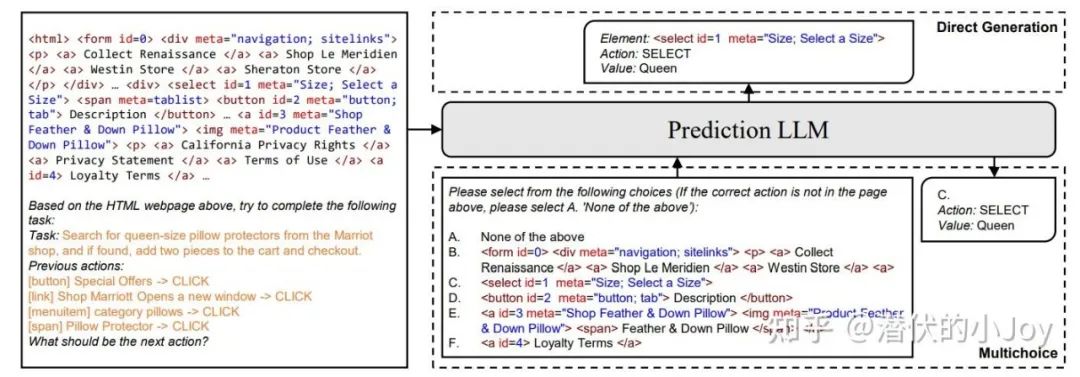
本文的思路是将整个订机票的流程拆解成一次次 html 的查找与虚拟的鼠标点击,对于每次给定 item 的点击操作,在 html 源码中查找 k 个大概率与之此 item 相关的指令,再选出最可能的执行操作。
在上图中,左侧即是目前已经执行的操作序列、对任务的描述和目前所在网页的html源码,右下角即是选出来的k个最可能指令.
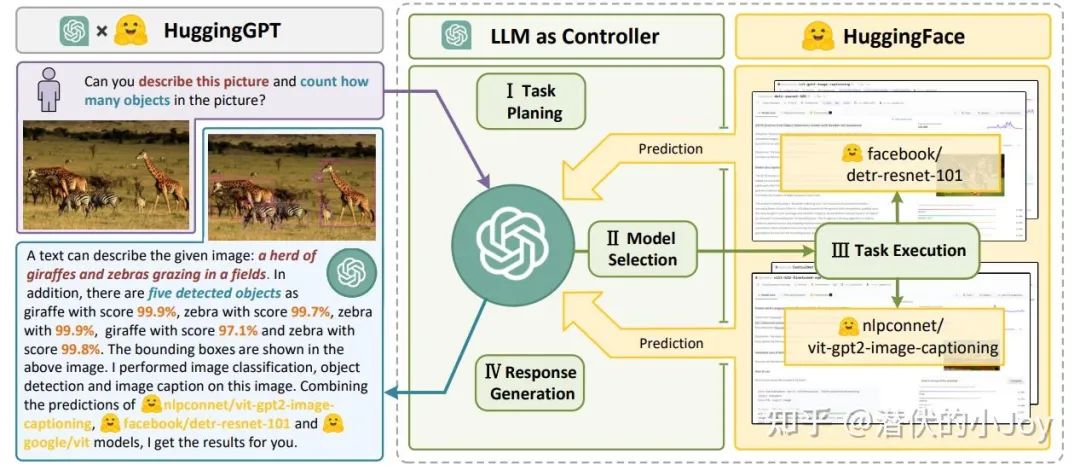
2. LLM control LLM/Agent。如 HuggingGPT 框架,用 LLM 作为任务规划器,根据 Planing 结果选择 HuggingFace 平台中可用的模型,并根据执行结果总结。
3. 日前爆火的 Claude 新功能 computer use 和智谱的 AutoGLM 与传统的 api 交互有所不同,其通过 VLM(视觉语言模型)操控,如下是一个自动导航的例子:
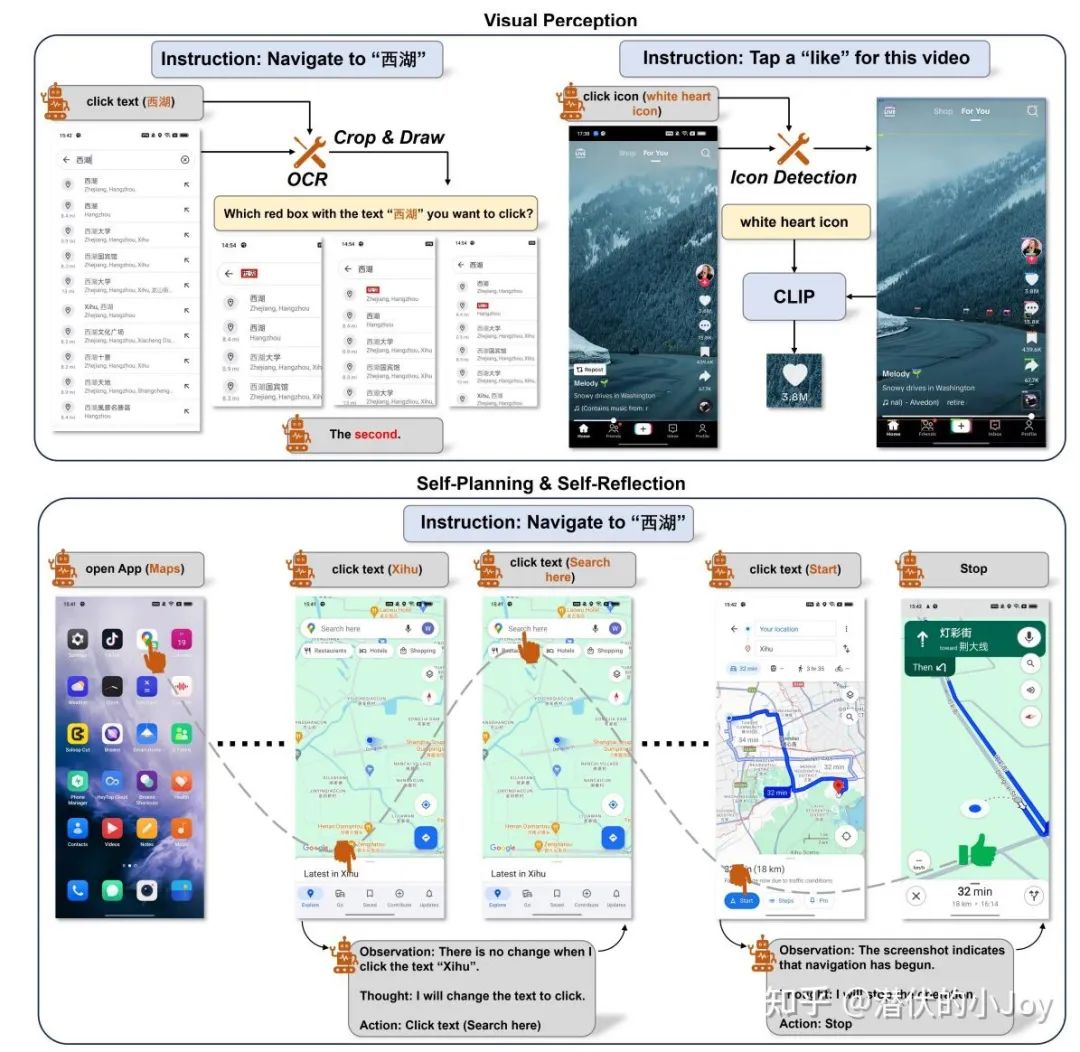
有趣的是,斯坦佛 Yang Diyi 老师等发现了弹窗攻击对 VLM 决策的干扰极大,并且要求 Agent 忽略弹窗或包含广告提示等基本防御技术对攻击无效。
Profile(optional):有时有 Role playing 角色扮演任务的需求,需要对 agent 添加角色资料的描述。这将在后面 AI+society science 的讨论提到。
出于不同的需要,我们可以大致将 Agent 分为如下几类:
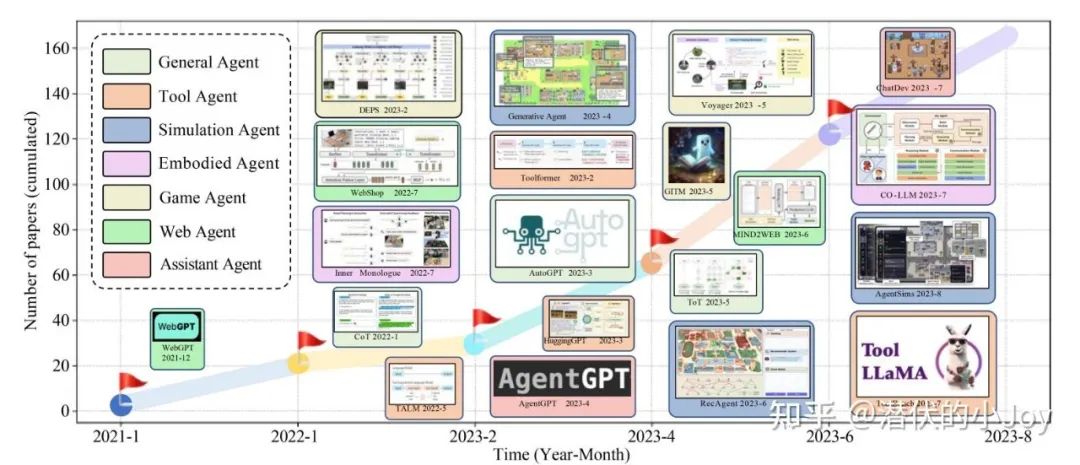
Agent 的研究是具有潜力的,我认为其是学术和工业应用 gap 最小的方向。国内如扣子等平台,每个人都可以定制搭建自己的 Agent,又或者通过 camel,dspy,langchain 等成熟的库编写代码搭建。
02
About multi-agents
基于单智能体的思维局限性,长思维链条任务的表现不佳等因素,人们又尝试探索多智能体 multi-agents 之间的合作是否会带来更好的任务表现。
具体的讲,多智能体相对于单智能体:
-
能够提升回答的准确性与一致性,可以有效减少LLM的幻觉问题。
-
多智能体系统可以将任务分段,从而可以处理更加复杂的任务,同时可以容纳更长的上下文长度(清华 NLP 实验室的 MiniCPM 3.0 无限上下文的方案(后问详细介绍))同时可以并行处理任务。
-
通过角色扮演,不同的智能体可以带来不同的视角,使得任务回答更加全面完善。多智能体间也可以通过协作,结合不同模型的优势解决问题。
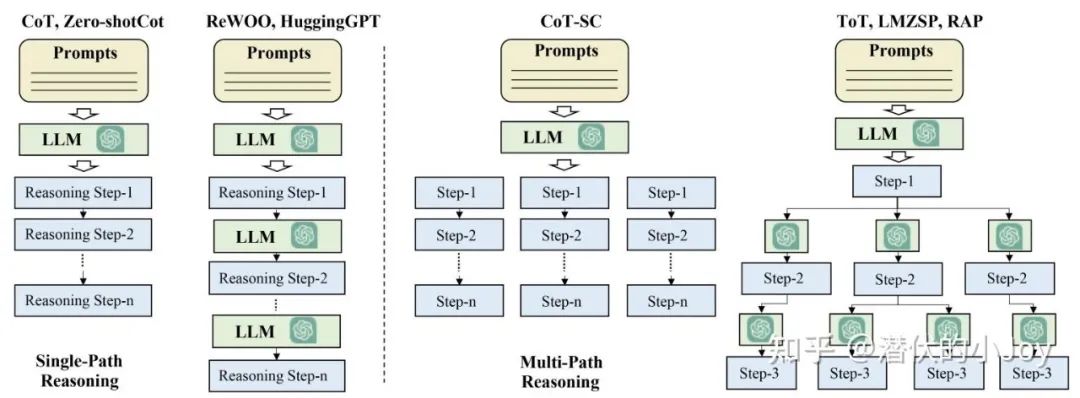
如下图,单个智能体的思维链,无论是 Chain of Thought(CoT) 还是 Tree of Thought(ToT),我们将每一个 step 替换成一个 LLM 来做,每个 LLM 专注于自己的子任务,只负责一个小的 step。
又或者是参照常见任务中人类合作的模式,搭建 Agent 工作流 workflow。
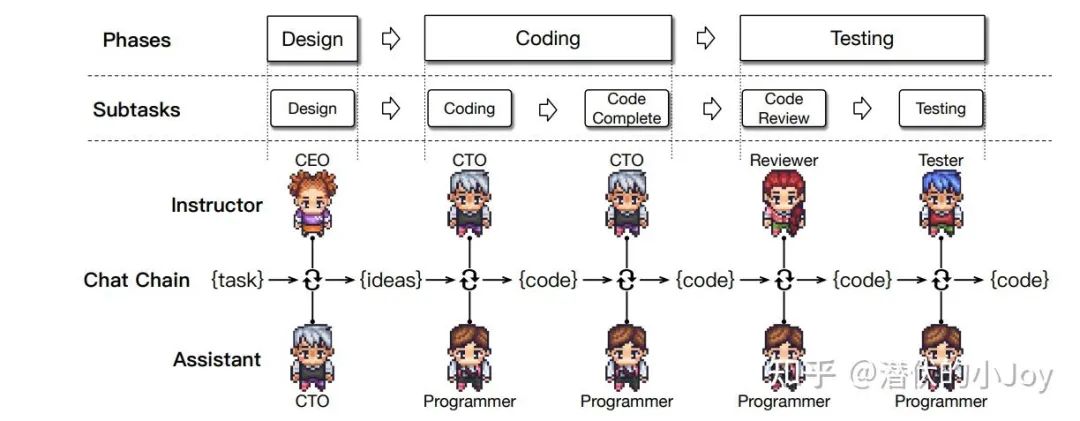
由清华 NLP 组开发的 ChatDev,模拟软件开发的工作流程:项目经理明确需求,工程师编写具体代码,进行检查和测试,从而提高所生成代码的一致性完成度和质量。
模拟生化实验室中的配置,博士生-导师架构,动态加入科研助理,本科生实验实习助理以设计科学实验。
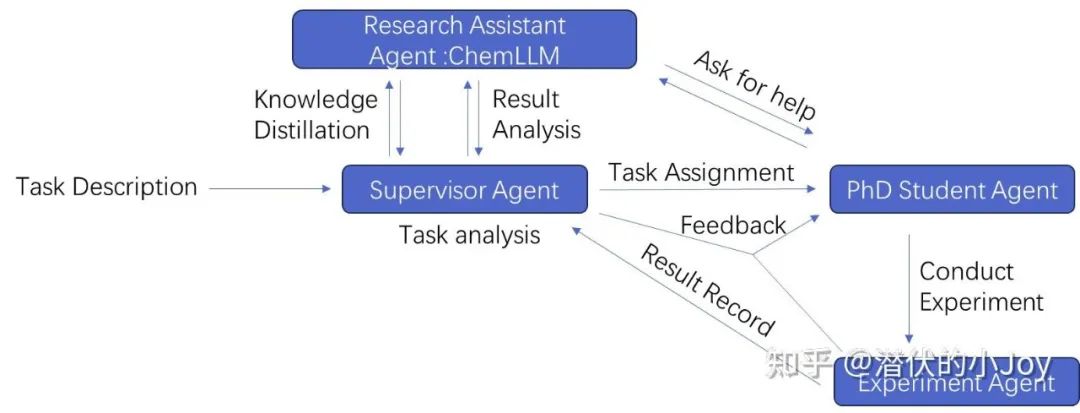
By PKU-HMI Lab
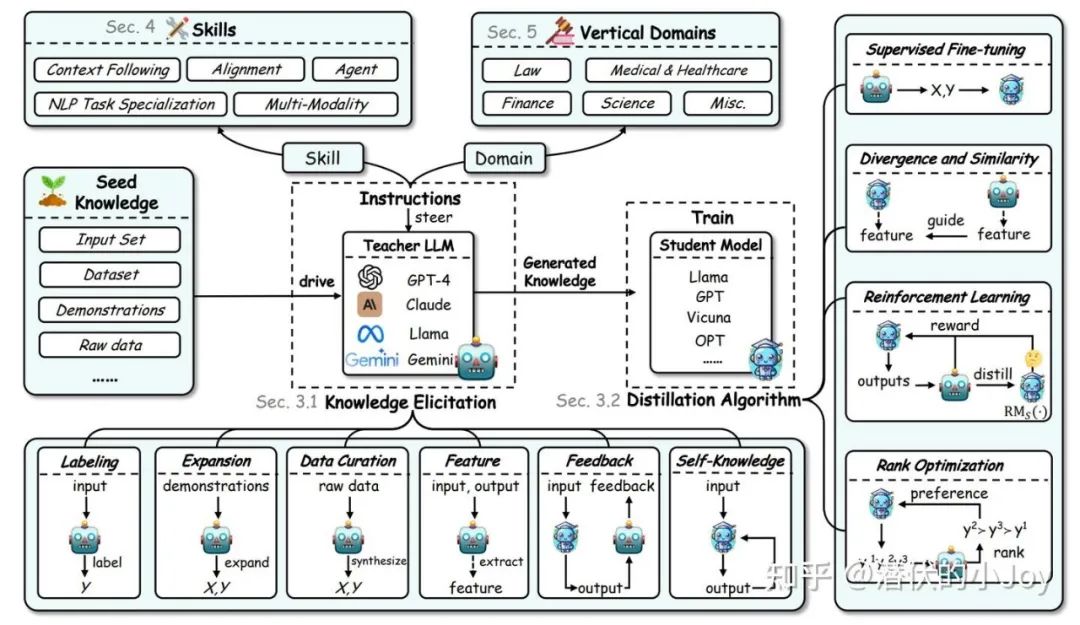
关于 Teacher-student 框架,除了传统的多智能体协作外,可以讨论的话题还有知识蒸馏 Knowledge Distillation,用大模型去训练小模型,从而逐渐的减少学生老师间的通信,对齐学生和老师在该任务下的能力(如老师为 GPT-4,学生为 GPT-3.5)。
常见的知识蒸馏通常在监督微调(SFT)与强化学习微调(RL)层微调,近年来也有不少 In-context learning(ICL),与之相似的,通过对话讨论也有一定的蒸馏效果。
关于知识蒸馏更多的讨论可参加下图原文:
多智能体与单智能体的研究类似,主要聚焦于多智能体之间的通信(Planing & Reasoning),架构(Memory),和外部工具使用(Tool use & Action)。
关于多智能体框架,目前主流的有 Camel-AI,CrewAI,LangGraph(皆为较活跃的维护社区),Openai 的 Swarm,metaGPT,微软的 AutoGen,Magentic-One。
这里向大家介绍 Camel AI 框架,也是最早提出并且持续更新维护的多智能体系统。
构建一套多智能体合作解决问题的机制,最重要的就是多智能体之间的通讯。
03
applications: AI+ Society Science
基于大语言模型的快速迭代和智能体的发展,其在各个领域都有了极为广泛的应用。
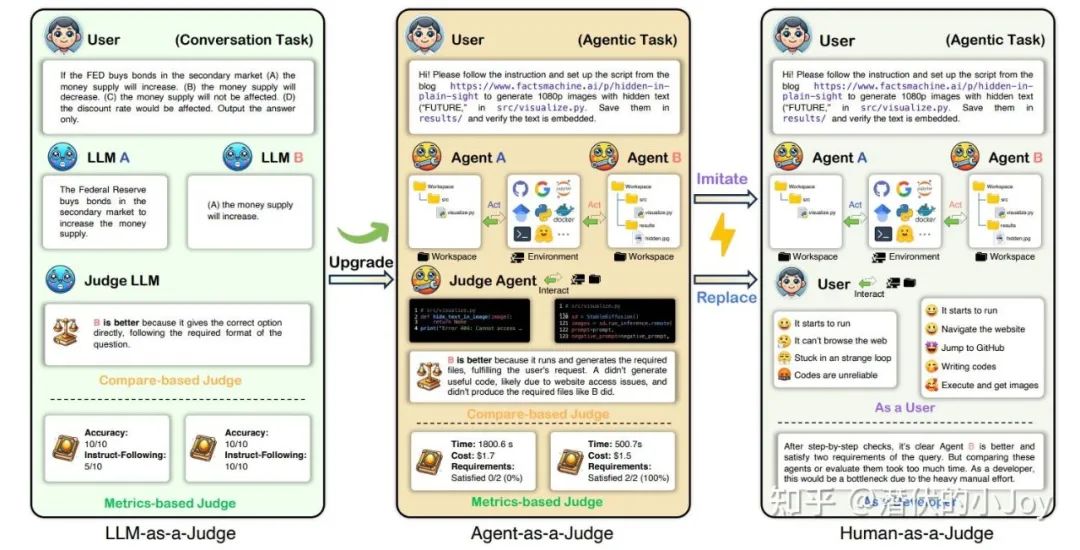
Agent-as-a-Judge: Evaluate Agents with Agents
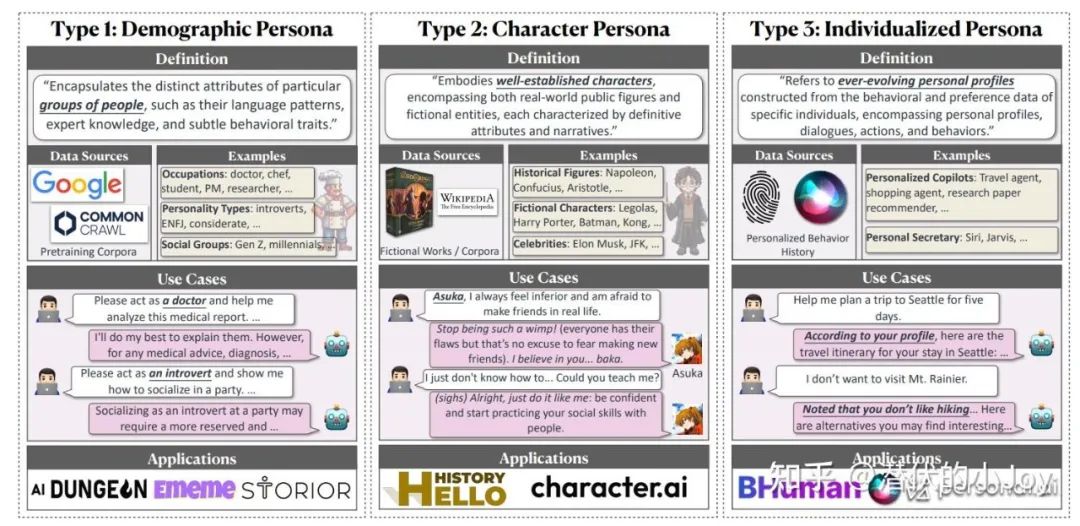
From Persona to Personalization: A Survey on Role-Playing Language Agents
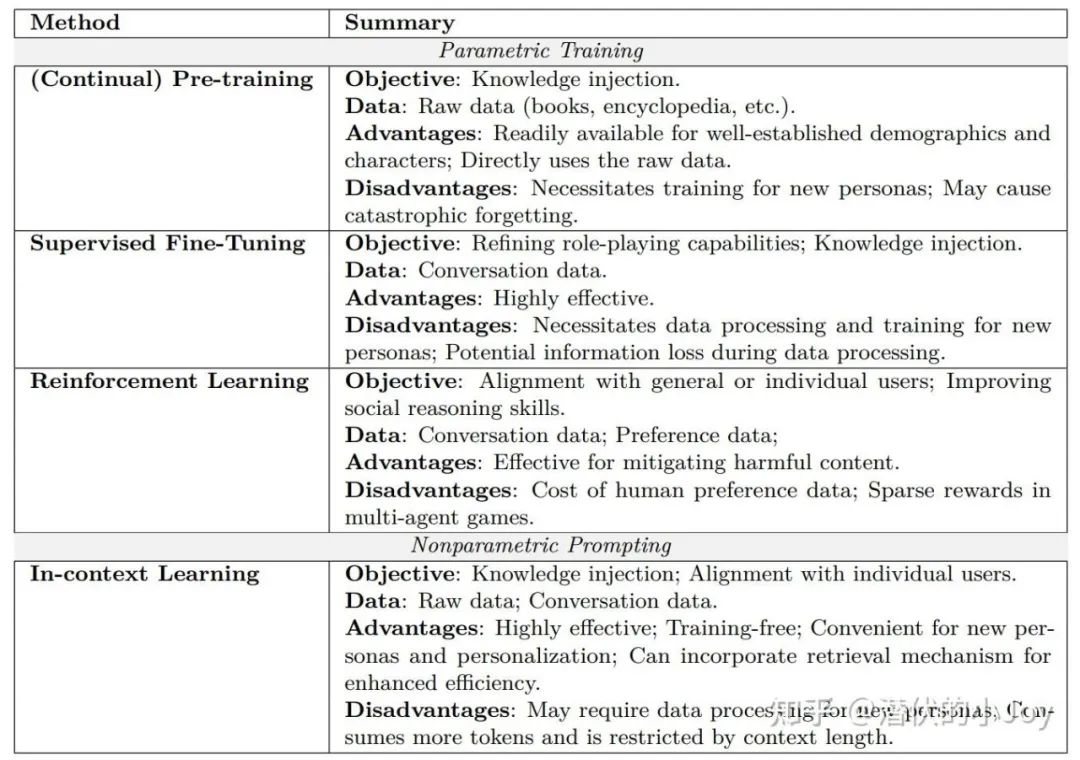
From Persona to Personalization: A Survey on Role-Playing Language Agents
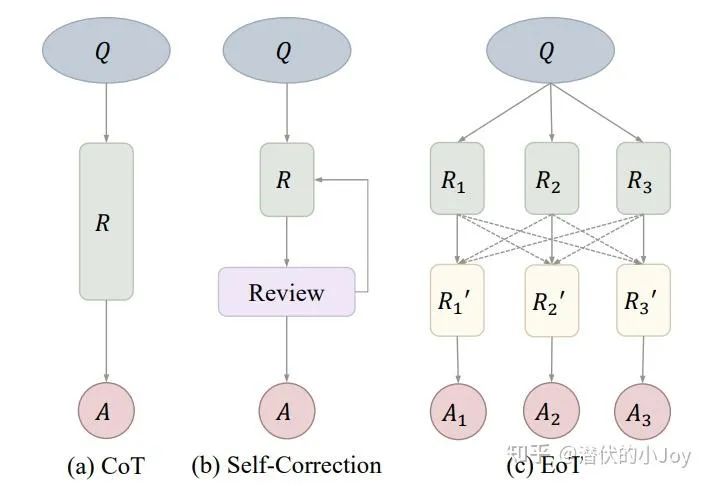
Exchange-of-Thought: Enhancing Large Language Model Capabilitiesthrough Cross-Model Communication
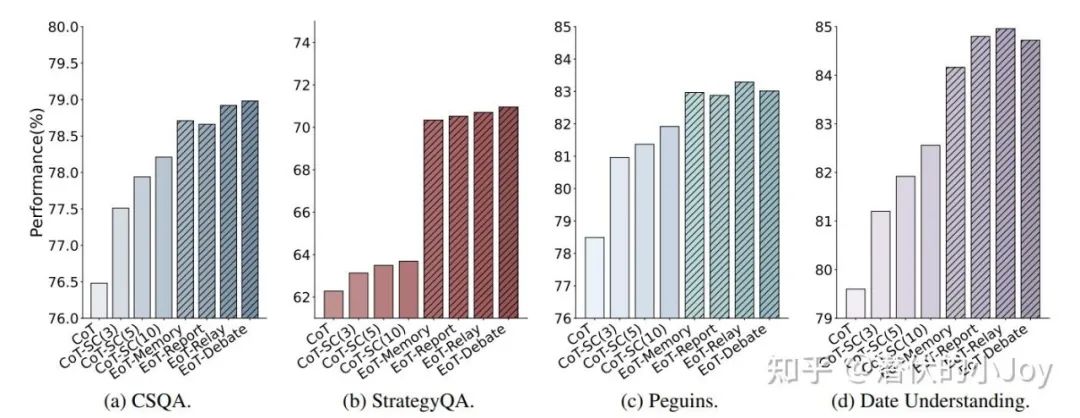
Exchange-of-Thought: Enhancing Large Language Model Capabilitiesthrough Cross-Model Communication
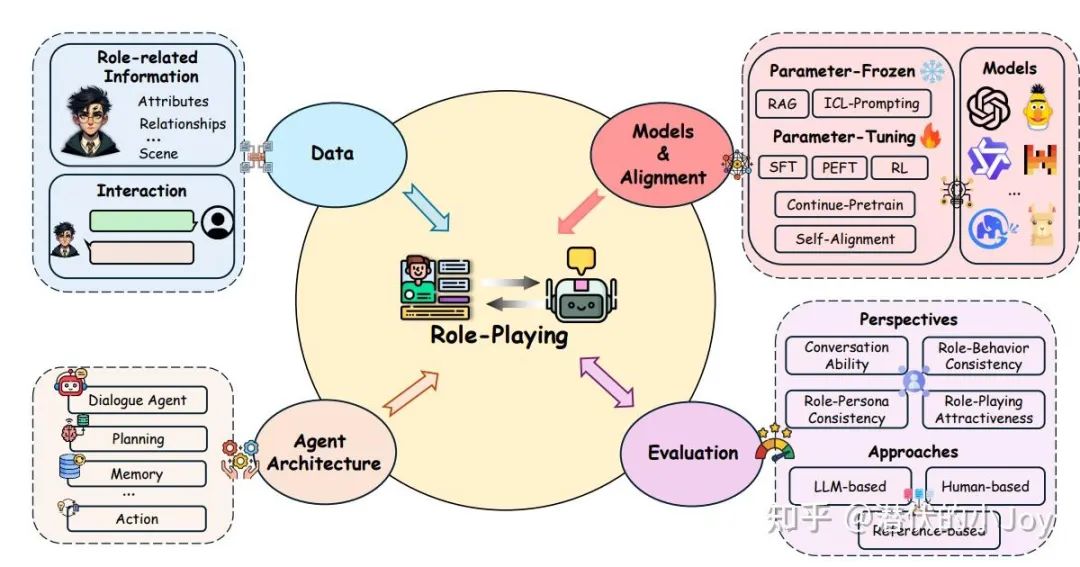
The Oscars of AI Theater: A Survey on Role-Playing with Language
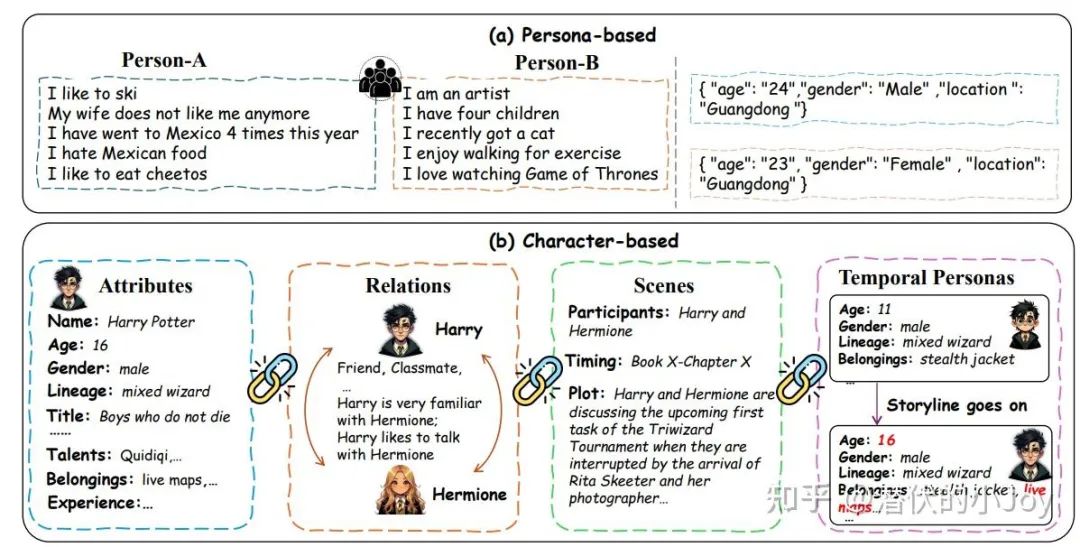
The Oscars of AI Theater: A Survey on Role-Playing with Language
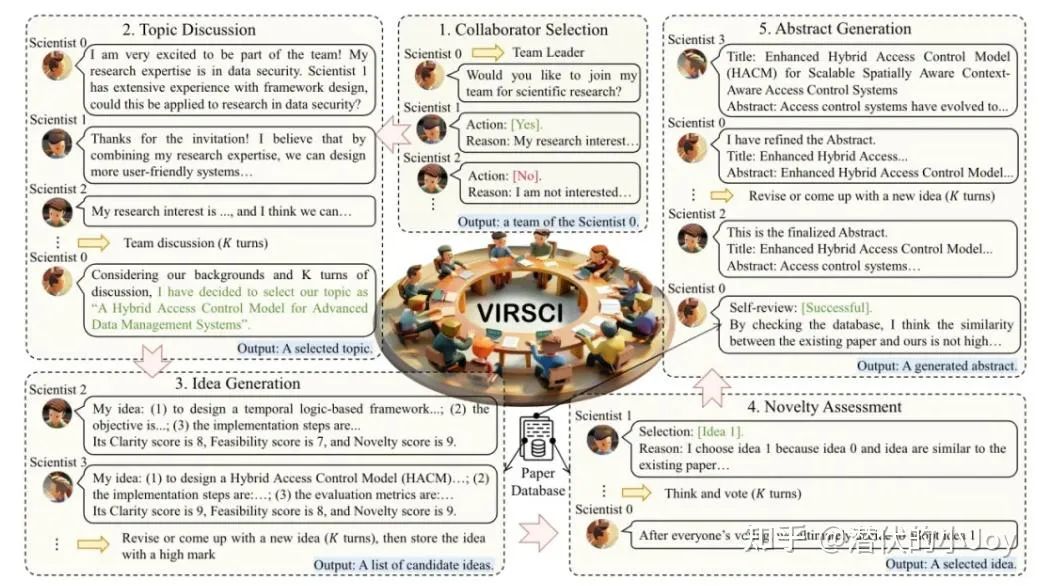
TWO HEADS ARE BETTER THAN ONE: A MULTIAGENT SYSTEM HAS THE POTENTIAL TO IMPROVESCIENTIFIC IDEA GENERATION
适当的团队规模和讨论轮数能够显著提升创新性。过大的团队规模或过多的讨论轮次可能导致协调困难和创意枯竭,从而降低创新性表现。
同时,团队成员之间存在首次合作的人数比例在 50 %时,团队的创新性达到最高,这表明在新旧成员合理混合的情况下,团队不仅能发挥已有的协作默契,还能在多样化的视角中产生更多新颖想法。
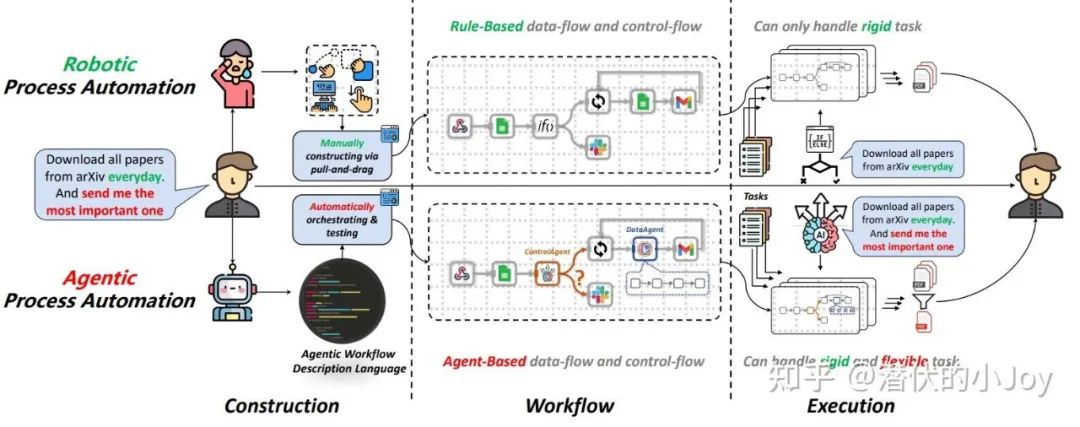
PROAGENT: FROM ROBOTIC PROCESS AUTOMATIONTO AGENTIC PROCESS AUTOMATION
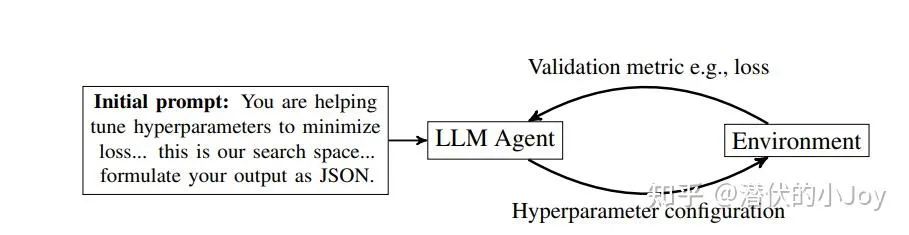
Using Large Language Models forHyperparameter Optimization
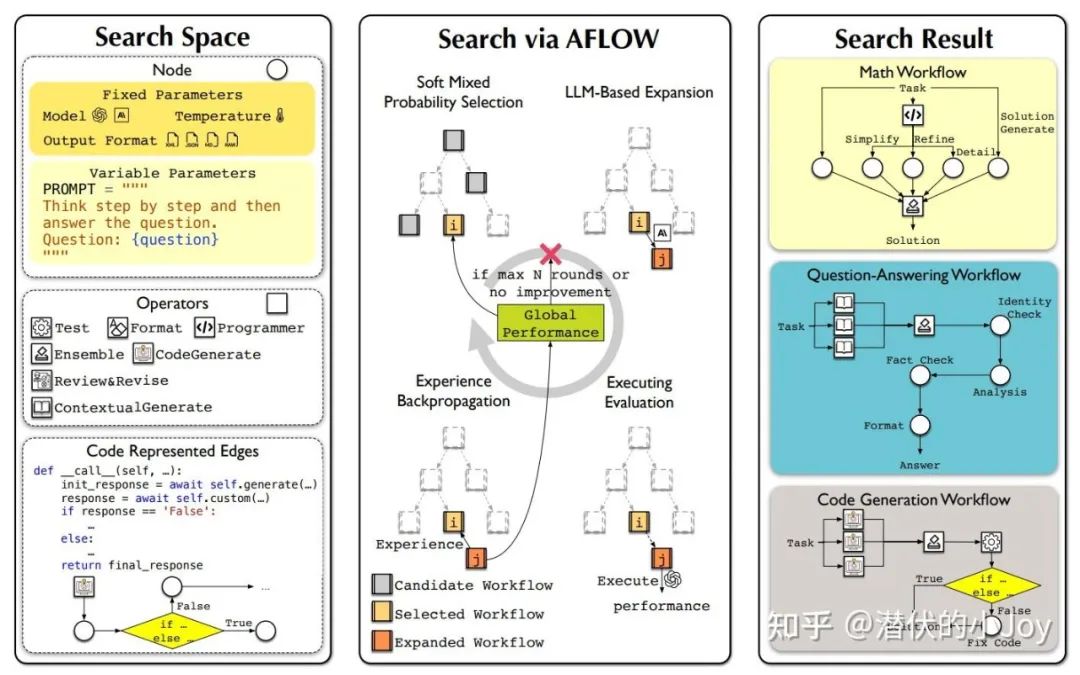
AFLOW: AUTOMATING AGENTIC WORKFLOW GENERATION
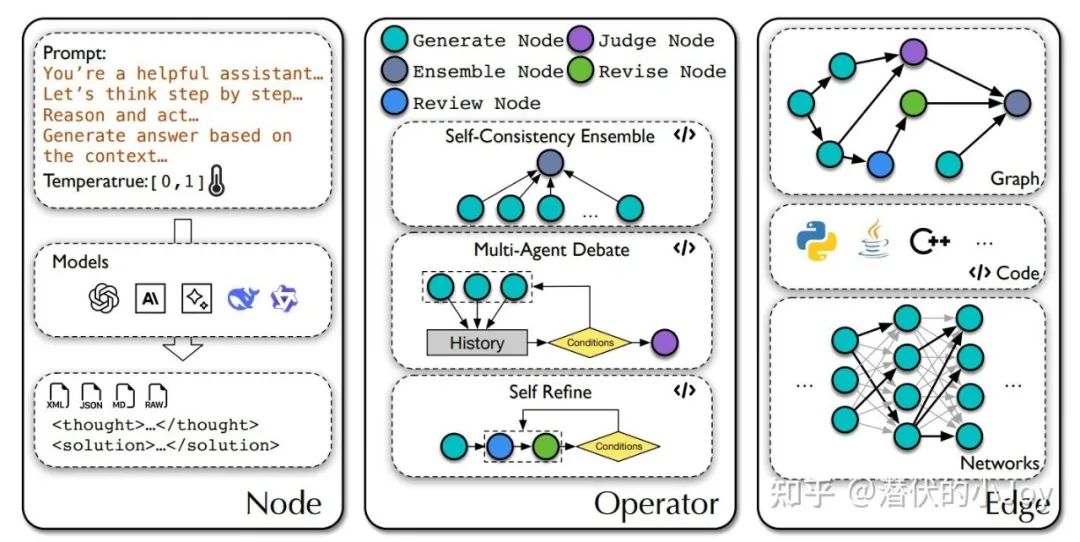
AFLOW: AUTOMATING AGENTIC WORKFLOW GENERATION
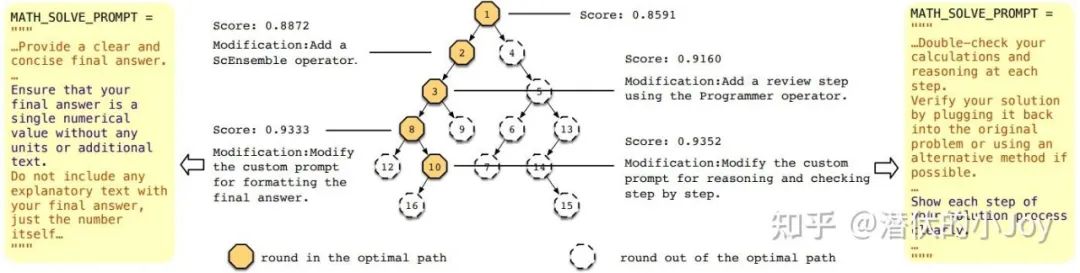
AFLOW: AUTOMATING AGENTIC WORKFLOW GENERATION
多是 SFT 和 RL 阶段,近些年有了一些 In-context-learning。
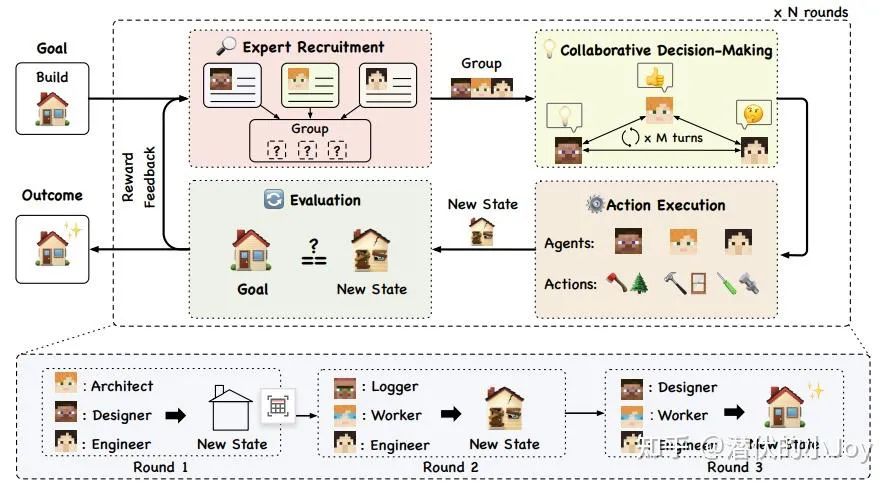
AGENTVERSE: FACILITATING MULTI-AGENT COLLABORATION AND EXPLORING EMERGENT BEHAVIORS
其中三个智能体的合作方式有 Vertical Structure 和 Horizontal Structure 两种。
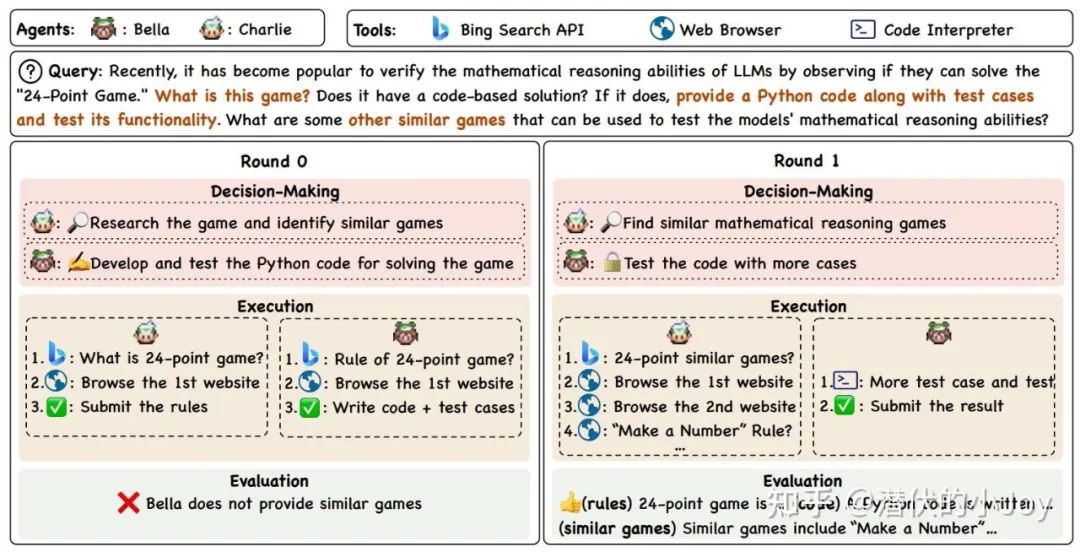
AGENTVERSE: FACILITATING MULTI-AGENT COLLABORATION AND EXPLORING EMERGENT BEHAVIORS
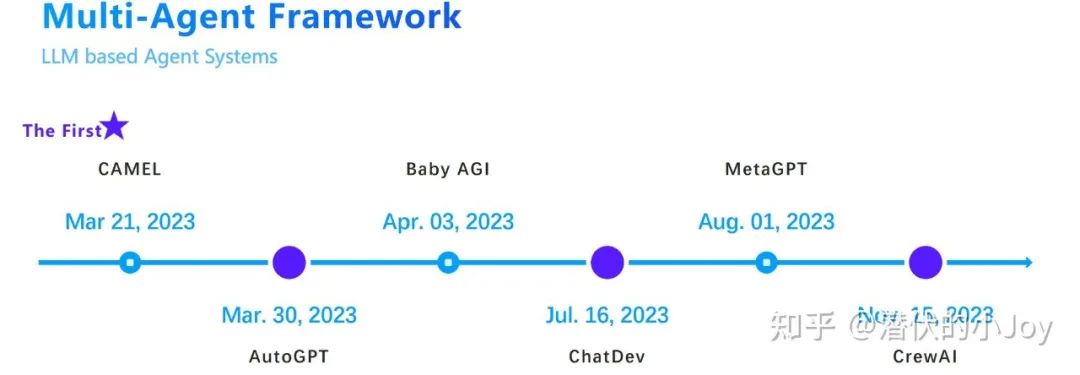
Camel-ai.org
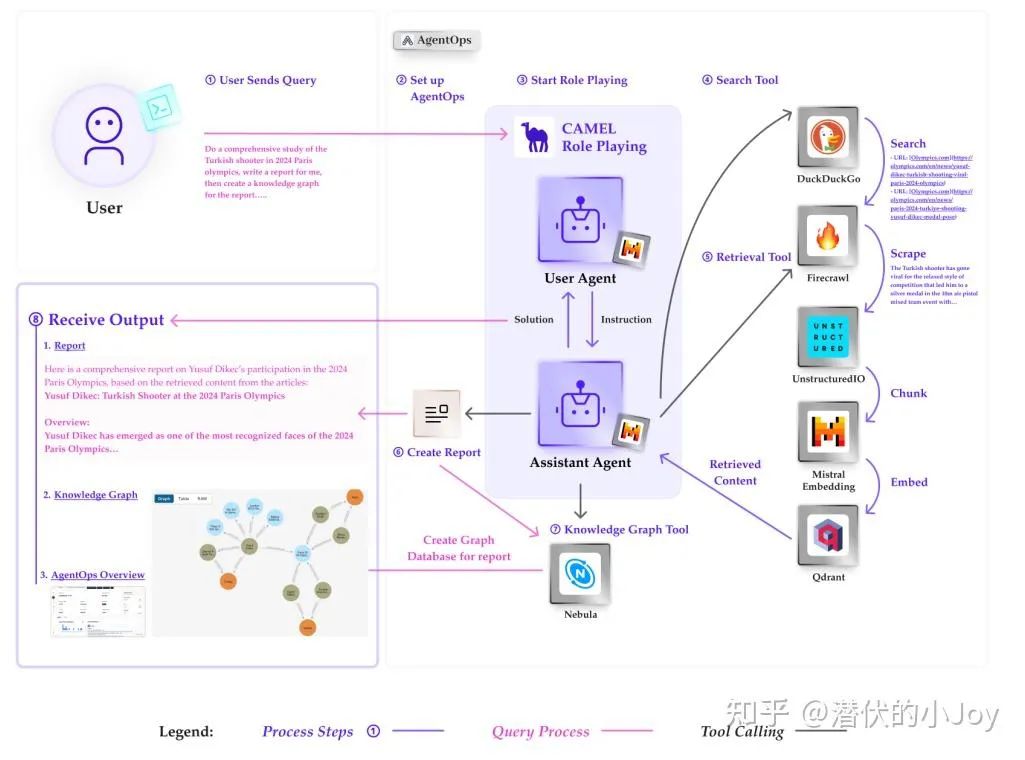
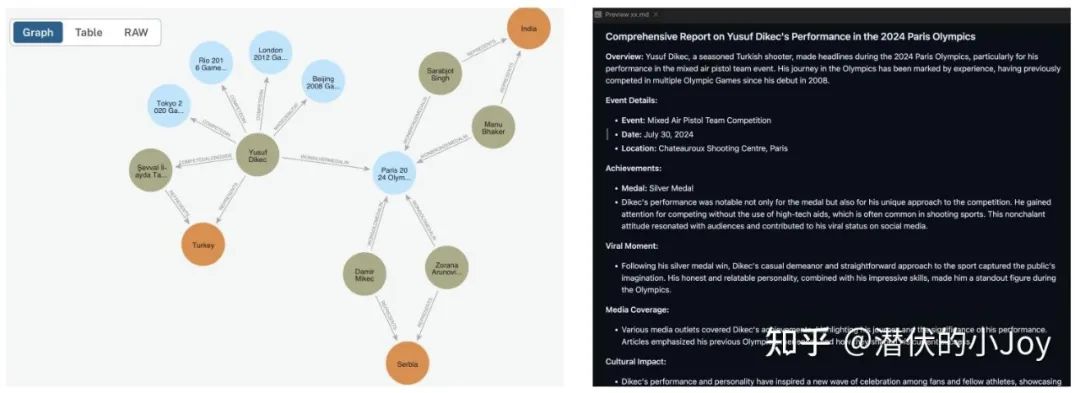
Camel-ai.org
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 923


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


