DeepSeek V3把训练大模型的成本给干下来了(附教程)

【人工智能】大模型训练的成本革命:DeepSeek 的资源需求与优化之道 随着人工智能技术的飞速发展,大规模语言模型(LLM)的训练成本成为行业关注的焦点。DeepSeek 作为中国 AI 领域的代表,以其低成本高性能的特性震惊全球。本文深入剖析 DeepSeek 的资源需求与训练优化策略,探讨其如何以 557.6 万美元的训练成本实现与 GPT-4o、Claude-3.5 等顶尖模型媲美的性能。通过分析其技术报告,我们揭示了 DeepSeek 在算力利用、算法创新和数据效率上的突破,包括多头潜在注意力(MLA)、混合专家(MoE)架构和 FP8 混合精度训练等关键技术。文章结合 阅读详情

一夜之间,DeepSeek突然之间炸场,各个大佬都在纷纷转发,而且发布即开源,直接用50多页的论文公布了其训练细节
简单来说,DeepSeek V3是个拥有671B参数的MoE模型,每个token可以激活37B参数,利用了大概14.8T的高质量token进行了大规模与训练。原生就是FP8混合精度训练框架,并首次验证其在超大规模模型上的有效性

训练大模型也可以很省钱

DeepSeek V3延续了便宜又快的训练思路。

DeepSeek V3的训练总共才用了不到280万个GPU小时,而Llama 3 405B却用了3080万GPU小时。用训练一个模型所花费的钱来说,训练一个DeepSeek V3只需要花费557.6万美元,相比之下,一个简单的7B Llama 3模型则需要花费76万美元。
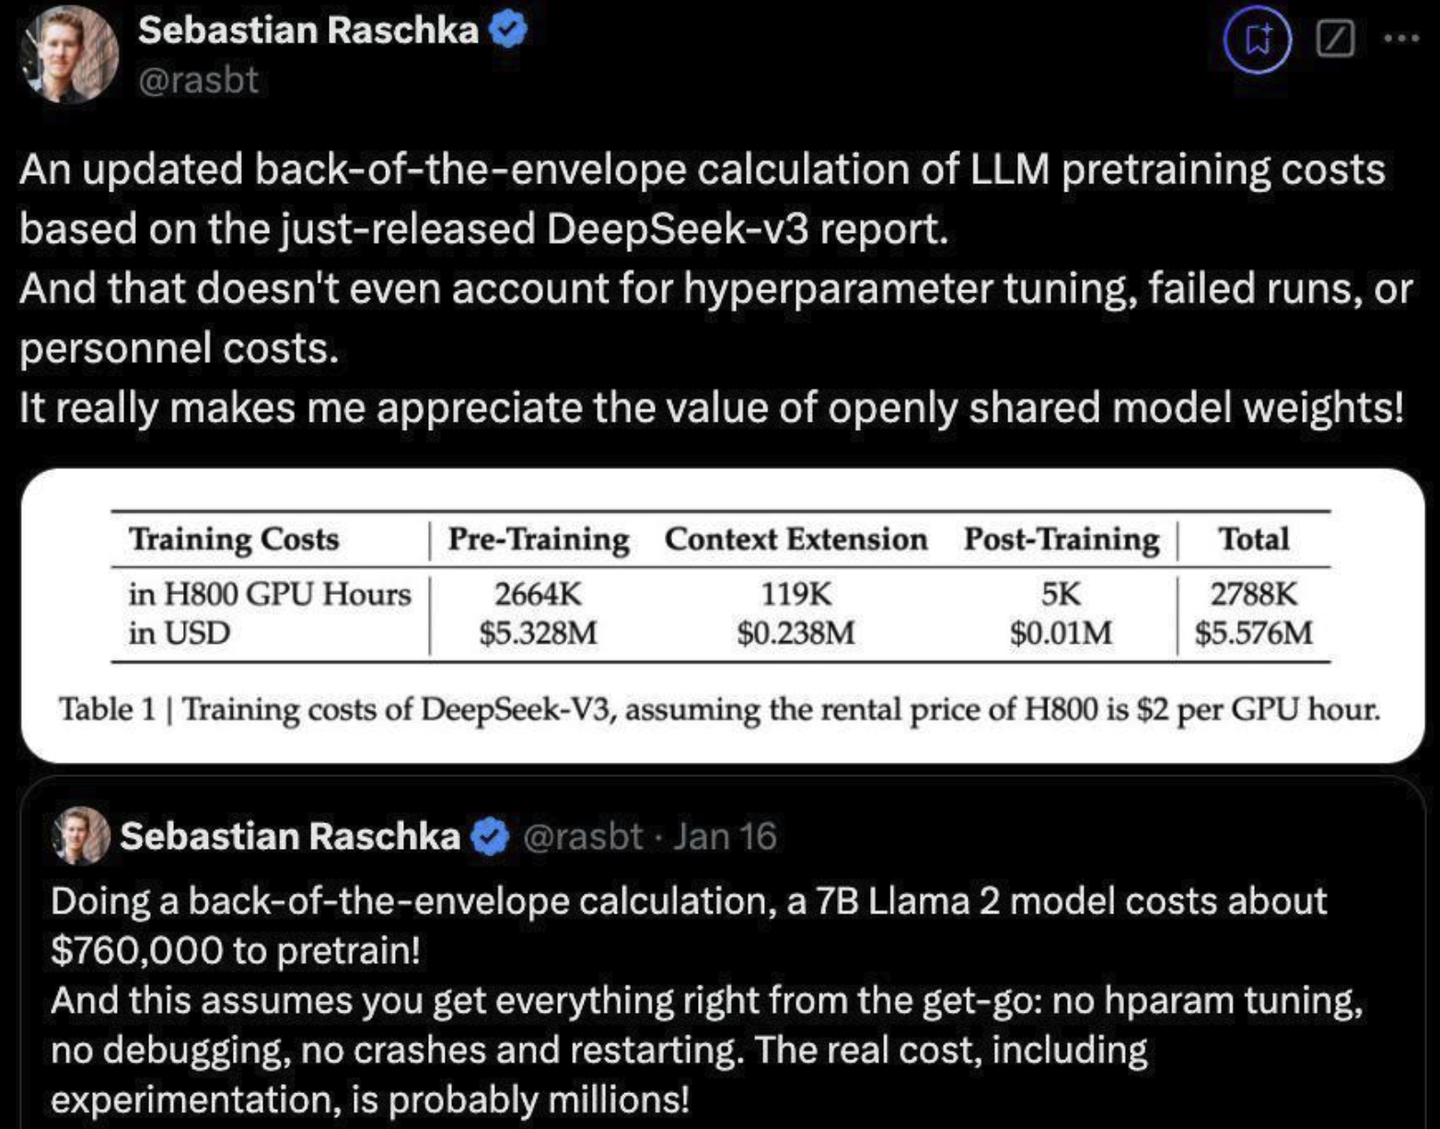
从论文中的公布细节可以得到它的训练成本估算:

  • 以 H800 GPU 小时为单位。H800 GPU 的租赁价格假定为每小时 2 美元。
  • 训练分为三个阶段:预训练、上下文扩展和后期训练:
  • 预训练:使用了 2664K(266.4 万)GPU 小时,成本约为 532.8 万美元。
  • 上下文扩展:使用了 119K(11.9 万)GPU 小时,成本约为 23.8 万美元。
  • 后期训练:使用了 5K GPU 小时,成本约为 1,000 美元。
  • 总成本:2788K(278.8 万)GPU 小时,总费用为 557.6 万美元。

比起动辄几百亿人民币都训练不出来一个好用的大模型,DeepSeek V3的训练简直颠覆了大家的想象。这里训练这么省钱当然主要是因为该模型原生就是FP8,还有在模型架构上做了一些优化导致模型训练成本很低。

模型效果惊为天人

从发布的效果来看,这个开源模型在多个数据集上的效果都能够赶上最前沿的几个大模型。
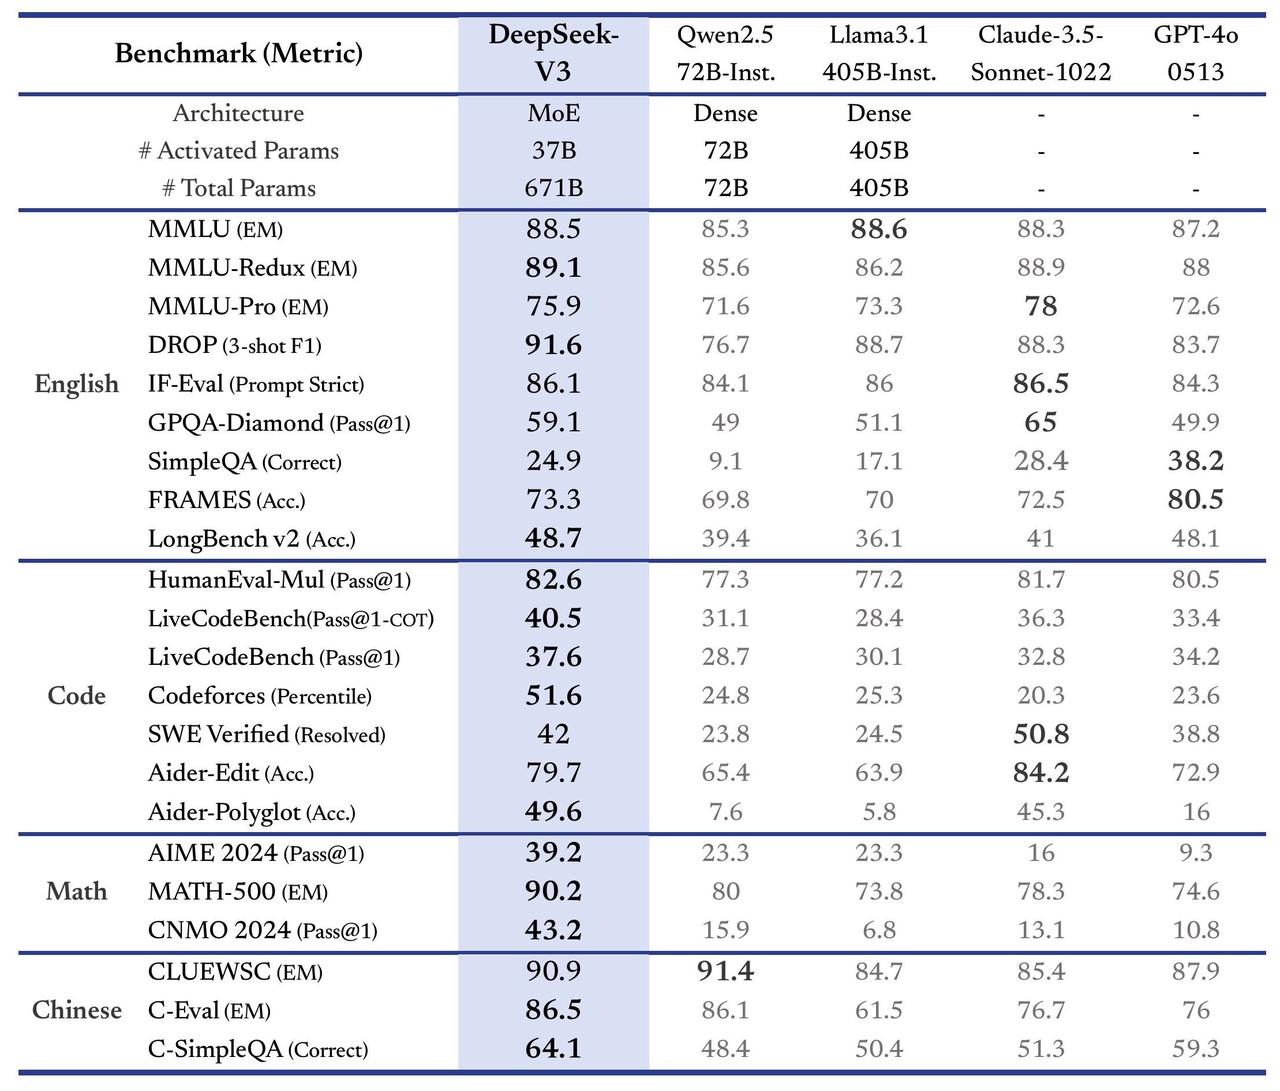
比如在英语任务上,在多项英语基准(MMLU、MMLU-Redux、DROP 等)上,DeepSeek V3 展现了强劲的性能:在 MMLU-Redux(89.1)和 DROP(91.6)的表现优于其他模型,就连GPT-4o分数都比它要低,在复杂推理任务中展现了领先优势。F-Eval(Prompt Strict)上达到 86.1,仅仅只略低于 Claude-3.5(86.5)。

在编程领域上,DeepSeek V3 在编程任务中表现中规中矩:

  • 在 HumanEval-Mul 和 Codeforces 的基准上,分别取得 82.6 和 51.6。
  • 对比之下,只有Claude-3.5 在部分代码生成任务上(SWE Verified)表现略优。

在数学任务上,DeepSeek V3 在数学推理任务中表现出色:

  • MATH-500(90.2)的表现超过 GPT-4o(74.6)和 Claude-3.5(78.3)。
  • 在 AIME 2024 和 CNMO 2024 的 测试中,分别取得 39.2 和 43.2 的分数。

中文任务这个应该是最有优势的了,基本都可以秒杀国外的一些前沿大模型,

  • CLUEWSC(90.9)接近 Qwen2.5 的顶级表现(91.4)。
  • 在更复杂的中文问答任务(C-SimpleQA)中,DeepSeek V3 的分数为 64.1,达到顶尖水准。

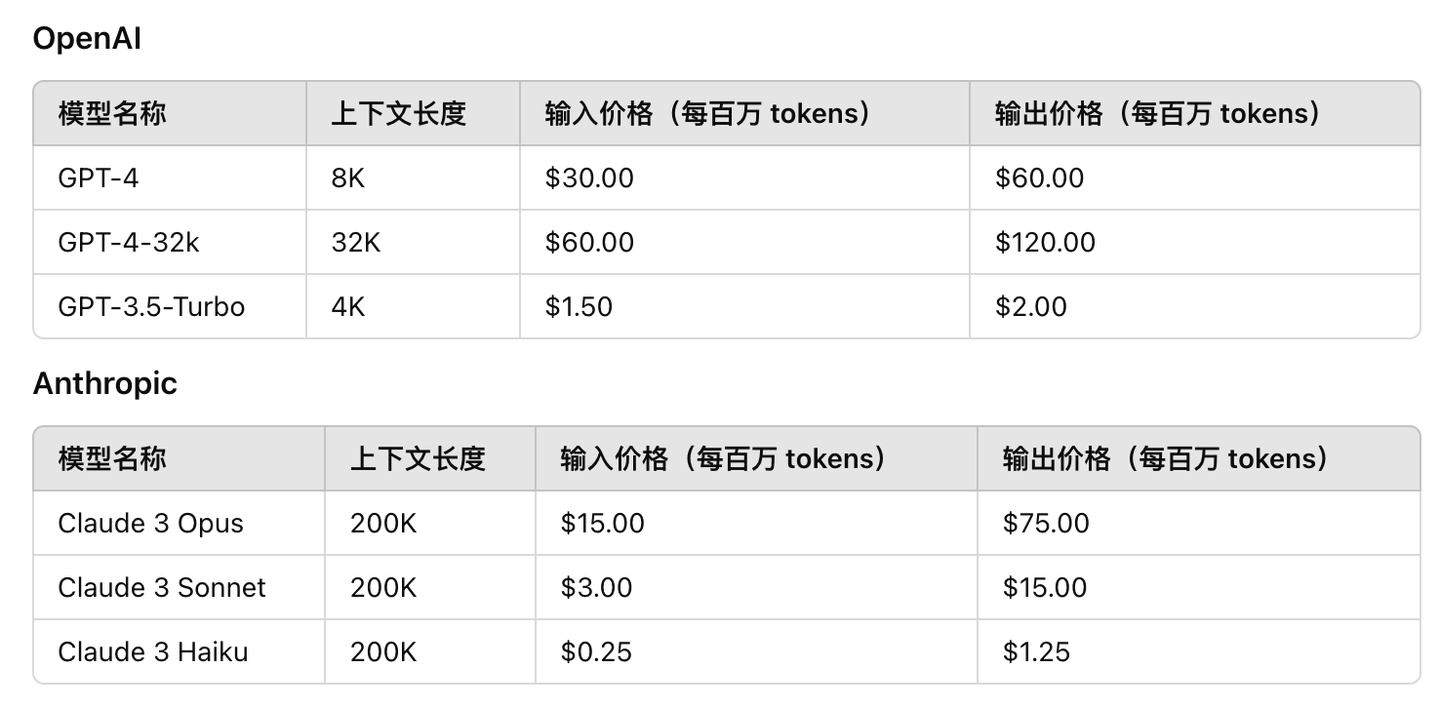
在又快又好的同时,DeepSeek V3的API价格也被打下来了。每一百万的输入tokens,只需要0.27 ;每百万的输出 t o k e n s 需要 1.1 ;每百万的输出tokens需要1.1 ;每百万的输出tokens需要1.1。

我们这里对比一下目前国外几个前沿大模型的价格,**GPT-4每百万输入tokens,高达30 ,而 C l a u d e 3 O p u s 每百万输出 t o k e n s 也要 15 ,而Claude3 Opus每百万输出tokens也要15 ,而Claude3Opus每百万输出tokens也要15。**从价格上来看,DeepSeek V3真的是太便宜的,便宜到我都怀疑这个公司还能不能赚到钱。
而如果要平衡性能和成本,它就成了DeepSeek官方绘图中唯一进入“最佳性价比”三角区的模型。其他像GPT-4o、Claude3.5等模型,价格都比较昂贵。
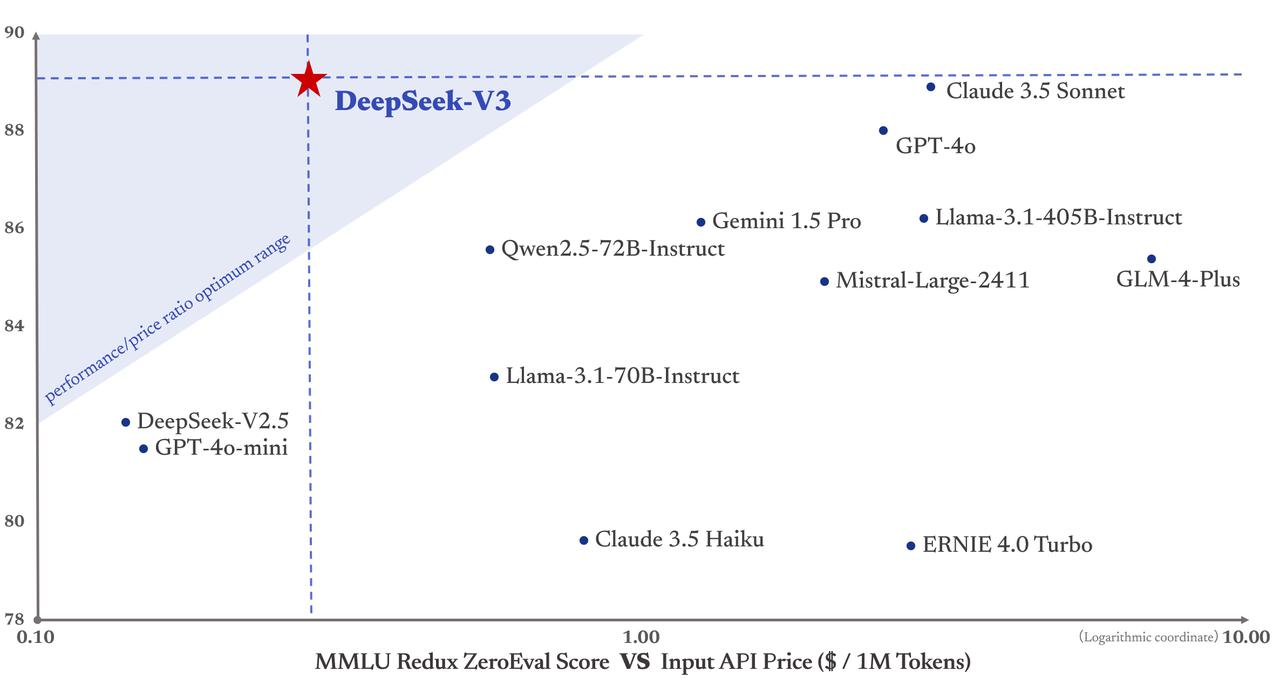
模型的一些训练细节

DeepSeek V3除了使用了FP8之外,还有一些其他的模型细节。比如它继续采用了多头潜在注意力(MLA)来实现高效推理。它在传统多头注意力机制(Multi-Head Attention)的基础上,引入了潜在特征(Latent Features)概念,进一步提高了对复杂关系的建模能力。

也就是先把token的特征压缩成一个小维度的latent vector,然后再通过一些简单的变换把它扩展到各个头需要的Key和Value空间。对于一些重要的信息,比如旋转位置编码RoPE,会进行单独处理,这样网络仍然可以保留时间和位置的信息。
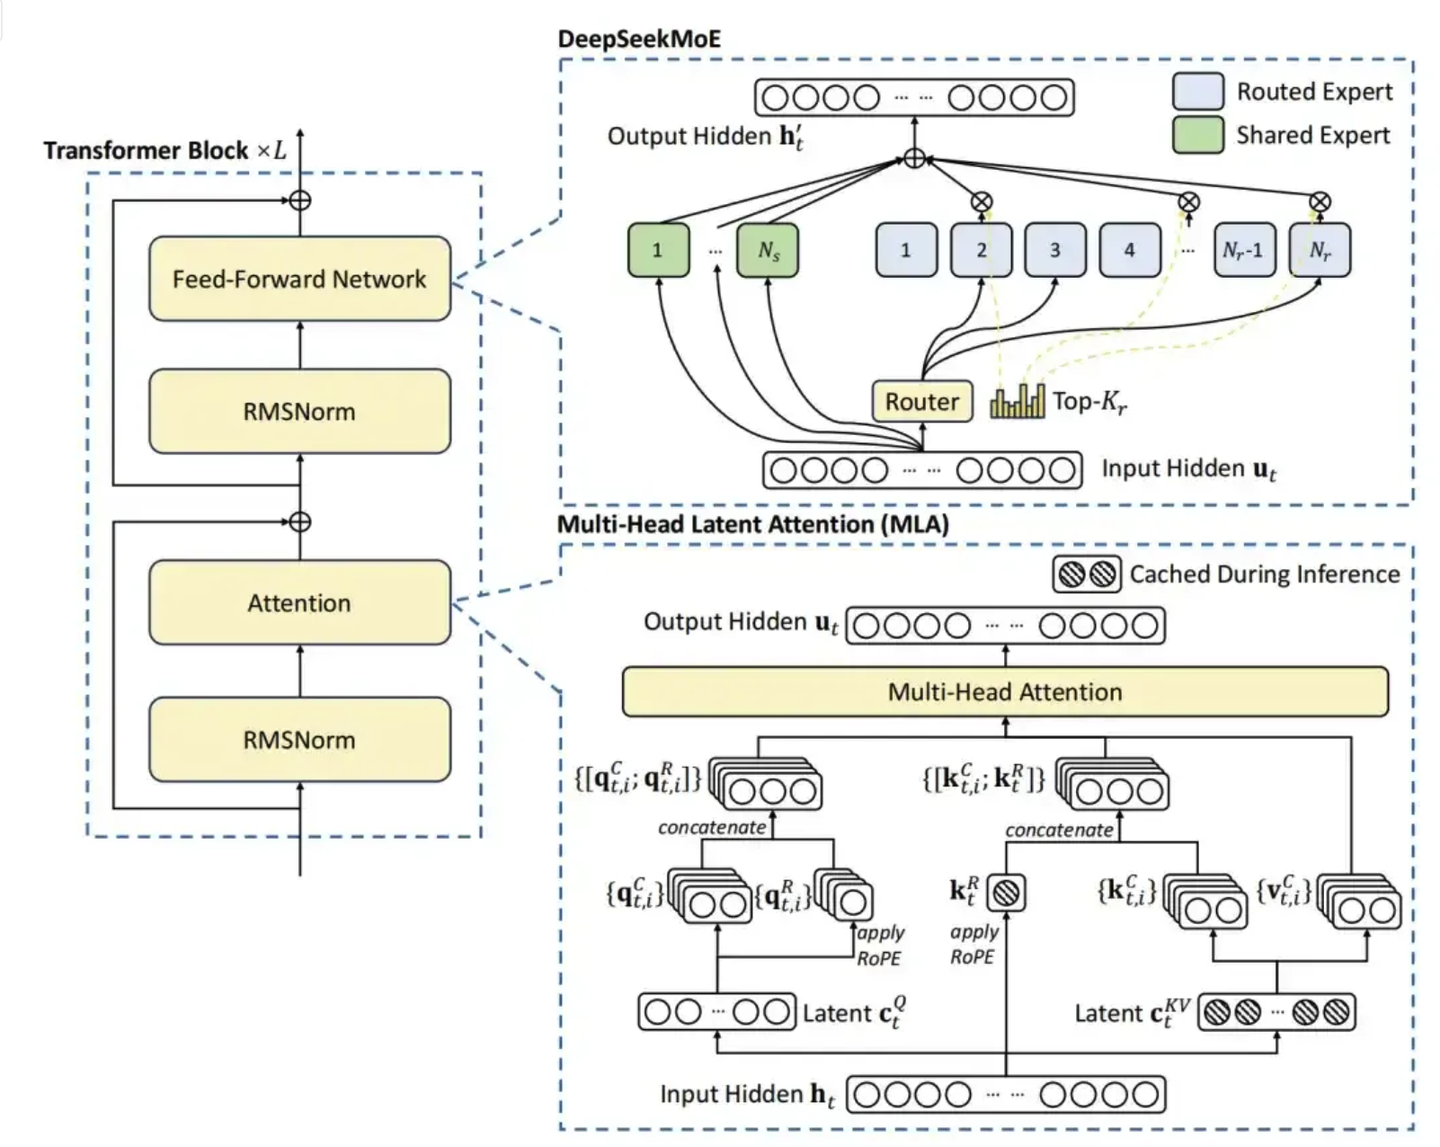
在MOE架构中,引入了路由专家 (Routed Experts) 和共享专家 (Shared Experts) 。主要是用来激活那些参数需要被更新。

**路由专家中主要是用来选择参数进行激活。**对于每个输入的token,只有一部分路由专家会被选中来参与计算。这个选择过程是由一个门控机制决定的,比如DeepSeekMoE中用的那种根据亲和度分数来选的Top-K方式。

而**共享专家始终参与所有输入的处理。**无论输入是什么,所有共享专家都会贡献它们的力量。

还用到了一个MTP(多个tokens预测)技术,**MTP的核心理念在于训练时,模型不仅要预测下一个token(就像传统语言模型那样),还要同时预测序列后面的几个token。**这样一来,模型就能获得更丰富的训练信息,有助于它更深入地理解上下文以及长距离的依赖关系。

写在最后

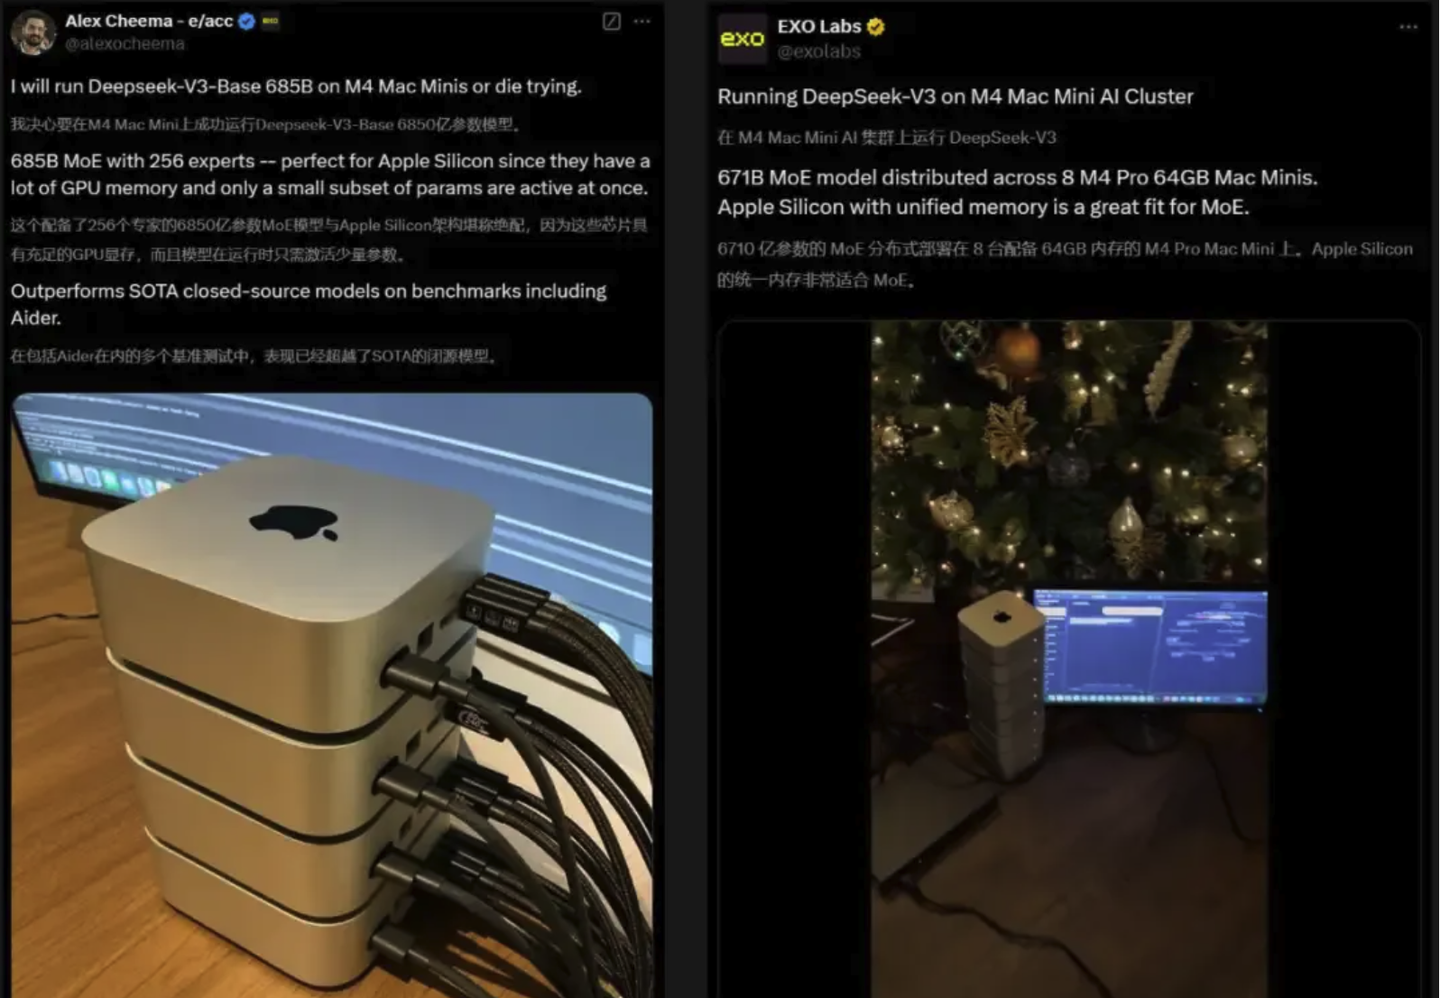
DeepSeek-V3现在已经可以在官方平台上直接测试了,代码也是完全开源的,可以随时下载。国外的AI爱好者们都已经开始尝试了,有人甚至把4个或8个M4 Mac mini叠在一起运行DeepSeek V3。
还有开发者用DeepSeek-V3创建了一个AI公司logo风格的小行星游戏,只要几分钟很快就搞定了。

如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

DeepSeek V2节省了42.5%的训练成本,怎么做到的? DeepSeek V2通过多种创新技术和优化措施实现了42.5%的训练成本节省。通过以上技术手段,DeepSeek V2在保持高性能的同时,实现了显著的训练成本节省。DeepSeekMoE混合专家架构的具体工作原理主要基于两个核心策略:细粒度专家细分和共享专家隔离。DeepSeek V2如何实现激活参数的减少,具体技术细节是什么?DeepSeek V2中KV缓存压缩为潜在向量(MLA)的技术细节和效果评估。 阅读详情

相关推荐

DeepSeek-V3 大模型哪些地方超越了其他主流大模型

DeepSeek-V3 在长文本处理方面表现出色,能够处理长达 128K token 的输入,并在多个长文本处理任务中取得优异成绩。

kcarly的专栏 1650

创建自己专属 DeepSeek 大模型:超详细教程

DeepSeek 大语言模型算法是北京深度求索人工智能基础技术研究有限公司推出的深度合成服务算法,于 2024 年 4 月上线。它以 Transformer 架构为基础,通过海量语料数据进行预训练,并运用监督微调、人类反馈的强化学习等技术进行对齐,构建成深度神经网络。同时,增加审核、过滤等安全机制,使其能够根据人类指令或提示,实现语义分析、计算推理、问答对话、篇章生成、代码编写等多种任务。DeepSeek 模型在算法和工程优化方面进行了系统级创新。

ytt0523_com的博客 3835

①Modbus TCP转Modbus RTU/ASCII网关同步采集无需编程高速轻松组网

MS-A1-50X1系列作为MODBUS TCP通信的服务器进行动作。可通过MODBUS TCP 通信,将 MS-A1-50X1 系列产品通过 RS485 采集的仪器仪表之类的值作为通信数 据输出到 PLC,上位机等。

2401_89571741的博客 1398

深度解析为什么Deepseek v3的成本这么低?

DeepSeek V3的训练总共才用了不到280万个GPU小时,而Llama 3 405B却用了3080万GPU小时。用训练一个模型所花费的钱来说,训练一个DeepSeek V3只需要花费557.6万美元,相比之下,一个简单的7B Llama 3模型则需要花费76万美元。

huang9604的博客 4526

SQL2000在Win10上安装完整指南:兼容模式、SP4补丁与远程连接配置

数据库兼容性是老系统迁移与运维中绕不开的难题。当历史遗留的SQL Server 2000遭遇全新的Windows 10环境,安装程序常因系统版本检测失败而拒绝运行,这背后是旧版安装程序与NT内核版本间的识别错位。通过兼容模式模拟旧系统环境、以管理员身份运行安装程序,并处理注册表挂起与杀毒软件干扰,即可突破基础安装障碍。安装后的SP4补丁与TCP/IP端口配置,则是保障服务稳定与远程连接的关键。这一技术路径广泛适用于制造企业MES、进销存系统及医院HIS等仍依赖老旧数据库的场景,为IT运维与数据迁移测试提供了

weixin_29266679的博客 441

【开源电机驱动】位置环控制

这是三闭环里的最后一个:位置闭环控制。如果你认真的阅读并推导了前章节,那么这一节将会很好理解。一如既往,我会使用简练的语言来描述复杂的问题。本章节主要涉及位置环的一些概念,以及控制框图。文章不会涉及具体的代码。

BadBoyHolly的博客 6095

DeepSeek-V3的训练之道

在 DeepSeek-V3 中,MLA 的 KV 压缩维度(dc)设置为 512,Query 压缩维度(d’)设置为 1536,解耦 Key 的头维度(dr)设置为 64。在预训练阶段之后,DeepSeek-V3 进入了后训练阶段,这一阶段主要包括监督微调(Supervised Fine-Tuning, SFT)和强化学习(Reinforcement Learning, RL),通过这两个阶段的训练,DeepSeek-V3 的性能得到了进一步的提升,使其能够更好地理解和生成符合人类偏好的文本。

weixin_44245188的博客 2308

ssd训练自己的数据集

基于SSD实现目标检测(训练自己的数据集)

reset2021的博客 6804

DeepSeek大模型微调全攻略:从入门到精通的实战指南!非常详细收藏我这一篇就够了!

DeepSeek是由。

2401_85375151的博客 2677

Python爬虫反爬:突破Cloudflare 5秒盾(免费方案,小红书/知乎可用)

这套方案的核心优势是“真实模拟+免费无门槛”无需付费代理、无需复杂JS解密,仅用playwright模拟真实浏览器,即可突破Cloudflare 5秒盾;适配小红书、知乎、豆瓣等主流平台,修改配置即可复用;兼顾易用性和稳定性,新手也能快速上手,企业级场景可通过IP轮换、异步爬取进一步优化。“模拟人类行为到底”——Cloudflare的反爬本质是区分“机器”和“人类”,只要爬虫的浏览器指纹、行为特征与人类一致,就能稳定绕过限制。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 2881

字符编码——简体中文编码中区位码、国标码、内码、外码、字形码的区别及关系

目录区位码国标码(交换码)内码(机内码)区位码、国际码、内码的转换为什么要加上20H为什么加上80H 本文以GB2312为例,讲述区位码、国标码、内码、外码、字形码 区位码 整个GB2312字符集分成94个区,每区有94个位,每个区位上只有一个字符,即每区含有94个汉字或符号,用所在的区和位来对字符进行编码(实际上就是字符编号、码点编号),因此称为区位码。 换言之,GB2312将包括汉字在内的所有字符编入一个94 * 94的二维表,行就是“区”、列就是“位”,每个字符由区、位唯一定位,其对应的区、位编号合并

路人coder 5341

DeepSeek模型优化技巧深度解析:超参数调优、正则化等方法

通过合理设置学习率、批量大小、网络结构和正则化参数,DeepSeek模型的性能可以得到显著提升。此外,混合精度训练、并行训练和LoRA微调等策略也为优化模型性能提供了更多可能性。希望本文能够帮助读者更好地理解和优化DeepSeek模型的性能。

加入“Super Entity”,与全能开发团队共探AI智能体与数字人项目,开启前沿技术之旅。 2350

【Linux】Windows11 安装 WSL2 并运行 Ubuntu 22.04 详细操作步骤

Windows 11 安装 WSL2 和 Ubuntu 22.04 指南 本文详细介绍在 Windows 11 上安装 WSL2 和 Ubuntu 22.04 的完整步骤,包括: WSL2 与 VirtualBox 的性能对比优势 系统版本检查与升级方法 两种安装方式(一键安装和手动安装) Ubuntu 22.04 的安装与配置 存储位置管理及迁移技巧 常用 WSL2 命令速查表 文章还提供了性能优化建议和常见问题解决方案,适合开发者和 Linux 爱好者快速搭建高效的开发环境。

No8g攻城狮的博客 2万+

舒服了!DeepSeek V3把训练大模型的成本给干下来了(附教程)

一夜之间,DeepSeek突然之间炸场,各个大佬都在纷纷转发,而且发布即开源,直接用50多页的论文公布了其训练细节

2301_81888214的博客 1049

【AI应用实战-Codex】Mac intel芯片下安装Codex(二)

摘要:本文介绍了在Intel芯片Mac上安装OpenAI Codex桌面应用时遇到的问题及解决方法。由于官方仅提供ARM64版本,导致Intel Mac无法直接运行。解决方案包括:1)使用社区脚本将ARM版DMG与x64 Electron重新打包成兼容版本;2)使用VSCode插件配合CLI作为替代方案。文章详细记录了重新打包过程中遇到的"electron_common_owl_features"绑定缺失错误,通过注入stub代码、重算ASAR完整性哈希等步骤成功解决问题。最终生成的Co

3528

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

DeepSeek V3降低训练大模型成本全攻略:附教程,轻松实现!

DeepSeek-V3现在已经可以在官方平台上直接测试了,代码也是完全开源的,可以随时下载。国外的AI爱好者们都已经开始尝试了,有人甚至把4个或8个M4 Mac mini叠在一起运行DeepSeek V3。还有开发者用DeepSeek-V3创建了一个AI公司logo风格的小行星游戏,只要几分钟很快就搞定了。总的来说,DeepSeek V3的发布,只用了较低的成本就可以超越现有的一些大模型,并且能够和GPT-4o和Claude 3.5相媲美,确实是一个杰出的工作。

2401_85375151的博客 1794

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

最强开源大模型:DeepSeek V3,它来了!

DeepSeek-V3的发布不仅是技术的一次飞跃,更是开源精神的体现。它不仅在性能上与世界顶尖的闭源模型媲美,更以开源的方式推动了人工智能技术的普惠发展,是当之无愧的国产之光!未来,相信DeepSeek将会继续在AGI探索的道路上砥砺前行,为AI领域带来更多创新与突破。

公众号@极客密码 1万+

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

为什么低成本?深度拆解 DeepSeek-V3的训练之道

DeepSeek-V3 以极低的成本(约 550 万美金)实现了与 Claude 3.5 等顶尖模型相媲美甚至更优的性能,并且选择了开源的道路,为全球的研究者和开发者带来了巨大的惊喜。那么,DeepSeek-V3 是如何炼成的呢?今天,我们就深入拆解其训练过程。

m0_56255097的博客 2034

DeepSeek-V3再发论文,梁文锋署名,低成本训练大模型的秘密揭开了

这篇 14 页的论文瞄向了「Scaling 挑战以及对 AI 架构所用硬件的思考」。从中你不仅能读到 DeepSeek 在开发和训练 V3 过程中发现的问题和积累的心得,还能收获他们为未来的硬件设计给出的思考和建议。这一次,DeepSeek CEO 梁文锋同样也是署名作者之一。

m0_59164304的博客 1351

【AI 大模型】DeepSeek 大模型简介 ( DeepSeek-R1 和 DeepSeek-V3 大模型 | Python 调用 DeepSeek API | 本地部署 DeepSeek )

一、DeepSeek 大模型 1、DeepSeek-R1 和 DeepSeek-V3 大模型 DeepSeek-V3 大模型 DeepSeek-R1 大模型 大模型调用 2、DeepSeek 官网访问 DeepSeek-R1 和 DeepSeek-V3 大模型 3、DeepSeek 大模型参数 4、DeepSeek 蒸馏模型本地部署硬件需求 二、DeepSeek 开发者平台 1、开放平台地址 2、申请 API Key 3、Python 调用 DeepSeek API 三、本地部署 DeepSeek 大模型

让 学习 成为一种 习惯 ( 韩曙亮 の 技术博客 ) 2万+

重磅!“AI界拼多多”再发力,国产大模型DeepSeek-V3开源后刷屏,总训练成本557万美元,性能比肩GPT-4o...

整理 | 屠敏出品 | 优快云(ID:优快云news)就在今天,素来被硅谷视为“来自东方神秘力量”的中国大模型创业公司 DeepSeek 再次悄悄惊艳了国内外的 AI 技术圈,其重磅发布了一个全新的超大规模模型——DeepSeek-V3。这个新模型拥有 6710 亿个参数,但采用了 MOE(混合专家)架构,能根据任务需求激活特定参数,每处理一个词元激活 370 亿参数,从而实现高效又准确的任务...

优快云资讯 8504

揭秘Deepseek v3低成本背后的技术玄机!

这个问题其实可以从它发布的技术报告中窥见一二。DeepSeek V3的训练总共才用了不到万个GPU小时,而Llama 3 405B却用了万GPU小时。用训练一个模型所花费的钱来说,,相比之下,一个简单的7B Llama 3模型则需要花费76万美元。从论文中的公布细节可以得到它的比起动辄几百亿人民币都训练不出来一个好用的大模型,DeepSeek V3的训练简直颠覆了大家的想象。DeepSeek V3除了使用了FP8之外,还有一些其他的模型细节。比如它继续采用了(MLA)来实现高效推理。

2401_84494441的博客 1362

DeepSeek-V3 是怎么训练的|我只能说它真牛!

这两天,DeepSeek-V3 低调发布,在国际上狠狠秀了一波肌肉:只用了 500 多万美金的成本,带来了不输 Claude 3.5 的成绩,并开源!下面,让我们以更加系统的方式,来看看这次的 DeepSeek-V3,是这么炼成的。本文将从和五个纬度来拆解 V3,所用到的图表、数据源于技术报告:《DeepSeek-V3 Technical Report》。

m0_63171455的博客 8443
上一篇: deepseek完整的671B R1塞进本地,详尽教程来了!
下一篇: Ollama 本地运行大模型(LLM)完全指南(附教程)
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值